Честная интерпретация метрик детекции
Запусти валидацию, вместе изучи precision, recall, mAP50-95, AP по классам и матрицу ошибок, а затем выбери порог для выпуска на основе целевого показателя.
Одно число успокаивает: mAP 0.83 — готово. Но за тем же mAP может скрываться класс, который ошибается в половине случаев, постоянно неточные рамки или порог, из-за которого уведомления приходят каждую минуту. Ты запустишь настоящую валидацию и разберёшь её построчно, пока она не подскажет, что исправить и где установить порог.
Практические занятия
Как оценивается каждое предсказание#
При валидации каждая предсказанная рамка сопоставляется с разметкой. Предсказание считается истинно положительным (TP), если у него правильный класс, а значение IoU с ещё не сопоставленной рамкой разметки превышает порог; в противном случае это ложноположительное предсказание (FP). Каждый несопоставленный объект из разметки считается ложноотрицательным (FN).
| Метрика | Формула | На какой вопрос отвечает |
|---|---|---|
| Precision | TP / (TP + FP) | Если модель нарисовала рамку, как часто она оказывается правильной? |
| Recall | TP / (TP + FN) | Сколько реальных объектов удалось найти? |
| F1 | 2 × P × R / (P + R) | Одно число, которое учитывает оба показателя |
При снижении порога уверенности добавляются рамки: recall растёт, а precision падает. Кривая precision-recall показывает этот компромисс для всех порогов, а площадь под ней — это средняя точность (AP) для одного класса. mAP50 — это среднее AP по классам при IoU 0.5, когда даже заметно неточная рамка всё ещё засчитывается. mAP50-95 усредняется по десяти порогам IoU от 0.5 до 0.95, поэтому вознаграждает точные рамки; именно это главное число в таблицах моделей Ultralytics.
Запусти валидацию#
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
metrics = model.val(data="coco8.yaml")

print(f"precision={metrics.box.mp:.3f} recall={metrics.box.mr:.3f}")
print(f"mAP50={metrics.box.map50:.3f} mAP50-95={metrics.box.map:.3f}")
Class Images Instances Box(P R mAP50 mAP50-95)
all 4 17 0.551 0.962 0.943 0.669
person 3 10 0.551 0.8 0.848 0.387
dog 1 1 0.36 1 0.995 0.597
horse 1 2 0.36 1 0.995 0.696
elephant 1 2 0.656 0.969 0.828 0.545
umbrella 1 1 0.543 1 0.995 0.895
potted plant 1 1 0.833 1 0.995 0.895Разбирай результаты сверху вниз:
- Instances 17, Images 4. COCO8 — это тест для быстрой проверки. Четырёх изображений недостаточно, чтобы решить, выпускать ли модель; воспринимай все числа как иллюстрацию.
- mAP50 0.943 против mAP50-95 0.669. Большинство объектов обнаружено, но многие рамки неточные. Большой разрыв означает, что слабое место — локализация, а не детекция.
- AP50-95 класса
person— 0.387. Самый распространённый класс оказался самым слабым. Это и есть узкое место. - P 0.551, R 0.962. Эти столбцы рассчитаны при единственном пороге уверенности, который максимизирует F1 по всем классам, — здесь это низкий порог, — а не при пороге 0.25, с которым ты делаешь предсказания. Не называй эти значения «точностью модели».
AP по классам и порог для выпуска#
В результатах того же запуска есть AP по классам, а также precision и recall для каждого порога уверенности, поэтому ты можешь выбрать порог по целевому значению, а не наугад:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
metrics = model.val(data="coco8.yaml", plots=False, verbose=False)
box = metrics.box

# Per-class AP from the same run: the average hides the weakest class
for i, c in enumerate(box.ap_class_index):
    print(f"{model.names[int(c)]:13} AP50={box.ap50[i]:.3f}  AP50-95={box.ap[i]:.3f}")

# Precision and recall at every confidence threshold for one class
row = list(box.ap_class_index).index(0)  # class 0 = person
for conf in (0.1, 0.25, 0.5, 0.75):
    j = int(conf * (len(box.px) - 1))
    print(f"person @ conf {conf:.2f}: precision {box.p_curve[row, j]:.2f}, recall {box.r_curve[row, j]:.2f}")
all 4 17 0.551 0.962 0.943 0.669
person AP50=0.848 AP50-95=0.387
dog AP50=0.995 AP50-95=0.597
horse AP50=0.995 AP50-95=0.696
elephant AP50=0.828 AP50-95=0.545
umbrella AP50=0.995 AP50-95=0.895
potted plant AP50=0.995 AP50-95=0.895
person @ conf 0.10: precision 0.63, recall 0.80
person @ conf 0.25: precision 1.00, recall 0.54
person @ conf 0.50: precision 1.00, recall 0.40
person @ conf 0.75: precision 1.00, recall 0.14Теперь порог — это правило принятия решения, а не интуиция:
| Целевое значение, исходя из критериев принятия решения | Выбери | Результаты этого запуска |
|---|---|---|
| Ложными могут быть не более 5% оповещений (precision ≥ 0.95) | Самый низкий порог, который соответствует этому условию, чтобы сохранить максимальный recall | 0.25: precision 1.00, recall 0.54 |
| Пропускай не более 1 из 5 человек (recall ≥ 0.80) | Самый высокий порог, который соответствует этому условию, чтобы сохранить максимальный precision | 0.10: precision 0.63, recall 0.80 |
В этом случае ни один вариант не подходит: высокая precision означает потерю половины людей, а высокий recall — треть ложных оповещений. Это основание для решения «дорабатывать», а не проблема порога. В папке запуска при валидации также сохраняются BoxPR_curve.png, BoxP_curve.png, BoxR_curve.png, BoxF1_curve.png и confusion_matrix.png, чтобы ты мог оценить тот же компромисс по графикам; в руководстве по метрикам производительности подробно разобран каждый показатель.
Что исправить дальше#
Матрица ошибок показывает, с чем путают слабый класс. Если AP класса forklift низкий, а вместо погрузчиков предсказывается pallet_jack, проблема в путанице классов, а не в локализации: добавь примеры, наглядно показывающие визуальные различия, или объедини классы, если раздельная обработка не нужна в последующем коде. В руководстве по анализу результатов оценки модели разобран весь рабочий процесс.
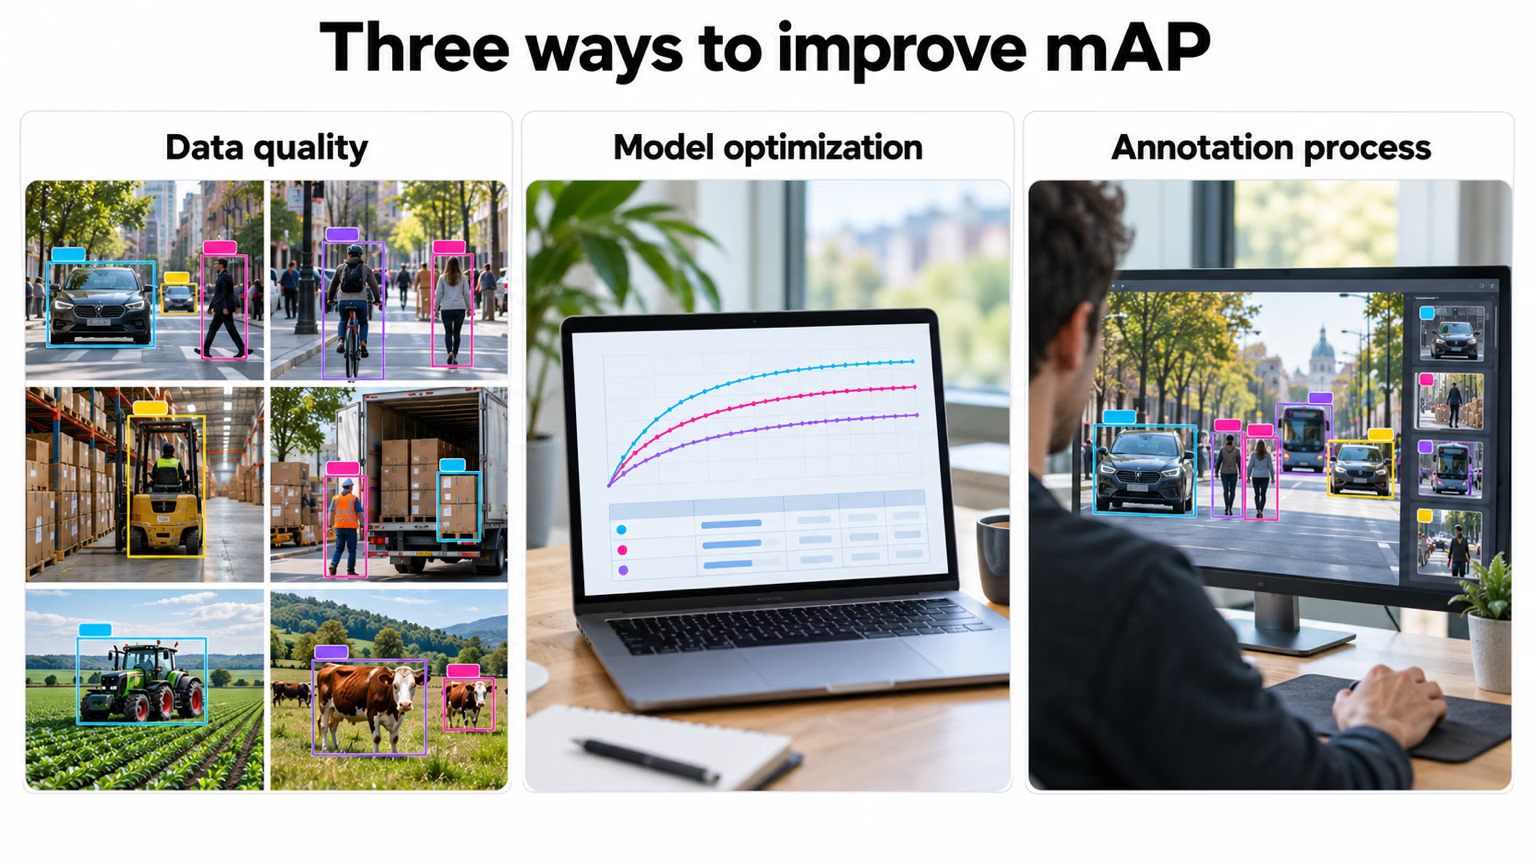
Большинство исправлений относится к первой и третьей панелям: нужны более качественные данные и разметка для класса, который является узким местом. Меняй модель или настройки обучения только после того, как проверки данных из предыдущих трёх уроков пройдены.
| Оценка на неизменяемой тестовой выборке | Решение |
|---|---|
| Каждый критически важный для бизнеса класс соответствует целевым значениям precision и recall | Выпускай и отслеживай работу модели |
| Один класс или условие не соответствует целевому значению | Дорабатывай: добавь целевые данные и разметку для устранения этого пробела |
| Все классы сильно не дотягивают до цели или визуально перекрываются | Пересмотри спецификацию задачи, классы или конфигурацию камер |
Подводные камни#
mAP 0,83 может скрывать класс с показателем 0,40. Если именно этот класс важен для бизнеса, у тебя не модель с показателем 0,83 — у тебя неработающая модель с приукрашенным средним значением.
Симптом: модель, которая «набирает 0,94», строит рамки слишком свободно для измерений или кадрирования. Решение: сообщай mAP50-95, а разницу с mAP50 рассматривай как показатель точности локализации.
Симптом: идеально выглядящие показатели на нескольких десятках изображений или на почти точных копиях обучающих данных. Решение: увеличь валидационную выборку до нескольких сотен экземпляров для каждого важного класса и перед оценкой метрик запусти описанную в предыдущем уроке проверку на почти дублирующиеся изображения.
Показать решение
Вывод: счётчик людей на yolo26n.pt, валидация COCO8
Узкое место — person, AP50-95 0.387 при общем показателе 0.669. Это также класс с наибольшим числом экземпляров (10 из 17), поэтому он и самый слабый, и наиболее важный для счётчика людей. AP50 равен 0.848: модель находит большинство людей, но рисует неточные рамки. Для подсчёта это менее важно, чем для задач, где измеряются положение или размер.
Чтобы получить точность ≥ 0.95, минимальный подходящий порог — conf 0.25: точность равна 1.00, но полнота — всего 0.54. Счётчик пропустит почти половину людей. Для полноты ≥ 0.80 нужен conf 0.10, при котором треть подсчётов будет ложной.
Решение: продолжать итерации. Собери и разметь изображения людей с камеры, где будет работать система, — особенно мелких, перекрытых и находящихся у края кадра, — а затем повтори валидацию на зафиксированном тестовом наборе из нескольких сотен людей. Четырёх валидационных изображений недостаточно, чтобы принять решение о запуске.