Наборы данных, отражающие реальность
Перед тем как размечать новые данные, проверь реальный набор данных на пробелы в охвате и составь план сбора данных с трудными отрицательными примерами.
Большинство разочаровывающих моделей компьютерного зрения — не плохие модели, а хорошие модели, обученные на наборе данных, который не похож на условия их эксплуатации. На прошлом уроке детектор COCO не нашёл ни одной лодки на снимке с дрона, потому что лодки в COCO сняты сбоку. Пятиминутная проверка выявит такие пробелы до того, как ты потратишь деньги на разметку.
Практические занятия
Модели учатся на наборе данных, а не на реальном мире#
Модель интерполирует между увиденными примерами. Обучи её на городских улицах в солнечный день, а затем запусти ночью в туманном гараже — и она не справится. Не потому, что автомобили выглядят иначе, а потому, что она никогда не видела автомобили в таких условиях. Это несоответствие называется сдвигом домена, и валидация не предупредит о нём, если валидационные изображения получены из той же выборки с перекосом:
Решение — в подходе к сбору данных, а не в алгоритме: до разметки целенаправленно собирай данные в условиях эксплуатации модели. Подробности смотри в руководстве по сбору и аннотированию данных.
Аудит реального набора данных#
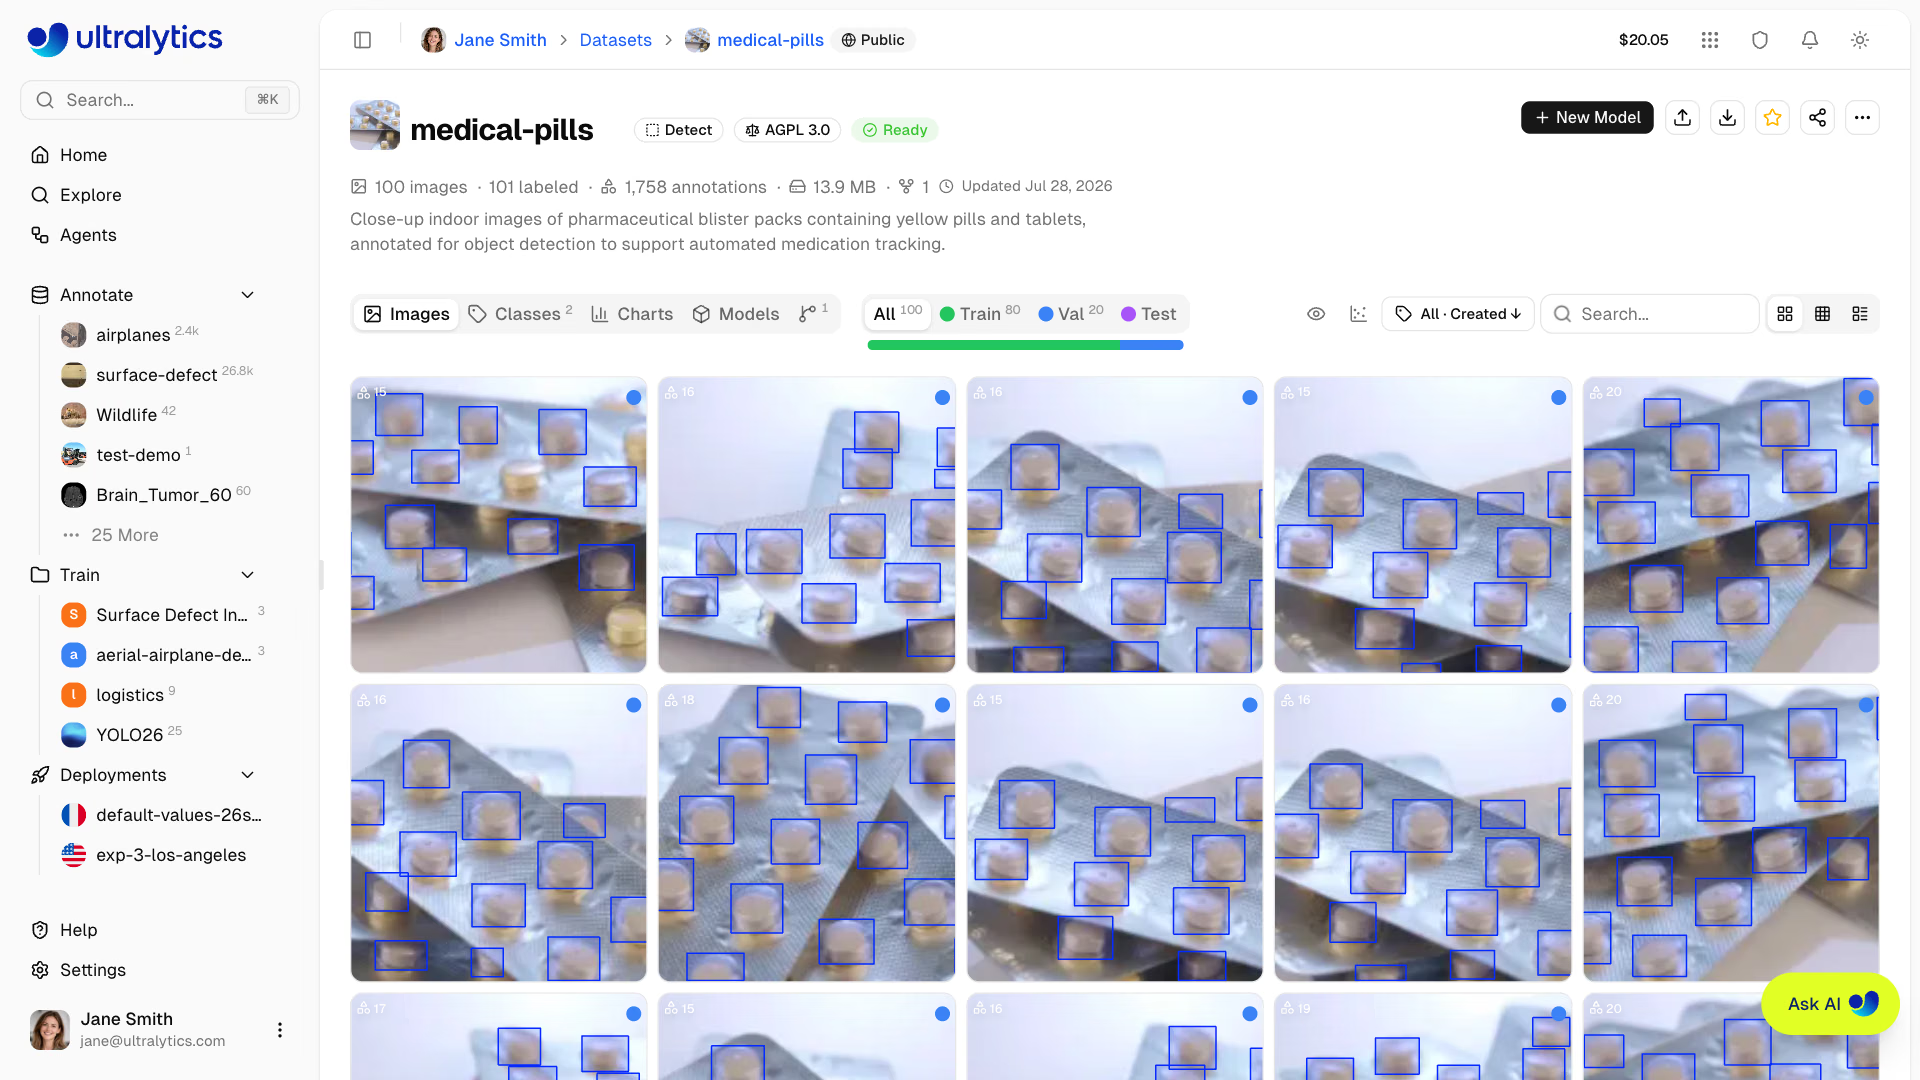
Набор данных medical-pills выше — крупные планы блистерных упаковок, на которых обведена каждая таблетка, — хорошо подходит для аудита. На странице набора данных Ultralytics Platform показывает основные показатели; скрипт ниже вычисляет значения, которые помогают оценить охват. Скрипт запускается на копии, входящей в состав ultralytics:
from collections import Counter
from pathlib import Path

from PIL import Image, ImageStat
from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("medical-pills.yaml")  # downloads the dataset on first use

for split in ("train", "val"):
    images = sorted(Path(data[split]).glob("*.jpg"))
    labels = [Path(str(p).replace("/images/", "/labels/")).with_suffix(".txt") for p in images]
    rows = [line.split() for f in labels if f.exists() for line in f.read_text().splitlines()]
    classes = Counter(data["names"][int(r[0])] for r in rows)
    backgrounds = sum(not f.exists() or not f.read_text().strip() for f in labels)
    areas = sorted(float(r[3]) * float(r[4]) for r in rows)  # box area as a share of the image
    sizes = Counter(Image.open(p).size for p in images)
    brightness = [ImageStat.Stat(Image.open(p).convert("L")).mean[0] for p in images]
    print(f"{split}: {len(images)} images, {backgrounds} backgrounds, {dict(classes)}, sizes {dict(sizes)}")
    print(f"  boxes: median {areas[len(areas) // 2]:.1%} of the image, {sum(a < 0.01 for a in areas)} of {len(areas)} under 1%")
    print(f"  brightness: {min(brightness):.0f} to {max(brightness):.0f} (0 = black, 255 = white)")
train: 92 images, 0 backgrounds, {'pill': 1623}, sizes {(1920, 1080): 92}
boxes: median 1.4% of the image, 320 of 1623 under 1%
brightness: 171 to 198 (0 = black, 255 = white)
val: 23 images, 0 backgrounds, {'pill': 399}, sizes {(1920, 1080): 23}
boxes: median 1.4% of the image, 79 of 399 under 1%
brightness: 171 to 198 (0 = black, 255 = white)Читай результаты как отчёт об охвате: по одному выводу в строке:
| Результат | Что это означает | Решение |
|---|---|---|
| Одно разрешение: 1920×1080 | Одна камера, одна настройка | Собери данные со всех моделей камер, на которых будет работать система |
| Яркость только в диапазоне 171–198 | Яркий равномерный студийный свет, нет тёмных условий | До запуска системы у аптечной стойки собери снимки при слабом и смешанном освещении, а также при контровом свете |
| 0 фоновых изображений | Модель никогда не видит сцены без таблеток | Добавь пустые блистерные упаковки, другие таблетки и пустые прилавки как трудные отрицательные примеры |
| Медианный размер рамки — 1,4% изображения; каждая пятая рамка меньше 1% | Мелкие объекты | Выбери достаточно высокое значение imgsz и специально добавь снимки объектов издалека |
Один класс: pill | Нет типов таблеток | Для подсчёта этого достаточно; добавляй классы, только если они нужны для принятия решения |
Ничего из этого не отражается в оценке на валидации, потому что валидационная выборка содержит те же пробелы.
Четыре аспекта охвата#
| Аспект | Что собирать | Типичная ошибка при недостаточном охвате |
|---|---|---|
| Освещение | Рассвет, полдень, сумерки, ночь, блики, контровой свет, мерцающие люминесцентные лампы | Полнота обнаружения падает при смене смен или под прямыми солнечными лучами |
| Погода и атмосфера | Дождь, туман, снег, пыль, конденсат на объективе | Ложные срабатывания на капли, пропуски объектов в дымке |
| Перекрытия и загромождённость сцены | Частично скрытые объекты, переполненные сцены, объекты, обрезанные краем кадра | Пропуски каждый раз, когда объект виден не полностью |
| Камера и ракурс | Объектив, высота и угол установки, разрешение, сжатие, размытие движения | Работает на тестовой камере, но не на следующем объекте |
В примере с мариной не учли ракурс: тот же класс, но новый угол съёмки — и полнота обнаружения упала до нуля.
Трудные отрицательные примеры и фоновые изображения#
Детектор должен научиться распознавать и то, что не является целевым объектом. Трудные отрицательные примеры внешне похожи на него: для детектора вилочных погрузчиков это могут быть гидравлическая тележка, ножничный подъёмник, отражение погрузчика на полированном полу или плакат по технике безопасности с изображением погрузчика.
В формате YOLO фоновое изображение — это просто изображение без файла разметки: на нём нечего обводить. В рекомендациях по обучению Ultralytics советуют добавлять около 0–10% фоновых изображений, чтобы уменьшить количество ложных срабатываний; в COCO таких изображений около 1%. Заполни эту долю трудными отрицательными примерами из своей среды, а не случайными пустыми кадрами. Аугментация данных поможет менять яркость и угол, но не создаст гидравлическую тележку, которую модель никогда не видела.
Подводные камни#
Симптом: размечено 10 000 изображений — все дневные и снятые на пилотную камеру. Решение: в течение пары недель собирай данные с камер, на которых будет развёрнута модель, в полном диапазоне условий; проверь охват и только потом плати за разметку. Синтетические данные могут закрыть известный пробел, но не заменят реальные кадры.
Симптом: высокий mAP на валидации, но плохие результаты на первом новом объекте. Решение: помни, что валидация унаследовала слепые зоны набора данных. Возьми десять случайных обучающих изображений и десять кадров с производства и попроси коллегу отличить одни от других; если ему это удастся, у тебя есть сдвиг домена.
Для плана выборки с целевым количеством примеров для каждого условия продолжай с раздела Сбор качественных и репрезентативных данных в Создании высокопроизводительных наборов данных YOLO.
Показать решение
Для medical-pills, используемого на аптечной стойке при смешанном магазинном освещении, заполни сетку по данным аудита (яркость 171–198, один источник 1920×1080, фоновых изображений нет) и быстрому просмотру изображений: на них видны одни и те же упаковки на одной и той же яркой поверхности, без рук:
| Класс | Яркое студийное освещение | Тусклое или тёплое магазинное освещение | Контровой свет / блики | Частично закрыто рукой | Камера телефона |
|---|---|---|---|---|---|
pill | 2,022 | 0 | 0 | 0 | 0 |
| Фон | 0 | 0 | 0 | — | 0 |
План сбора в порядке приоритета:
- Тусклое или тёплое магазинное освещение — обычные условия у стойки; сейчас изображений нет.
- Частично закрыто рукой — так происходит почти при каждом реальном взаимодействии.
- Камера телефона — второй сенсор и другое разрешение.
- Контровой свет / блики — фольгированные упаковки отражают окна и потолочные светильники.
Сложные отрицательные примеры: пустые блистеры (та же фольга, но без таблеток) и другие круглые предметы на стойке — монеты, пуговицы, конфеты. Добавь их как фоновые изображения, примерно 5–10% набора данных.