Качество аннотаций
Разберись, что содержит метка YOLO, проверяй файлы меток на повреждённые строки и поддерживай единообразие аннотаторов с помощью инструкций и измеряемого раунда калибровки.
Модель, обученная на непоследовательных метках, усваивает эту непоследовательность. Пятьдесят тысяч рамок, размеченных по одному ясному правилу, лучше полумиллиона рамок с двадцатью индивидуальными трактовками, а повторная разметка почти всегда обходится дешевле, чем более крупная модель. В этом уроке ты получишь линтер меток, одностраничные инструкции и способ измерить согласованность аннотаторов.
Практические занятия
Что такое метка на самом деле#
В формате YOLO для каждого изображения есть соответствующий файл .txt с одной строкой на каждый объект. Координаты нормализованы относительно ширины и высоты изображения до диапазона 0–1, поэтому метки сохраняются при изменении размера. Структура строки зависит от задачи:
| Задача | Одна метка | Примечания |
|---|---|---|
| Детекция | class x_center y_center width height | Центр и размер рамки |
| Сегментация экземпляров | class x1 y1 x2 y2 ... xn yn | Контур полигона |
| Оценка позы | class x y w h px1 py1 v1 ... pxn pyn vn | Рамка, затем ключевые точки с необязательным признаком видимости |
| OBB | class x1 y1 x2 y2 x3 y3 x4 y4 | Четыре угла повёрнутой рамки |
| Классификация | Файл меток не нужен | Изображения распределены по отдельным папкам для каждого класса |
| Семантическая сегментация | PNG-маска для каждого изображения | Значение каждого пикселя — индекс класса |
| Оценка глубины | PNG- или NPY-файл глубины для каждого изображения | Значение каждого пикселя — расстояние |
Индексы классов начинаются с 0 и сопоставляются с названиями в YAML-файле набора данных. Для изображения без объектов файл меток не нужен — так работают фоновые изображения. На страницах о формате детекции, семантической сегментации и глубине приведены рабочие примеры.
Проверь линтером файлы меток#
Повреждённые строки могут приводить к ошибкам без предупреждения: координата больше 1, идентификатор класса, не определённый в YAML, или одна и та же рамка, нарисованная для объекта дважды, — всё это становится шумом, который модель пытается усвоить. Короткий скрипт-линтер выявит такие ошибки до обучения:
from itertools import combinations
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

def iou(a, b):
    """IoU of two normalized (x_center, y_center, width, height) boxes."""
    ax1, ay1, ax2, ay2 = a[0] - a[2] / 2, a[1] - a[3] / 2, a[0] + a[2] / 2, a[1] + a[3] / 2
    bx1, by1, bx2, by2 = b[0] - b[2] / 2, b[1] - b[3] / 2, b[0] + b[2] / 2, b[1] + b[3] / 2
    inter = max(0, min(ax2, bx2) - max(ax1, bx1)) * max(0, min(ay2, by2) - max(ay1, by1))
    return inter / (a[2] * a[3] + b[2] * b[3] - inter)

def check_labels(text, names):
    """Return a list of problems in one YOLO detection label file."""
    problems, boxes = [], []
    for i, row in enumerate(text.split("\n"), 1):
        values = row.split()
        if not values:
            continue
        if len(values) != 5:
            problems.append(f"row {i}: {len(values)} values, expected 5")
        elif int(values[0]) not in names:
            problems.append(f"row {i}: unknown class {values[0]}")
        elif not all(0 <= float(v) <= 1 for v in values[1:]):
            problems.append(f"row {i}: coordinates outside 0-1")
        else:
            boxes.append((i, int(values[0]), [float(v) for v in values[1:]]))
    for (i, ca, a), (j, cb, b) in combinations(boxes, 2):
        if ca == cb and iou(a, b) > 0.8:
            problems.append(f"row {j}: duplicate of row {i} (IoU {iou(a, b):.2f})")
    return problems

broken = "0 0.50 0.50 0.20 0.30\n0 0.51 0.50 0.20 0.30\n3 0.40 0.40 0.10 0.10\n0 1.20 0.50 0.10 0.10\n0 0.50 0.50 0.10"
print("\n".join(check_labels(broken, {0: "pill"})))

data = check_det_dataset("medical-pills.yaml")
files = sorted(Path(data["path"], "labels").rglob("*.txt"))
found = sum(len(check_labels(f.read_text(), data["names"])) for f in files)
print(f"medical-pills: {found} problems in {len(files)} label files")
row 3: unknown class 3
row 4: coordinates outside 0-1
row 5: 4 values, expected 5
row 2: duplicate of row 1 (IoU 0.90)
medical-pills: 0 problems in 115 label filesСамодельный пример показывает все ошибки, которые обнаруживает линтер; реальный набор данных проходит проверку без ошибок. Запускай линтер после каждой партии разметки и перед каждым запуском обучения — это занимает считаные секунды.
Почему разметка становится непоследовательной#
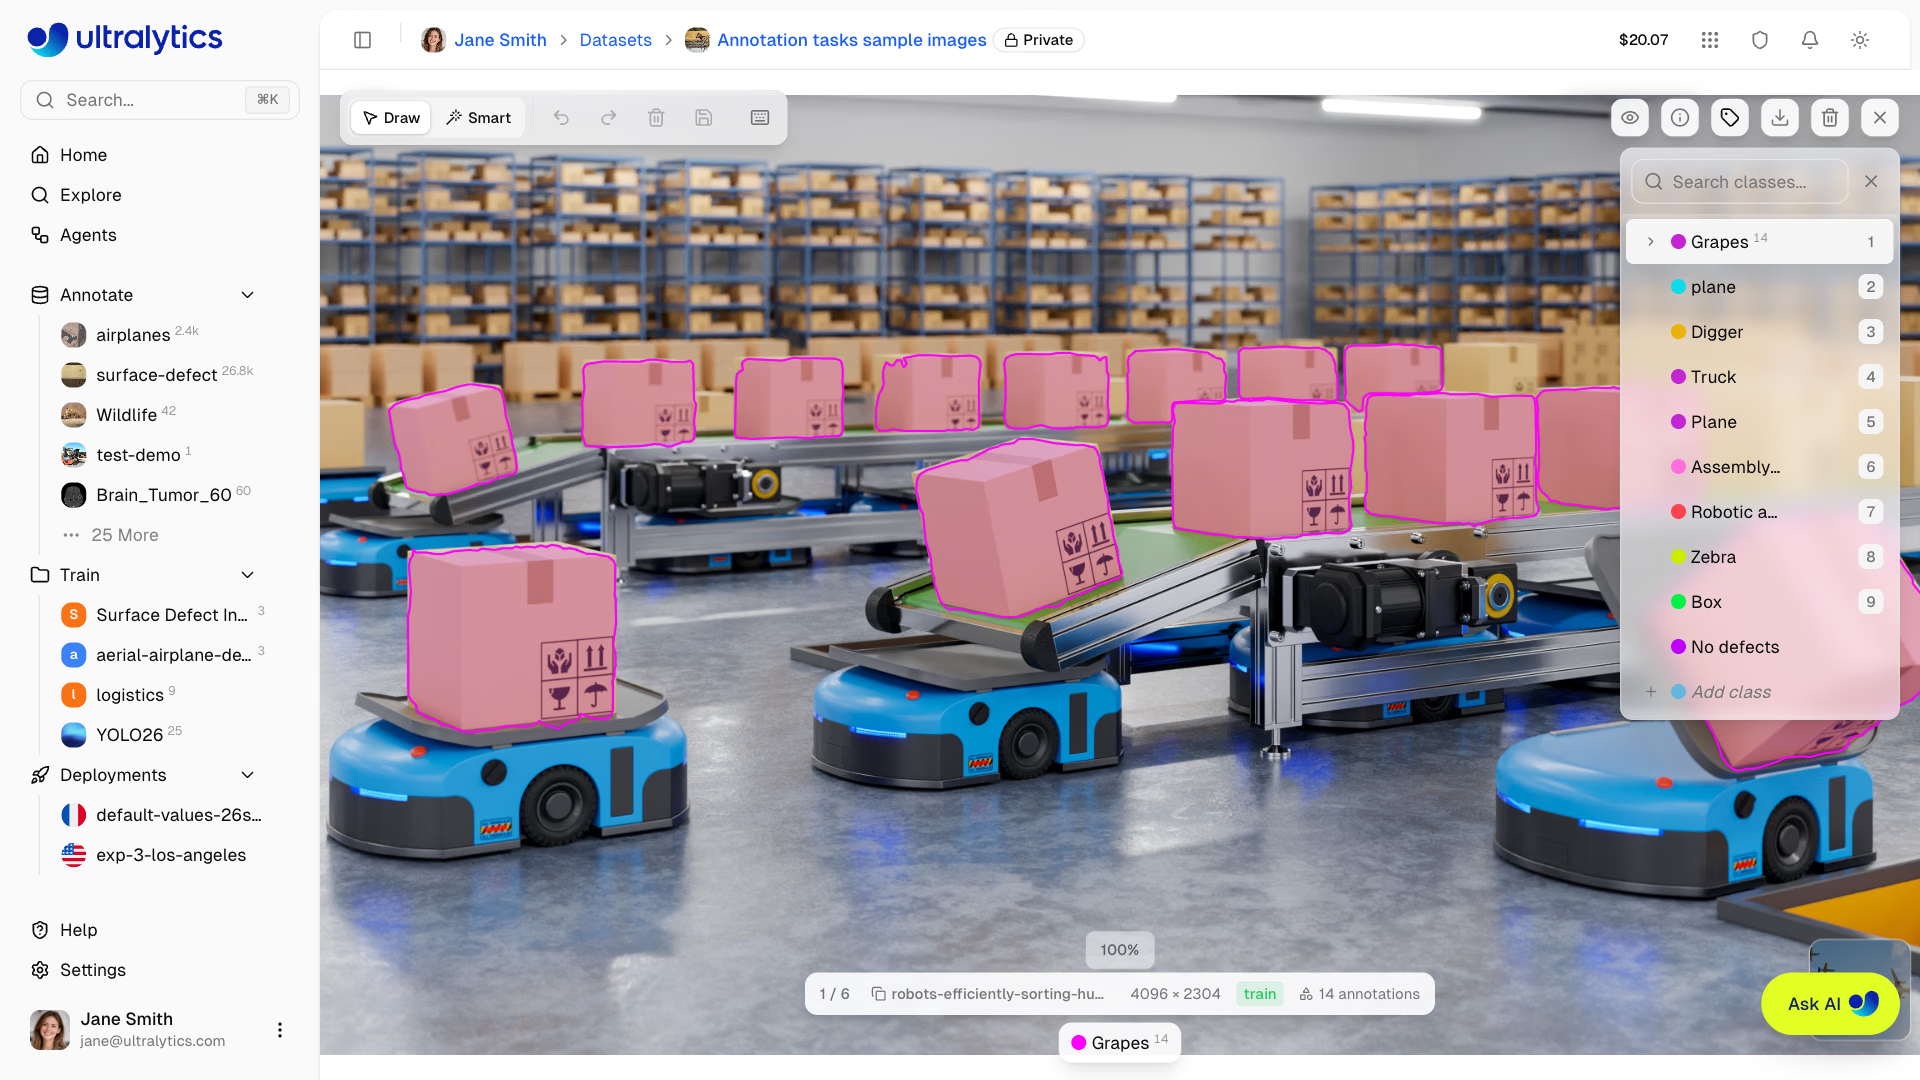
Посмотри на панель классов в этом редакторе: 14 полигонов коробок сохранены под классом Grapes, а класс Box находится ниже в списке — кроме того, plane и Plane существуют как два отдельных класса. Линтер не выявит ни одну из этих проблем: каждая строка формально корректна. Но рецензент, сверяющий метки с инструкциями, заметит обе проблемы за считаные секунды. Большинство ошибок разметки именно такие: файлы корректны, но решения неверны.
Аннотаторы редко размечают плохо из-за небрежности. Разметка становится непоследовательной, потому что правила неоднозначны и каждый делает разумный, но отличный от остальных выбор:
- Где должна заканчиваться рамка? Включать ли тень, переносимую сумку или груз на вилах погрузчика?
- Обрезанные объекты. Если человек наполовину за пределами кадра, это всё ещё
person? Какая часть объекта должна быть видна? - Окклюзия. Если видна только часть машины — например, одно колесо, — её размечать или пропускать?
- Границы классов. Пикап — это
carилиtruck? Самокат — этоbicycleилиother? - Случаи, которые не нужно размечать. Отражения, плакаты и экраны, на которых изображён объект.
Любой вариант подходит, если все выбирают одинаково.
Одностраничные инструкции#
Они умещаются на одной странице, содержат пример изображения для каждого правила и в первую очередь описывают неоднозначные случаи:
## Class: forklift

Include:
- Forklifts with at least 30% of the body visible, moving or parked, any size or color.

Do not label:
- Pallet jacks (no overhead mast) → class `pallet_jack`.
- Reflections in glass or polished floors, and forklifts on posters or screens.

Box rules:
- Include the mast and the full visible body.
- Exclude the load (pallets, boxes) — those have their own classes.
- For partly occluded forklifts, box the visible part only.
Измерь согласованность в раунде калибровки#
Прежде чем перейти от одного аннотатора к двадцати, попроси всех разметить одни и те же 50 изображений, а затем сравни результаты:
Согласованность — это доля объектов, для которых оба аннотатора указали один класс и достигли IoU не менее 0.5; это практический вариант согласованности между экспертами:
def iou(a, b):
    """IoU of two (x1, y1, x2, y2) pixel boxes."""
    w = max(0, min(a[2], b[2]) - max(a[0], b[0]))
    h = max(0, min(a[3], b[3]) - max(a[1], b[1]))
    inter = w * h
    return inter / ((a[2] - a[0]) * (a[3] - a[1]) + (b[2] - b[0]) * (b[3] - b[1]) - inter)

def agreement(boxes_a, boxes_b, threshold=0.5):
    """Share of objects both annotators drew with the same class and IoU >= threshold."""
    unmatched, matched = list(boxes_b), 0
    for cls_a, box_a in boxes_a:
        best = max(unmatched, key=lambda b: iou(box_a, b[1]) if b[0] == cls_a else -1, default=None)
        if best and best[0] == cls_a and iou(box_a, best[1]) >= threshold:
            unmatched.remove(best)
            matched += 1
    return matched / max(len(boxes_a), len(boxes_b))

# Two annotators label the same calibration image
alice = [("forklift", (100, 200, 400, 600)), ("person", (450, 220, 520, 480)), ("person", (600, 230, 660, 470))]
bob = [("forklift", (100, 120, 400, 600)), ("person", (452, 218, 522, 478)), ("pallet_jack", (600, 230, 660, 470))]
print(f"agreement: {agreement(alice, bob):.0%}")
agreement: 67%За показателем 67% скрываются два вида расхождений. Рамка Боба вокруг погрузчика начинается на 80 пикселей выше — он включил верхушку мачты, — но всё равно совпадает с рамкой Алисы по IoU 0.83, поэтому это считается согласованностью; если продукт измеряет высоту, уточни правило построения рамок. Третий объект — реальное расхождение: Алиса указывает person, а Боб — pallet_jack. Для этого нужны более ясное правило и пример изображения, после чего следует провести ещё один раунд. Сохрани эти 50 калибровочных изображений: они станут проверочным заданием для каждого нового аннотатора.
Проверяющий, который незаметно исправляет метки, разрывает цикл обратной связи, и разметчики так и не узнают, в чём ошиблись. Отклоняй разметку с указанием причины и дай разметчику исправить её. На первых ста изображениях это медленнее, зато потом намного быстрее.
Что отслеживать#
| Метрика | Что она показывает |
|---|---|
| Производительность (объектов в час) | Объём и стоимость работы |
| Доля отклонённых разметок | Ухудшается ли качество |
| Согласованность на общем наборе с пересекающимися данными | Применяют ли аннотаторы по-прежнему одни и те же правила |
Когда согласованность снижается, значит, что-то изменилось: появился новый аннотатор или камера, партия оказалась неоднозначной либо накопилась усталость. Если позже модель ошибается при определённых условиях, отправь именно эти изображения на повторную разметку — этот цикл автоматизирует активное обучение, которое даёт большую часть реального прироста точности. Просматривай и фильтруй ошибки в своих наборах данных на Ultralytics Platform, а о масштабировании процесса читай в материалах Контроль качества наборов данных и Лучшие практики аннотирования.
Показать решение
Инструкции по разметке класса pill для medical-pills, составленные после раунда калибровки на 10 изображениях:
## Class: pill

Include:
- Every tablet inside a blister cavity, including half-visible ones at the image edge.
- Tablets seen through clear plastic, even when glare covers part of them.

Do not label:
- Empty cavities, torn foil, or tablets outside the pack.
- Reflections of tablets in the foil.

Box rules:
- Box the tablet itself, not the plastic bubble around it.
- If two tablets touch, draw two boxes.
Как интерпретировать оценку согласованности: допустим, в первом раунде результат — 82%. Отсортируй несопоставленные объекты по причинам расхождений. Для блистерных упаковок обычно встречаются две причины: рамки обведены вокруг пластикового блистера, а не таблетки (исправляется первым правилом построения рамок с примером изображения), и один из аннотаторов пропустил таблетки, скрытые бликами (исправляется вторым правилом включения объектов). Повтори проверку на 10 новых изображениях; масштабируй процесс, только когда оценка превысит порог 90%.