Рекомендации по разметке
Составь руководство по разметке, выбери инструмент, избегай десяти ошибок, незаметно снижающих точность, и измерь с помощью скрипта согласованность аннотаторов перед масштабированием процесса.
Качество разметки ограничивает качество модели. Если десять аннотаторов по-разному интерпретируют понятие «паллета», пусть даже незначительно, набор данных научит модель сразу всем десяти вариантам, а обучение не устранит это противоречие. Письменное руководство, калибровочный раунд с измерением результатов и короткий список типичных ошибок помогают поддерживать единообразие разметки — независимо от того, размечает ли один человек 500 изображений или команда — 50 000.
Практические занятия
Выбери инструмент для аннотирования#
Подходящий инструмент зависит от задачи, команды и места обучения модели:
| Инструмент | Лучше всего подходит для | Примечания |
|---|---|---|
| Ultralytics Platform | Все семь задач YOLO: редактор рамок, полигонов, семантических масок, ключевых точек, повернутых рамок и классов изображений, а также загруженных карт глубины; интеллектуальная разметка с помощью SAM | Разметка, графики набора данных и обучение в одном месте; без экспорта |
| CVAT | Крупные команды, видео, сложные процессы проверки | Локальное размещение или облако |
| Label Studio | Мультимодальные проекты (изображения + текст + аудио) | Гибкая настройка, но освоить инструмент сложнее |
| Labelme | Разметка полигонами для небольших команд | Простое настольное приложение |
| LabelImg | Быстрое прототипирование с разметкой только рамками | Легковесный инструмент; репозиторий архивирован |
На Ultralytics Platform интеллектуальная разметка с помощью SAM 2.1, SAM 3 и SAM 3.1 работает с наборами данных для обнаружения объектов, сегментации, семантической сегментации и OBB. Какой бы инструмент ты ни выбрал, убедись, что он экспортирует нужный для задачи формат YOLO; в материале «Подготовка пользовательского набора данных» описаны формат разметки и преобразование данных.
Семь типов разметки#

| Тип разметки | Что нужно нарисовать | Задача |
|---|---|---|
| Метка класса | Одна метка на изображение | Классификация |
| Ограничивающая рамка | Прямоугольник без наклона для каждого объекта | Детекция |
| Полигон | Контур каждого экземпляра объекта | Сегментация экземпляров |
| Плотная маска | Класс для каждого пикселя | Семантическая сегментация |
| Ключевые точки | Именованные точки, например суставы | Поза |
| Ориентированная рамка | Повернутый прямоугольник для каждого объекта | OBB |
| Карта глубины | Ничего: карта расстояний для каждого пикселя, полученная с датчика глубины и связанная с каждым изображением | Оценка глубины |
Сначала составь руководство по разметке#
До того как кто-либо начнет рисовать рамки, составь руководство из пяти разделов:
- Определения классов: один абзац на каждый класс с положительными примерами, похожими объектами, которые не относятся к этому классу, и пограничными случаями.
- Правила рисования: плотно обводи видимый объект рамками; проводи полигоны по видимому контуру.
- Правила обработки перекрытий и размера: установи единый порог для частично видимых объектов («размечай, если класс можно определить») и мелких объектов («размечай людей выше 10 пикселей») и применяй их везде.
- Журнал неоднозначных случаев: записывай каждый вопрос «а как быть с этим случаем?» вместе с согласованным ответом и снимком экрана.
- Что пропускать: все, что не нужно размечать для этой задачи.
Достаточно одной-двух страниц со снимками экрана. Затем руководство задает короткий цикл действий, который выполняют до масштабирования разметки:
Размечай каждый значимый объект на каждом изображении. Неразмеченный погрузчик учит модель считать погрузчики фоном, поэтому она учится их пропускать. До начала обучения частично размеченный набор данных выглядит так же, как полностью размеченный набор меньшего размера. Полностью размечай каждое изображение, прежде чем переходить к следующему.
Десять ошибок, снижающих точность#
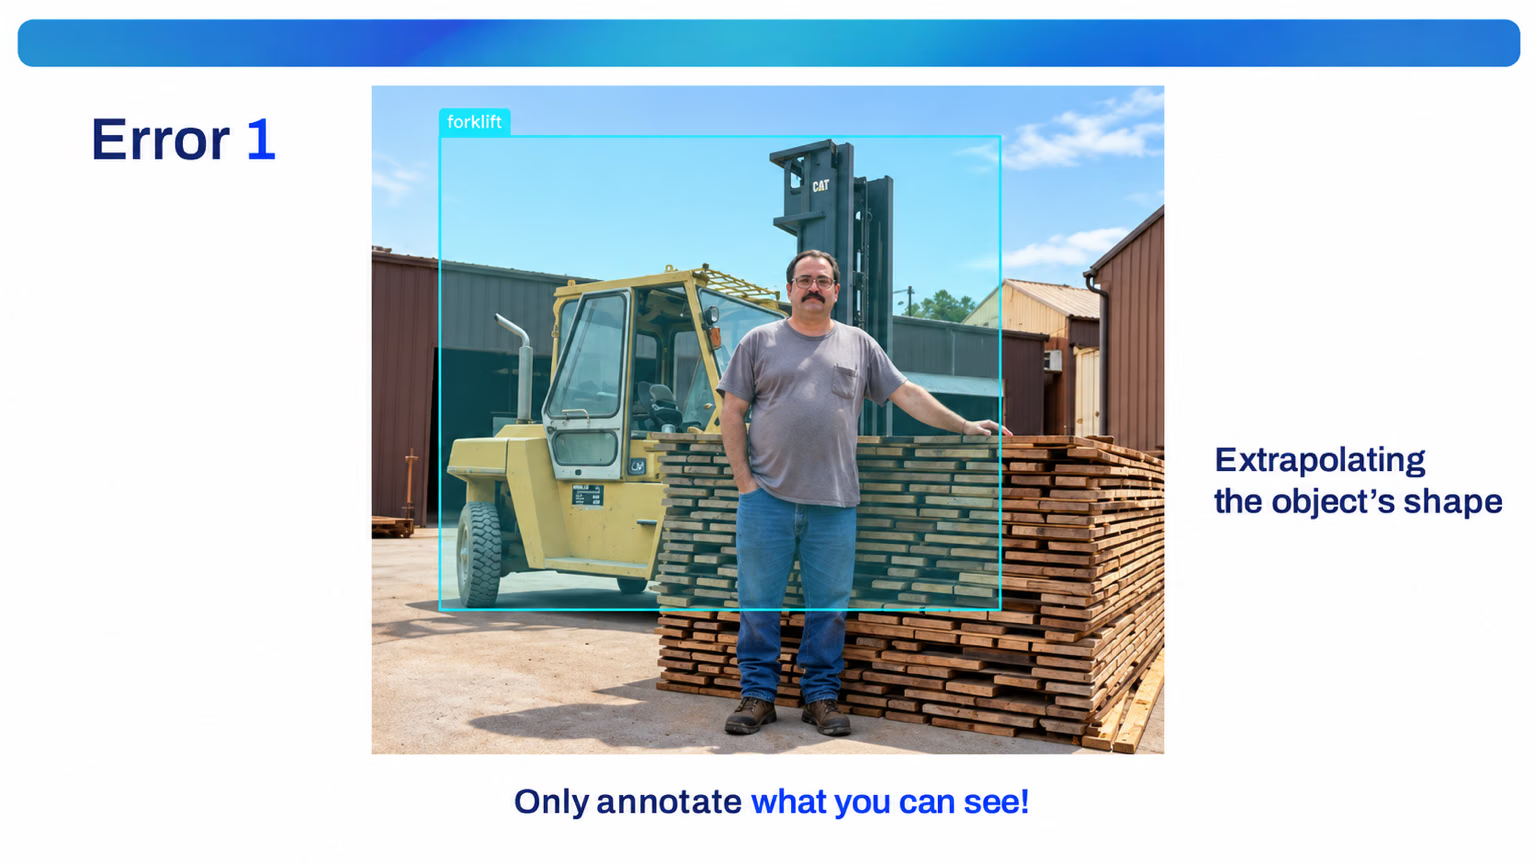
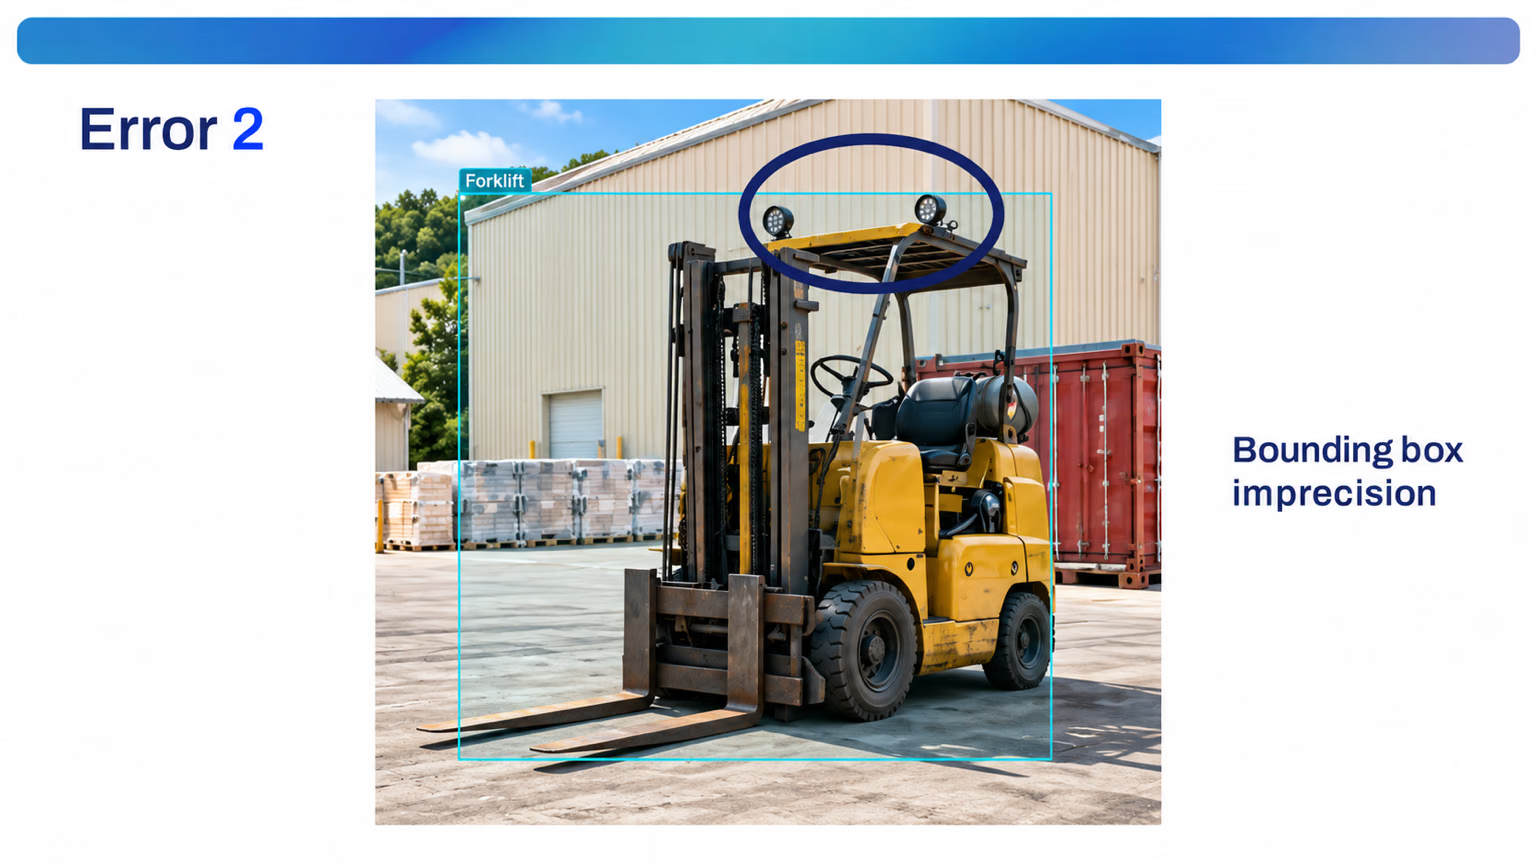
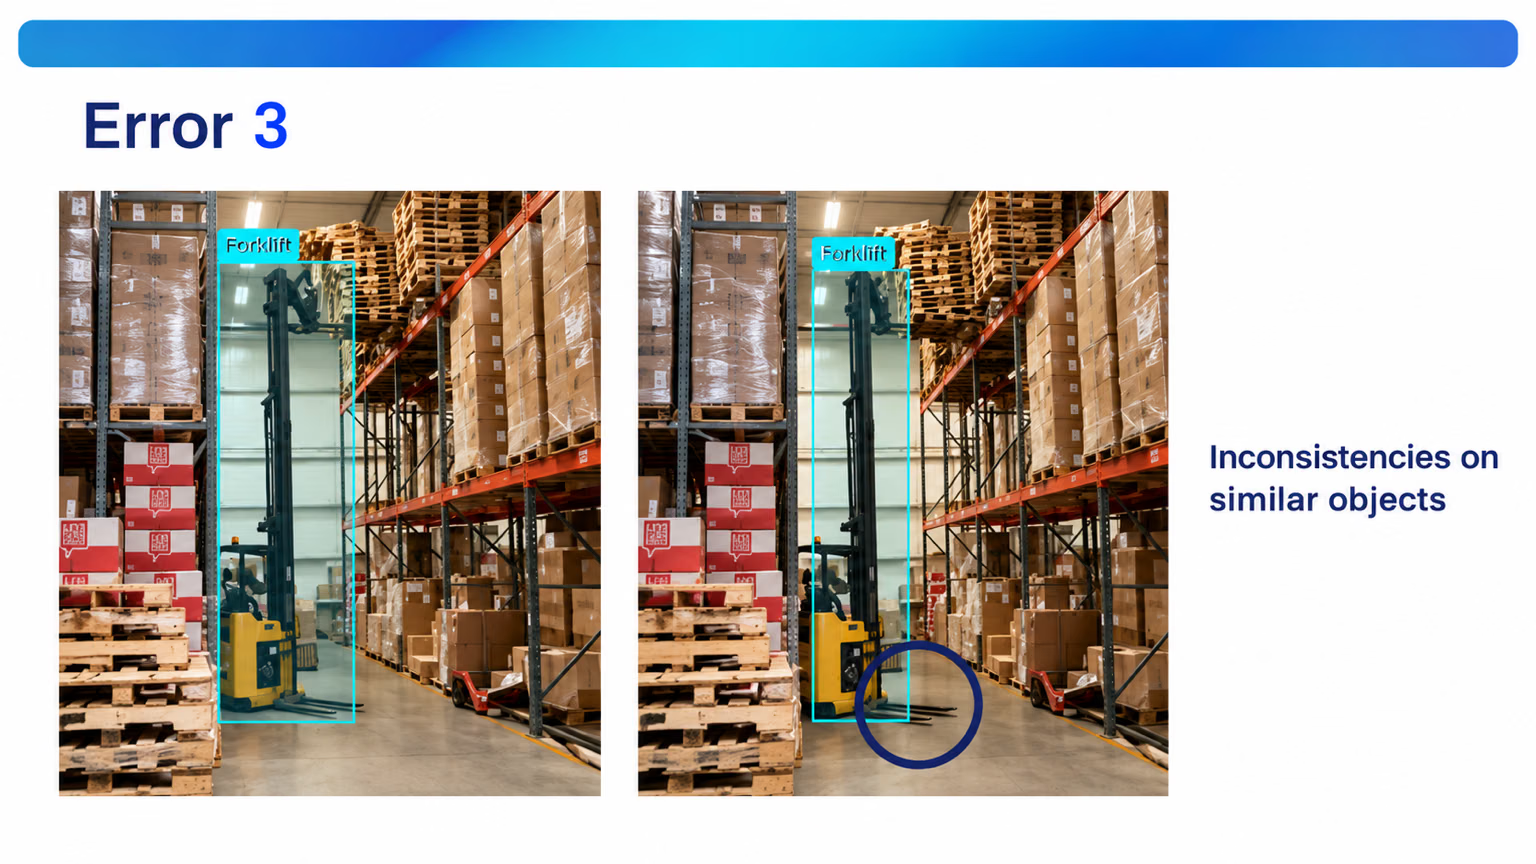
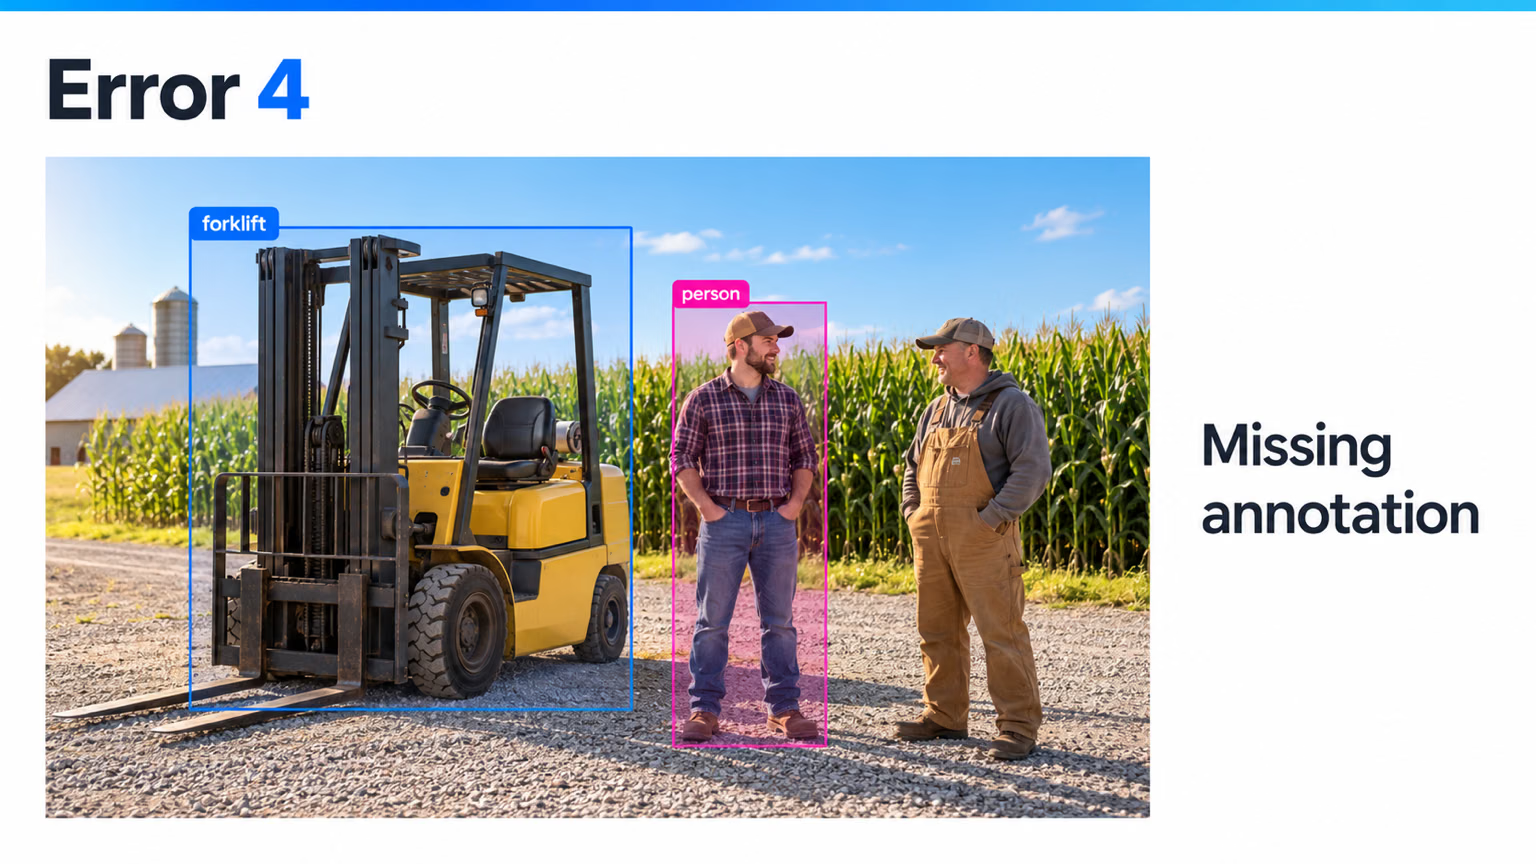
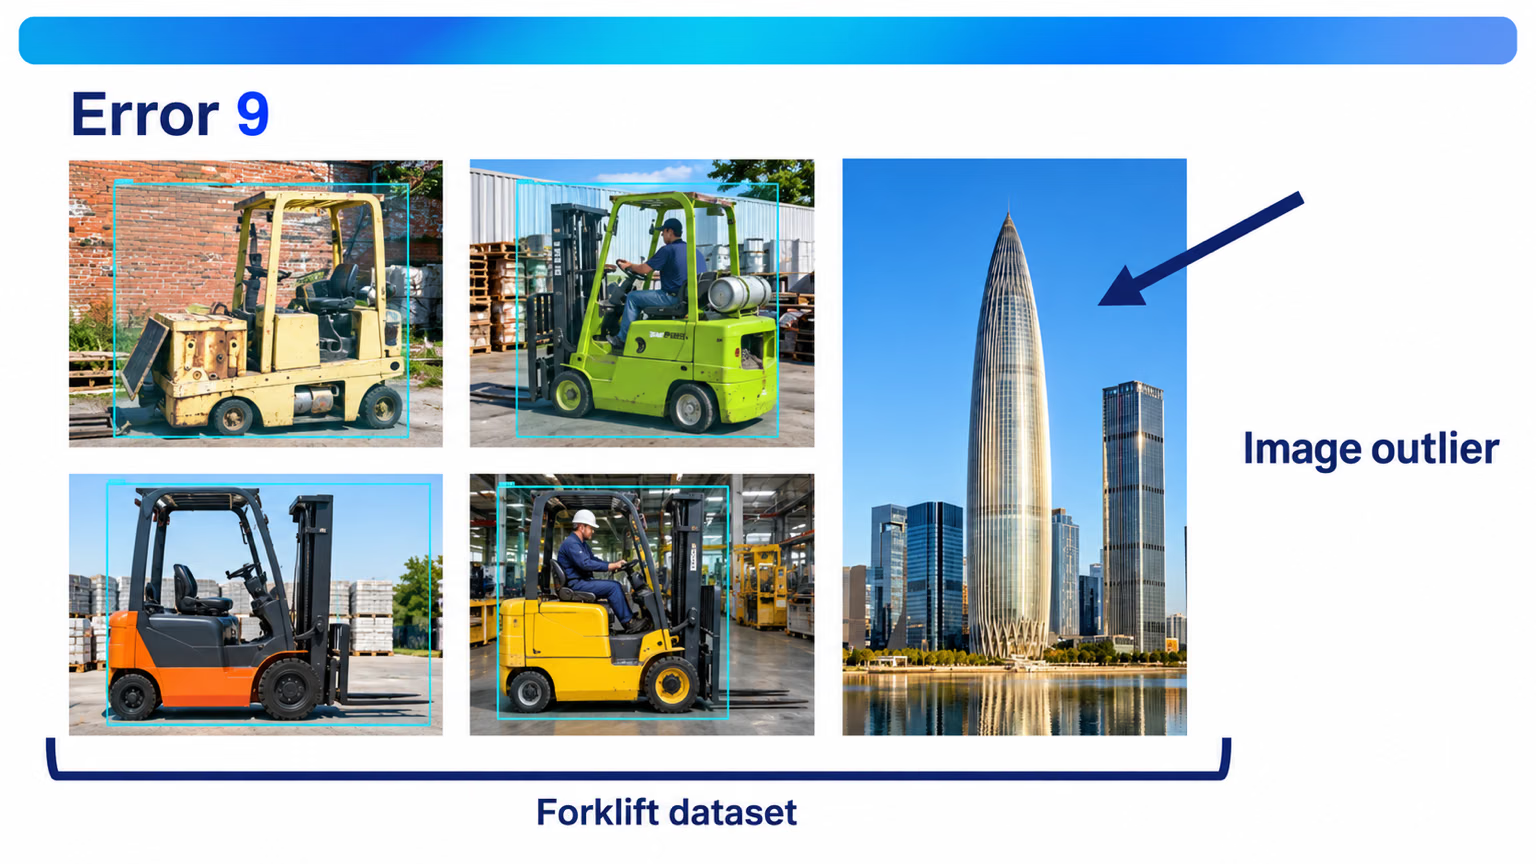
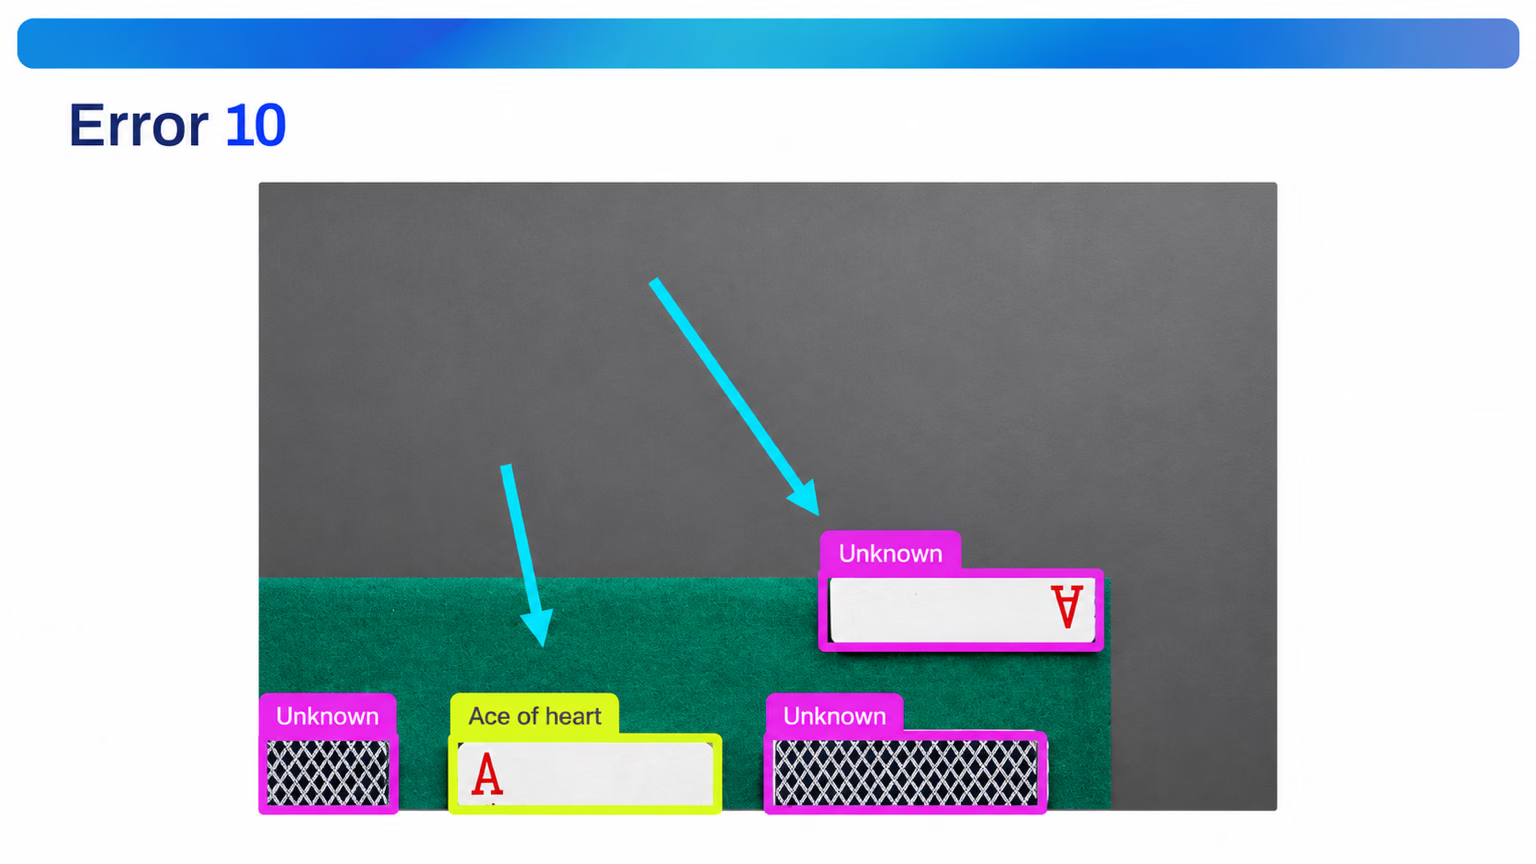
Самые частые ошибки, которые замечает команда Ultralytics по аннотированию, показаны на изображениях погрузчика, человека и паллеты (адаптировано по презентации Алексиса Шутцгера). Добавь их в руководство как первые примеры.
1. Дорисовывание формы объекта. Размечай только то, что видно. Здесь погрузчик стоит за человеком и штабелем пиломатериалов, но рамка охватывает их обоих и проходит там, где аннотатор представил оставшуюся часть машины. Обведи только видимую часть.
2. Неточные рамки. Рамки должны плотно охватывать объект. Эта рамка пересекает огни защитного козырька; если рамка срезает часть объекта или оставляет вокруг него запас пола, модель усваивает неверные границы.
3. Несогласованные правила разметки похожих объектов. Левая рамка включает вилы, а правая — нет. Модель получает два ответа на один и тот же вопрос, поэтому зафиксируй правило: вилы включать или не включать.
4. Пропущенные аннотации. Рядом с погрузчиком стоят два человека, но рамкой отмечен только один. Для модели неразмеченный человек становится примером того, что «люди — это фон».
5. Неверный класс. Проверяй класс, а не только рамку. Правильная рамка вокруг погрузчика с меткой person искажает оба класса; обычно это происходит из-за случайного нажатия сочетания клавиш.
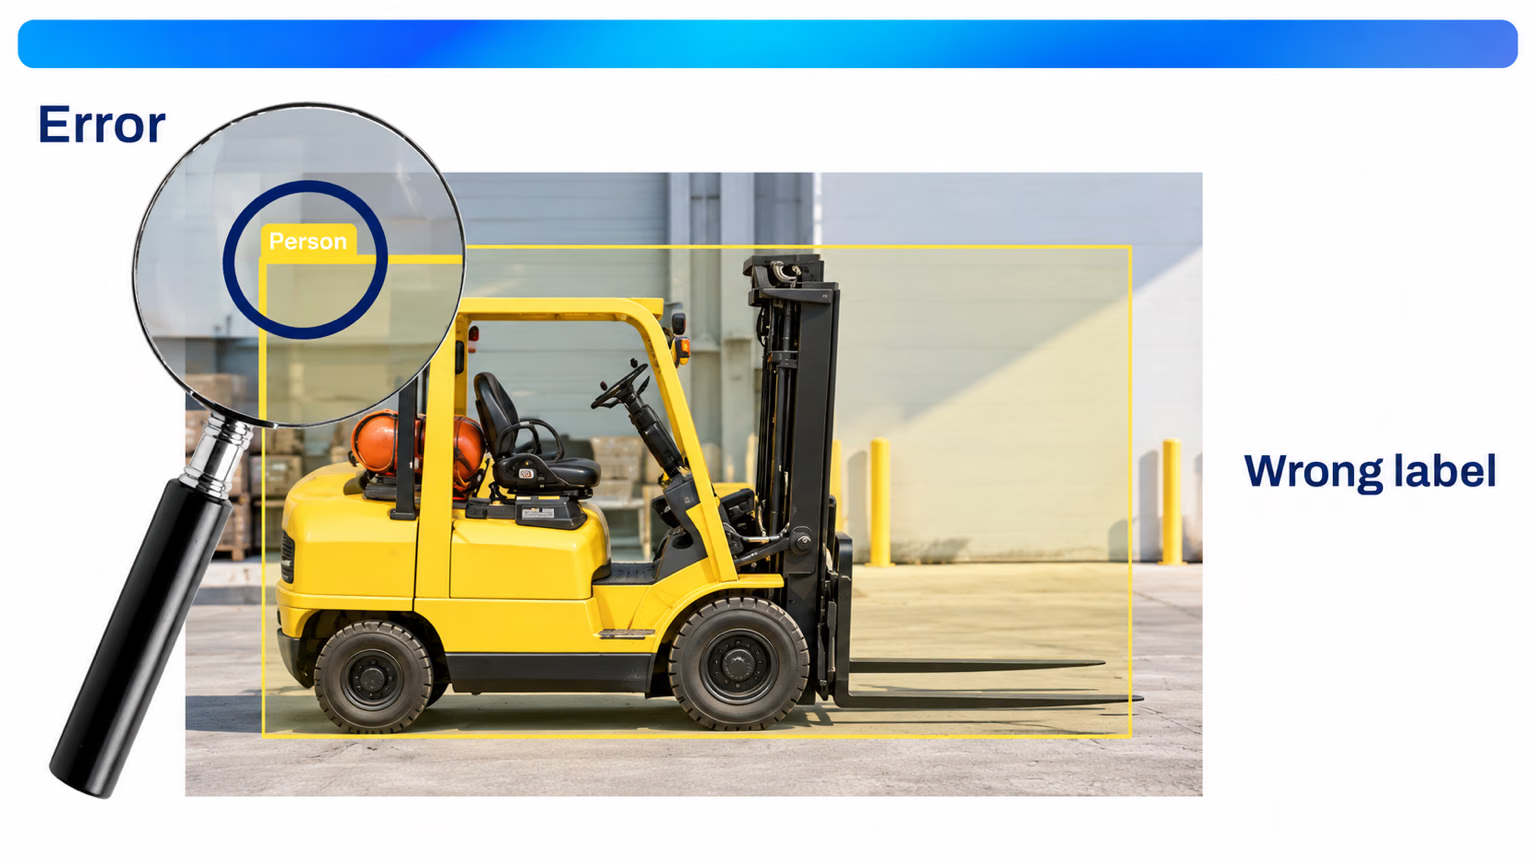
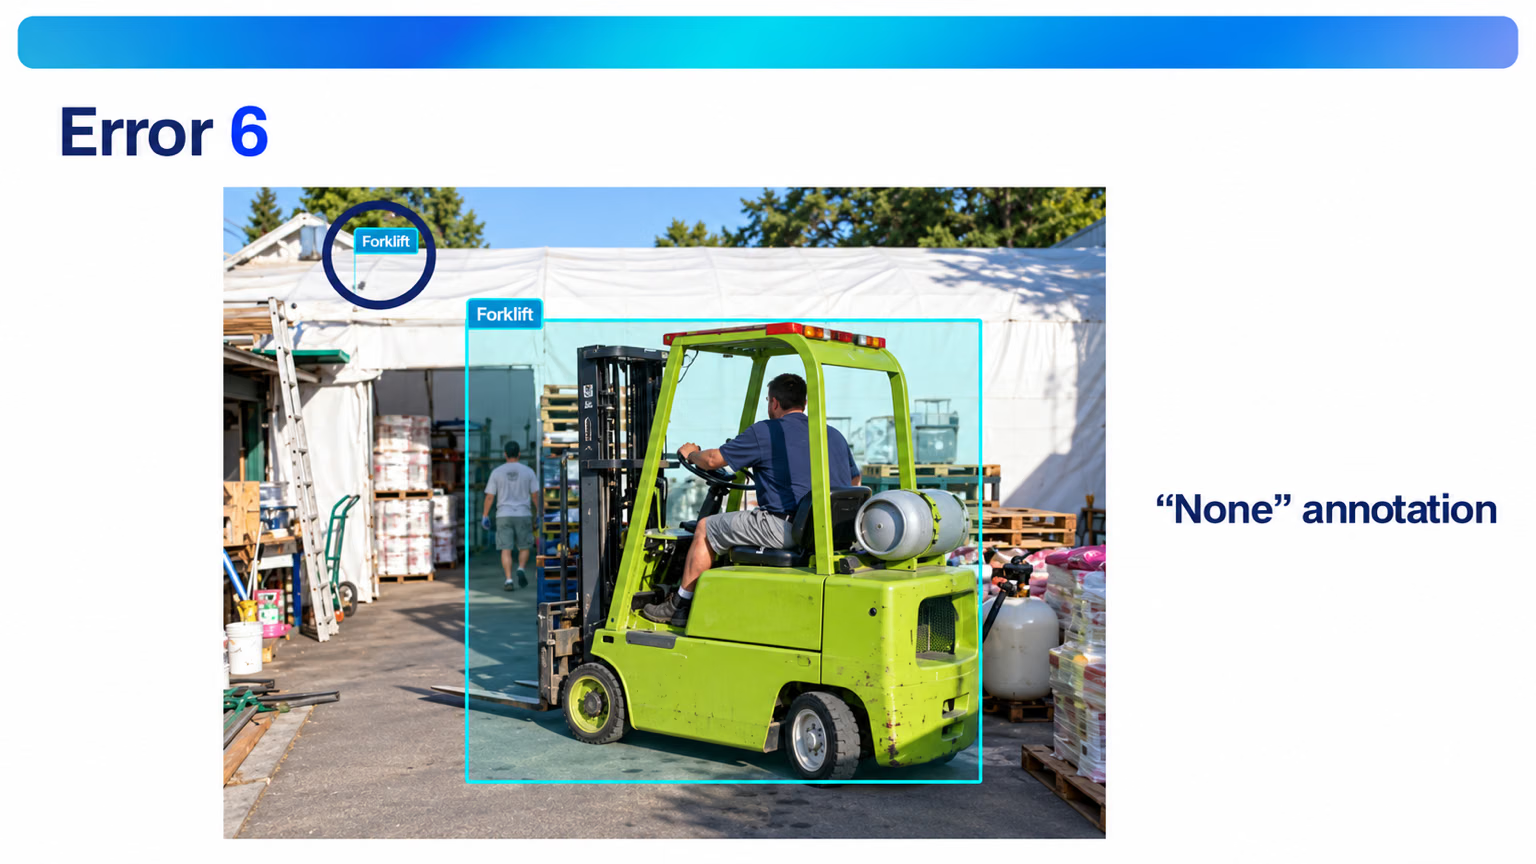
6. Пустые или случайные аннотации. В каждой аннотации должен быть реальный объект и реальный класс. Случайный щелчок оставляет почти пустую рамку, как в углу этого изображения, а рамка, сохранённая без класса, может экспортироваться как None или класс 0. Исправь такие аннотации или удали их.
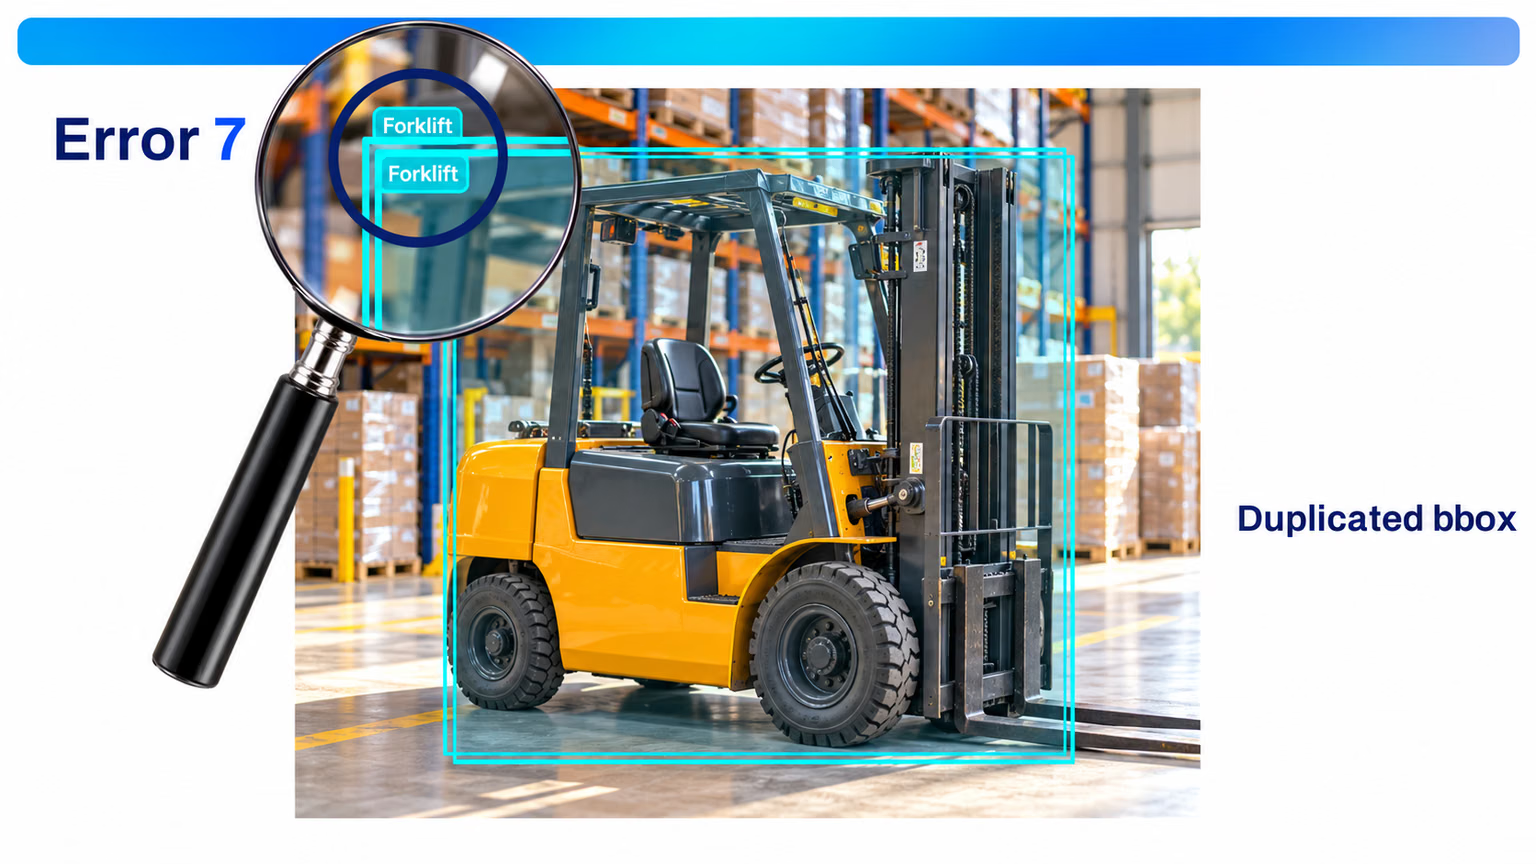
7. Дублирующиеся рамки. Один объект — одна рамка. Две перекрывающиеся рамки вокруг одного погрузчика завышают число экземпляров и учат модель предсказывать дубликаты.
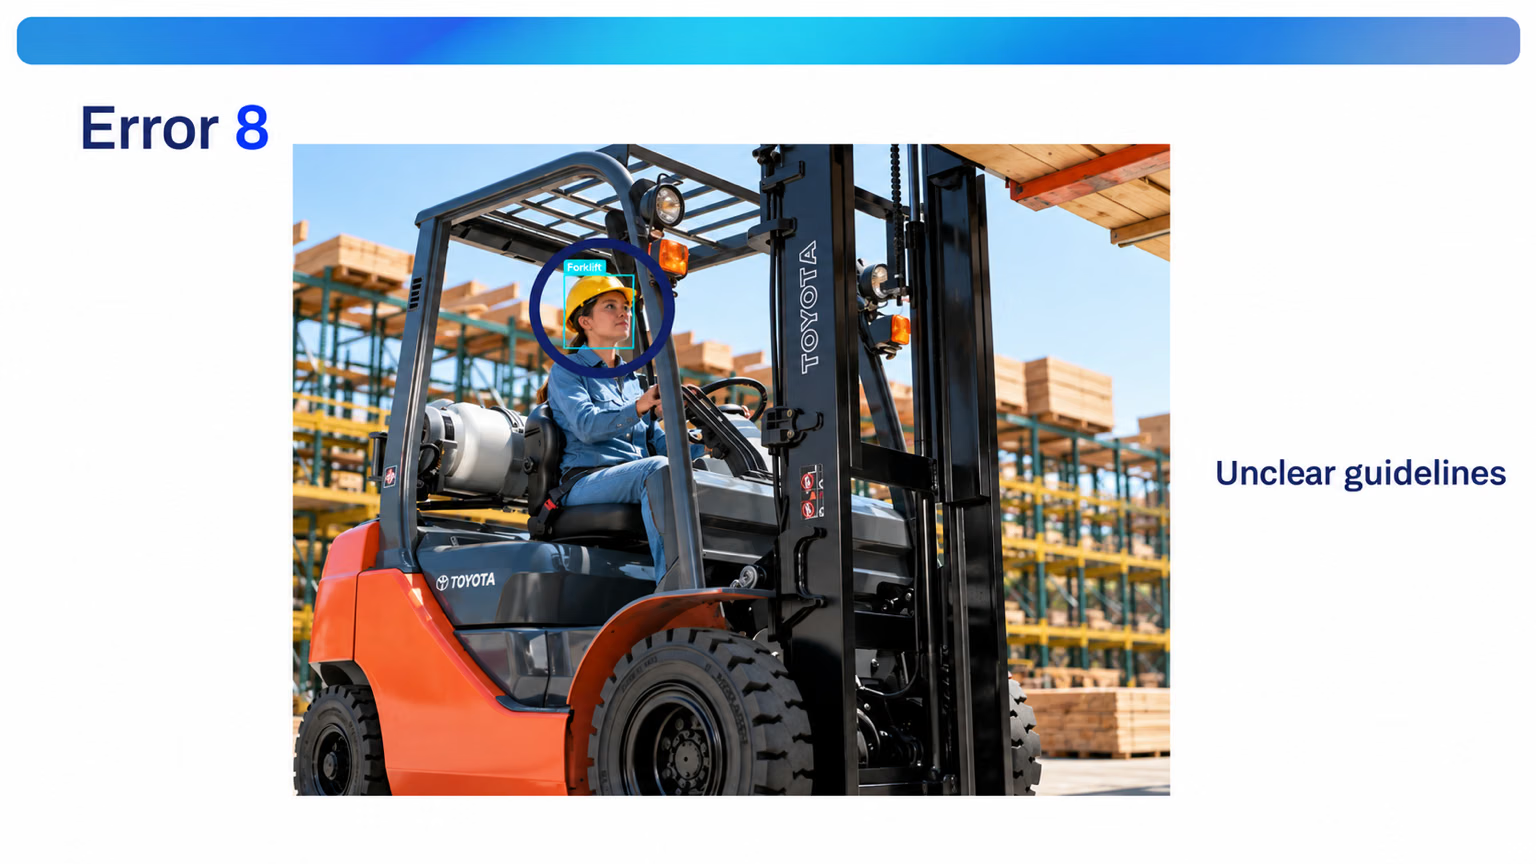
8. Неясные правила. Без письменных правил разметчики действуют на своё усмотрение: здесь один из них обвёл только голову водителя и присвоил ей класс forklift. Водитель — часть погрузчика или отдельный person? Дай ответ на этот вопрос один раз в руководстве.
9. Выбросы среди изображений. Удаляй изображения, не соответствующие условиям эксплуатации. Фотография городского пейзажа в наборе данных с погрузчиками ничему полезному не учит и снижает качество всего остального.
10. Неоднозначность из-за аугментации. Если при кадрировании можно удалить признак, определяющий класс, два класса становятся неразличимыми. Если срезать угловой символ с червового туза, он станет похож на карты с меткой unknown. В статье Осторожно применяй аугментацию описано решение.
Измеряй согласованность, а не гадай#
Во время калибровочного раунда два разметчика получают одни и те же изображения, а их метки сравниваются для каждого объекта. Метки считаются совпавшими, если у них один класс и их перекрытие составляет не менее 0.5 по метрике IoU. Этот скрипт вычисляет оценку на изображениях val из COCO8. Чтобы запустить скрипт без второго человека, в роли разметчика B выступает предварительно обученная модель; при работе с реальной командой считывай рамки B из файлов его разметки:
from pathlib import Path

import torch

from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset, img2label_paths
from ultralytics.utils.metrics import box_iou
from ultralytics.utils.ops import xywh2xyxy

data = check_det_dataset("coco8.yaml")
model = YOLO("yolo26n.pt")  # stands in for a second annotator; compare two label folders the same way
names = data["names"]

matched = total = 0
for image in sorted(Path(data["val"]).glob("*.jpg")):
    rows = [r.split() for r in Path(img2label_paths([str(image)])[0]).read_text().splitlines() if r.strip()]
    a_cls = torch.tensor([int(r[0]) for r in rows])  # annotator A: the dataset labels
    a_box = xywh2xyxy(torch.tensor([[float(v) for v in r[1:]] for r in rows]))
    b = model(image, conf=0.5, verbose=False)[0].boxes  # annotator B: confident model proposals
    iou = box_iou(a_box, b.xyxyn)
    used = set()
    for i in range(len(rows)):  # pair each A object with the best unused same-class B box at IoU >= 0.5
        ok = [j for j in range(len(b)) if j not in used and b.cls[j] == a_cls[i] and iou[i, j] >= 0.5]
        if ok:
            used.add(max(ok, key=lambda j: iou[i, j]))
        else:
            print(f"{image.name}: {names[int(a_cls[i])]} labeled by A only")
    for j in set(range(len(b))) - used:
        print(f"{image.name}: {names[int(b.cls[j])]} labeled by B only")
    matched += len(used)
    total += len(rows) + len(b) - len(used)

print(f"agreement: {matched}/{total} objects = {matched / total:.0%}")
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: potted plant labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000061.jpg: person labeled by A only
000000000061.jpg: elephant labeled by A only
000000000061.jpg: person labeled by A only
agreement: 8/17 objects = 47%Как это читать:
- Оценка — это число сопоставленных объектов, делённое на общее число объектов, отмеченных любым из разметчиков: 8 из 17.
- Расхождения группируются. Все девять расхождений приходятся на два изображения, и большинство из них — люди, занимающие намного меньше 1% кадра. Это не девять случайных ошибок, а отсутствие одного правила: размечаем ли мы людей вдали?
- Решение — добавить правило в руководство, например: «Размечай каждого человека высотой не менее 10 пикселей на изображении размером 640 пикселей». Оба разметчика размечают эти два изображения заново, после чего оценка вычисляется повторно.
Правило принятия решения: наращивай объём разметки, только когда согласованность достигает 90%. Если она ниже, каждый новый разметчик умножает число расхождений.
Ускоряй разметку с помощью интеллектуальных инструментов#
Интеллектуальная разметка позволяет модели YOLO или SAM предлагать метки, которые человек принимает или исправляет; это может в несколько раз повысить производительность. Запускай процесс итерациями: обучи модель на проверенной выборке, используй её для разметки следующей, проверь результат и переобучи модель. Это цикл активного обучения, который подробно разобран на Ultralytics Platform в статье Интеллектуальная разметка и пакетная маркировка.
Модель, которая пропускает маленьких людей, не предлагает рамки для маленьких людей, а проверяющий, нажимающий «принять всё», не добавляет их сам. Следующая модель, обученная на этих метках, пропускает их с ещё большей уверенностью. Проверяй каждое изображение и добавляй пропущенные моделью объекты, а также исправляй ошибки в её разметке.
Проверь визуально#
Каждый запуск обучения Ultralytics сохраняет labels.jpg и train_batch*.jpg в папку запуска. Первый файл строит графики количества классов, а также расположения и размеров рамок; в остальных показаны настоящие обучающие изображения с наложенными метками. Открой их до завершения первой эпохи. Визуальная проверка выявляет то, что не покажут метрики: рамки вокруг теней, перепутанные идентификаторы классов и незамкнутые полигоны.
Показать решение
Расхождения в COCO8 превращаются в такие записи в руководстве:
| Расхождение | Добавленное в руководство правило |
|---|---|
Только разметчик A отметил людей вдали в 000000000049.jpg | Размечай каждого человека высотой не менее 10 пикселей на изображении размером 640 пикселей; людей меньшего размера пропускай на всех изображениях. |
| Только разметчик A отметил растение в горшке у края кадра | Размечай объект, обрезанный краем кадра, если видна хотя бы половина объекта. |
Слон частично скрыт другим слоном в 000000000061.jpg | Размечай перекрытых животных, если видна голова или половина тела; обводи только видимую часть. |
Чтобы сравнить разметку двух людей, а не человека и модели, считай строки разметчика B из второй папки с разметкой точно так же, как скрипт считывает строки разметчика A (Path("labels_b", image.stem + ".txt")), создай на их основе b_cls и b_box с помощью тех же двух строк и используй их везде, где скрипт обращается к b.cls и b.xyxyn. Повтори проверку после повторной разметки; раунд завершён, когда оценка превысит 90%.