Умная разметка и пакетная маркировка
Выбери модель для разметки и порог уверенности, измерив объём работы по проверке. Затем запусти пакетную аннотацию и оцени долю правок.
Ручная отрисовка рамок занимает примерно час на 100 изображений; проверка качественной предварительной разметки может быть в несколько раз быстрее. Но модель для разметки с неправильно выбранным порогом уверенности может добавить работы вместо того, чтобы её сократить, а непроверенные предсказания научат следующую модель собственным ошибкам. В этом уроке объём работы по проверке измеряется для разных порогов на настоящих размеченных данных, чтобы ты выбрал порог на основе чисел, а не догадок.
Практические занятия
Три способа предварительной разметки#
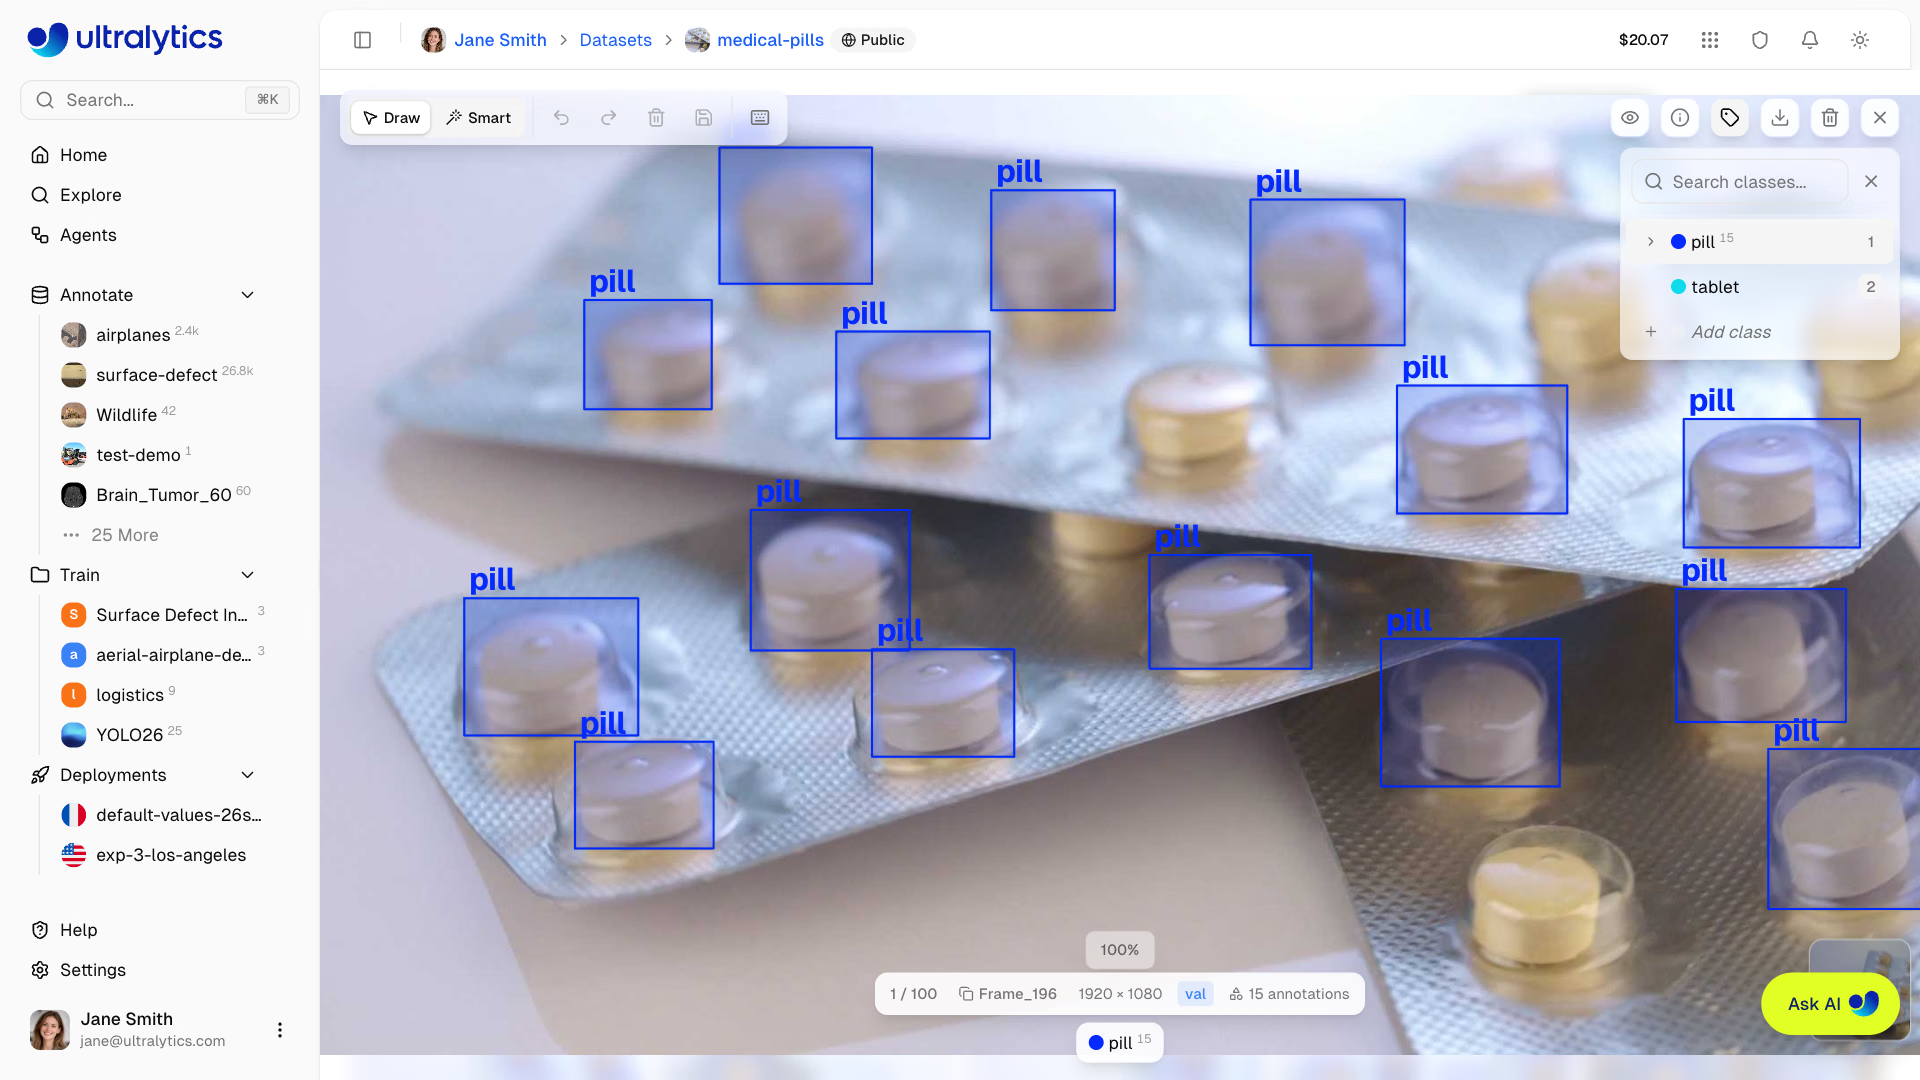
В редакторе аннотаций режим Draw (V) предназначен для ручной разметки, а режим Smart (S) позволяет модели предлагать метки:
| Семейство | Принцип работы | Задачи | Стоимость |
|---|---|---|---|
| SAM (SAM 2.1 Tiny—Large, SAM 3, SAM 3.1 — по умолчанию) | Щёлкни по объекту, чтобы создать маску; щёлкни вне его, чтобы добавить область, внутри — чтобы вычесть её; A включает и выключает автоматическое применение. | Обнаружение объектов, сегментация, семантическая сегментация, OBB | Free |
| YOLO (официальные модели или собственные модели) | Predict добавляет детекции модели; Map classes сопоставляет классы модели с классами датасета; дубликаты с IoU от 0.7 отбрасываются. | Обнаружение объектов, сегментация, семантическая сегментация, OBB, позы | Бесплатно в редакторе |
| С указанием классов (Moondream 3.1 — по умолчанию, YOLOE-26x, SAM 3 Text и другие) | Находит в изображении объекты, соответствующие названиям классов датасета; платные модели провайдеров работают с твоим собственным API-ключом. | Датасеты для обнаружения объектов с 1–200 классами | Хостируемые модели — бесплатно |
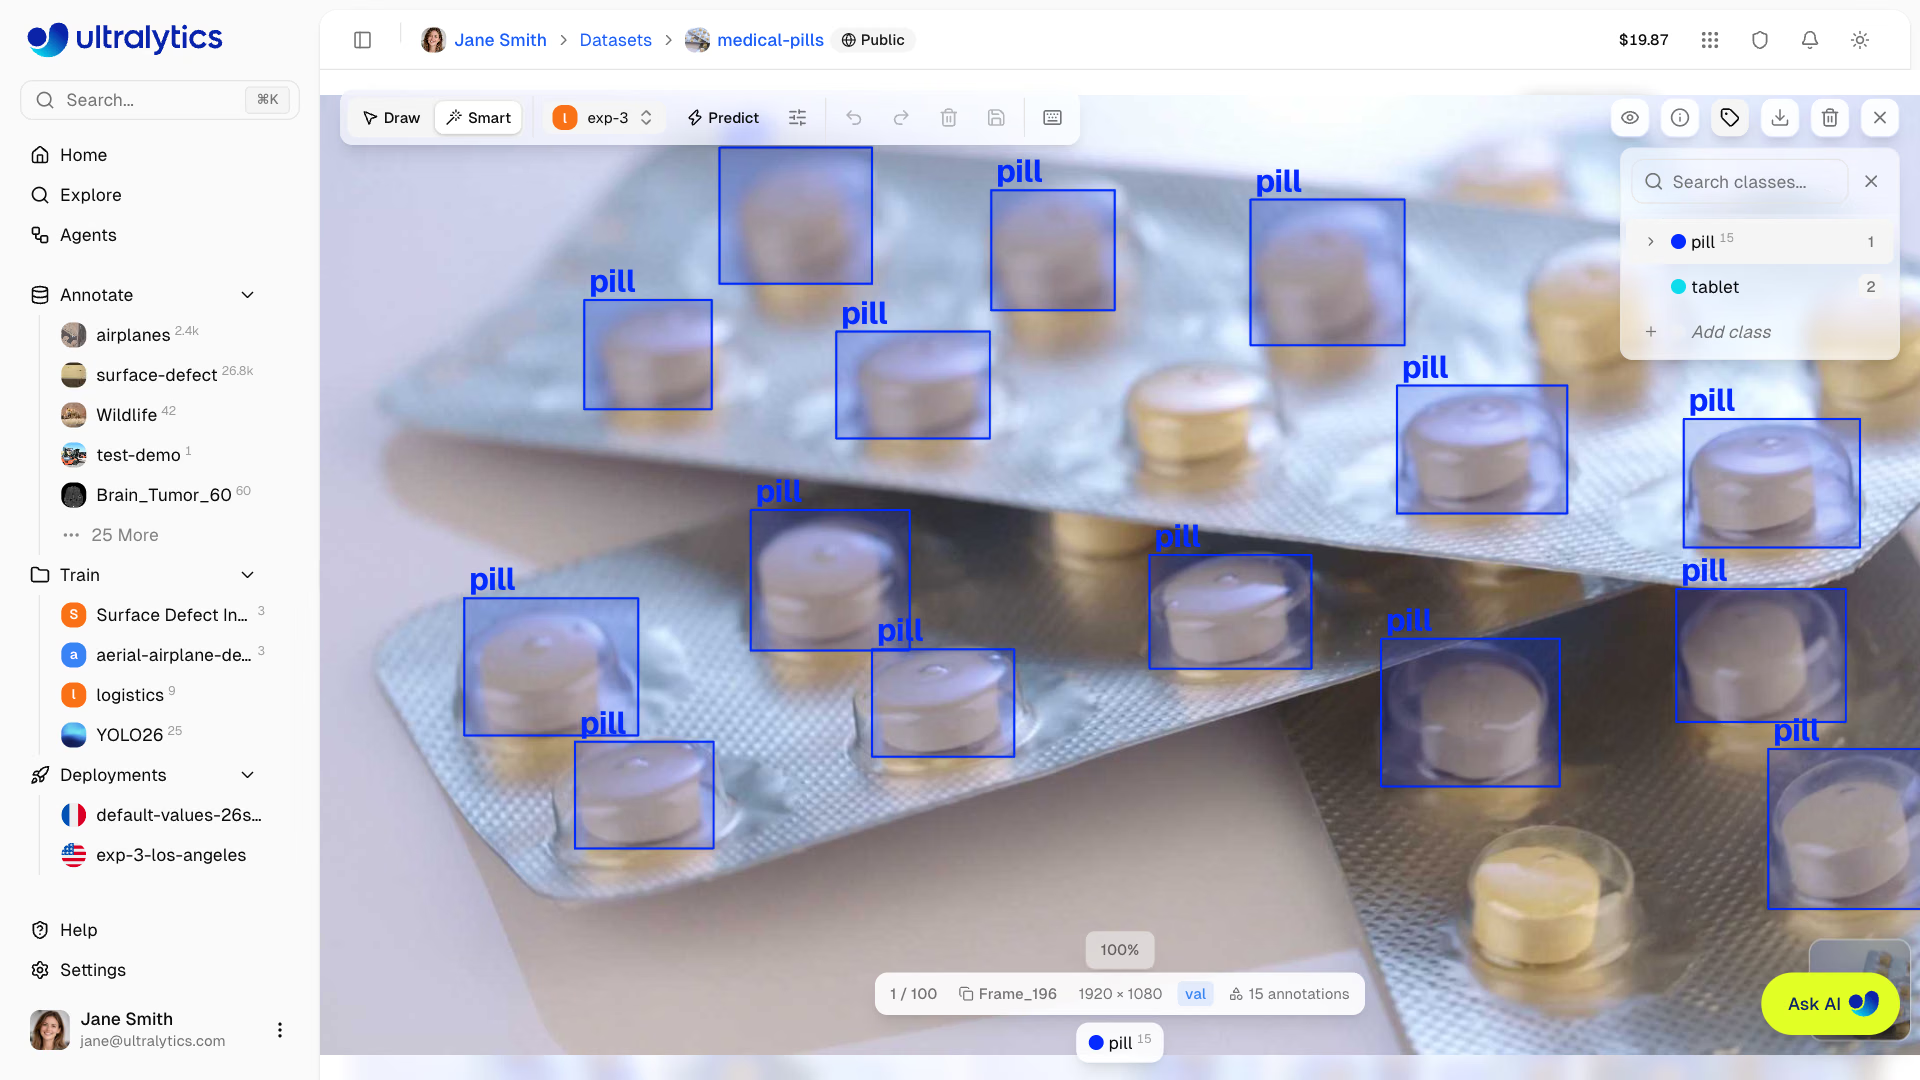
Для SAM нужен один щелчок на объект, зато она создаёт наиболее точные формы. Для предсказаний модели нужен один щелчок на изображение, а качество зависит от модели. Поэтому в оставшейся части урока мы разберём, как выбрать и настроить эту модель.
Выбери модель для разметки#
Даже слабая модель v0, обученная на 100–200 размеченных вручную изображениях, лучше разметки с нуля, а к версии v1 она обычно становится полезным партнёром в активном обучении. Результаты моделей с указанием классов сильно зависят от предметной области: некоторые модели, находящие почти все объекты на обычных фотографиях, пропускают большинство объектов на изображениях печатных плат, рентгеновских снимках или товаров в магазинах. Поэтому перед тем, как полагаться на такую модель, проверь десять её предсказаний.
Пример: измеряем объём работы по проверке для каждого порога#
Порог уверенности определяет, на что рецензенты потратят время: при слишком низком пороге они удаляют ложные рамки, а при слишком высоком — дорисовывают пропущенные моделью. Измерь это на изображениях с уже правильными метками. В примере используется 128 размеченных изображений из COCO128, а модель для разметки — предварительно обученная YOLO26n:
from pathlib import Path

import torch

from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset
from ultralytics.utils.metrics import box_iou
from ultralytics.utils.ops import xywhn2xyxy

data = check_det_dataset("coco128.yaml")  # 128 labeled images, downloaded on first use
images = sorted(Path(data["train"]).glob("*.jpg"))
results = YOLO("yolo26n.pt").predict(images, conf=0.05, verbose=False)  # your labeling model

def review_work(result, image, conf):
    """Return (kept, delete, draw): correct pre-labels, false positives to delete, missed objects to draw."""
    label = Path(str(image).replace("images", "labels")).with_suffix(".txt")
    lines = label.read_text().splitlines() if label.exists() else []  # no label file = background image
    gt = torch.tensor([[float(x) for x in line.split()] for line in lines]).reshape(-1, 5)
    h, w = result.orig_shape
    gt_boxes, gt_cls = xywhn2xyxy(gt[:, 1:], w=w, h=h), gt[:, 0]
    boxes = result.boxes[result.boxes.conf >= conf]
    iou = box_iou(boxes.xyxy, gt_boxes) * (boxes.cls[:, None] == gt_cls[None])  # IoU with same-class boxes only
    matched = set()
    for row in iou:  # greedily match each prediction to its best unmatched ground-truth box
        for j in row.argsort(descending=True).tolist():
            if row[j] >= 0.5 and j not in matched:
                matched.add(j)
                break
    return len(matched), len(boxes) - len(matched), len(gt) - len(matched)

print("conf  kept  delete  draw  edits/image")
for conf in (0.1, 0.25, 0.4, 0.5, 0.7):
    kept, delete, draw = (sum(t) for t in zip(*(review_work(r, i, conf) for r, i in zip(results, images))))
    print(f"{conf:<5} {kept:>4} {delete:>7} {draw:>5} {(delete + draw) / len(images):>12.1f}")
conf kept delete draw edits/image
0.1 590 490 339 6.5
0.25 468 138 461 4.7
0.4 386 58 543 4.7
0.5 328 35 601 5.0
0.7 230 6 699 5.5Как это работает и что показывают результаты:
- Модель один раз выполняет предсказание при низком значении
conf=0.05; затем каждый порог фильтрует один и тот же набор предсказаний, поэтому проверка разных порогов проходит быстро. review_workсопоставляет каждое предсказание с эталонной рамкой того же класса, если IoU составляет не менее 0.5. Несопоставленные предсказания — это рамки, которые рецензент удаляет; несопоставленные эталонные объекты — те, которые рецензент дорисовывает.- Минимум правок на изображение достигается при пороге 0.25–0.4 (4.7). Ниже этого значения резко растёт число удалений, выше — число пропусков.
- Даже при оптимальном пороге рецензенты дорисовывают около 3.6 рамки на изображение: модели nano трудно обнаруживать мелкие объекты, составляющие длинный хвост распределения COCO.
Правила выбора: выбери порог, при котором меньше всего правок на изображение. Если при любом пороге преобладает дорисовка, модель для разметки слишком слабая для этих данных — используй более крупную модель или собственную дообученную модель. Если даже при 0.5 преобладают удаления, модель путает похожие классы — прежде чем размечать новые данные, проверь матрицу ошибок. Для собственного проекта проверь разные пороги на 50–100 уже размеченных изображениях, используя свою дообученную модель.
Запусти пакетную аннотацию#
Пакетная аннотация запускает одну модель YOLO или модель с указанием классов на всём датасете. Открой её через More actions > Batch Annotation или выбери Annotate all в уведомлении после предсказания в редакторе:
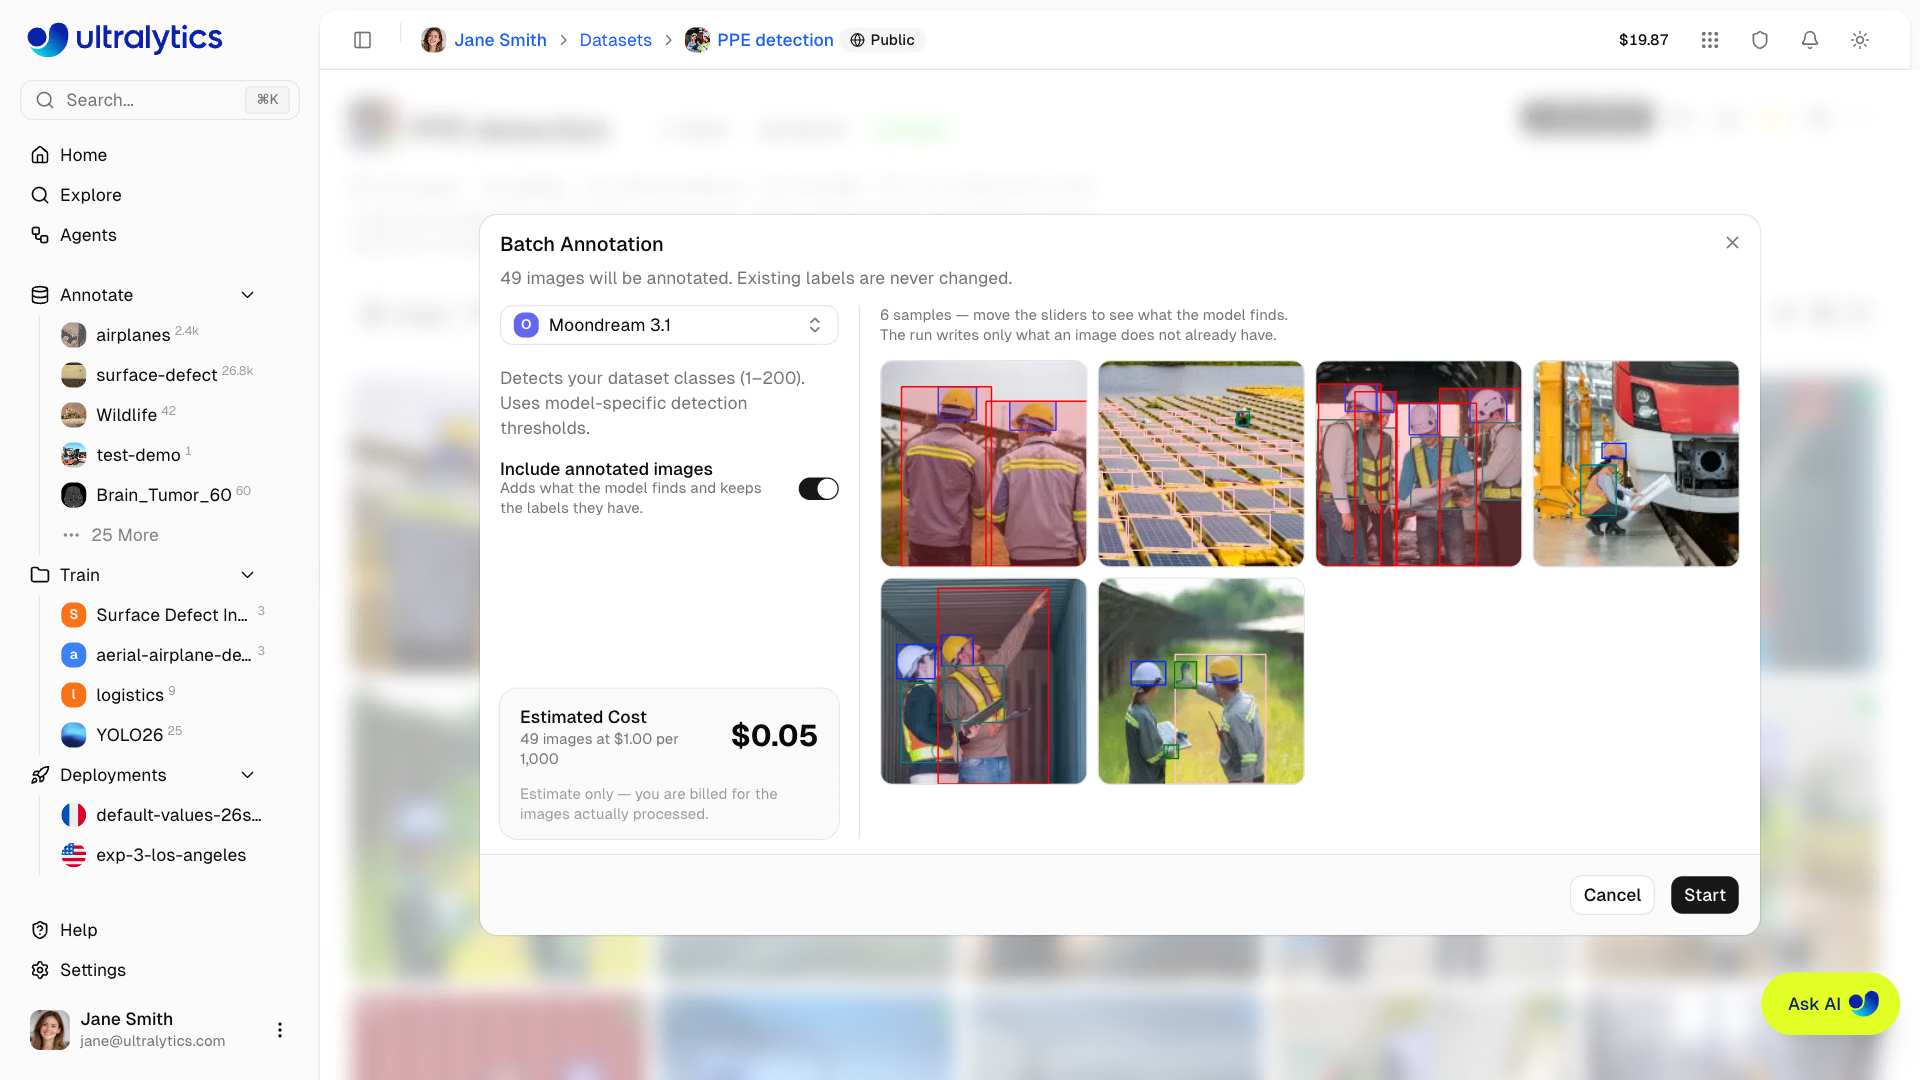
- Выбери модель. Для датасетов обнаружения объектов по умолчанию выбирается Moondream 3.1; переключись на свою дообученную модель или модель YOLO.
- Для модели YOLO установи выбранный по результатам проверки порог уверенности (по умолчанию —
0.25) и IoU (0.7), затем проверь примеры предсказаний. - Оставь параметр Include annotated images выключенным, чтобы размечать только изображения без меток.
- Проверь Estimated Cost ($1.00 за 1 000 изображений, минимум $0.01) и нажми Start.
Перед запуском сохраняется версия датасета, поэтому ты сможешь восстановить его состояние до запуска. При нажатии Stop уже обработанные изображения сохраняются, а оплата за них списывается.
Проверь результаты и вычисли долю правок#
Предсказания сохраняются как обычные аннотации, поэтому ничто не помечает их как непроверенные. Сначала отфильтруй изображения по классу, чтобы проверить редкие классы, а затем отсортируй по Annotations по возрастанию (вероятны пропуски) и по убыванию (перегруженные сцены, где рамки сливаются). Затем создай версию, открой Compare versions на вкладке Versions и выбери v_auto в поле From:
| Количество | Значение |
|---|---|
| Добавлено | Объекты, пропущенные моделью, а также исправленная копия каждой изменённой рамки |
| Удалено | Ложноположительные результаты, а также исходная версия каждой изменённой рамки |
| Доля правок | (добавлено + удалено) ÷ количество аннотаций в v_auto; это верхняя оценка, поскольку исправленная рамка учитывается дважды. |
Отслеживай долю правок для каждой партии. Её рост — ранний сигнал о том, что новые изображения отличаются от тех, с которыми знакома модель для разметки. В уроке рекомендации по аннотированию рассматриваются руководства по разметке и согласованность рецензентов.
Подводные камни#
Симптом: после каждого переобучения результат почти не меняется, и одни и те же объекты по-прежнему пропускаются. Решение: непроверенные предварительные метки превращают систематические ошибки модели разметки в истинные данные датасета: похожий класс, постоянно неточная граница рамки, объекты, которые модель вообще не обнаруживает. Проверяй каждое изображение, прежде чем оно попадёт в версию для обучения.
Симптом: пакетная аннотация завершается, но большинство объектов по-прежнему остаются без меток. Решение: сначала запусти модель в редакторе на десяти репрезентативных изображениях. Если она пропускает больше нескольких объектов, вручную разметь начальный набор и обучи версию v0.
Симптом: у предсказанных рамок неправильные названия классов. Решение: если классы модели отличаются от классов датасета, на шаге Сопоставить классы каждый класс модели сопоставляется с классом датасета или пропускается. Сопоставляй классы внимательно: неверное сопоставление изменит метки у всех рамок этого класса.
Показать решение
Пример: для дообучения модели инспекции таблеток проверка порогов выбирает значение 0.35. Пакетная разметка сохраняет v4 с 1 240 аннотациями. После проверки Compare versions v4 → v5 показывает 96 добавленных и 152 удалённых аннотации, поэтому доля правок равна (96 + 152) ÷ 1 240 = 20%. Удалённых аннотаций больше, чем добавленных, — значит, модель делает лишние предсказания: проверка удалённых рамок показывает, что модель принимает блики на блистерах за таблетки. Отсюда следуют два действия: для следующей партии на один шаг повысить порог уверенности (0.35 → 0.45) и проверить, снизится ли доля правок; добавить 30 проверенных изображений глянцевых упаковок в следующую версию обучающих данных, чтобы модель научилась различать их.