Добавь и подготовь данные
Проверь локальный датасет перед загрузкой, продуманно выбери кадры из видео и добейся, чтобы датасет на платформе с первой попытки получил статус Ready.
Ошибка в датасете обходится дешевле всего, если обнаружить её до загрузки. Метки Pascal VOC незаметно пропускаются, изображения размером меньше 28 пикселей отклоняются, а из 30-минутного видео получается всего 100 кадров, большинство из которых показывают пустую сцену. В этом уроке ты выполнишь двухминутную проверку перед загрузкой, целенаправленно выберешь кадры из видео и изучишь сигналы обработки на платформе, чтобы твои обучающие данные поступили полностью.
Практические занятия
Создай датасет#
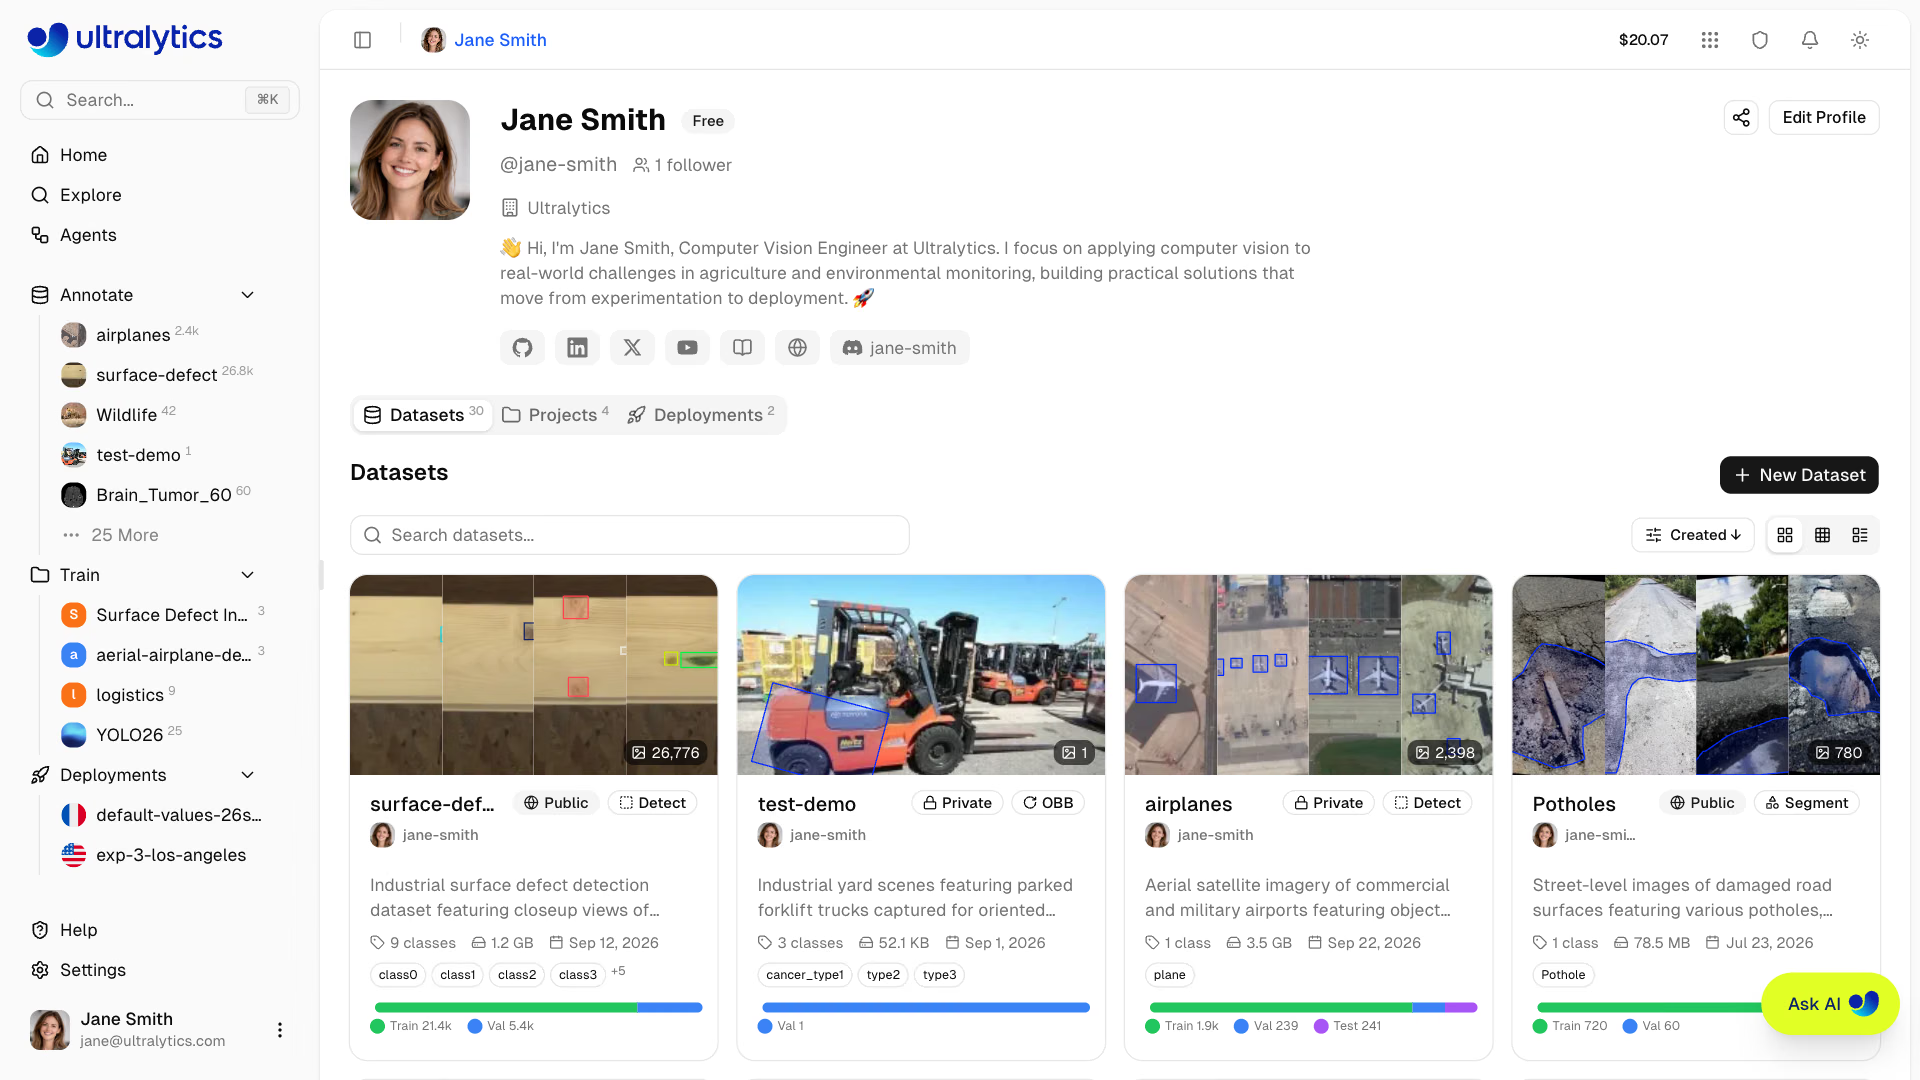
Открой Annotate на боковой панели и нажми New Dataset. В диалоге нужно указать источник, название, тип задачи, необязательную лицензию, размытие лиц и видимость:

| Источник | Когда использовать | План |
|---|---|---|
| Загрузка | Файлы находятся на твоём компьютере: изображения, видео, архивы или экспорты NDJSON | Все разделы |
| URL | Есть общедоступная ссылка .zip, .tar, .tar.gz, .tgz или .ndjson; платформа скачивает данные на сервер | Все разделы |
| Облако | Данные уже хранятся в Google Cloud Storage, Amazon S3 или Azure Blob Storage и должны остаться там | Pro, Enterprise |
| Локальное развёртывание | Данные изображений ни при каких условиях не должны покидать твои устройства | Enterprise |
Правило принятия решения: для этого курса загрузи копию. Для датасетов из Cloud и On Premise данные изображений остаются вне платформы, поэтому умная аннотация, кластеризация, клонирование и снимки версий для них недоступны.
Тип задачи определяет, какие инструменты и модели будут доступны. Платформа поддерживает все семь задач Ultralytics YOLO:
| Задача | Как размечать |
|---|---|
| Детекция | Прямоугольник либо умная аннотация с помощью SAM и YOLO |
| Сегментация | Полигон либо умная аннотация с помощью SAM и YOLO |
| Семантическая сегментация | Полигон либо умная аннотация с помощью SAM и YOLO; маски PNG импортируются напрямую |
| Оценка позы | Ключевые точки на встроенных или пользовательских скелетах; модели YOLO для оценки позы обеспечивают умную аннотацию |
| OBB | Ориентированный прямоугольник либо умная аннотация с помощью SAM и YOLO |
| Классификация | Выбор класса на боковой панели |
| Глубина | Без рисунков: загрузи изображения с соответствующими картами глубины (только загрузка или URL) |
Пример: проверь датасет перед загрузкой#
Платформа принимает изображения JPEG, PNG, WebP, BMP, TIFF, HEIC, AVIF, JP2, DNG и MPO размером до 50 МБ и не менее 28 пикселей по короткой стороне, а также распознаёт метки форматов YOLO, COCO, LabelMe, Ultralytics или Labelbox NDJSON и семантические PNG-маски. Файлы Pascal VOC XML распознаются, но не импортируются. Этот скрипт проверяет локальный датасет YOLO на соответствие этим правилам; в примере используется общедоступный датасет medical pills:
from collections import Counter
from pathlib import Path

from PIL import Image

from ultralytics.data.utils import check_det_dataset

ACCEPTED = {".jpg", ".jpeg", ".png", ".webp", ".bmp", ".tif", ".tiff", ".heic", ".avif", ".jp2", ".dng", ".mpo"}
data = check_det_dataset("medical-pills.yaml")  # your local dataset YAML
root = Path(data["path"])

problems = Counter()
for split in ("train", "val", "test"):
    if not data.get(split):
        continue
    files = [p for p in Path(data[split]).rglob("*") if p.is_file()]
    images = [p for p in files if p.suffix.lower() in ACCEPTED]
    labeled = 0
    for img in images:
        label = Path(str(img).replace("images", "labels")).with_suffix(".txt")
        labeled += label.exists() and label.stat().st_size > 0
        if min(Image.open(img).size) < 28:
            problems["under 28 px (rejected)"] += 1
        if img.stat().st_size > 50 * 1024**2:
            problems["over 50 MB (rejected)"] += 1
    problems["unsupported files (skipped)"] += len(files) - len(images)
    print(f"{split:<5} {len(images):>4} images, {labeled:>4} labeled, {len(images) - labeled:>3} background")
problems["Pascal VOC .xml labels (not imported)"] += len(list(root.rglob("*.xml")))
print("classes:", data["names"])
print("problems:", {k: v for k, v in problems.items() if v} or "none")
train 92 images, 92 labeled, 0 background
val 23 images, 23 labeled, 0 background
classes: {0: 'pill'}
problems: noneЧто означают результаты:
- Количество объектов в каждой выборке. Изображения в папках
train/,val/иtest/сохранят принадлежность к этой выборке при загрузке — именно эти числа отобразит Платформа. Если строкиvalнет, Платформа случайным образом создаст для тебя валидационную выборку (см. ниже, в разделе о подводных камнях). - Фоновые изображения (без файла с метками) допустимы в умеренном количестве: они помогают модели понять, как выглядит «здесь ничего нет». Если их сотни, скорее всего, метки не экспортировались.
problems: noneозначает, что обработка изображений не завершена. Здесь указано количество файлов, которые попадут на вкладкуErrorsили не будут загружены вовсе.
Заархивируй папку датасета вместе с data.yaml и перетащи архив в галерею. Платформа автоматически определит формат, сохранит одинаковые изображения только один раз и при конфликте с уже имеющимися в датасете изображениями предложит Пропустить, Оставить оба или Заменить.
Пример: проверь видео перед обработкой на Платформе#
Платформа выбирает из каждого видео по одному кадру в секунду и сохраняет не более 100 кадров. Для роликов длиннее 100 секунд интервал увеличивается:
| Длительность ролика | Сохранено кадров | Интервал |
|---|---|---|
| 60 секунд | 60 | 1 секунда |
| 100 секунд | 100 | 1 секунда |
| 30 минут (54 000 кадров при 30 кадрах/с) | 100 | 18 секунд |
Для быстрого просмотра этого достаточно, но для большинства реальных проектов не подходит: из 30-минутной записи смены получится 100 кадров, на которых в основном будет пустой проход. Самостоятельно выбери кадры из длинного видео и загрузи их:
Для равномерной выборки достаточно FFmpeg:
mkdir -p frames
ffmpeg -i source.mp4 -vf fps=1 frames/%06d.jpg
Для выборки по событиям используй предварительно обученную модель Ultralytics YOLO, чтобы сохранить только кадры с нужным объектом:
from pathlib import Path

import cv2

from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # or your latest fine-tune
out = Path("frames")
out.mkdir(exist_ok=True)

source = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
seen = kept = 0
for i, result in enumerate(model.predict(source, stream=True, vid_stride=5, classes=[0], conf=0.5, verbose=False)):
    seen += 1
    if len(result.boxes):  # keep only frames where a person was detected
        cv2.imwrite(str(out / f"frame_{i:05d}.jpg"), result.orig_img)
        kept += 1
print(f"Kept {kept} of {seen} sampled frames")
Kept 12 of 12 sampled framesvid_stride=5 проверяет каждый пятый кадр, classes=[0] ограничивает поиск людьми, а conf=0.5 отбрасывает ненадёжные предсказания. В этом демонстрационном ролике с активным движением люди есть в каждом выбранном кадре; в записи преимущественно пустой сцены доля сохранённых кадров резко снизится, как и расходы на разметку. Увеличивай vid_stride, пока соседние сохранённые кадры не перестанут выглядеть одинаково.
Как читать сигналы обработки на Платформе#
После загрузки Платформа проверяет и нормализует данные (изображения больше 4 096 пикселей уменьшаются), создаёт миниатюры, обрабатывает метки и вычисляет статистику. Проверь три места:
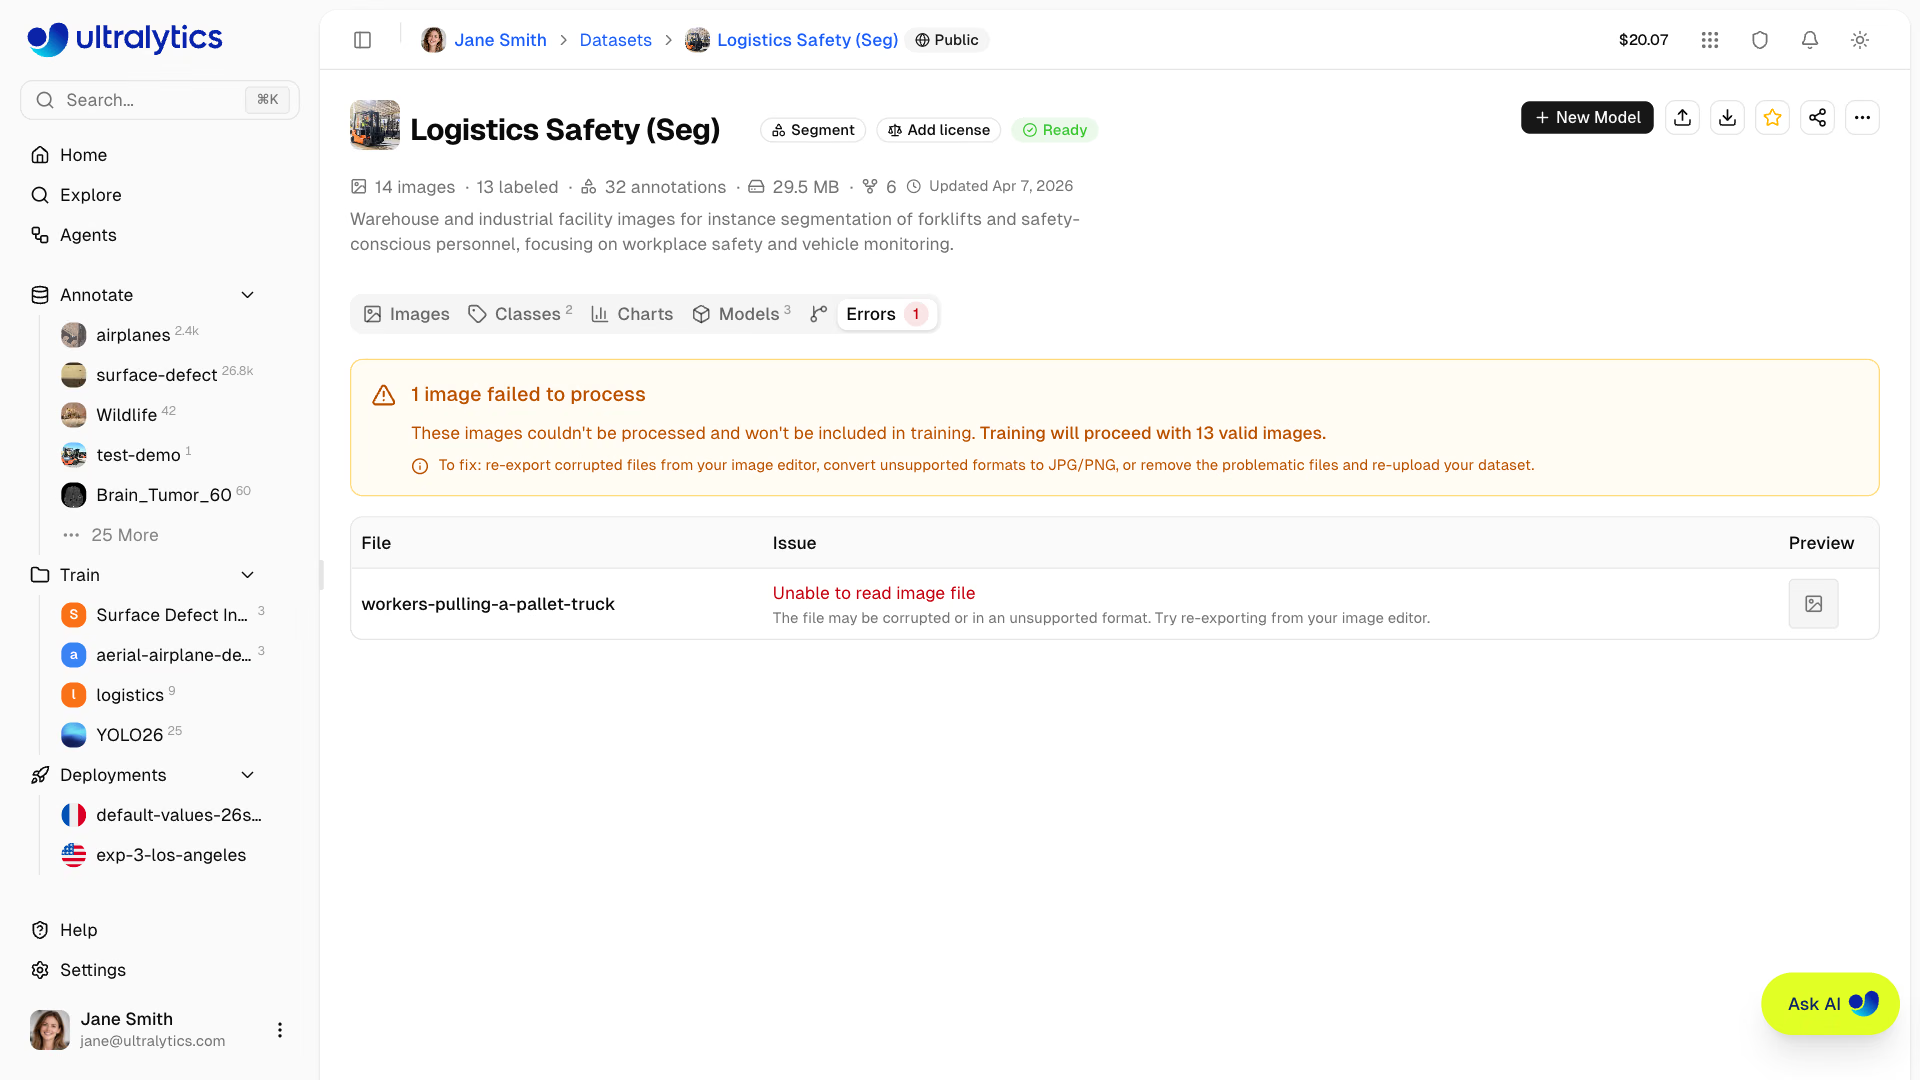
- Вкладка
Errorsпоявляется только при ошибках обработки файлов: повреждённых файлах, неподдерживаемых форматах, изображениях меньше 28 пикселей, а также изображениях в режимах CMYK и индексированных цветов. Для каждой ошибки есть подсказка по исправлению. Экспортируй эти файлы заново или загрузи их повторно. - На вкладке
Chartsпоказаны распределение по выборкам, наиболее распространённые классы, размеры изображений и файлов, расположение аннотаций, размеры рамок и количество объектов на изображение. Обрати внимание на редко встречающиеся классы, крошечные изображения и рамки, сгруппированные в одном углу. - Значок в заголовке датасета показывает
Readyпосле завершения обработки, если в датасете есть хотя бы одно изображение изtrain, одно изображение изvalилиtestи одно изображение с меткой. НажмиNot Ready, чтобы узнать, какое условие не выполнено.

Начни с общедоступного датасета#
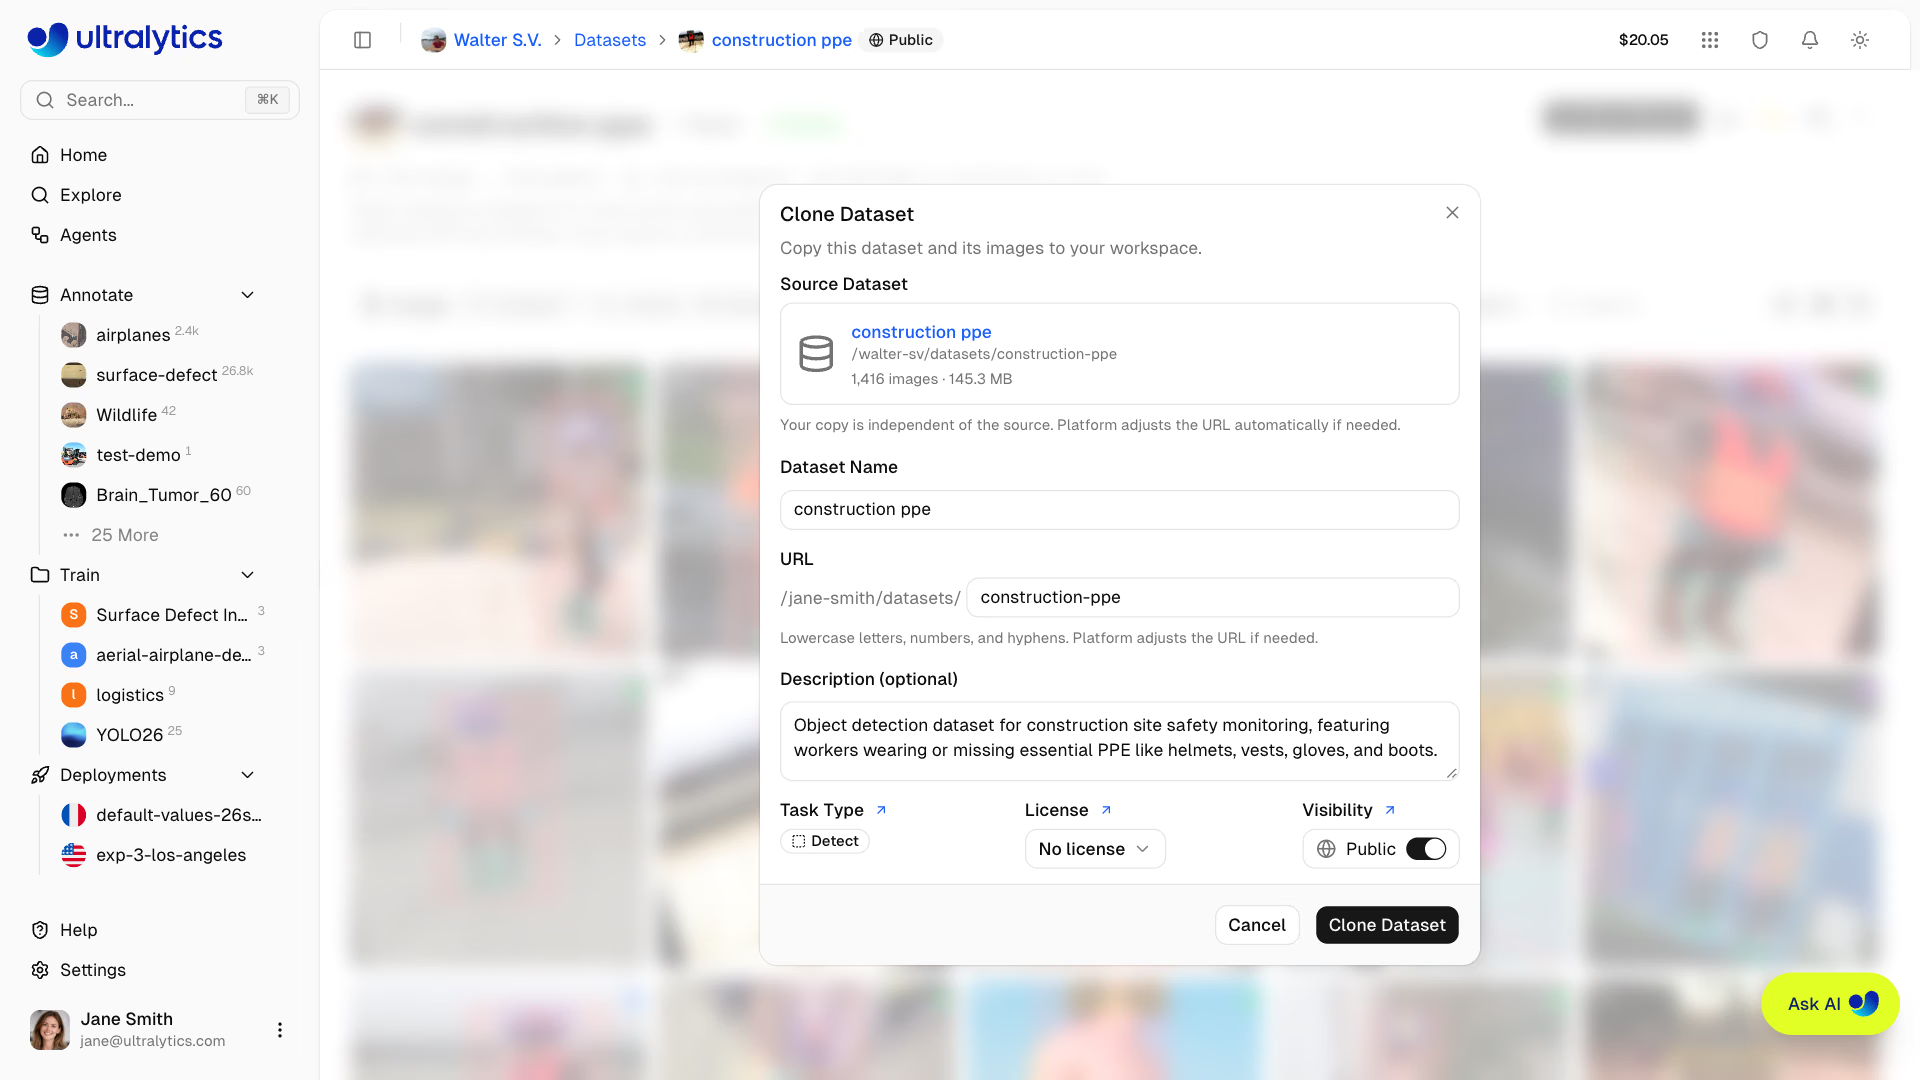
Пока нет данных? На странице Explore перечислены официальные датасеты и датасеты сообщества. Функция Clone Dataset копирует изображения, аннотации и классы в твою рабочую область, учитывает их в объёме хранилища и по умолчанию сохраняет общедоступность исходного датасета. Поэтому, если ты собираешься добавить конфиденциальные данные, переключи соответствующий параметр в диалоге.
Подводные камни#
Симптом: загрузка завершается успешно, но все изображения оказываются без меток. Решение: Platform обнаруживает файлы Pascal VOC XML и не импортирует их. Сначала преобразуй их в метки YOLO .txt или JSON COCO; предварительная проверка перед загрузкой подсчитывает файлы .xml, чтобы ты заметил проблему до загрузки.
Симптом: mAP на валидации отличный, а развёрнутая модель работает плохо. Решение: если при загрузке без выбранного разделения папка val пуста, Platform случайным образом переносит около 20% обучающих изображений в val. Для видеокадров в результате почти одинаковые соседние кадры оказываются в обеих выборках. Вместо этого загружай данные в папки train/ и val/, разделив их по видео или камерам (урок 4).
Симптом: ты не можешь найти инструмент для полигонов или ключевых точек. Решение: набор инструментов определяется типом задачи. Измени тип в заголовке датасета; для каждого изображения хранятся метки всех задач, поэтому при переключении метки других задач скрываются, а не удаляются.
Показать решение
Пример решения: датасет medical pills и 4-минутное видео с линейной камеры. Проверка перед загрузкой: 92 изображения для обучения и 23 для валидации, все размечены, проблем нет. Длительность видео — 240 секунд, это больше 100 секунд, поэтому интервал увеличивается до ceil(240 / 100) = 3 секунд, а Платформа сохраняет 80 кадров (по одному в 0 с, 3 с, …, 237 с). Ожидаемое количество изображений в галерее: 92 + 23 + 80 = 195. Кадры из видео загружаются без меток в выборку, выбранную фильтром галереи. Чтобы они не попали в валидационную выборку, выбери Train перед загрузкой видео. Значок показывает Ready, поскольку в датасете есть изображения для обучения, для валидации и с метками. Если бы ты загрузил только видео, значок показывал бы Not Ready: размеченных изображений ещё нет.