Запуск, анализ и дообучение модели
Запусти облачное обучение с известной стоимостью, оцени запуск по графикам для каждой эпохи и выполняй дообучение так, чтобы оптимизатор по умолчанию не игнорировал выбранную тобой скорость обучения.
За каждую минуту работы обречённого на провал запуска приходится платить за облачный GPU, а самая распространённая ошибка при дообучении ничего не стоит, но незаметно тратит время запуска: оптимизатор по умолчанию игнорирует заданную тобой скорость обучения. В этом уроке ты обучишь настоящую модель на наборе данных medical pills, оценишь её графики с помощью правила принятия решения и настроишь дообучение так, чтобы заданные параметры действительно применялись.
Практические занятия
Запусти обучение#
Нажми New Model на странице проекта или набора данных. На вкладке Cloud Training последовательно задаются следующие параметры:
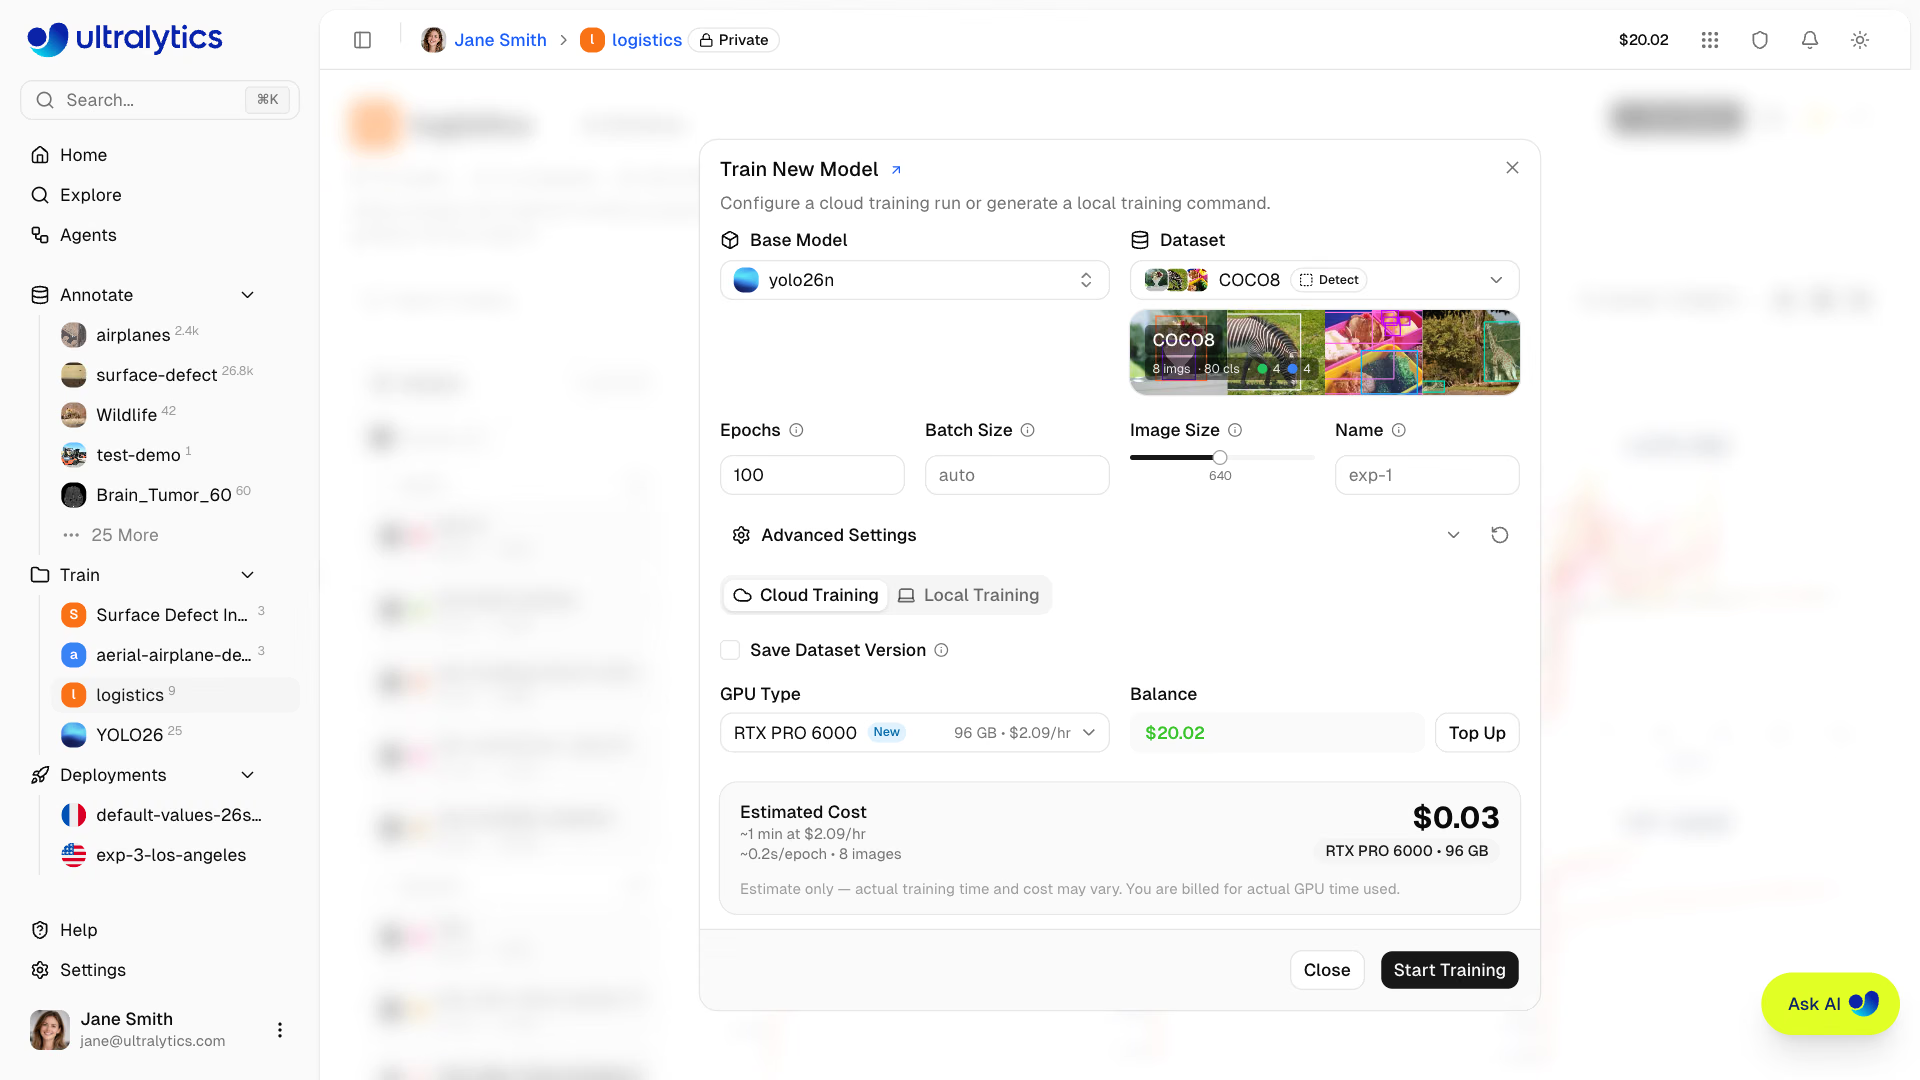
| Параметр | По умолчанию | Когда менять |
|---|---|---|
| Базовая модель | Выбери модель в разделе Official (рекомендуется YOLO26) | Если выполняешь дообучение, выбери предыдущий запуск в разделе My Models |
| Датасет | — | Всегда включай Save Dataset Version, чтобы привязать запуск к конкретной версии данных |
| Эпохи | 100 | Быстрая проверка (10–20 эпох) или очень большие наборы данных |
| Размер батча | -1 (автоматически подбирается под объём памяти GPU) | Для точного сравнения двух запусков |
| Размер изображения | 640 | Объекты маленькие: увеличь его (ползунок ограничен значением 1280; редактор YAML принимает значения до 4096) |
| Дополнительные настройки | Значения по умолчанию | Более 50 аргументов model.train() в YAML, включая оптимизатор, скорость обучения и аугментацию |
Это те же аргументы, которые принимает model.train(...) при локальном запуске; на странице модели позже появится копируемая команда yolo train с нестандартными значениями.
Выбери GPU и рассчитай бюджет запуска#
| Уровень | Примеры (объём видеопамяти, цена за час) | Подходит для |
|---|---|---|
| Бюджетный | RTX 2000 Ada (16 GB, $0.24), RTX A5000 (24 GB, $0.27), RTX 4090 (24 GB, $0.69) | Быстрых проверок, nano- и малых моделей |
| Средний | L40S (48 GB, $0.86), RTX 5090 (32 GB, $0.99), A100 SXM (80 GB, $1.49) | Моделей среднего размера, больших батчей |
| По умолчанию | RTX PRO 6000 (96 GB, $2.09) | Большинства задач |
| Высокопроизводительный | H100 SXM (80 GB, $3.29), H200 SXM (141 GB, $4.39) | Большие датасеты, когда время имеет значение |
| Pro и Enterprise | B200 (180 GB, $5.89), B300 (288 GB, $7.39) | Самые масштабные задачи |
Карточка стоимости оценивает длительность и цену до запуска: около $0.23 за 1,000 изображений × YOLO26n × 100 эпох на RTX PRO 6000 по умолчанию и около $1.56 за 5,000 изображений × YOLO26s × 100 эпох на H100 SXM, которая обучает примерно в 3.4 раза быстрее, чем RTX 4090. Оплата начисляется за фактическое время работы GPU: завершённые, отменённые и завершившиеся ошибкой запуски тарифицируются после старта GPU; для запуска нужен баланс, покрывающий оценочную стоимость (не менее 15 минут работы GPU), а активные запуски останавливаются, если баланс становится отрицательным. Поэтому для долгих задач включи автоматическое пополнение в Settings > Billing. Если выбрать GPU дешевле RTX PRO 6000, можно бесплатно перейти на неё, когда простаивают мощности под управлением Ultralytics; при этом оплата всё равно рассчитывается по выбранному тарифу.
Правила выбора: сначала проверь новый датасет на GPU по умолчанию, запустив обучение на 10–20 эпох. Перейди на H100 или H200, если запуск длится несколько часов и кто-то ждёт его завершения. Выбирай GPU подешевле, а не побыстрее, если загрузка GPU остаётся низкой.
Следи за запуском#
На вкладке Train страницы модели отображаются данные в трёх подвкладках. На Charts строятся графики метрик, потерь на обучении и валидации, а также скорости обучения для каждой эпохи; Console хранит последние 2 000 строк и сразу останавливает запуск при трассировке стека или ошибке нехватки памяти CUDA; System показывает загрузку, память и температуру GPU:

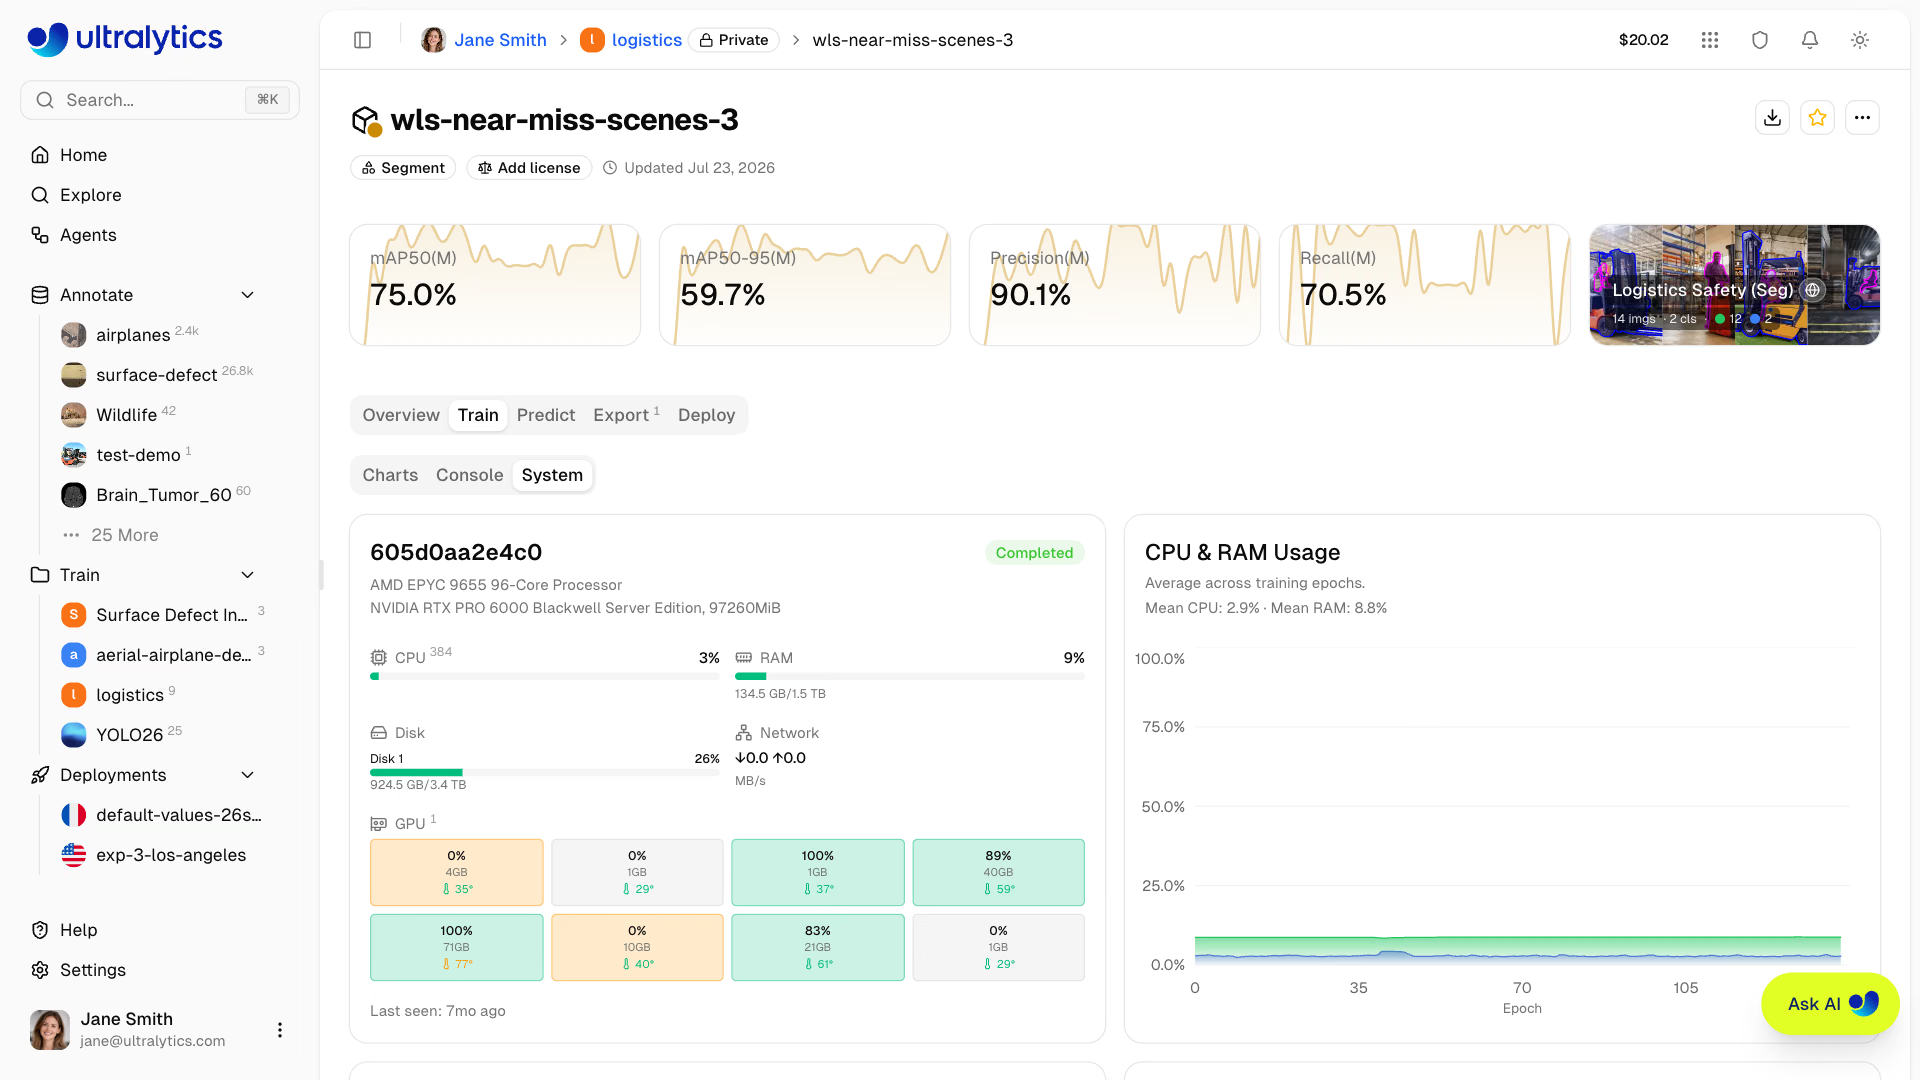
Если запуск не выдаёт никаких данных в течение 4 часов, он помечается как неудачный. Лучшая контрольная точка загружается периодически, поэтому при отмене запуска сохраняется лучшая на данный момент эпоха, а уведомления в Slack сообщат тебе о завершении или сбое запусков.
Пример: обучение, потоковая передача данных и анализ запуска#
Ты можешь обучать модель где угодно и при этом отслеживать запуск в Platform. Экспортируй API-ключ из Settings > API Keys как ULTRALYTICS_API_KEY; project вида username/project передаёт в этот проект графики, консоль и лучшую контрольную точку:
from ultralytics import YOLO

# export ULTRALYTICS_API_KEY="..." first to stream this run into your Platform project
model = YOLO("yolo26n.pt")
results = model.train(data="medical-pills.yaml", epochs=10, imgsz=320, project="username/pill-inspection", name="v1-baseline")
print(f"mAP50-95 {results.box.map:.3f}, best checkpoint: {model.trainer.best}")
Class Images Instances Box(P R mAP50 mAP50-95)
all 23 399 0.97 0.957 0.977 0.659
mAP50-95 0.659, best checkpoint: .../runs/detect/username/pill-inspection/v1-baseline/weights/best.ptЭта же команда выполняется на GPU Platform, если нажать New Model; локально запуск занял меньше двух минут на CPU ноутбука с imgsz=320. В results.csv запуска хранятся последовательности значений для каждой эпохи, которые отображает подвкладка Charts, поэтому нескольких строк достаточно, чтобы превратить «следи за кривыми» в правило:
import pandas as pd

df = pd.read_csv("results.csv")  # the per-epoch metrics behind the Charts subtab
df.columns = df.columns.str.strip()
m = df["metrics/mAP50-95(B)"]
best_epoch = int(df.loc[m.idxmax(), "epoch"])
recent_gain = m.iloc[-1] - m.iloc[-4]  # change over the last 3 epochs
val_loss = df["val/box_loss"]
print(f"epochs={len(df)} best mAP50-95={m.max():.3f} at epoch {best_epoch}")
print(f"gain over last 3 epochs: {recent_gain:+.3f}")
print(f"val box loss: {val_loss.iloc[0]:.3f} -> {val_loss.iloc[-1]:.3f}")
if recent_gain < 0.005 and val_loss.iloc[-1] >= val_loss.iloc[-4]:
    print("verdict: plateaued - stop, and fix the data before training longer")
elif best_epoch == len(df):
    print("verdict: still improving at the last epoch - more epochs should help")
else:
    print("verdict: converged - keep best.pt")
epochs=10 best mAP50-95=0.659 at epoch 10
gain over last 3 epochs: +0.028
val box loss: 1.367 -> 1.045
verdict: still improving at the last epoch - more epochs should helpЛучшая эпоха — последняя, mAP50-95 выросла на 2,8 пункта за последние три эпохи, а потери на валидации всё ещё снижаются: этот запуск на 10 эпох завершился рано, и более длительное обучение или дообучение принесёт пользу. Используй те же три сигнала для любого запуска в Platform на подвкладке Charts: положение лучшей эпохи, недавний прирост и направление изменения потерь на валидации.
Дообучи предыдущую модель#
Выбери предыдущую модель в разделе My Models в качестве базовой; Platform создаст новую модель на основе этой контрольной точки, не изменяя старую. Обычно рекомендуют снизить скорость обучения, но при настройке по умолчанию optimizer: auto обучение самостоятельно выбирает оптимизатор и скорость обучения и игнорирует lr0. Это видно в первых строках консоли:
optimizer: 'optimizer=auto' found, ignoring 'lr0=0.01' and determining best 'optimizer' and 'lr0' automatically...
optimizer: AdamW(lr=0.002, momentum=0.9) with parameter groups 114 weight(decay=0.0), 126 weight(decay=0.0005), 126 bias(decay=0.0)
Явно укажи optimizer в Advanced Settings, и заданное значение сохранится. При дообучении модели таблеток ещё на 5 эпох с optimizer: SGD и lr0: 0.001 в журнале появится:
optimizer: SGD(lr=0.001, momentum=0.937) with parameter groups 114 weight(decay=0.0), 126 weight(decay=0.0005), 126 bias(decay=0.0)
                   all         23        399      0.969      0.962      0.983      0.687
mAP50-95 выросла с 0.659 до 0.687. На следующем уроке ты проверишь этот кандидат перед выпуском.
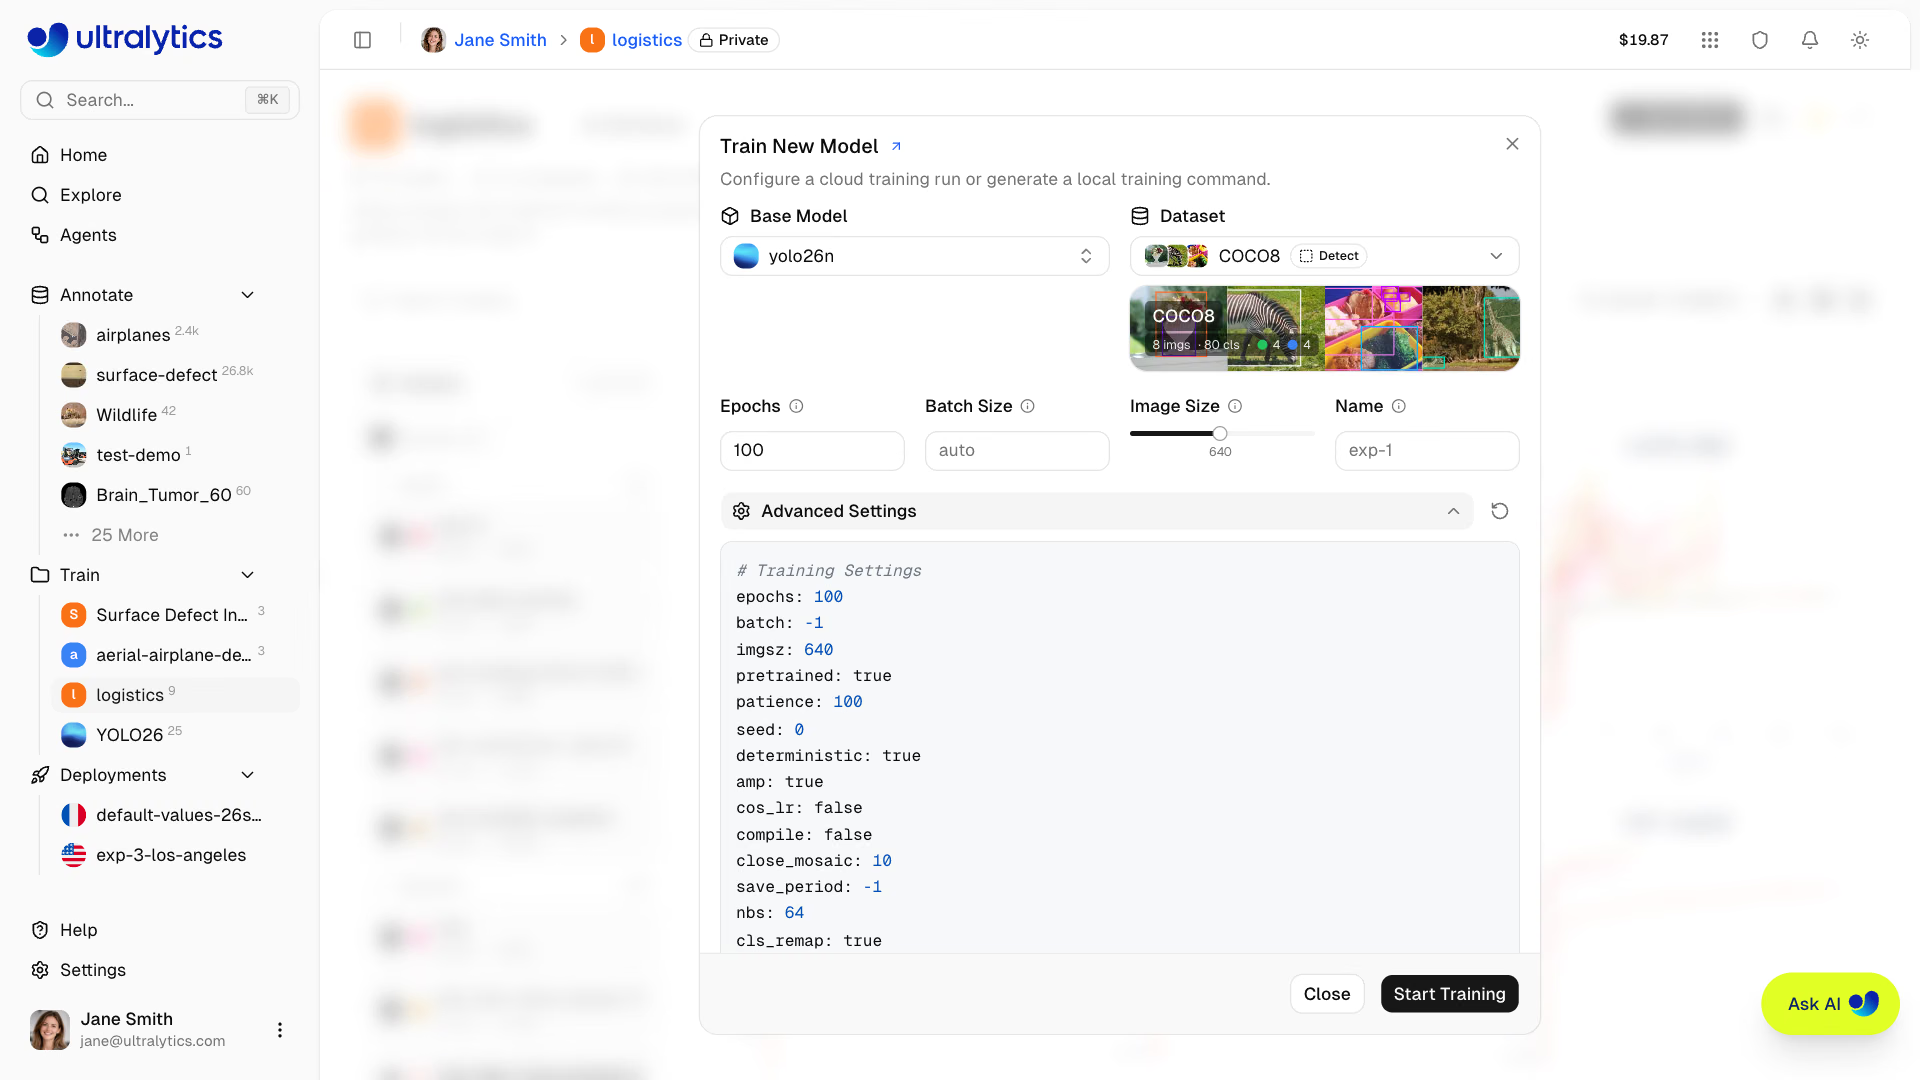
Чтобы воспроизвести предыдущий запуск, открой таблицу Training Configuration на странице модели, выбери Copy JSON и вставь содержимое в Advanced Settings. В руководстве по дообучению описана заморозка слоёв, а в руководстве по подбору гиперпараметров — систематический перебор параметров.
Подводные камни#
Симптом: ты задаёшь lr0: 0.001, а в консоли отображается ignoring 'lr0=...'. Решение: при использовании optimizer: auto во время обучения оптимизатор и скорость обучения выбираются автоматически. Установи optimizer в значение SGD или AdamW вместе с lr0, затем проверь строку optimizer: в консоли.
Симптом: во время всего запуска на вкладке System загрузка GPU заметно ниже 80%. Решение: узкое место — загрузка данных, а не GPU, поэтому более быстрый GPU обойдётся дороже. Выбери GPU подешевле или увеличь размер пакета, если позволяет память.
Симптом: mAP50-95 на валидации не меняется уже 10 эпох, а ошибка на валидации постепенно растёт. Решение: останови обучение. Лучший на данный момент чекпойнт сохранится, а дальнейший прирост даст работа с данными (уроки 3 и 4), а не дополнительные эпохи.
Показать решение
Пример для медицинских таблеток: базовая модель, обученная 10 эпох, достигает пика на 10-й эпохе с mAP50-95 0.659; прирост за последние три эпохи составляет +0.028, а потери box на валидации снижаются с 1.367 до 1.045, поэтому вывод — «продолжить». Вместо обучения с нуля выполни дообучение: базовая модель v1-baseline из раздела My Models, 5 эпох, в Advanced Settings задай optimizer: SGD и lr0: 0.001. Консоль подтверждает SGD(lr=0.001, momentum=0.937), а mAP50-95 достигает 0.687. На GPU по умолчанию это стоит несколько центов; карточка стоимости показывает оценку до нажатия Start Training, а фактическая сумма отображается после запуска в Settings > Billing.