Разверни и вызывай конечную точку
Создай отдельную конечную точку в одном из 42 регионов, подбери размер под свой трафик и вызывай её через клиент, который обрабатывает холодные старты, ответы 429 и недействительные ключи.
Бесплатная конечная точка, масштабируемая до нуля, может отвечать на первый запрос до минуты, а наивный клиент превращает это в тайм-аут для пользователя. Утёкший ключ продолжает работать, даже если его удалить. В этом уроке ты развернёшь лучшую модель, осознанно подберёшь размер конечной точки и напишешь небольшой клиент, необходимый для любой производственной интеграции.
Практические занятия
Общий инференс или отдельная конечная точка#
Любую модель уже можно вызывать через общий API инференса Platform — он подходит для тестирования. Для производственного трафика используй отдельную конечную точку:
| Общий инференс | Отдельная конечная точка | |
|---|---|---|
| Сервис | Общий для пользователей Platform | Одна модель, один клиент |
| Регионы | Регион твоих данных (US, EU или AP) | Любой из 42 регионов |
| Ограничение частоты запросов | 20 запросов в минуту на ключ | Platform не ограничивает прямые вызовы |
| Размер запроса | Около 4,5 MB | 32 MB, до 1 часа на запрос (поддерживается видео) |
| Аутентификация | Любой API-ключ рабочего пространства | Только ключ, привязанный к развёртыванию |
Создай и настрой размер конечной точки#
Открой вкладку модели Deploy. Браузер измерит задержку до всех 42 регионов (14 в Северной и Южной Америке, 13 в Европе, 12 в Азиатско-Тихоокеанском регионе, 3 на Ближнем Востоке и в Африке) и отсортирует таблицу по этому показателю:
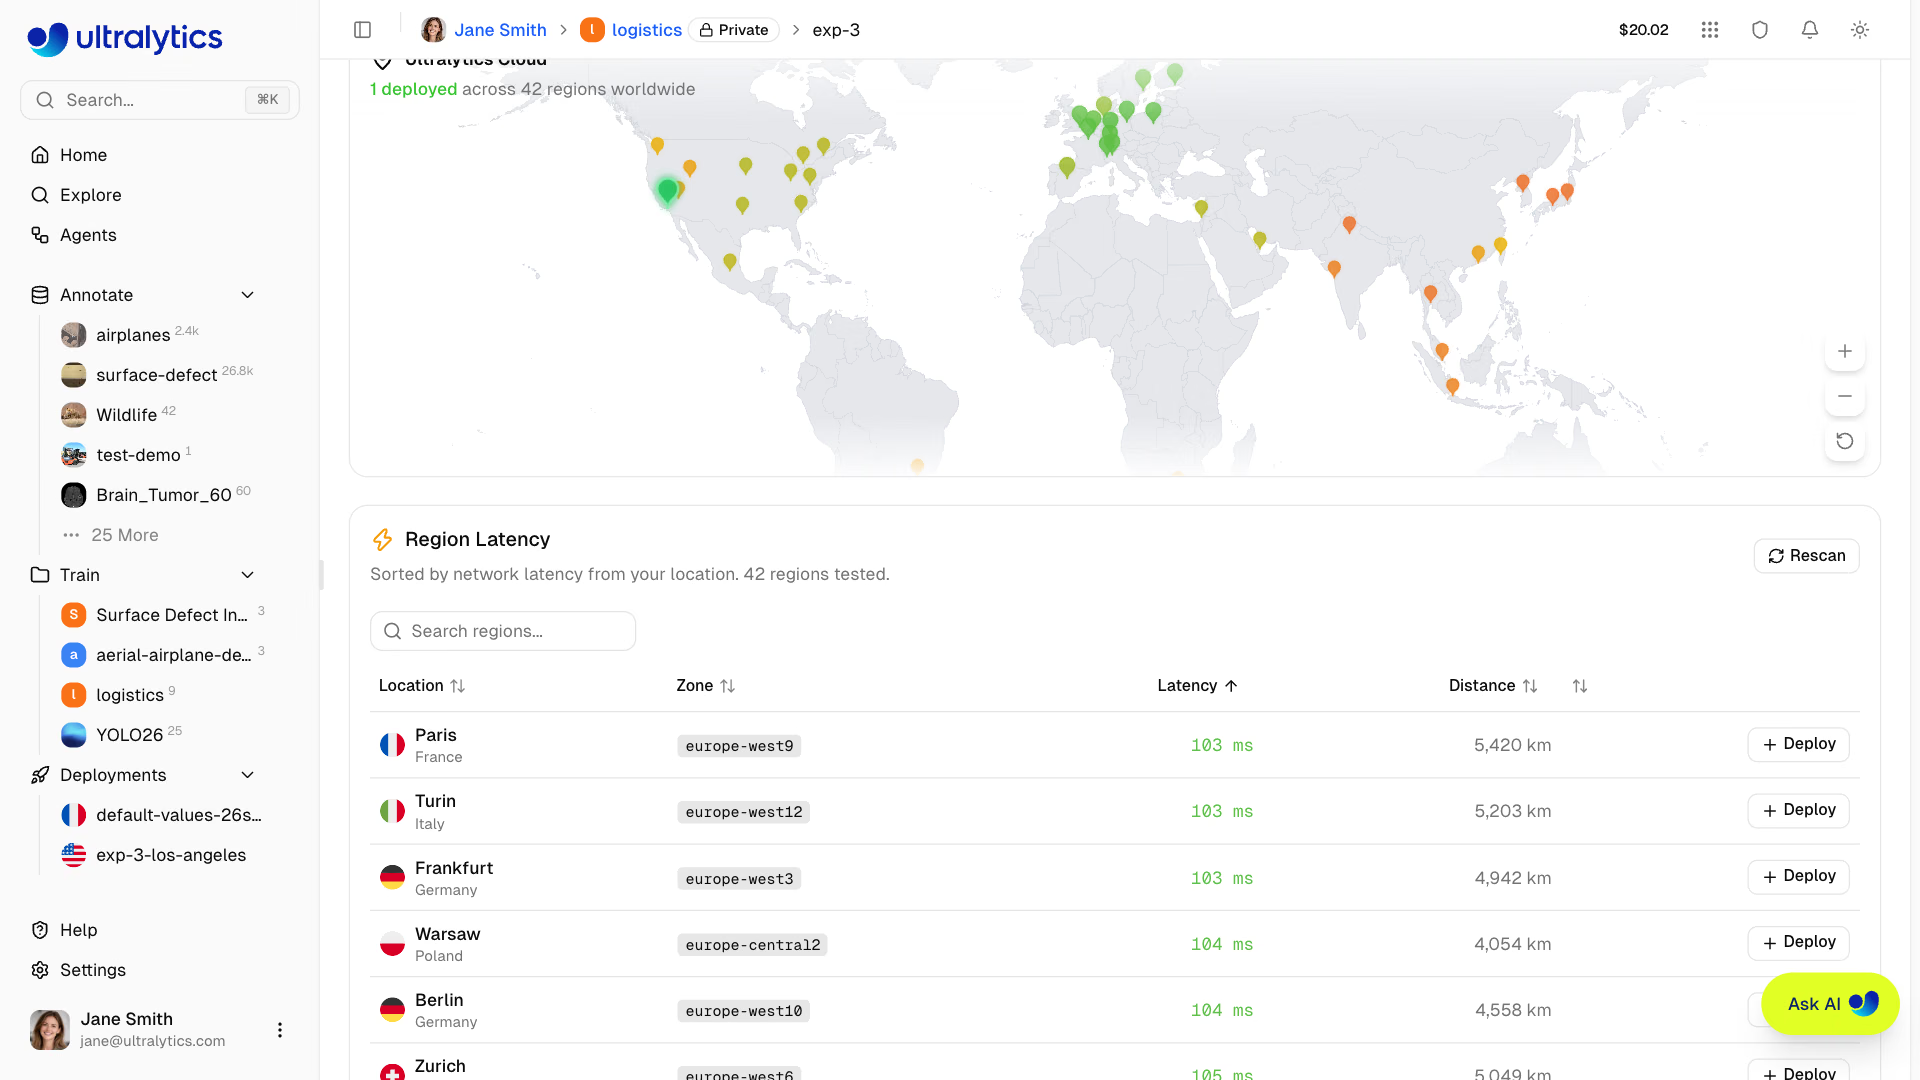
Нажми Deploy в строке региона, ближайшего к твоим клиентам, проверь CPU, объём памяти, цену и сгенерированное имя (например, yolo26n-iowa), затем нажми Create Deployment. Также можно начать с пункта New Deployment на вкладке Deployments в своём профиле:
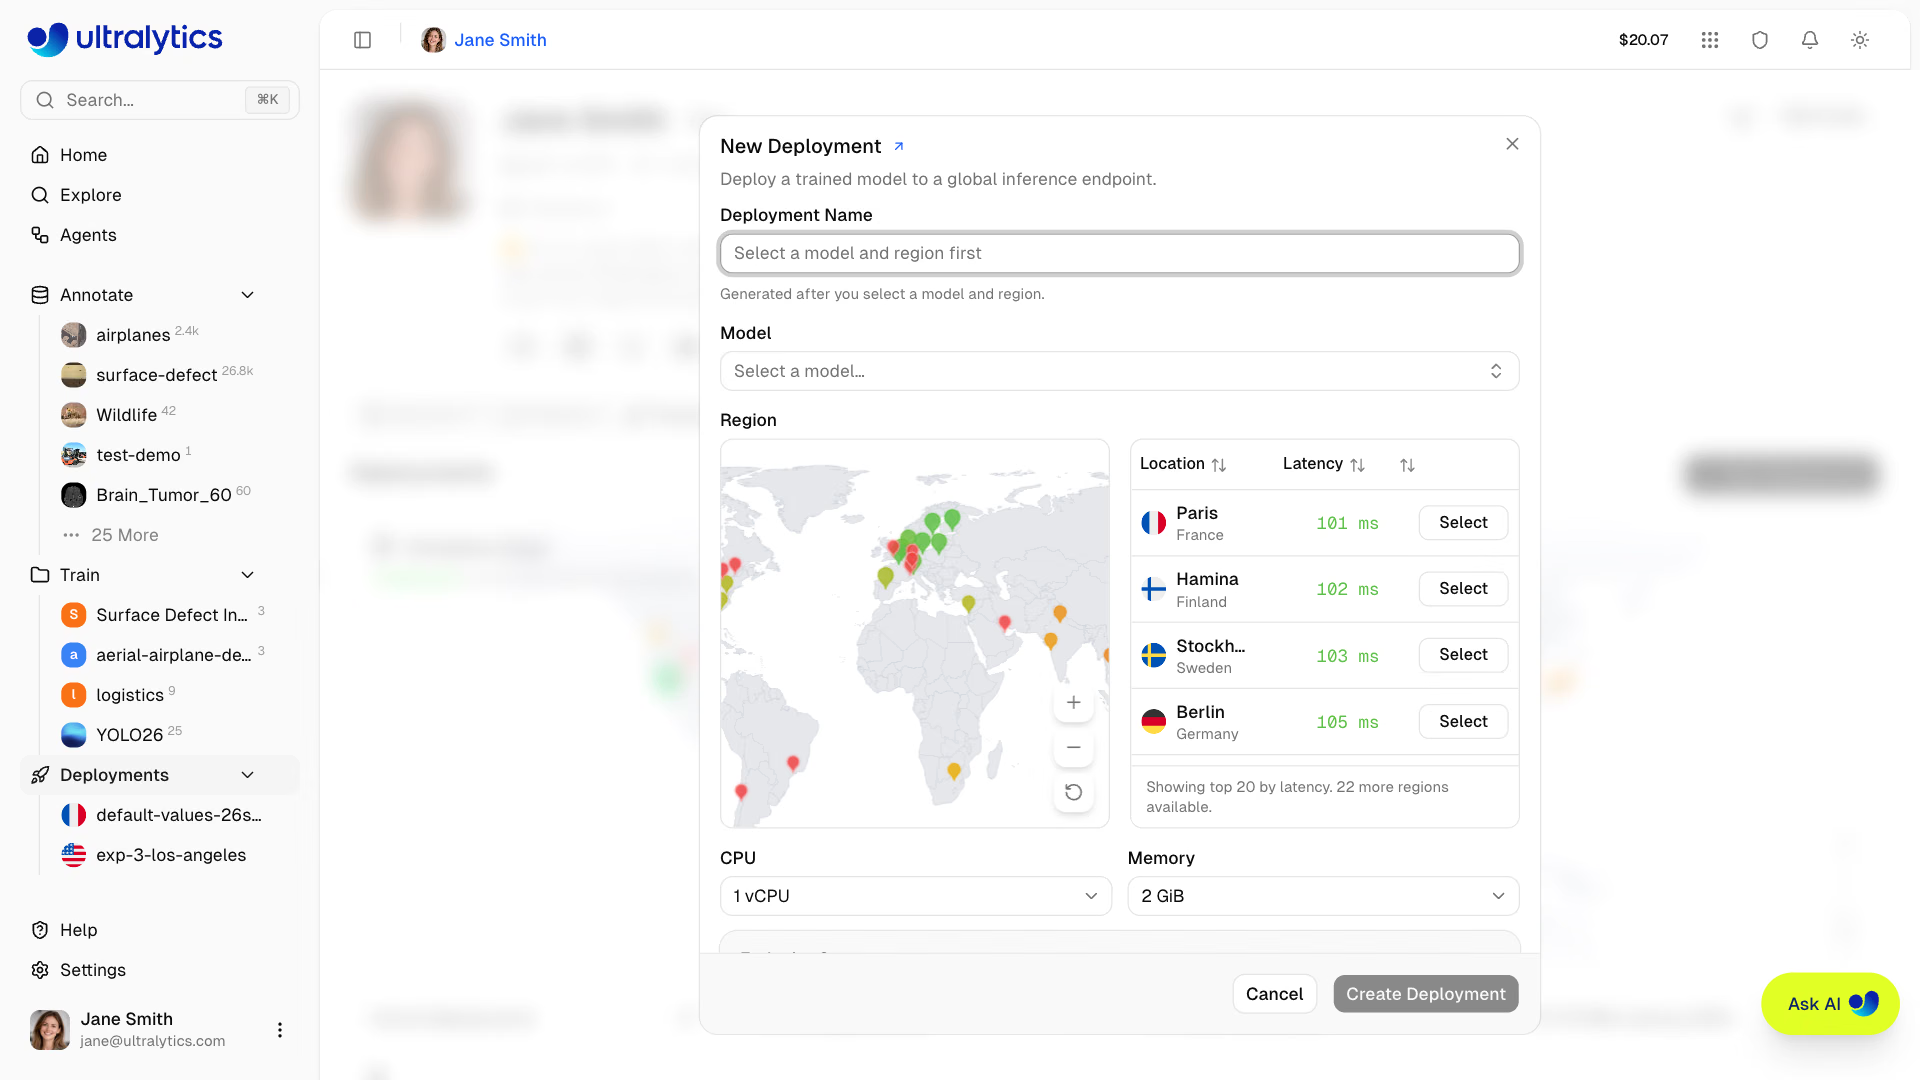
Выбирай размер с учётом характера трафика:
| Трафик | Объём | Стоимость |
|---|---|---|
| Пакетные задания, внутренние инструменты, демонстрации с неравномерной нагрузкой | По умолчанию: 1 vCPU, 2 GiB; масштабируется до нуля | Бесплатно на любом тарифе |
| Постоянный трафик реального времени, который не может ждать холодного запуска | Настраиваемый размер (1–8 vCPU, 2–32 GiB) с одним постоянно работающим экземпляром | Почасовая оплата с момента готовности до остановки, включая простой: около $0.12/ч за 1 vCPU и 4 GiB в Айове |
| Пользователи в нескольких частях света | Одна конечная точка на регион за твоим собственным маршрутизатором | Оплата каждой конечной точки зависит от её размера |
Тарифы допускают 3 (Free), 10 (Pro) или неограниченное количество (Enterprise) развёртываний; остановленные конечные точки тоже учитываются. Конечная точка принимает трафик, когда её статус становится Ready:
Практический пример: клиент, готовый к работе в production#
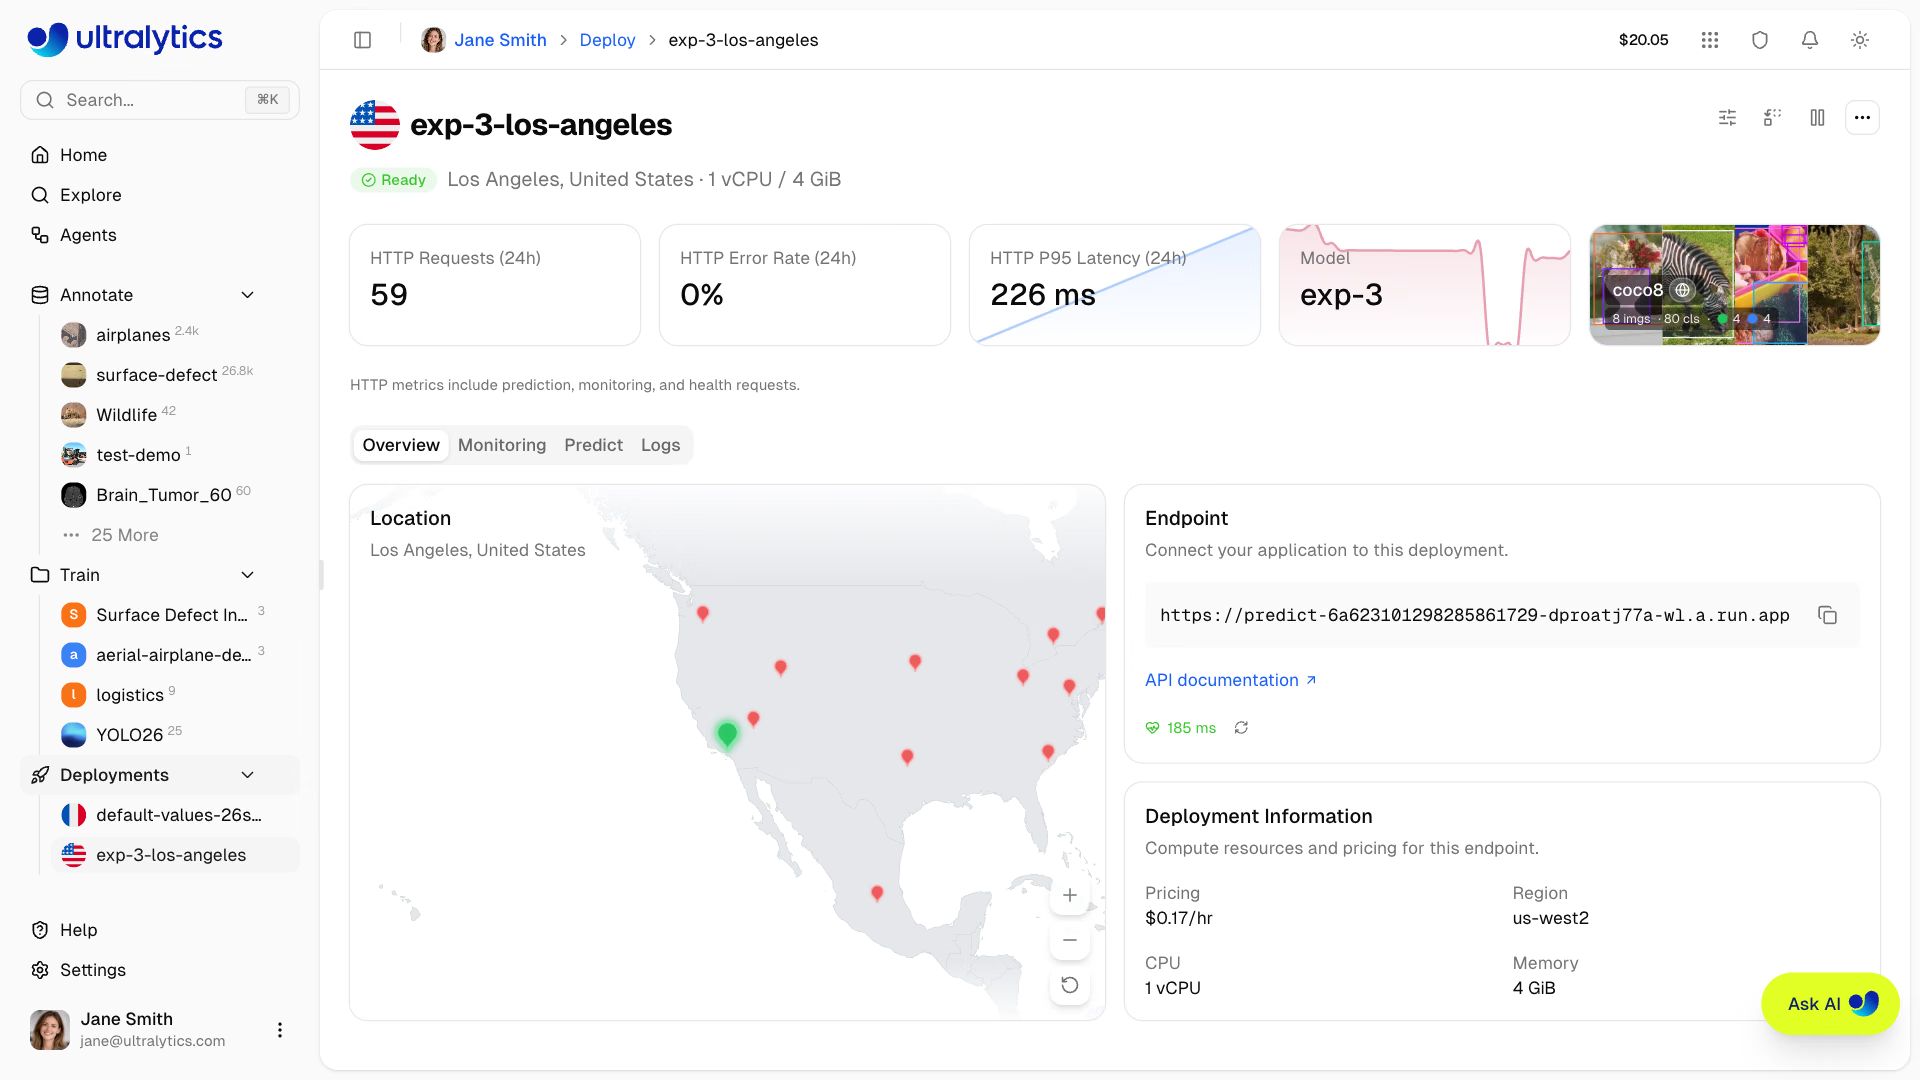
У каждой конечной точки есть URL, например https://predict-<id>-<hash>-<region>.a.run.app, который обслуживает /predict (POST), /health и интерактивную страницу /docs. Она принимает только API-ключ, привязанный при создании; владельцы рабочего пространства видят этот ключ уже заполненным на вкладке Predict в разделе Docs развёртывания, рядом с примерами для Python, JavaScript и cURL. Примеры выполняют один запрос; производственный код должен также выдерживать холодный запуск и высокую нагрузку на экземпляр:
import os
import time
from collections import Counter

import httpx

URL = "https://YOUR_DEPLOYMENT_URL.run.app/predict"
HEADERS = {"Authorization": f"Bearer {os.environ['ULTRALYTICS_API_KEY']}"}  # the deployment's bound key, server-side only

def predict(client, path, conf=0.25, attempts=4):
    """POST one image; retry timeouts, 429, and 5xx with backoff; fail fast on other errors."""
    for attempt in range(attempts):
        try:
            with open(path, "rb") as f:
                r = client.post(URL, headers=HEADERS, data={"conf": conf}, files={"file": f}, timeout=90)
            if r.status_code < 400:
                return r.json()
            if r.status_code != 429 and r.status_code < 500:
                r.raise_for_status()  # 401 wrong key, 413 too large: retrying won't help
            wait, reason = float(r.headers.get("Retry-After", 2**attempt)), r.status_code
        except httpx.TimeoutException:  # a scaled-to-zero endpoint can take up to a minute to wake
            wait, reason = 2**attempt, "timeout"
        print(f"attempt {attempt + 1}: {reason}, retrying in {wait:.0f} s")
        time.sleep(wait)
    raise RuntimeError(f"endpoint still unavailable after {attempts} attempts")

with httpx.Client() as client:
    response = predict(client, "bus.jpg")
for image in response["images"]:
    counts = Counter(d["name"] for d in image["results"])
    print(f"{sum(counts.values())} objects {dict(counts)} in {image['speed']['inference']:.1f} ms")
Мы проверили его на локальной заглушке: она один раз отвечает 429, а затем возвращает настоящий результат YOLO26n для bus.jpg в формате ответа конечной точки:
attempt 1: 429, retrying in 2 s
5 objects {'bus': 1, 'person': 4} in 34.9 ms
Разберём важные решения построчно:
timeout=90учитывает холодный запуск длительностью до минуты; стандартные тайм-ауты большинства HTTP-клиентов намного короче.- Для ошибок 429 и 5xx выполняются повторные попытки с учётом
Retry-After, если конечная точка его отправляет. Каждая конечная точка обслуживает запросы одним экземпляром и при перегрузке ограничивает нагрузку с помощью429. - При других ошибках 4xx запрос сразу завершается с ошибкой:
401означает неверный ключ, а413— что размер тела запроса превышает 32 MB; ни одна из этих проблем не исчезнет сама собой. - Ответ содержит по одной записи на изображение (или видеокадр) в
images; каждая запись включаетresults(class,name,confidence,boxсx1,y1,x2,y2) иspeedв миллисекундах.
Необязательные поля формы: conf (по умолчанию 0.25), iou (0.7), imgsz (размер, на котором обучалась модель), vid_stride для видео и normalize=true для координат в диапазоне 0–1. Эквивалентный вызов cURL — по одной строке на поле:
curl -X POST "https://YOUR_DEPLOYMENT_URL.run.app/predict" \
  -H "Authorization: Bearer $ULTRALYTICS_API_KEY" \
  -F "file=@bus.jpg" -F "conf=0.25" -F "iou=0.7" -F "imgsz=640"
Выпускай новые версии, не меняя URL#
Команда Replace model на странице развёртывания заменяет модель на другую завершённую модель из того же рабочего пространства. Старая модель продолжает работать, пока не будет готова новая; URL, регион и ключ остаются прежними. Если развёртывание новой модели завершится неудачей, предыдущая модель продолжит работу. Откат выполняется той же командой для предыдущей модели, поэтому не удаляй её из проекта. Команда Update configuration меняет размер на месте, а Stop приостанавливает оплату, сохраняя URL.
Для некоторых изменений нужна новая конечная точка: регионы нельзя изменить (для переноса нужно удалить конечную точку и создать заново, получив новый URL), а пользовательские домены не поддерживаются. Если клиентам нужно постоянное брендированное доменное имя, поставь перед конечной точкой собственный шлюз. Чтобы работать вне Platform, экспортируй модель (Экспорт для развёртывания) или размести её самостоятельно за Triton Inference Server.
Подводные камни#
Симптом: на твоём эндпоинте появляется трафик, который ты не можешь объяснить. Решение: никогда не помещай ключ в веб-приложение или мобильное приложение; вызывай эндпоинт из своего бэкенда. Удаление или деактивация привязанного ключа не блокирует эндпоинт, потому что он всё ещё принимает эту строку ключа. Чтобы отозвать доступ, останови или удали развёртывание и создай новое, привязав к свежему ключу.
Симптом: первый утренний запрос завершается ошибкой, а повторный проходит успешно. Решение: эндпоинты стандартного размера масштабируются до нуля. Установи тайм-аут не менее 90 секунд, отправь запрос /health для прогрева эндпоинта перед ожидаемым трафиком или переключись на пользовательский размер, если каждый запрос должен обрабатываться быстро.
Симптом: загрузка завершается ошибкой 413. Решение: выделенные эндпоинты принимают тела запросов размером до 32 МБ. Раздели длинные видео на короткие клипы или отправляй выбранные кадры, а также передай vid_stride, чтобы пропускать кадры на стороне сервера.
Показать решение
Пример ответа для камеры контроля таблеток на производственной линии: разверни v2-finetune в europe-west1 (Сен-Гилен — регион с минимальной задержкой для немецкого завода) с размером по умолчанию. Холодный запрос после часа простоя: 38 с — тайм-аут в 90 секунд позволяет его обработать; прогретый запрос: 0,3 с. Решение: ПЛК линии отправляет кадр каждые 30 секунд во время смен, поэтому конечная точка остаётся прогретой всю смену и только обработка первого кадра требует холодного запуска. Вызов /health с контроллера линии за 2 минуты до каждой смены устраняет и эту задержку, поэтому можно оставить бесплатный размер по умолчанию и сэкономить около $90 в месяц по сравнению с пользовательским экземпляром на 1 vCPU и 4 GiB. Повторная замена модели на v1-baseline возвращает результаты v1 по тому же URL; для завершения снова замени модель на v2.