Контролируй работоспособность и точность
Изучи метрики конечной точки и статистику предсказаний в Platform, настрой оповещение по результатам регулярной проверки работоспособности и отслеживай дрейф точности с помощью контрольной выборки.
Конечная точка может отвечать 200 OK на каждый запрос, а её точность при этом упадёт на 5 пунктов из-за того, что ночная смена приглушила свет. Platform показывает работу каждой конечной точки, но не отправляет оповещения и не может оценить точность без меток. В этом уроке ты настроишь две регулярные проверки, которые устранят этот пробел, и отработаешь оповещение о снижении точности на симуляции ночной смены.
Практические занятия
Что показывает Platform#

| Сигнал | Где | Как долго хранится |
|---|---|---|
| HTTP-запросы, частота ошибок (4xx и 5xx), задержка P95 | Карточки на странице развёртывания и вкладке Deployments; обновляются каждую минуту | Карточки показывают данные за 24 часа; API предоставляет данные за период от 1 часа до 30 дней |
| Работоспособность | Карточка Endpoint на вкладке Overview | В режиме реального времени; при сбое автоматически выполняются повторные проверки |
| Журналы | Вкладка Logs: 20 последних записей, фильтр Errors | API возвращает до 200 записей за запрос с постраничной навигацией |
| Статистика предсказаний и временные примеры (до 100 изображений) | Вкладка Monitoring | Только в памяти обслуживающего экземпляра |
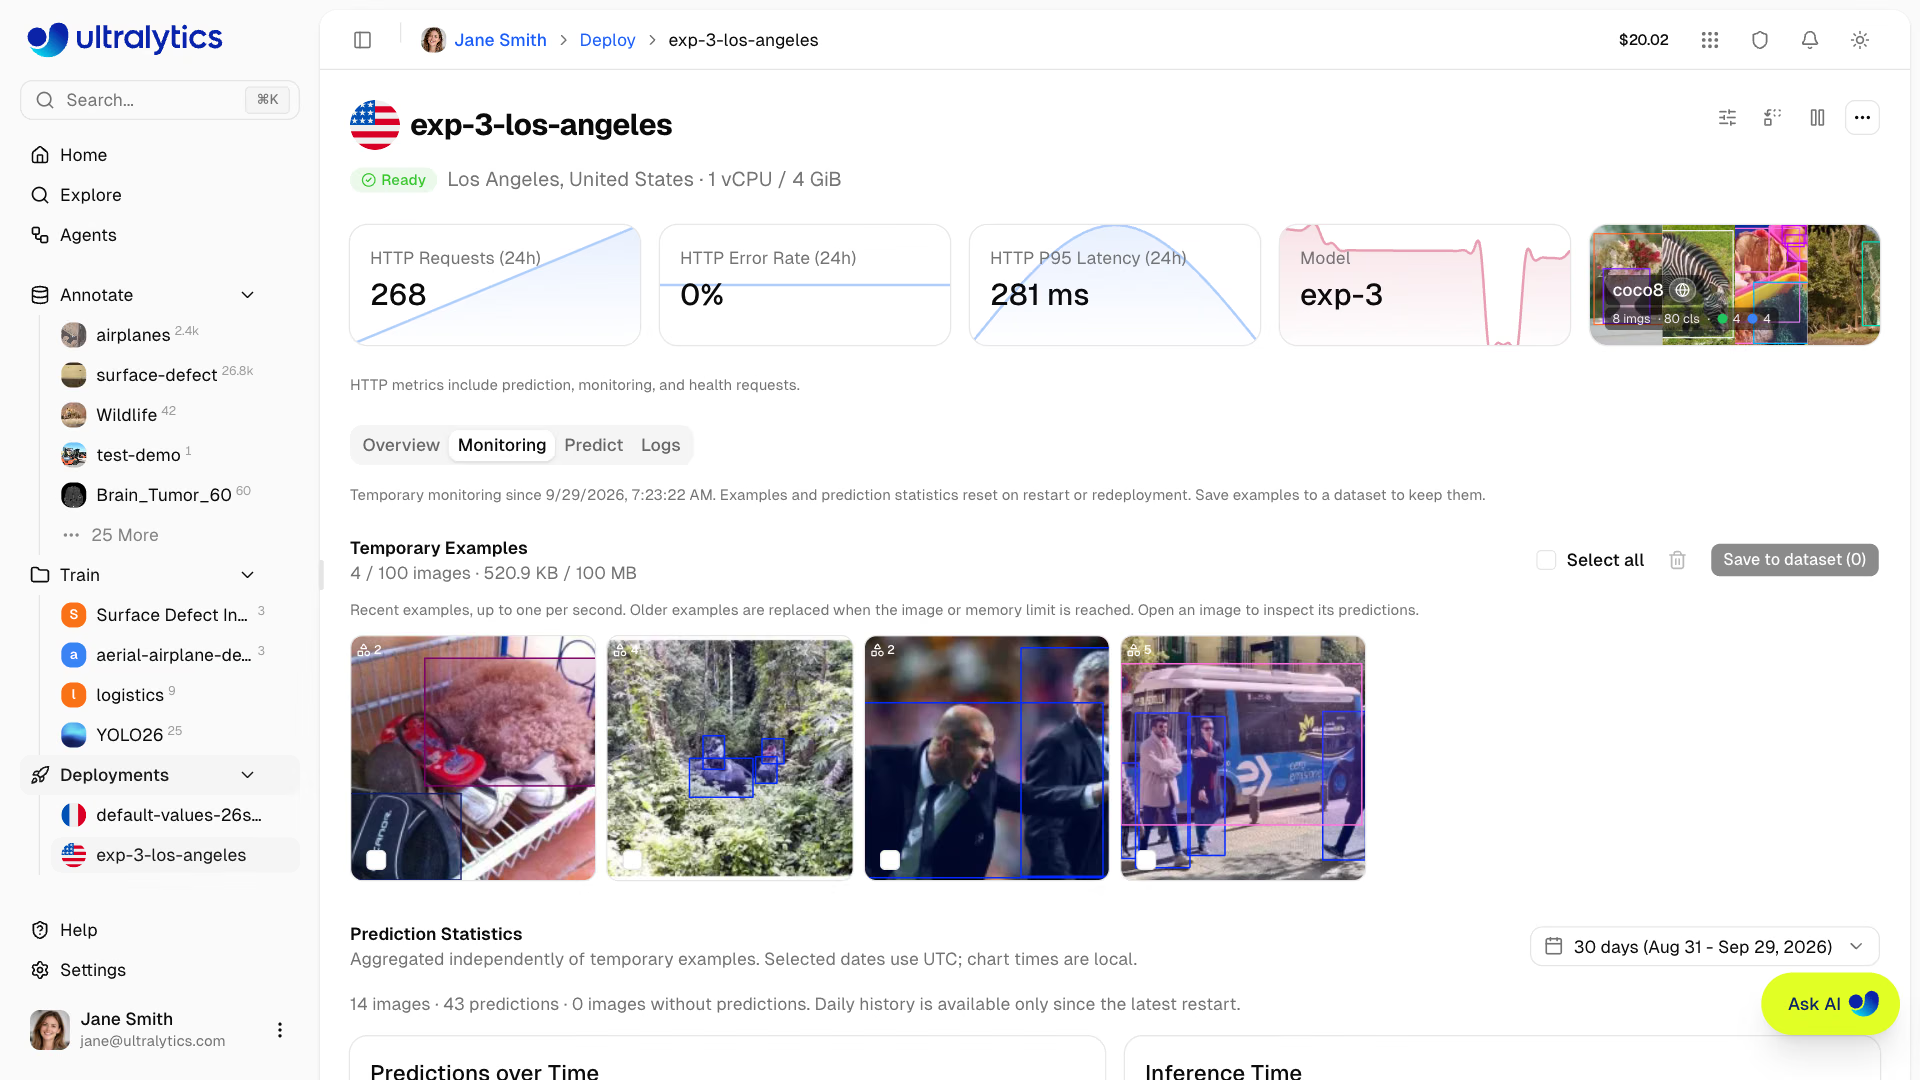
Есть два важных ограничения. Метрики собираются только тогда, когда конечная точка имеет статус Ready, а удаление развёртывания закрывает доступ к его истории. Статистика и примеры на вкладке Monitoring пропадают при каждой остановке, перезагрузке, смене размера конечной точки или замене модели: это представление в реальном времени, а не архив.
Практический пример: регулярная проверка конечной точки#
В Platform карточка частоты ошибок становится красной при превышении 5%, а Slack может сообщать о готовности развёртывания или сбое запуска, но оповещений о превышении порогов нет. Запускай эту проверку каждые 5 минут через cron, CI или агент мониторинга и отправляй оповещение при ненулевом коде завершения:
from ultralytics_platform import Platform

OWNER, DEPLOYMENT = "your-username", "yolo26n-iowa"  # from the deployment page URL
P95_BUDGET_MS, MAX_ERROR_RATE = 300, 1.0  # errorRate is a percentage

with Platform() as client:  # reads ULTRALYTICS_API_KEY
    health = client.deployments.health(OWNER, DEPLOYMENT)
    summary = client.deployments.metrics(OWNER, DEPLOYMENT, range="1h", view="overview")["summary"]
    print(
        f"healthy={health['healthy']} requests={summary['totalRequests']} "
        f"p95={summary['p95LatencyMs']:.0f} ms errors={summary['errorRate']:.2f}%"
    )
    if not health["healthy"] or summary["p95LatencyMs"] > P95_BUDGET_MS or summary["errorRate"] > MAX_ERROR_RATE:
        for entry in client.deployments.logs(OWNER, DEPLOYMENT, severity="ERROR,WARNING", limit=5)["entries"]:
            print(entry["timestamp"], entry["severity"], entry["message"][:120])
        raise SystemExit(1)  # non-zero exit lets cron, CI, or your pager treat it as an alert
При запуске с заглушкой API, которая возвращает работоспособную конечную точку, скрипт выводит одну строку и завершается с кодом 0; с P95_BUDGET_MS = 100 те же данные приводят к завершению с кодом 1:
healthy=True requests=1200 p95=180 ms errors=0.40%healthпроверяет доступность конечной точки и возвращаетhealthy,statusиlatencyMs. Кроме того, он запускает конечную точку, масштабированную до нуля, поэтому проверка каждые 5 минут одновременно поддерживает её в прогретом состоянии.metrics(..., view="overview")возвращаетtotalRequests,errorRate(процентное значение) иp95LatencyMsдля заданного периода.logsполучает последние ошибки и предупреждения, поэтому оповещение содержит первую подсказку о проблеме.
Установи SDK с помощью pip install -U ultralytics-platform (для SDK требуется Python 3.11 или новее). Отправляй оповещения только о сохраняющихся нарушениях, например после трёх неудачных проверок подряд, и добавь к каждому оповещению однострочную инструкцию по устранению проблемы.
Практический пример: отслеживание точности на контрольной выборке#
Метрики запросов не показывают точность. Для этого нужна контрольная выборка: 200–500 реалистичных производственных изображений, тщательно размеченных и сохранённых в отдельной закрытой версии набора данных, на которой никогда не обучали модель. Раз в неделю оценивай развёрнутый чекпойнт и добавляй результат в файл истории:
import json
import sys
from datetime import date
from pathlib import Path

from ultralytics import YOLO

DEPLOYED = "pills-v1.pt"  # the exact best.pt behind the endpoint
HOLDOUT = sys.argv[1] if len(sys.argv) > 1 else "medical-pills.yaml"  # labeled, never trained on

metrics = YOLO(DEPLOYED).val(data=HOLDOUT, split="val", plots=False, verbose=False)
history = Path("holdout_history.jsonl")
rows = [json.loads(line) for line in history.read_text().splitlines()] if history.exists() else []
row = {"date": date.today().isoformat(), "data": HOLDOUT, "map50_95": round(float(metrics.box.map), 4)}
history.write_text("".join(json.dumps(r) + "\n" for r in [*rows, row]))

baseline = rows[0]["map50_95"] if rows else row["map50_95"]
drop = baseline - row["map50_95"]
print(f"holdout mAP50-95 {row['map50_95']:.3f} (baseline {baseline:.3f}, drop {drop:+.3f})")
if drop > 0.01:  # more than 1 mAP point below the deployment-day baseline
    raise SystemExit("ALERT: holdout accuracy regressed - open the retraining runbook")
Первый запуск фиксирует базовый уровень точности на день развёртывания. Затем заранее проверь оповещение: этот скрипт создаёт копию контрольной выборки «ночная смена» с теми же метками и изображениями, яркость которых снижена до 15%:
import shutil
from pathlib import Path

import cv2

from ultralytics.data.utils import check_det_dataset

src = Path(check_det_dataset("medical-pills.yaml")["path"])
dst = Path("pills-night")
(dst / "images/val").mkdir(parents=True, exist_ok=True)
for img in (src / "images/val").glob("*.jpg"):  # darken every holdout image to mimic a dim night shift
    cv2.imwrite(str(dst / "images/val" / img.name), (cv2.imread(str(img)) * 0.15).astype("uint8"))
shutil.copytree(src / "labels/val", dst / "labels/val", dirs_exist_ok=True)  # same labels, darker pixels
Path("pills-night.yaml").write_text(f"path: {dst.resolve()}\ntrain: images/val\nval: images/val\nnames:\n  0: pill\n")
print("wrote pills-night.yaml")
$ python holdout_check.py
holdout mAP50-95 0.659 (baseline 0.659, drop +0.000)
$ python simulate_night_shift.py
wrote pills-night.yaml
$ python holdout_check.py pills-night.yaml
holdout mAP50-95 0.609 (baseline 0.659, drop +0.050)
ALERT: holdout accuracy regressed - open the retraining runbookКаждый запрос во время ночной смены по-прежнему получал бы ответ 200 за миллисекунды, хотя модель потеряла 5 пунктов mAP. Это заметно только по контрольной выборке. Ежеквартально обновляй контрольную выборку, добавляя новые размеченные производственные изображения, и сбрасывай базовый уровень при каждом развёртывании новой модели. В руководстве по мониторингу моделей и уроке Наблюдаемость и дрейф описаны статистические тесты на дрейф.
Отслеживай дрейф на вкладке Monitoring#
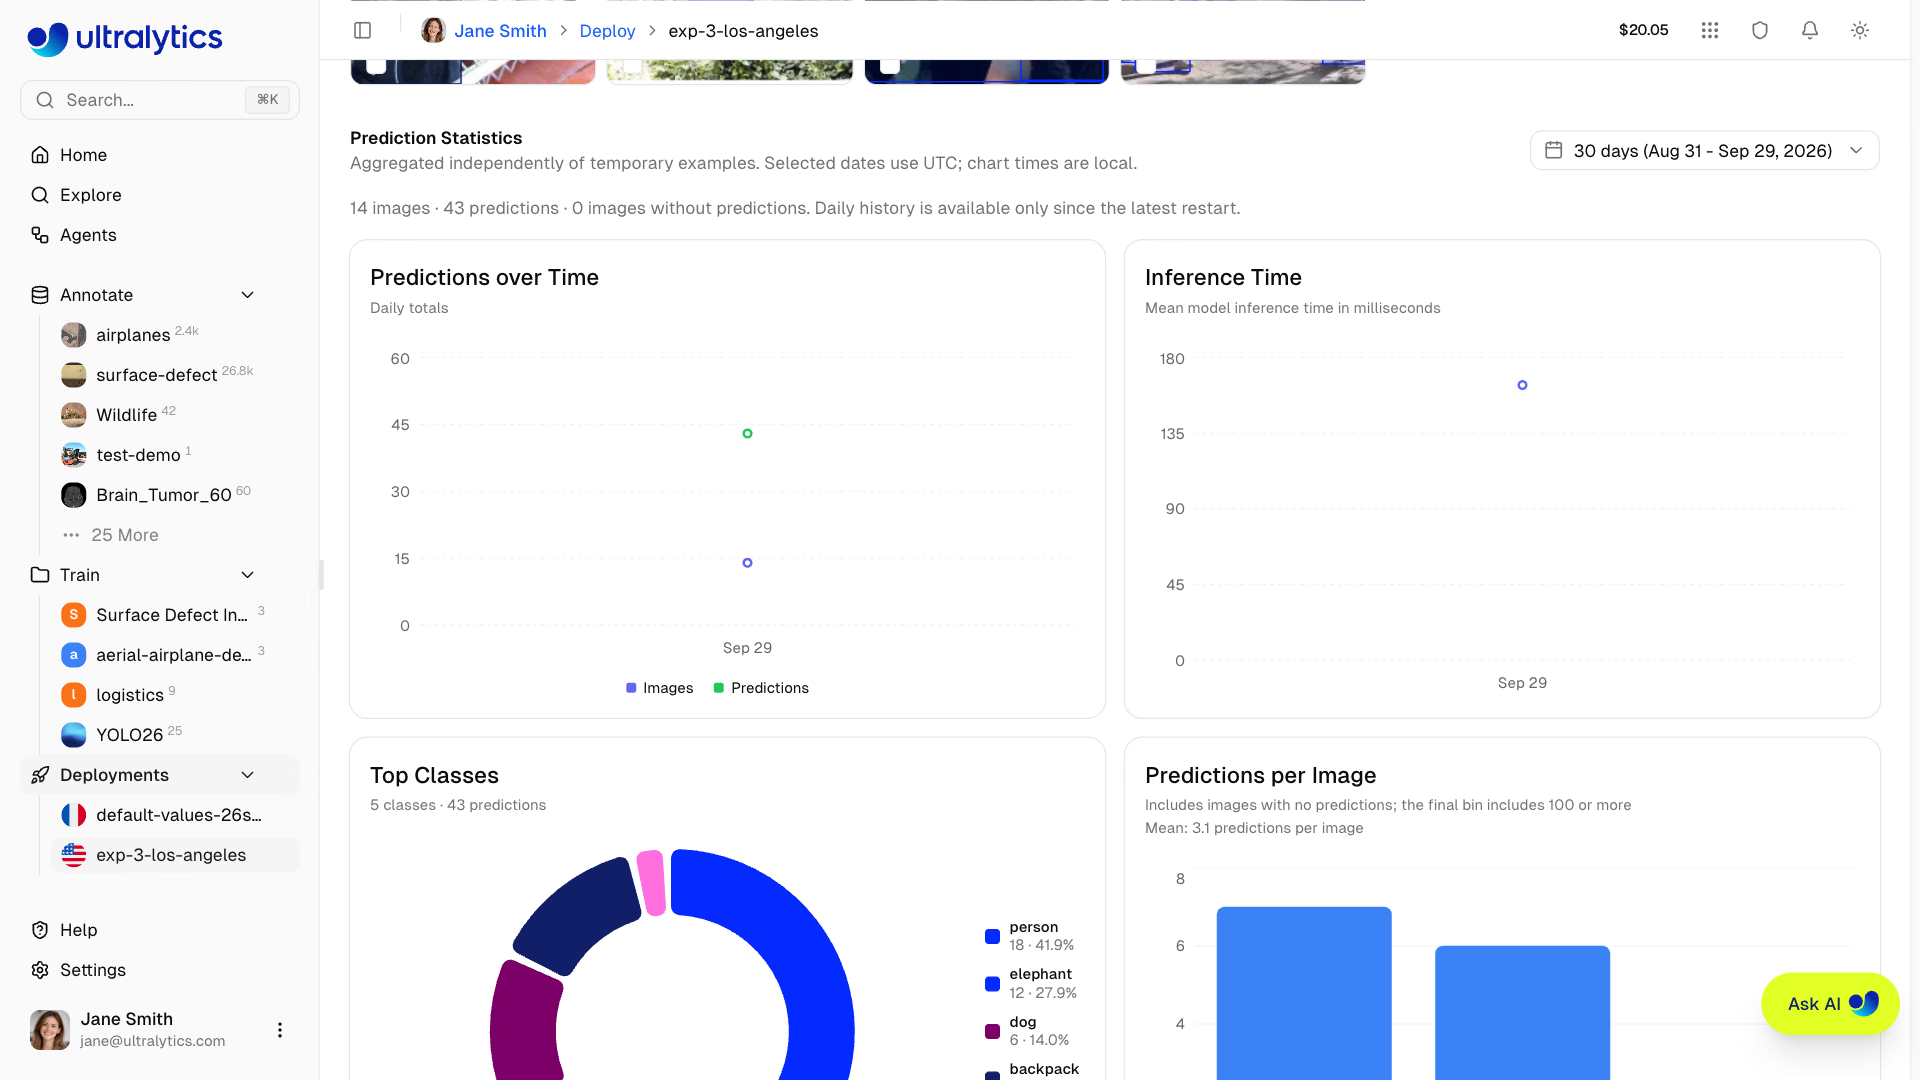
Зафиксируй форму графиков в неделю развёртывания, а затем сравнивай с ней новые данные. Уверенность показывает степень уверенности модели, а не правильность предсказания, поэтому оценивай эти графики вместе с контрольной выборкой:
| Сценарий | Вероятная причина | Действие |
|---|---|---|
| Уверенность снижается, показатели контрольной выборки стабильны | Безвредный сдвиг домена | Наблюдай за ситуацией; сохрани примеры для следующей версии набора данных |
| Снижаются и уверенность, и показатели контрольной выборки | Реальное снижение точности | Переобучи модель (урок 10) |
| Размеры или расположение рамок внезапно изменились | Переместили камеру, изменили объектив или площадку | Проверь камеру, прежде чем менять модель |
| Число предсказаний на изображение снизилось, уверенность стабильна | Камера отключена, сцена стала спокойнее или в клиенте появилась ошибка | Проверь системы выше по потоку |
| Задержка P95 выросла, время инференса не изменилось | Обработка запросов, размер данных или пропускная способность | Проблема в инфраструктуре, а не в модели |
Возвращай производственные изображения в набор данных#
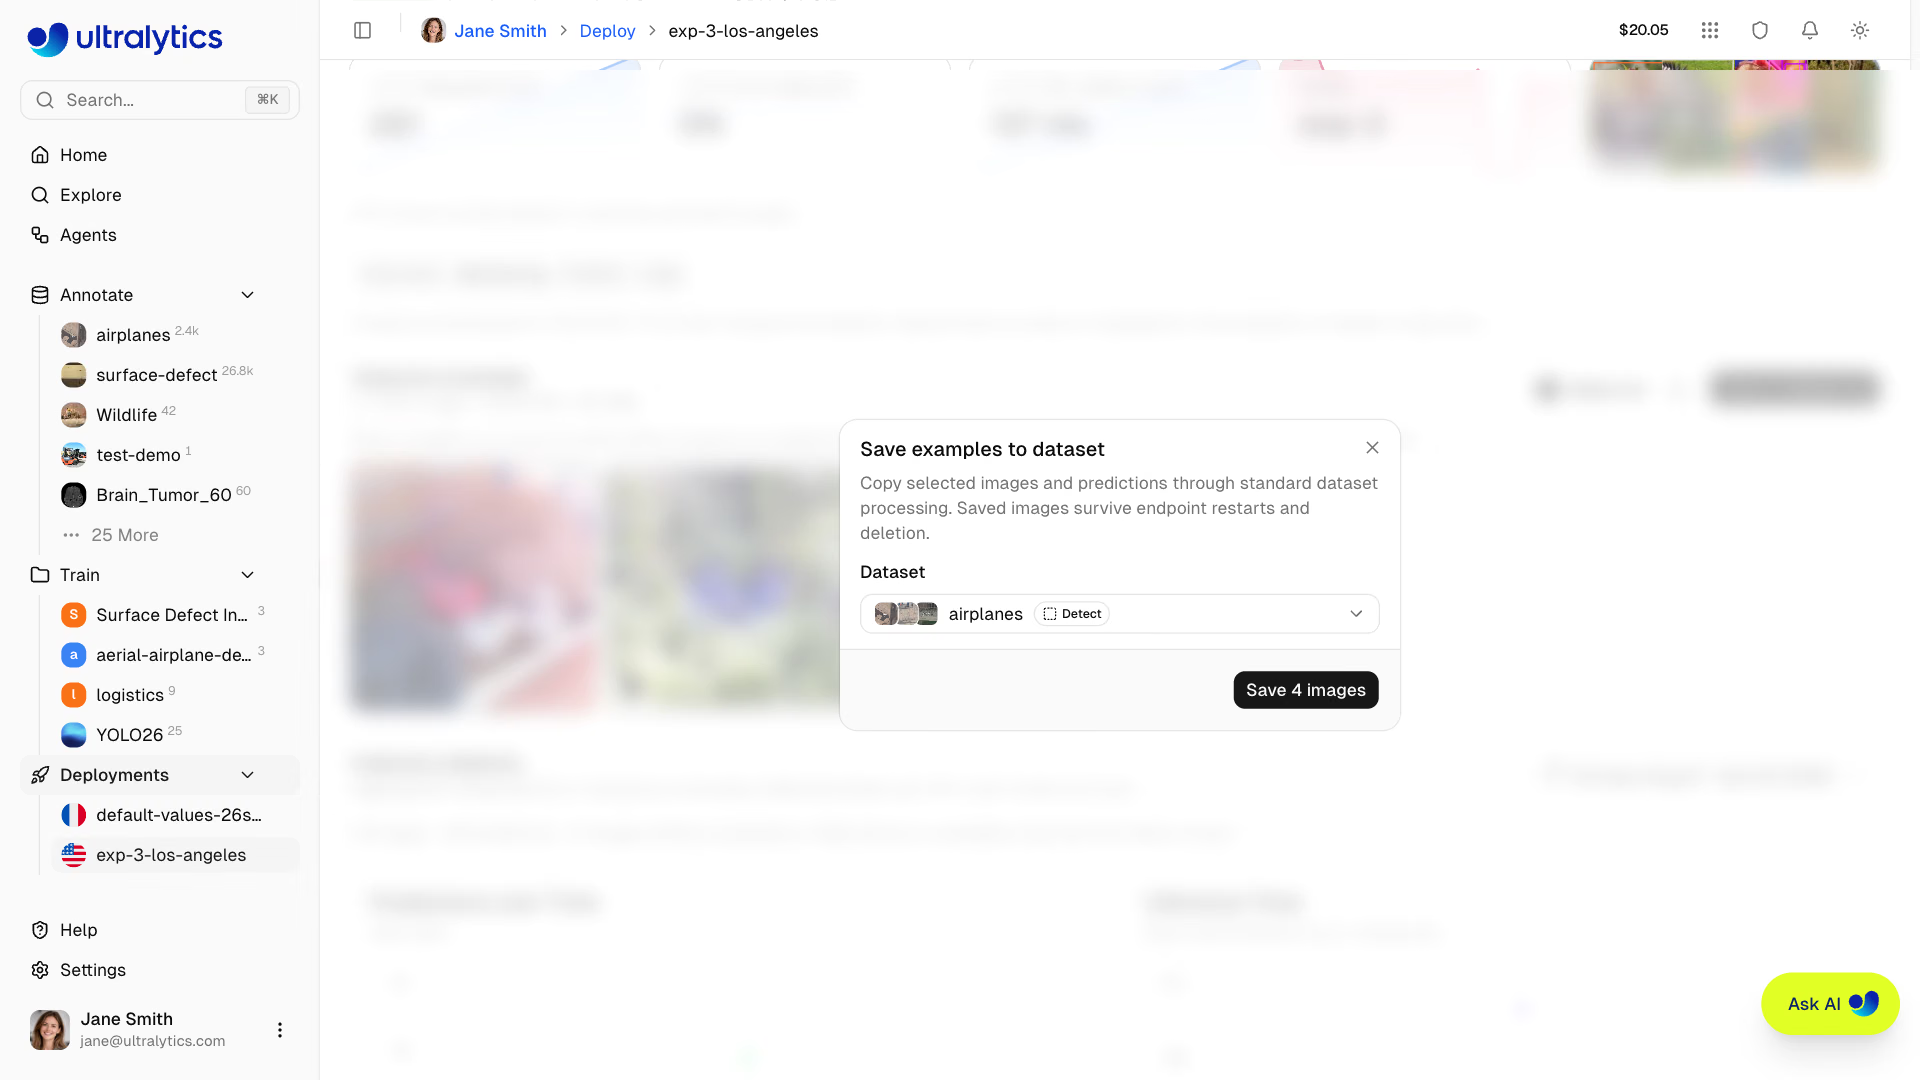
На вкладке Monitoring выбери примеры и нажми Save to dataset; они пройдут стандартную загрузку, сохранив предсказания и регион deploymentId в метаданных. Шаблон агента Collect Uncertain Detections делает то же самое для всего набора данных: он выполняет предсказания с помощью твоего развёртывания и копирует изображения с обнаружениями в заданном диапазоне уверенности в набор для проверки.
Подводные камни#
Симптом: примеры, которые ты собирался разметить, исчезают после изменения размера или замены модели. Решение: они хранятся в памяти экземпляра, обслуживающего запросы. Сохрани их в датасет и дождись завершения загрузки данных, прежде чем останавливать экземпляр, менять его размер или заменять модель.
Симптом: сразу после выпуска более качественной модели срабатывает оповещение об отложенной выборке или больше не срабатывает никогда. Решение: базовый уровень — это первая строка истории. Каждый раз при замене модели запускай новый holdout_history.jsonl (или записывай новую строку базового уровня).
Симптом: во время всплеска трафика растёт доля ошибок, хотя проверка работоспособности показывает норму. Решение: ответы 429 учитываются как ошибки, но означают «достигнута предельная ёмкость». Проверь журналы; если это ошибки 429, распредели трафик между большим числом эндпоинтов или используй пользовательский размер побольше.
Показать решение
Рабочий пример для эндпоинта таблеток: запись cron */5 * * * * python endpoint_check.py || ./page-oncall.sh с P95_BUDGET_MS = 300 и MAX_ERROR_RATE = 1.0; если установить бюджет 100 мс при реальном P95 в 180 мс, процесс завершается с кодом 1 и отправляет оповещение, значит, настройка работает. Еженедельная задача CI запускает holdout_check.py с DEPLOYED = "pills-v2.pt" на приватной версии отложенной выборки из 300 изображений: базовый уровень — 0.69. Репетиция ночной смены снижает его на 0.05 и выводит строку ALERT с кодом завершения 1, из-за чего задача CI завершается ошибкой и отправляет уведомление в канал. Двенадцать примеров Monitoring с вечерней смены отправляются в pill-review через «Сохранить в датасет»; к каждому добавляются теги deploymentId и europe-west1.