Очистка, дедупликация и разбиение
Найди дубликаты между сплитами и пробелы в классах с помощью двух коротких скриптов, разбей данные по важной для тебя единице и зафиксируй проверенную версию набора данных.
Оценка на валидации настолько достоверна, насколько корректно сформирован сплит. В популярном демонстрационном наборе данных COCO128 одни и те же 128 изображений намеренно используются для обучения и валидации, а случайное повторение этой схемы в твоих данных даст «отличную» модель, которая провалится при работе со следующей камерой. В этом уроке выполняются две проверки на реальных данных: поиск дубликатов и проверка классов в каждом сплите; затем данные разбиваются по камерам, а версия, прошедшая обе проверки, фиксируется.
Практические занятия
Пример: найди изображения, общие для разных сплитов#
Платформа хранит по одной копии изображения в каждом сплите и при загрузке предлагает обработать конфликты, но это не мешает одному и тому же изображению или сцене попасть и в train, и в val. Проверь данные перед загрузкой и ещё раз после объединения наборов данных:
import hashlib
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("coco128.yaml")  # any local YOLO dataset YAML before you upload it

def hashes(split_dir):
    return {hashlib.md5(p.read_bytes()).hexdigest(): p.name for p in Path(split_dir).rglob("*.jpg")}

train, val = hashes(data["train"]), hashes(data["val"])
shared = train.keys() & val.keys()
print(f"train {len(train)} images, val {len(val)} images, identical in both: {len(shared)}")
print("examples:", sorted(val[h] for h in shared)[:3])
train 128 images, val 128 images, identical in both: 128
examples: ['000000000009.jpg', '000000000025.jpg', '000000000030.jpg']Каждое изображение для валидации из COCO128 также входит в обучающую выборку. Для набора данных, предназначенного для быстрой проверки, это сделано намеренно, и именно поэтому его mAP на валидации ничего не говорит об обобщающей способности модели. В твоих данных любое ненулевое количество таких изображений — утечка: перед обучением перемести или удали по одной копии каждого изображения.
Найди близкие дубликаты с помощью Clustering#
Хеши обнаруживают только побайтно идентичные файлы. Соседние видеокадры, снимки из серии и перекодированные копии отличаются на несколько пикселей. Открой значок диаграммы рассеяния на панели инструментов галереи и нажми Analyze Dataset (от 20 до 200 000 изображений, только загруженные наборы данных):
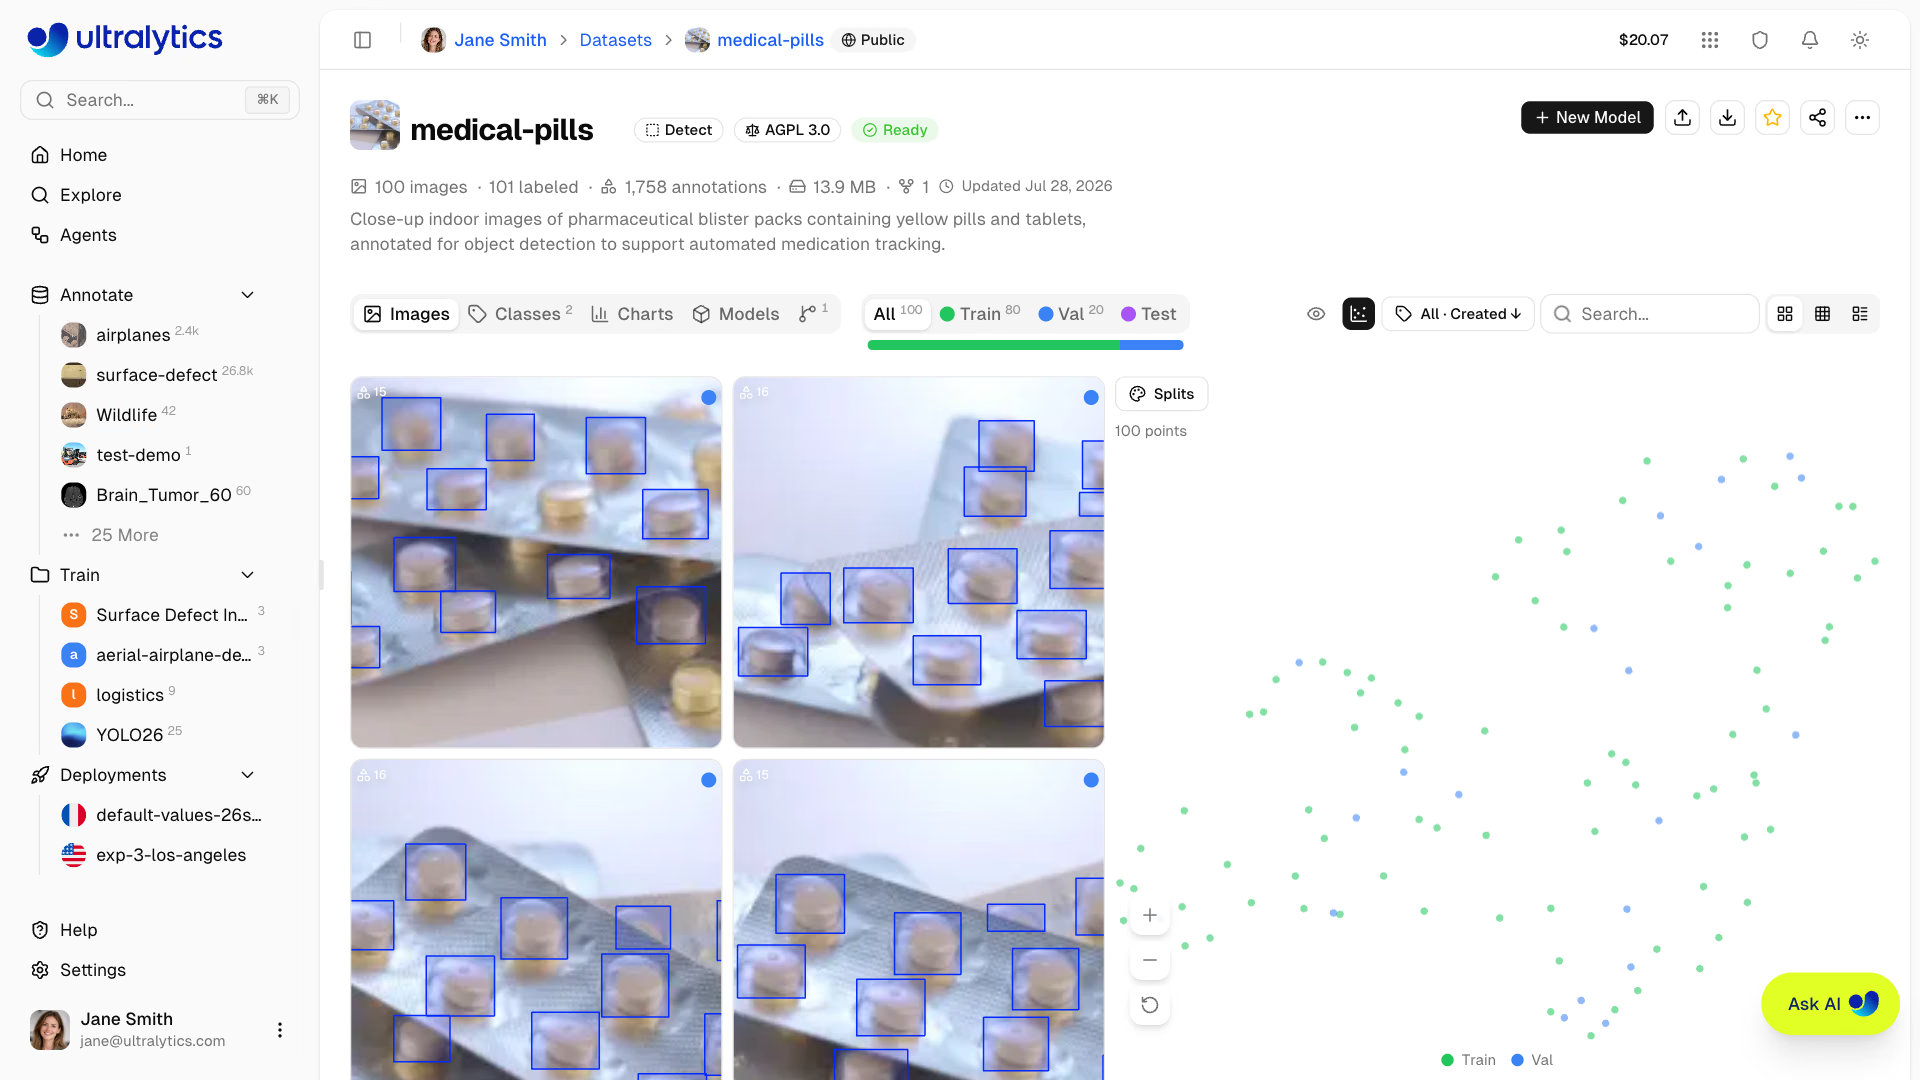
- Раскраска по сплитам: компактная группа точек, в которой перемешаны train и val, указывает на утечку из-за близких дубликатов.
- Раскраска по кластерам или классам: огромная группа одного класса показывает, чему набор данных уделяет слишком много внимания; отдельные точки — это выбросы (неправильная камера, повреждённый кадр, неверно размеченное изображение).
- Выдели область лассо или щёлкни по ней, чтобы отфильтровать галерею и оставить в ней эти изображения (до 1 000), а затем удали, перемести или переименуй их.
Те же эмбеддинги используются для функции Поиск похожих изображений в контекстном меню изображения: она добавляет похожие изображения из общедоступных и командных наборов данных в train как неразмеченные. Это самый быстрый способ заполнить пробел, обнаруженный проверкой ниже.
Пример: проверь классы в каждом сплите#
Скачай экспорт NDJSON из заголовка набора данных или на вкладке Versions. Каждая строка после заголовка содержит одно изображение, его сплит и метки, поэтому несколько строк Python позволяют подсчитать каждый класс в каждом сплите. Здесь скрипт выполняется на общедоступном экспорте COCO8:
import json
from collections import Counter, defaultdict

counts = defaultdict(Counter)  # split -> class name -> instances
images = Counter()
with open("coco8.ndjson") as f:  # the NDJSON export from the dataset header or Versions tab
    header = json.loads(f.readline())
    names = header["class_names"]
    for line in f:
        record = json.loads(line)
        images[record["split"]] += 1
        for box in (record.get("annotations") or {}).get("boxes", []):
            counts[record["split"]][names[str(box[0])]] += 1

print("images per split:", dict(images))
for name in sorted(set(counts["train"]) | set(counts["val"])):
    train, val = counts["train"][name], counts["val"][name]
    flag = "missing in train" if not train else "too few in val" if val < 10 else ""
    print(f"{name:<14} train {train:>3}  val {val:>3}  {flag}")
images per split: {'train': 4, 'val': 4}
bowl train 3 val 0 too few in val
broccoli train 1 val 0 too few in val
dog train 0 val 1 missing in train
elephant train 0 val 2 missing in train
giraffe train 2 val 0 too few in val
horse train 0 val 2 missing in train
orange train 4 val 0 too few in val
person train 0 val 10 missing in train
potted plant train 1 val 1 too few in val
umbrella train 0 val 1 missing in train
vase train 1 val 0 too few in val
zebra train 1 val 0 too few in valПри чтении учитывай: строка заголовка содержит class_names; каждая рамка обнаружения — это [class, x, y, w, h]. Нет в train означает, что модель вообще не сможет обучиться распознавать этот класс, а его AP на val будет равен нулю. Слишком мало в val означает, что AP класса будет сильно меняться от запуска к запуску: если в val 7 паллет, пропуск одной паллеты сдвигает AP для паллет примерно на 14 пунктов. COCO8 — это проверочный набор из 8 изображений, поэтому проверку не проходит каждый класс; в твоей рабочей версии не должно быть ни одного предупреждения. Устраняй пробелы, собирая дополнительные примеры, а не подбирая параметры.
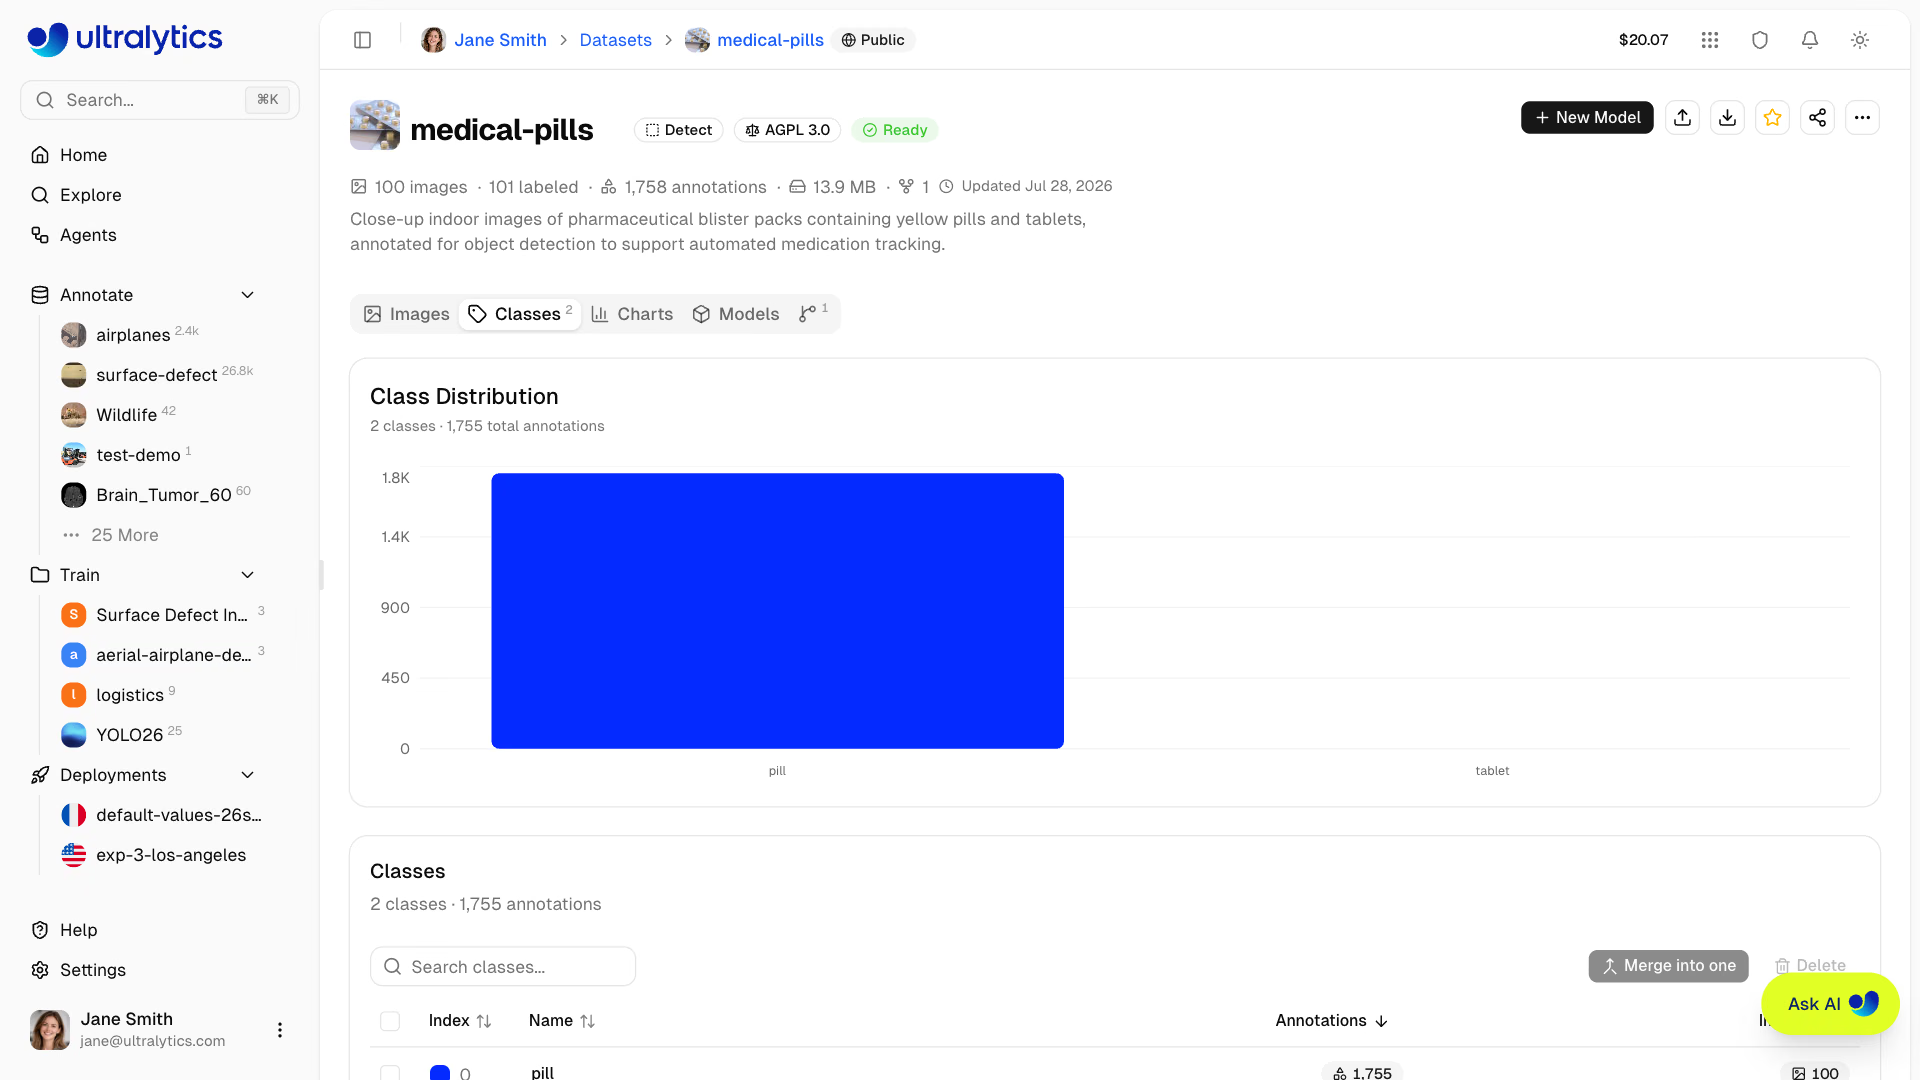
На вкладке Classes отображаются те же подсчёты для текущего набора данных; для несбалансированных данных можно включить логарифмическую шкалу. Функция Объединить в один сводит дубликаты, например car, automobile и vehicle, в один класс без потери аннотаций; Удалить удаляет класс и все его аннотации.
Разбивай данные по единице, для которой важно обобщение модели#
Кадры с одной камеры, из одной сессии или за один день коррелируют друг с другом. Если они попадают и в train, и в val, модель оценивается на сценах, которые уже видела. Откладывай целиком те единицы, которые меняются при эксплуатации: если меняются камеры — отложи камеры; если те же камеры снимают в другие дни — отложи дни.
Инструменты разбиения на платформе различаются именно в этом:
| Инструмент | Как выполняется назначение | Используется для |
|---|---|---|
Папки train/, val/, test/ в загружаемом наборе | Сохраняет назначенные тобой сплиты | Групповое разбиение, подготовленное офлайн |
| Фильтр сплита, установленный перед загрузкой | Все файлы из этой загрузки попадают в выбранный сплит | Загрузка данных с одной камеры в каждый сплит |
| Переместить в сплит в режиме Table | Перемещает выбранные изображения | Исправление отдельных изображений |
| Панель сплитов, Redistribute Splits | Случайным образом перераспределяет все изображения | Только для независимых фотографий |

В уроке Как правильно разбить набор данных рассказывается, как выбрать единицу разбиения; для очень маленьких наборов данных больше информации поможет извлечь кросс-валидация k-fold. Чтобы проверить группы после загрузки, добавь ключ группы в проверку классов (например, record["file"].split("_")[0] для файлов с именами cam07_000123.jpg или поле camera в метаданных изображения) и выведи все группы, встречающиеся в двух сплитах.
Зафиксируй версию, прошедшую проверку#
Для обучения нужен фиксированный снимок данных. На вкладке Versions введи описание («v5: cam07 отложена, +80 изображений паллет») и нажми New Version. Каждая версия — это неизменяемый пронумерованный снимок NDJSON, который можно скачать, сравнить или восстановить; при запуске то же самое делает диалог обучения с помощью Save Dataset Version и повторно использует совпадающую версию, если ничего не изменилось. Версии недоступны для подключённых облачных наборов данных и наборов данных On Premise.
Подводные камни#
Симптом: после нажатия Авто для разделения 80/20 mAP на валидации резко растёт, а точность в продакшене — нет. Решение: функция «Перераспределить разделения» случайным образом назначает каждое изображение (и по пути удаляет точные дубликаты), из-за чего соседние кадры попадают в обучающую и валидационную выборки. Для сгруппированных данных используй папки для загрузки или Переместить в раздел.
Симптом: в старом экспорте или предсказаниях модели внезапно появляются неправильные названия классов. Решение: ID классов задаются их позициями, поэтому при объединении или удалении класса индекс каждого класса выше него уменьшается на единицу. Создавай новую версию перед любым изменением классов и переобучай модель вместо повторного использования старых файлов разметки.
Симптом: результат нового запуска на 5 пунктов ниже, и больше ничего не изменилось. Решение: метрики можно сравнивать только на одном и том же разбиении. Изменив разбиение, укажи это в описании версии и повторно запусти базовый эксперимент на новой версии, прежде чем что-либо сравнивать.
Показать решение
Пример решения для набора данных с погрузчиками и 8 камерами. Проверка дубликатов находит 41 идентичное изображение в train и val — все из повторно загруженной папки; удали копии из val. Расширенная с помощью group = record['file'].split('_')[0] проверка показывает, что cam02 есть и в train, и в val, поэтому выбери её изображения из val в режиме Table и нажми Переместить в сплит > Train. Проверка также сообщает о pallet: train 63, val 7, too few in val: воспользуйся функцией Поиск похожих изображений для двух изображений паллет, чтобы добавить 40 похожих неразмеченных изображений, разметь их и перемести 15 изображений паллет с cam07 в val, чтобы cam07 целиком оставалась в одном сплите. Повтори проверку: 0 дубликатов, 0 утечек между группами, 22 изображения паллет в val. При раскраске Clustering по сплитам смешанных групп не обнаружено. Сохрани v5: cam07 val, cam08 test, +40 pallets.