Сравни запуски и выбери лучший
Сравнивай запуски в проекте Platform, фиксируй, зачем нужен каждый запуск, и решай с помощью скрипта проверки, выпускать ли кандидата.
Более крупные модели обычно выигрывают по основной метрике, но проигрывают по одному классу, который никто не проверил. Если заранее не установить правило, в выпуск попадёт модель, которая больше всего понравилась кому-то из команды. В этом уроке мы фиксируем каждый запуск, чтобы позже можно было найти обоснование, и превращаем вопрос «стало ли лучше?» в скрипт проверки, который возвращает PASS или FAIL.
Практические занятия
Сравнивай запуски в проекте#
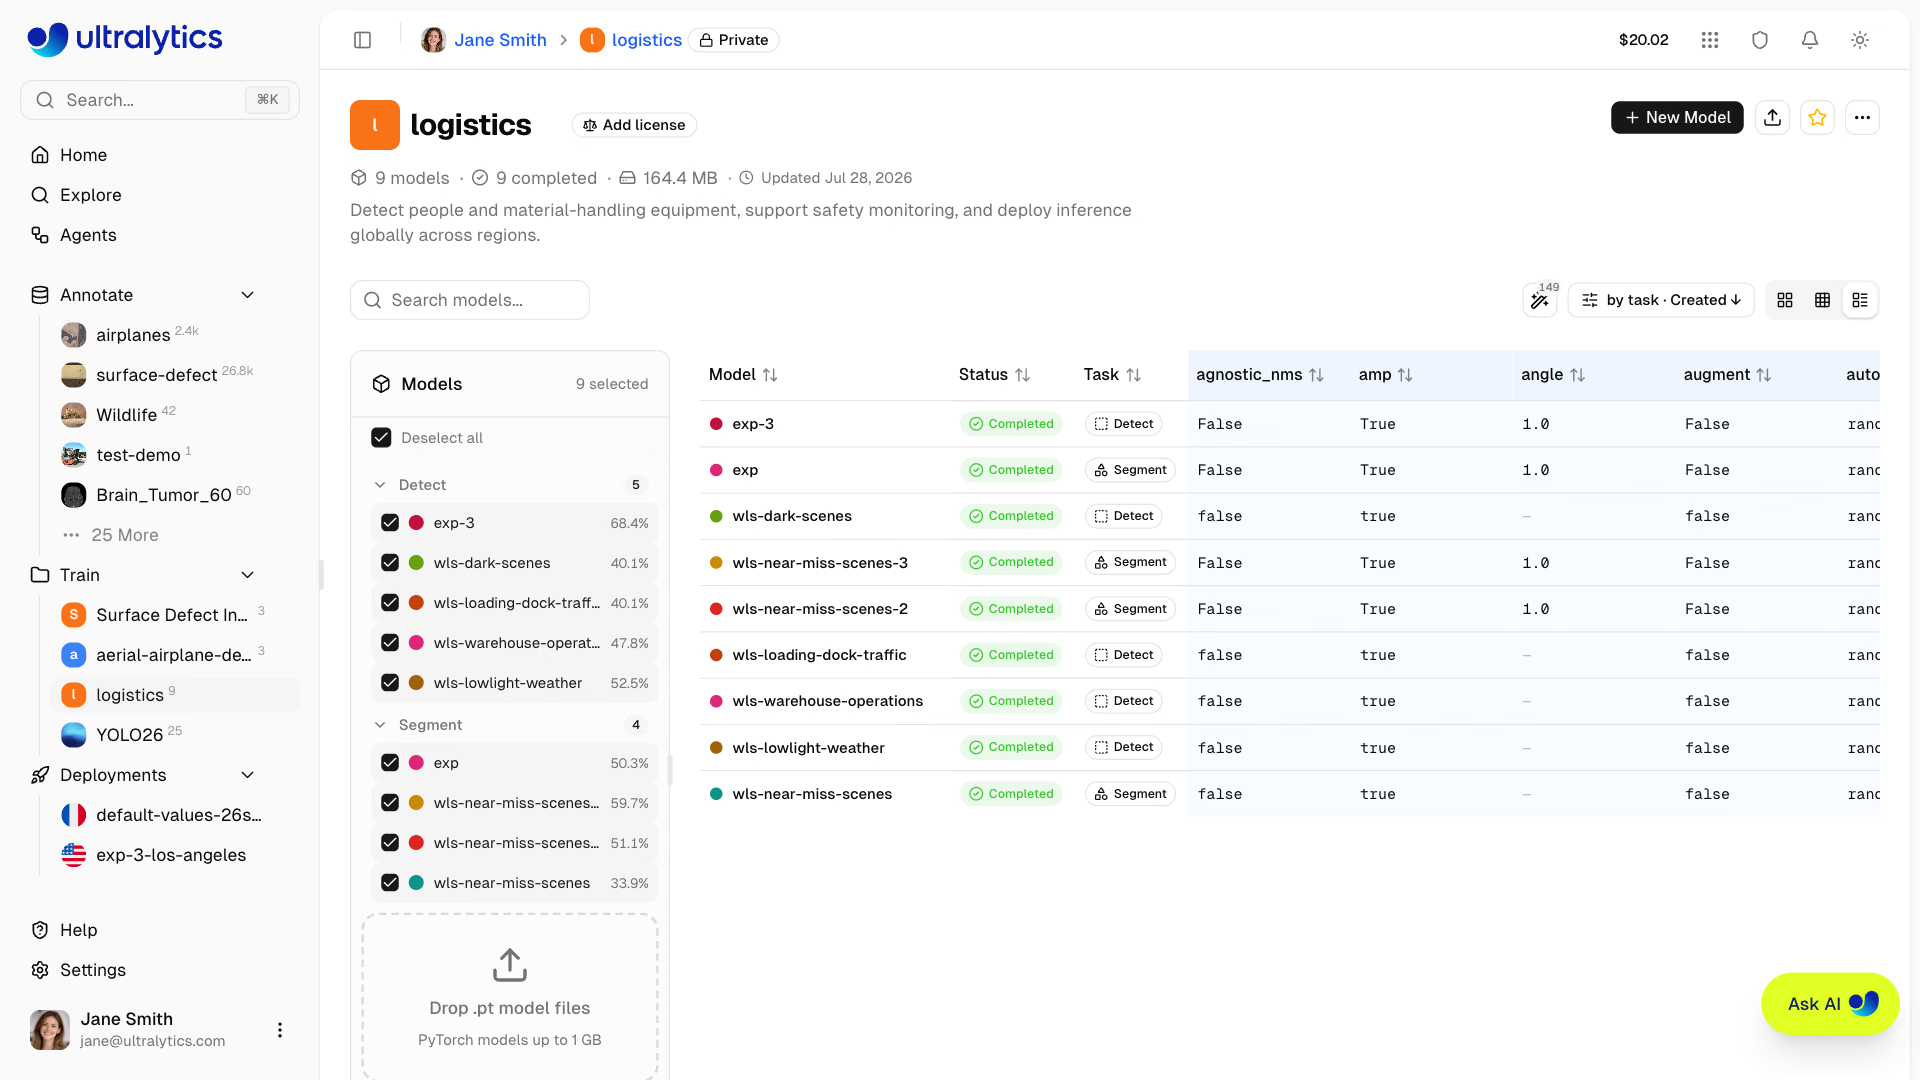
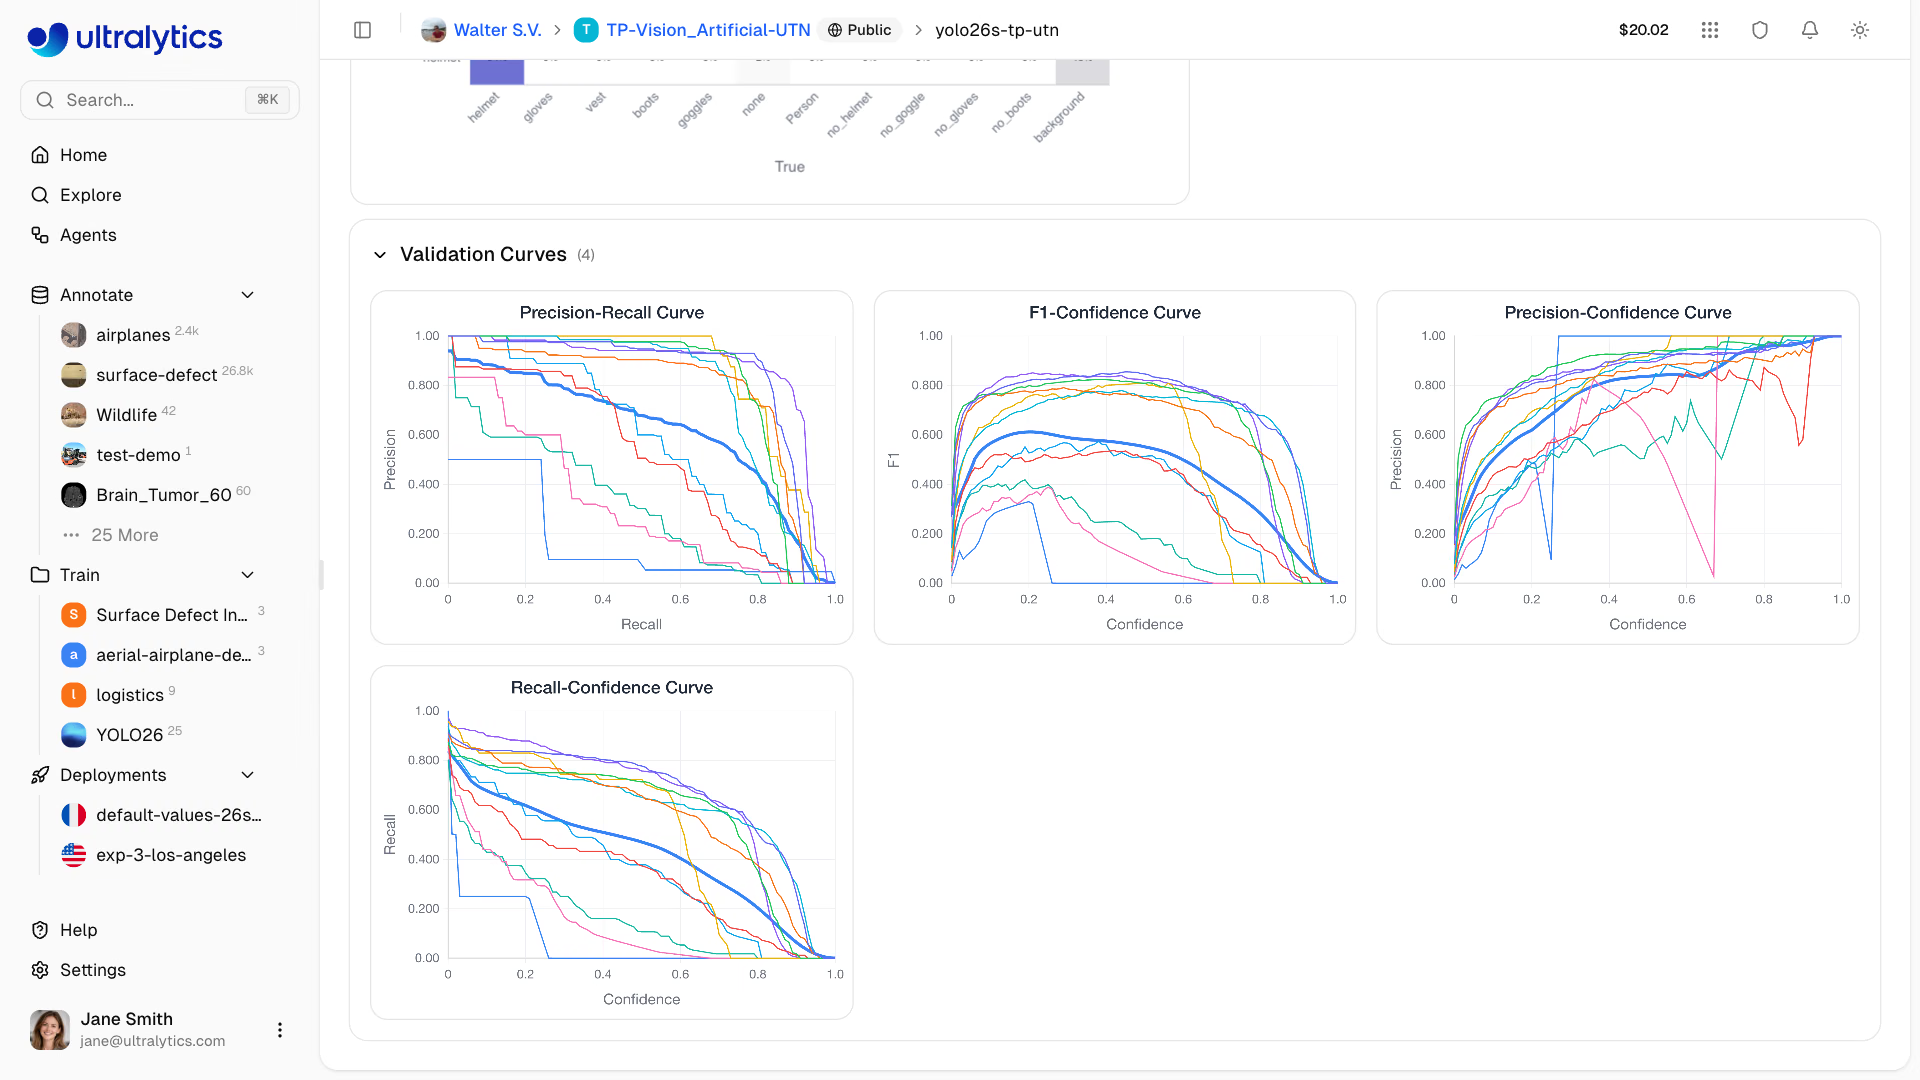
В проекте перечислены модели с флажками. Выбранные модели накладываются друг на друга на панели Charts; в режиме Table рядом отображаются параметры обучения и итоговые метрики, а Diff скрывает одинаковые столбцы, чтобы сразу было видно, что два запуска отличаются только значением imgsz. Сравнение работает в пределах одного проекта, поэтому храни связанные эксперименты вместе (модели можно вырезать и вставлять между проектами). При анализе кривых сравнивай итоговое значение, скорость его достижения и плавность изменения.

Если есть две или более завершённые модели, функция Compare with AI просит Ask AI обобщить различия и предложить следующий эксперимент. Отнесись к предложению как к гипотезе для следующего запуска, а не как к окончательному выводу.
Сделай каждый запуск понятным#
Смысл заключён в названиях: run_5 ничего не говорит, а v3_pallets_added и v4_imgsz1024 указывают версию датасета и внесённые изменения. Чтобы записать обоснование, открой More actions > Information на странице модели и сохрани заметку в JSON как Custom Metadata:
{
  "hypothesis": "Pallet AP is low because val holds only 7 pallets",
  "change": "Dataset v3: +80 pallet images from cam03 and cam07; fine-tuned from v2",
  "result": "Pallet AP 0.31 -> 0.58, overall mAP50-95 0.51 -> 0.59",
  "next": "Forklift recall drops at night; collect dawn and dusk footage"
}
Остальные сведения записывает Platform: в карточке Run Information указаны GPU, почасовая ставка, общая стоимость, версия ultralytics, хост, родительская модель, закреплённая версия датасета, коммит Git (если доступен) и копируемая команда yolo train. Справедливо сравнивать только запуски на одной версии датасета, поэтому для каждого запуска нужно закреплять её.
Выбери метрику и критерии до просмотра результатов#
| Метрика | Когда подходит |
|---|---|
| mAP50-95 | Метрика по умолчанию для detect, segment, pose и OBB: учитывает точность рамок и достаточно стабильна для сравнения |
| mAP50 | Крупные, хорошо разделённые объекты, для которых точность рамок не так важна |
| AP для отдельного класса | Один класс определяет коммерческую ценность |
| Полнота при фиксированной точности | Системы безопасности и сигнализации |
| Задержка инференса на целевом устройстве | Всегда — как жёсткое ограничение |
В руководстве по метрикам производительности YOLO описана каждая метрика. Кандидат выпускается, только если проходит все проверки:
Пример: скрипт проверки перед выпуском#
Скачай файлы best.pt для финалистов и оцени их на одинаковых данных одним и тем же кодом. В этом примере используются две официальные контрольные точки, поэтому его можно запустить где угодно:
from ultralytics import YOLO

DATA = "coco8.yaml"  # identical held-out data for both runs; use your test split for the final call
BASELINE, CANDIDATE = "yolo26n.pt", "yolo26s.pt"  # e.g. best.pt from two Platform runs
NOISE, CLASS_FLOOR, LATENCY_BUDGET_MS = 0.005, 0.90, 100.0

def evaluate(weights):
    m = YOLO(weights).val(data=DATA, plots=False, verbose=False)
    per_class = {m.names[int(c)]: ap for c, ap in zip(m.box.ap_class_index, m.box.ap)}
    return m.box.map, per_class, m.speed["inference"]

(base_map, base_ap, _), (cand_map, cand_ap, cand_ms) = evaluate(BASELINE), evaluate(CANDIDATE)
weak = [n for n, ap in base_ap.items() if cand_ap.get(n, 0) < CLASS_FLOOR * ap]
gates = {
    f"mAP50-95 {base_map:.3f} -> {cand_map:.3f} beats noise": cand_map - base_map > NOISE,
    f"every class keeps {CLASS_FLOOR:.0%} of its AP (weak: {', '.join(weak) or 'none'})": not weak,
    f"inference {cand_ms:.1f} ms within {LATENCY_BUDGET_MS:.0f} ms": cand_ms <= LATENCY_BUDGET_MS,
}
for name, ok in gates.items():
    print("PASS" if ok else "FAIL", name)
print("verdict:", "ship the candidate" if all(gates.values()) else "keep the baseline, run more experiments")
raise SystemExit(0 if all(gates.values()) else 1)  # non-zero exit blocks a CI release step
PASS mAP50-95 0.669 -> 0.693 beats noise
FAIL every class keeps 90% of its AP (weak: elephant, potted plant)
PASS inference 44.1 ms within 100 ms
verdict: keep the baseline, run more experimentsРезультат: более крупная модель выигрывает по общей метрике 2,4 пункта, но два класса теряют более 10% AP, поэтому модель не проходит проверку. Такое ухудшение скрывает сравнение только по основной метрике. Словарь по классам берётся из ap_class_index и ap, в которых учитываются только присутствующие в данных классы; задержка измеряется на компьютере, где запущен скрипт, поэтому запускай проверку на оборудовании, похожем на целевое устройство развёртывания. В COCO8 всего 8 изображений для валидации — этого совершенно недостаточно для принятия решения. Используй отложенную выборку как минимум из нескольких сотен изображений и передай split="test" ровно один раз — для окончательной проверки.
Разбери изображения с низкими результатами#
Для запусков обнаружения, обученных с сохранённой версией датасета, в представлении Validation доступны Validation insights: изображения с худшими и лучшими результатами по F1 на отдельном изображении, показанные вместе с эталонной разметкой; инструмент анализа характеристик, который сопоставляет F1 с размером и соотношением сторон изображения, а также числом объектов; и классы, наиболее связанные с ошибками. Функция Find similar для изображений с худшими результатами добавляет похожие изображения в обучающую выборку как изображения без разметки, превращая провал проверки в конкретную задачу по работе с данными.
Подводные камни#
Симптом: опубликованное значение mAP на тестовой выборке отличное, а в продакшене результат хуже. Решение: подбирай параметры на валидационной выборке. Если ты сравнил десять запусков на тестовой выборке, значит, ты уже подстроился под неё, и результат завышен. Оцени финальных кандидатов на тестовой выборке один раз, в самом конце.
Симптом: запуск «побеждает» на 4 пункта, и никто не может воспроизвести причину. Решение: проверь закреплённую версию датасета в карточке Run Information каждого запуска. Если версии отличаются, повторно запусти базовый эксперимент на новой версии, прежде чем сравнивать.
Симптом: победитель меняется при каждом повторном обучении с новым seed. Решение: на большинстве датасетов разница менее примерно 0,5 пункта mAP — это шум между запусками. Не меняй порог шума в критерии допуска и используй более крупную отложенную выборку, если результаты настолько близки.
Показать решение
Пример для модели таблеток: сравни базовую модель v1-baseline (10 эпох) с кандидатом v2-finetune (ещё 5 эпох, SGD, lr0 0.001). Задай DATA = "medical-pills.yaml" и два веса в gate.py. Результат: PASS mAP50-95 0.659 -> 0.687 beats noise, PASS every class keeps 90% of its AP (weak: none), PASS inference 4.0 ms within 100 ms, вывод — «выпустить кандидата». В Custom Metadata для v2 укажи гипотезу «v1 всё ещё улучшалась на 10-й эпохе», изменение «дообучить 5 эпох, SGD lr0 0.001», результат «mAP50-95 0.659 -> 0.687». Добавь в метаданные примечание: выборка val medical-pills также использовалась при обучении, поэтому перед запуском в производство нужно провести проверку на отдельной отложенной выборке.