Как определить, что набор данных готов
Перед первым запуском обучения проверь восемь критериев «пройдено/не пройдено», автоматизируй три проверки, которые может выполнить скрипт, и выясни, какое исправление требуется при каждом сбое.
В каждом проекте наступает момент, когда команда хочет начать обучение. Иногда набор данных готов, а иногда в нём всё ещё есть утечка между выборками или недостаточно размеченный класс, из-за чего будет потрачена неделя GPU-времени и получена цифра, которой нельзя доверять. Восемь проверок, для каждой из которых фиксируется «да», «нет» или документированное исключение, позволяют принять объективное решение, а не полагаться на настроение.
Практические занятия
Восемь проверок#
| # | Проверка | Критерии прохождения | Если проверка не пройдена, вернись к |
|---|---|---|---|
| 1 | Чёткая цель | Цель, задача, классы и критерий приёмки записаны и согласованы | Начни с бизнес-цели |
| 2 | Определённые классы | Для каждого класса есть определение и указан похожий объект, который к этому классу не относится | Цель и руководство по разметке |
| 3 | Репрезентативные изображения | Для каждого сценария из спецификации соблюдена квота; большинство изображений взято из производственных источников | Собери качественные и репрезентативные данные |
| 4 | Достаточный объём | ≥ 1 500 изображений и ≥ 10 000 экземпляров на класс либо документированное исключение | Спецификация и сбор данных |
| 5 | Согласованная разметка | Руководство подготовлено, калибровочный раунд проведён, согласованность ≥ 90% | Рекомендации по разметке |
| 6 | Контроль качества завершён | Скрипт аудита не выявил проблем, подозрительные случаи проверены, замечания по контролю качества записаны | Контроль качества набора данных |
| 7 | Чистые разбиения | Разбиение с группировкой, ни одна группа не попадает в два разбиения, каждый класс представлен в каждом разбиении | Правильно раздели набор данных |
| 8 | Фоновые изображения | 0–10% изображений — это кадры без разметки объектов | Спецификация и сбор данных |
Контрольный список проверяет те же решения, которые по отдельности рассматриваются в руководстве по сбору и разметке данных; здесь они объединены в единое решение о запуске или остановке.
Автоматизируй проверки, основанные на подсчётах#
Проверки 4, 7 и 8 сводятся к подсчётам, поэтому скрипт каждый раз оценивает их одинаково. Этот скрипт читает учебный набор и списки разбиений, созданные group_split.py на предыдущем занятии:
from collections import Counter
from pathlib import Path

root = Path("datasets/practice")  # images/, labels/, and the train/val/test.txt lists from group_split.py
splits = {s: [Path(p).stem for p in (root / f"{s}.txt").read_text().split()] for s in ("train", "val", "test")}

def classes(stem):
    label = root / "labels" / f"{stem}.txt"
    return [int(r.split()[0]) for r in label.read_text().splitlines() if r.strip()] if label.exists() else []

stems = [s for split in splits.values() for s in split]
instances = Counter(c for s in stems for c in classes(s))
images = Counter(c for s in stems for c in set(classes(s)))
background = sum(not classes(s) for s in stems) / len(stems)
groups = {split: {s.rsplit("_", 1)[0] for s in names} for split, names in splits.items()}
per_split = {split: {c for s in names for c in classes(s)} for split, names in splits.items()}
shared = (groups["train"] & groups["val"]) | (groups["train"] & groups["test"]) | (groups["val"] & groups["test"])
weakest = min(instances, key=lambda c: (images[c], instances[c]))

checks = {
    "4 volume": (images[weakest] >= 1500 and instances[weakest] >= 10_000,
                 f"weakest class {weakest}: {images[weakest]} images, {instances[weakest]} instances"),
    "7 no shared groups": (not shared, f"{len(shared)} groups appear in more than one split"),
    "7 every class in every split": (all(per_split[s] == set(instances) for s in splits),
                                     ", ".join(f"{s} misses {len(set(instances) - per_split[s])}" for s in splits)),
    "8 background 0-10%": (background <= 0.10, f"{background:.1%} background images"),
}
for name, (ok, detail) in checks.items():
    print(f"{'PASS' if ok else 'FAIL'}  {name:<29} {detail}")
FAIL 4 volume weakest class 30: 1 images, 1 instances
PASS 7 no shared groups 0 groups appear in more than one split
FAIL 7 every class in every split train misses 5, val misses 36, test misses 41
PASS 8 background 0-10% 1.6% background imagesРазбиение с группировкой устранило утечку, но учебный набор совершенно не готов: в его самом слабом классе (30, skis) всего один размеченный экземпляр, а для половины классов нельзя рассчитать метрики на val. Так и должно быть для 128 демонстрационных изображений; именно такой вердикт и должна вынести эта проверка до того, как будет потрачена неделя на обучение.
Скрипт охватывает то, что можно подсчитать. Для проверок 1, 2, 3, 5 и 6 нужен человек: согласованная цель, письменные определения, охват спецификации, измеренная оценка согласованности и заметки о контроле качества. Оцени их вручную, приводя по одной строке доказательств для каждого пункта.
Реши: обучать, выпускать с известным пробелом или исправлять#
Когда проверка не пройдена, следующим шагом почти всегда хочется сделать что угодно, только не исправлять данные:
| Соблазнительный обходной путь | Почему это не работает |
|---|---|
| «Попробуем модель побольше». | Большая модель с таким же успехом усваивает шум в разметке. |
| «Настроим скорость обучения». | Никакая настройка оптимизатора не добавит отсутствующий класс или сценарий. |
| «Обучим на большем числе эпох». | На разнообразных данных с ограниченным покрытием переобучение наступает быстрее. |
| «Добавим аугментацию». | Аугментация не создаст сценарии, которых никогда не было в данных. |
Три почти готовых набора данных#
| Сценарий | Непройденная проверка | Как это выглядит | Решение |
|---|---|---|---|
| Объём без разнообразия | 3 | 5 000 изображений, одна камера, нет сложных случаев | До обучения собери данные с других камер, площадок и в другое время |
| Разнообразие без согласованности | 5 | Разметчики расходятся во мнениях о границах рамок и степени перекрытия объектов | Заверши руководство, проведи калибровку и перемаркируй затронутую выборку |
| Незаметная утечка | 7 | Случайное разбиение видеокадров по отдельным изображениям | Раздели данные заново по видеоклипам, камерам или дням; ожидай снижения mAP на валидации — это отражает реальность. |
Запускай модель, зная о пробеле в данных#
Часто правильное решение — сначала создать целевую модель, не дожидаясь, пока все проверки пройдут: пилотную версию, прототип или v1 для части камер. Модель в продакшене быстрее покажет, что на самом деле не так, чем попытки вслепую довести датасет до совершенства. Если запускаешь модель, зная о пробеле, запиши три вещи:
- Какая проверка не пройдена.
- Ожидаемое влияние, например: «нет ночных данных; ожидай снижения полноты после наступления темноты».
- План сбора данных, который устранит проблему, пока работает v1.
Запись «Объём: исключение» ничего не говорит следующему человеку. Запись «Объём: pallet, 700 экземпляров; ожидается снижение полноты обнаружения поддонов в загруженных зонах; к июню размечаем ещё 2 000» описывает контролируемый риск. Для каждого исключения нужно указать ожидаемое влияние на приёмочное тестирование.
Повторяй проверки перед каждым переобучением#
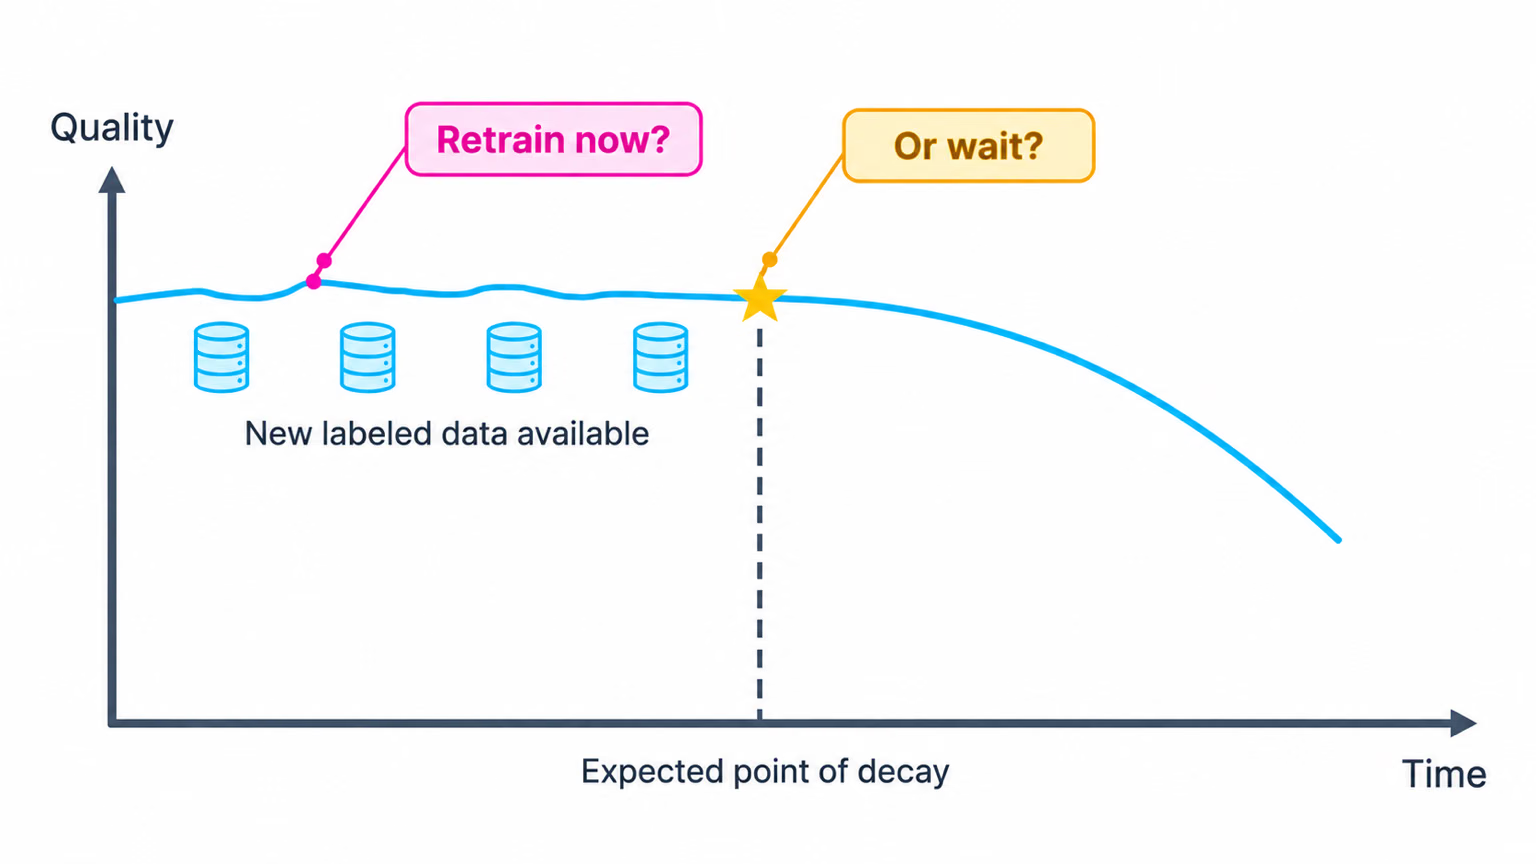
Датасет, готовый для v1, не обязательно будет готов для v3. Новые классы, источники и аннотаторы могут нарушить проверку, которая раньше проходила, а производственные данные дрейфуют, пока накапливаются новые метки. Перед каждым переобучением запускай readiness.py и заново оценивай результаты ручных проверок: это занимает минуты, а пропуск проверки может стоить недели обучения на испорченном датасете.
Показать решение
Оценённый контрольный список для учебного набора:
| # | Проверка | Оценка | Обоснование |
|---|---|---|---|
| 1 | Чёткая цель | да | objective.md и acceptance_test.py из урока 1 |
| 2 | Определены классы | нет | Для 80 классов COCO нет письменных определений или описания похожих объектов, которые нужно исключать |
| 3 | Репрезентативные изображения | нет | coverage.py: для cam2–cam4 не выполнена квота |
| 4 | Достаточный объём | нет | readiness.py: у самого слабого класса 1 изображение |
| 5 | Согласованность разметки | нет | Согласованность на калибровочном раунде — 47% |
| 6 | Контроль качества завершён | частично | Аудит проведён; подозрительные случаи в 000000000438.jpg ещё не разобраны |
| 7 | Корректные разбиения | нет | Общие группы отсутствуют, но в val нет 36 из 71 класса |
| 8 | Изображения без объектов | да | 1.6% |
Решение: сначала исправить. Приоритет по риску для приёмочного теста: (1) сократить список классов до нужных для цели — это сразу упростит проверки 2, 4 и 7; (2) собрать больше групп для этих классов; (3) завершить правило в руководстве для людей вдали и перемаркировать данные. Демонстрационный набор эту проверку не проходит — и так и должно быть.