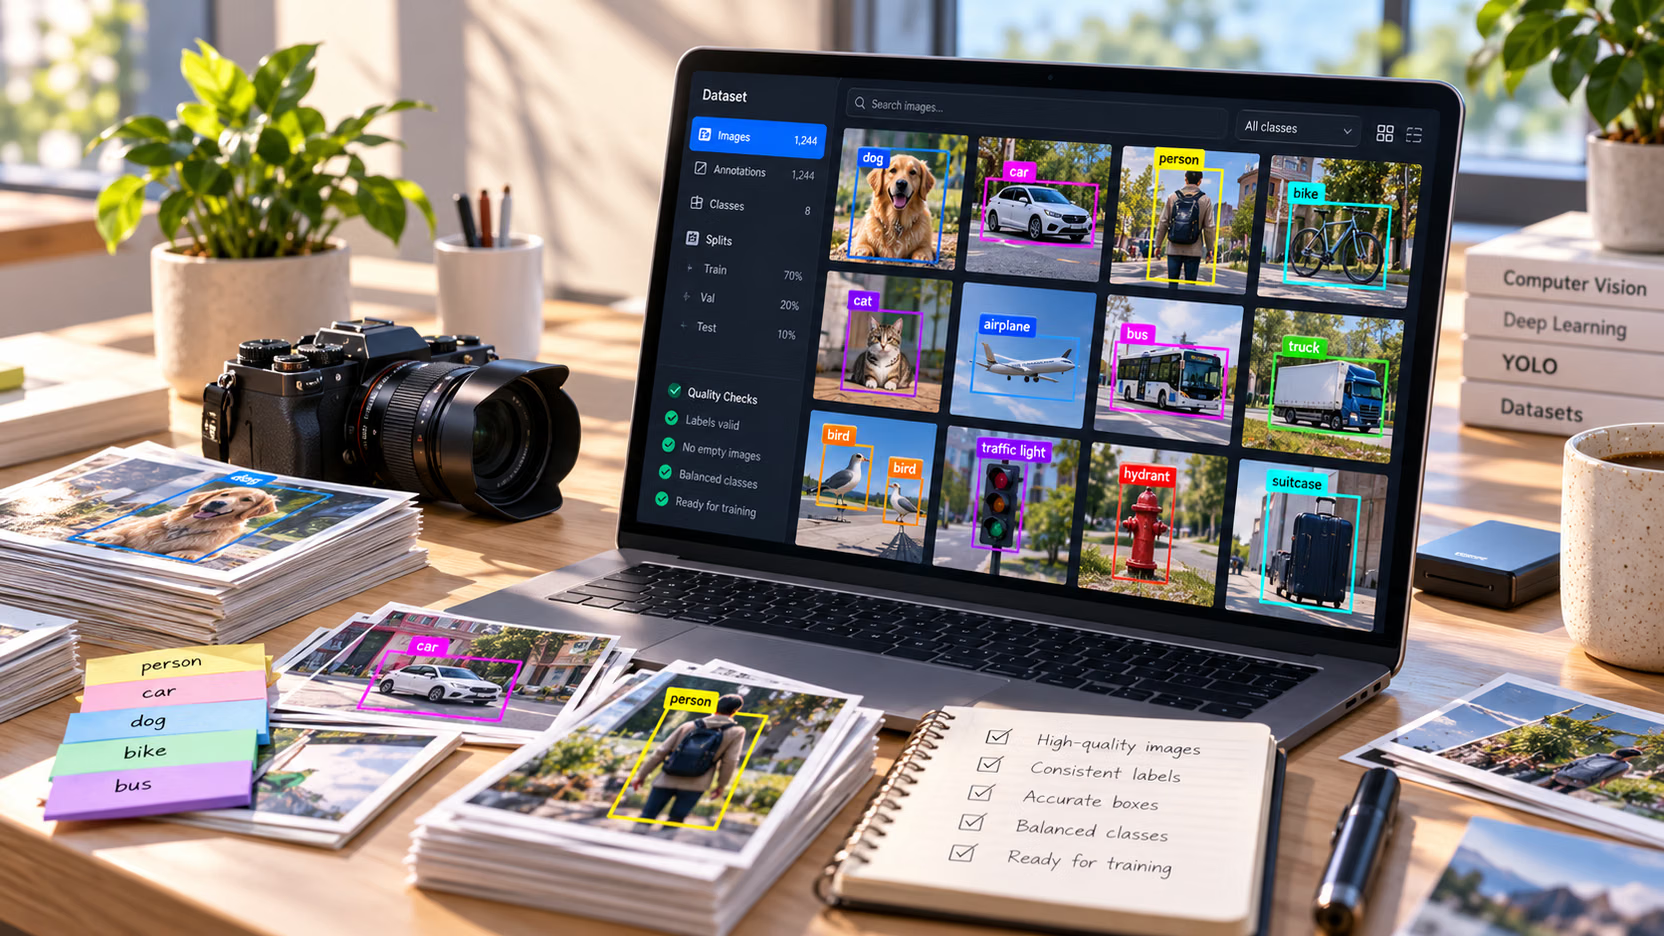
Создание высокопроизводительных наборов данных для YOLO
Практическое руководство по подготовке к обучению: преврати бизнес-цель в приемочный тест, определи требования к репрезентативным данным и собери их, обеспечь согласованность разметки, проверь качество с помощью скриптов, раздели данные без утечек, настрой аугментацию и допускай первую донастройку Ultralytics YOLO26 только после проверки готовности.
Автор Ultralytics Academy
Преобразуй бизнес-цель в документированный, сбалансированный набор данных без утечек, готовый для донастройки Ultralytics YOLO26, и точно знай, что исправить, если набор пока не готов.
Преобразуй бизнес-цель в задачу компьютерного зрения, определи классы и создай приемочный тест, который можно запустить как код.
Составь спецификацию набора данных с квотами для сценариев, соответствующую целевым показателям Ultralytics: ≥1,500 изображений и ≥10,000 размеченных экземпляров на класс, 0–10% фоновых изображений.
Собирай данные в реальных условиях развертывания, сохраняй метаданные съемки в именах файлов и выбирай кадры из видео так, чтобы не переполнять набор данных.
Обеспечь согласованность разметки с помощью письменного руководства и измеренного результата калибровочного этапа, учитывая десять самых распространенных ошибок аннотирования.
Проверяй разметку, баланс классов, дубликаты и вероятные пропущенные метки с помощью коротких скриптов на Python.
Разделяй данные по группам (видеофрагмент, камера, день, площадка), чтобы показатели на валидации отражали работу в production, и зафиксируй тестовый набор.
Выбирай настройки аугментации, соответствующие условиям развертывания, и проверяй их на пакетах данных при обучении.
Допускай обучение только после прохождения проверки готовности из восьми пунктов и используй результаты первой базовой донастройки, чтобы определить, что исправить в наборе данных дальше.
Одностраничный план и скрипт приемочного теста, который выводит PASS или FAIL.
Спецификация набора данных с квотами для сценариев, граничными случаями и долей фоновых изображений.
Практический набор данных с метаданными съемки в каждом имени файла и отчетом о покрытии квот.
Руководство по разметке, доработанное по итогам калибровочного этапа с измеренной оценкой согласованности.
Проверка качества и анализ подозрительных меток с краткими заметками по контролю качества.
Сгруппированные списки файлов для train / val / test без общих видеофрагментов, камер или дней между выборками.
Оцененная проверка готовности, первая донастройка с рейтингом по классам и многоразовый контрольный список для старта.
Знания в области машинного обучения не требуются: каждое понятие объясняется до того, как ты начнешь его применять.
Python 3.10+ и
pip install ultralyticsдля запуска скриптов; для всех примеров достаточно CPU.Рекомендуем: Основы компьютерного зрения — чтобы освоить ключевые понятия.
Содержание курса
5 модулей · 10 уроковМодуль 1
Начни с бизнес-цели
Преобразуй бизнес-цель в задачу компьютерного зрения, определи классы и создай приемочный тест, который можно запустить как код, прежде чем собирать хотя бы одно изображение.
Определи спецификацию набора данных
До начала сбора данных спланируй сценарии, квоты, вариативность, крайние случаи и изображения фона, а затем соотнеси план с целевыми объёмами Ultralytics.
Модуль 3
Рекомендации по разметке
Составь руководство по разметке, выбери инструмент, избегай десяти ошибок, незаметно снижающих точность, и измерь с помощью скрипта согласованность аннотаторов перед масштабированием процесса.
Контроль качества набора данных
Проверь скриптом разметку, баланс классов, дубликаты и охват разбиений, попроси модель указать на вероятные пропущенные метки и исправь найденное до начала обучения.
Модуль 4
Правильно раздели датасет
Оцени, насколько случайное разделение приводит к утечке данных, разделяй целые группы — например, клипы, камеры или дни — с помощью скрипта, проверяй наличие всех классов и зафиксируй тестовую выборку.
Используй аугментацию осознанно
Проверяй каждую аугментацию с учётом камеры в целевой среде, создай обоснованный профиль, обучи модель с ним и проверь результат на обучающих батчах.
Модуль 5
Как определить, что набор данных готов
Перед первым запуском обучения проверь восемь критериев «пройдено/не пройдено», автоматизируй три проверки, которые может выполнить скрипт, и выясни, какое исправление требуется при каждом сбое.
Первое дообучение и цикл итераций
Дообучи предобученные веса YOLO26 с настройками по умолчанию, ранжируй классы по AP с подсчётом пропусков и путаницы, а затем преврати самый слабый класс в следующую задачу по исправлению датасета.
Чек-лист для корпоративных клиентов
Одностраничный чек-лист для стартовой встречи с заказчиком: зафиксируй все решения по датасету до сбора данных и установи контрольные условия для каждого переобучения.