Обучи свою первую модель
Дообучи YOLO26 на своём датасете одной командой, следи за журналом обучения в реальном времени построчно и найди best.pt и важные графики в папке запуска.
Обучение детектора с нуля занимает несколько дней и требует огромных датасетов. Дообучение предварительно обученной YOLO26 примерно на сотне изображений занимает около минуты на CPU ноутбука, поскольку перенос обучения позволяет использовать уже имеющиеся у модели знания о границах, формах и объектах.
В этом уроке ты будешь обучать модель на датасете таблеток, проследишь, как mAP50-95 вырастет с почти нулевого базового значения до 0.66 за десять эпох, и научишься по журналу заранее понимать, идёт ли обучение нормально или зря тратит твоё время.
Практические занятия
Пример: обучение детектора таблеток#
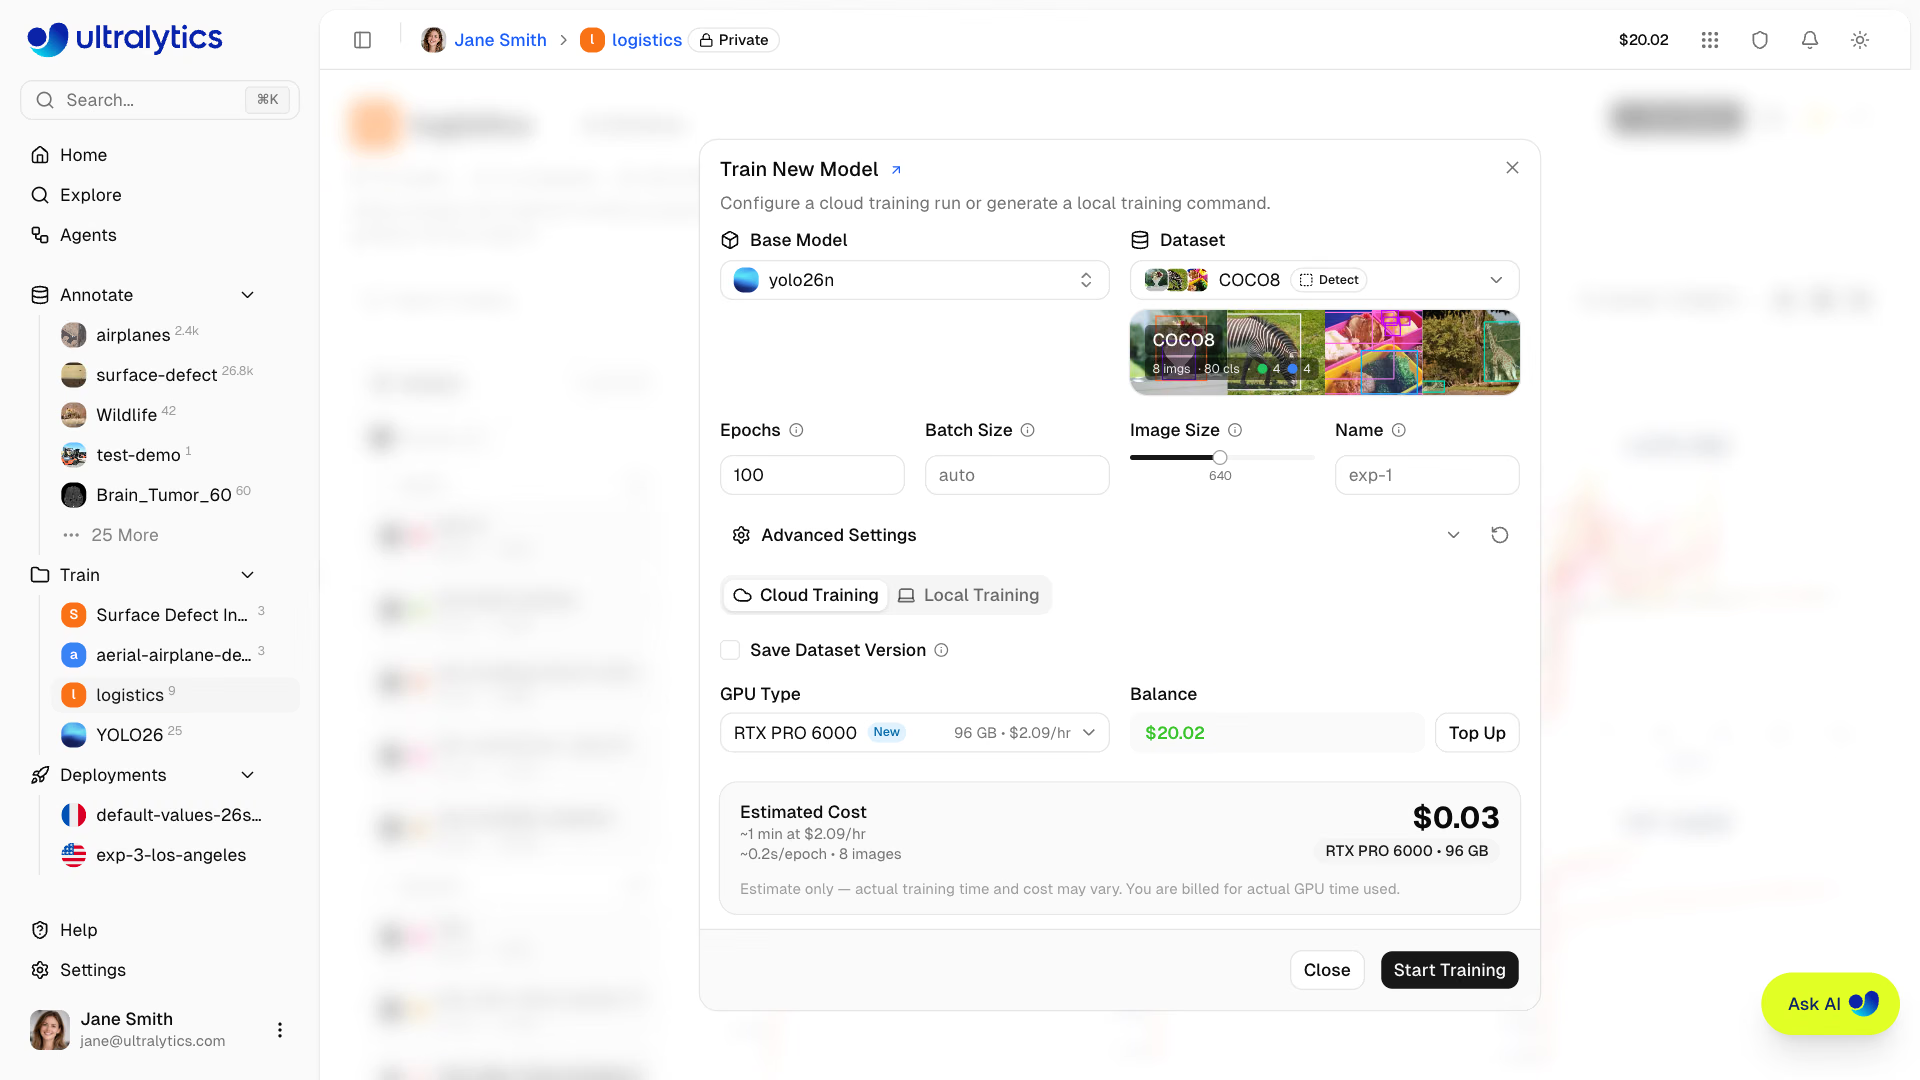
В диалоге Train New Model на Ultralytics Platform нужно выбрать те же параметры, что и в коде ниже: базовую модель, датасет, количество эпох и размер изображения. Обучение можно запустить на облачных GPU или получить соответствующую команду для локального запуска. С этими параметрами обучение на CPU ноутбука займёт около минуты:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # предобучена на COCO
results = model.train(data="my_dataset/data.yaml", epochs=10, imgsz=320, name="pills_v1")
print(results.save_dir)
CLI и Python дают одинаковый результат. epochs=10 и imgsz=320 сокращают время запуска на CPU; при наличии GPU убери оба параметра и используй значения по умолчанию (epochs=100, imgsz=640), поскольку большее число эпох и пикселей почти всегда помогает. Режим Train выполняет за тебя следующий цикл:
Разбери журнал построчно#
Реальный вывод, сокращённый до первых и последних двух эпох:
optimizer: AdamW(lr=0.002, momentum=0.9) with parameter groups ...
Using 92 train, 23 val images for fraction=1.0 at imgsz=320
      Epoch    GPU_mem   box_loss   cls_loss    l1_loss  Instances       Size
       1/10         0G      1.818      3.899   0.008805        206        320: 100% 6/6 3.3s
                   all         23        399      0.957      0.805      0.927      0.548
       2/10         0G      1.434      3.291   0.006285        208        320: 100% 6/6 4.4s
                   all         23        399      0.953      0.911      0.964      0.592
       ...
       9/10         0G      1.121      1.103   0.005143        194        320: 100% 6/6 5.0s
                   all         23        399      0.949      0.957      0.975      0.656
      10/10         0G      1.174      1.125   0.005068        212        320: 100% 6/6 5.1s
                   all         23        399       0.97      0.957      0.977      0.659
10 epochs completed in 0.015 hours.
optimizer: AdamW(lr=0.002 ...): оптимизатор и скорость обучения за тебя выбрал параметрoptimizer=auto, установленный по умолчанию.Using 92 train, 23 val images: проверь, что эти значения соответствуют твоему датасету. Меньшее число означает, что часть изображений пропущена.GPU_mem 0G: обучение идёт на CPU. На GPU здесь отображалась бы используемая память;0Gна компьютере с GPU означает, что GPU не используется.- Первая строка каждой эпохи: три значения потерь на обучающей выборке, количество размеченных объектов в последнем батче (
Instances) и размер изображения. - Строка
allкаждой эпохи: точность, полнота, mAP50 и mAP50-95 на валидационной выборке. Именно на неё нужно смотреть.
| Столбец | Значение | Нормальная динамика |
|---|---|---|
box_loss | Насколько предсказанные рамки отличаются от размеченных | Снижается, затем выходит на плато |
cls_loss | Насколько ошибочны оценки классов | Снижается, затем выходит на плато |
l1_loss | Непосредственная ошибка координат рамок YOLO26 | Снижается |
P, R | Точность и полнота на валидационной выборке | Растут и остаются сбалансированными |
mAP50, mAP50-95 | Качество детекции; mAP50-95 также учитывает точность рамок | Растёт, затем выходит на плато |
Здесь mAP50-95 вырос с базового значения 0.0002 до 0.548 после одной эпохи и 0.659 после десяти. На четвёртой эпохе точность снизилась до 0.80, а затем восстановилась: результаты отдельных эпох на 23 валидационных изображениях нестабильны, поэтому оценивай общую динамику, а не одну строку. Как принимать решения во время обучения:
- Потери снижаются, mAP растёт: дай обучению продолжиться.
- Потери не меняются с первой эпохи: останови обучение сочетанием Ctrl+C и проверь разметку и YAML.
- Точность намного выше полноты: модель слишком осторожна и пропускает объекты. Полнота намного выше точности: модель обнаруживает объекты там, где их нет.
- mAP долго не меняется: дополнительные эпохи не помогут; измени данные или
imgsz.
Три значения потерь — компоненты функции потерь YOLO26; в руководстве по метрикам производительности подробно объясняется каждая метрика.
Посмотри, что сохранил запуск#
Все файлы сохраняются в runs/detect/pills_v1/:
| Файл | Назначение |
|---|---|
weights/best.pt | Чекпойнт с наилучшей валидационной оценкой за все эпохи; используй его для инференса и экспорта |
weights/last.pt | Последний чекпойнт; используется для возобновления прерванного запуска |
args.yaml | Все аргументы, использованные при запуске, — для его воспроизведения |
results.csv, results.png | Потери и метрики по эпохам в виде данных и графиков |
labels.jpg | Распределение классов и гистограммы размеров и положений рамок |
train_batch*.jpg | Аугментированные батчи обучения с отрисованными метками |
val_batch*_labels.jpg, val_batch*_pred.jpg | Эталонные разметки и предсказания на валидационных изображениях |
confusion_matrix*.png, Box*_curve.png | Матрица ошибок, а также кривые точности, полноты, F1 и PR |
Прежде всего открой train_batch0.jpg. Если рамки не совпадают с объектами, значит, разметка неверна, и никакое количество эпох это не исправит.
Сначала измени эти аргументы#
| Аргумент | По умолчанию | Когда менять |
|---|---|---|
epochs | 100 | Короткие эксперименты на CPU или небольшие датасеты, на которых начинается переобучение (уменьши значение); большие датасеты, на которых качество продолжает улучшаться (увеличь, до 200–300) |
imgsz | 640 | Небольшие объекты (увеличь до 1024 или 1280) или эксперименты на CPU (уменьши) |
batch | 16 | Размер батча: уменьши при нехватке памяти или используй -1, чтобы автоматически подобрать размер примерно под 60% памяти GPU |
patience | 100 | Досрочно останови обучение, если валидационная оценка не улучшалась N эпох, например patience=20 |
device | автоматически | Принудительно выбери cpu, mps, индекс GPU, например 0, или несколько GPU, например [0, 1] |
name | train | Всегда давай запускам имена, отражающие внесённые изменения |
model.train(data="my_dataset/data.yaml", epochs=200, imgsz=1024, batch=-1, patience=20, name="pills_v1_1024")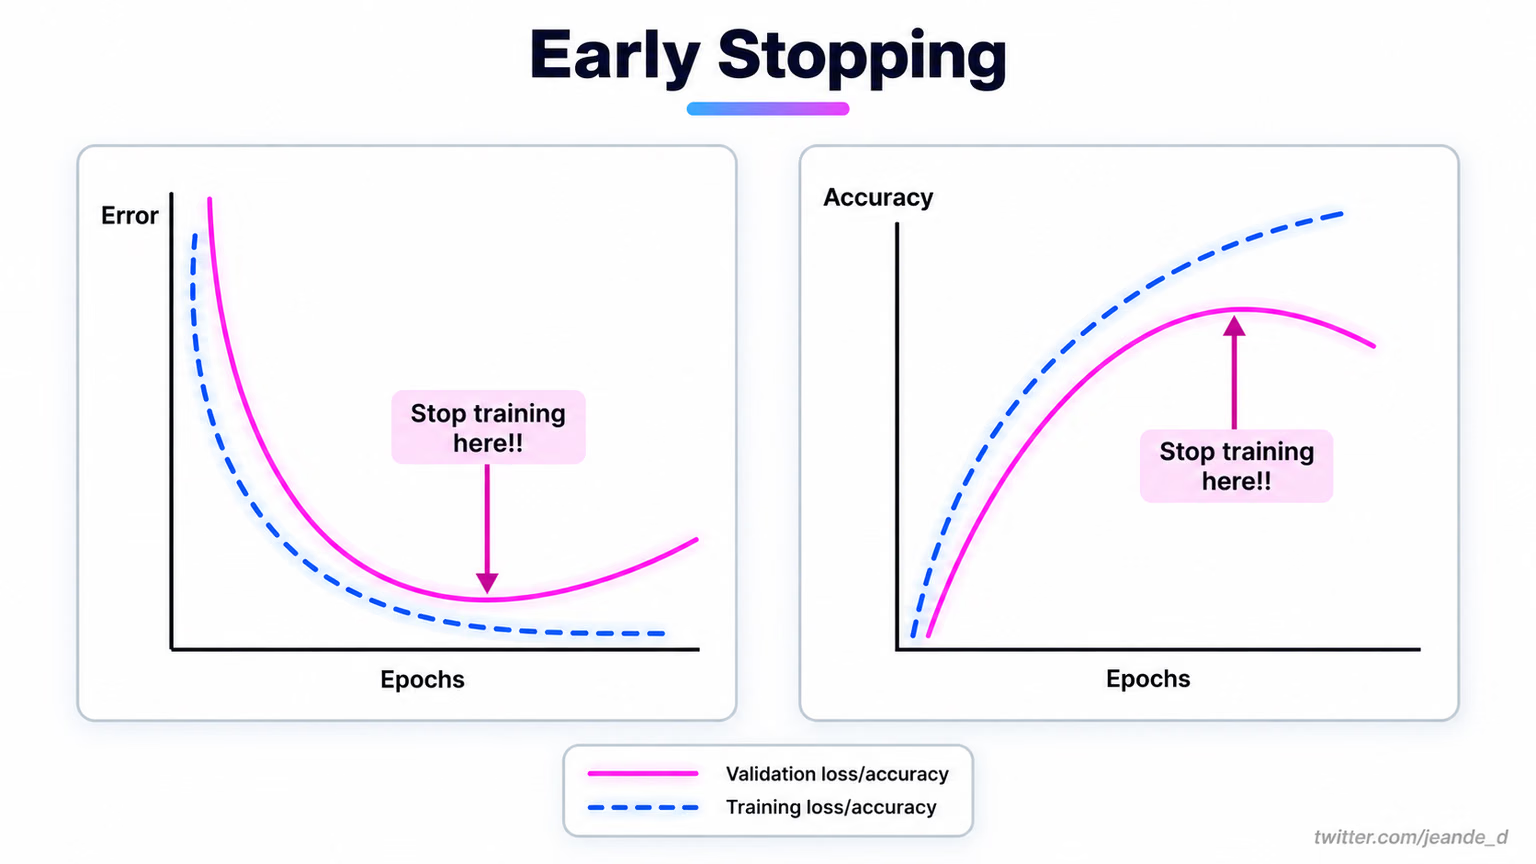
Значение patience по умолчанию — 100, поэтому запуск на 100 эпох никогда не остановится досрочно. Меньшее значение остановит застопорившийся запуск в момент, указанный кривыми выше; в любом случае сохраняется best.pt.
При использовании нескольких GPU передай список, например device=[0, 1, 2, 3]: Ultralytics сама запускает распределённое обучение с параллельной обработкой данных (DDP), batch задаёт общее число эпох для всех GPU, а при обучении по умолчанию используется смешанная точность (amp=True). Когда возможностей ноутбука станет недостаточно, тот же датасет и те же аргументы можно использовать для обучения на облачных GPU через Ultralytics Platform; подробнее об этом рассказывается в разделе «Обучение, просмотр и дообучение запусков».
Избегай этих ошибок#
Симптом: mAP близка к нулю после многих эпох на небольшом датасете. Причина: модель была загружена из yolo26n.yaml (случайные веса), а не из yolo26n.pt. Решение: всегда начинай с предобученной модели .pt. Обучение с нуля оправдано только для исследований бэкбона или очень больших датасетов.
Симптом: CUDA out of memory в первой эпохе. Решение: уменьши batch вдвое или задай batch=-1, чтобы AutoBatch выбрал подходящий размер. Уменьшение imgsz тоже помогает, но меняет то, что может увидеть модель.
last.pt — это последняя эпоха, результат которой может быть хуже, чем у более ранней. best.pt — эпоха с лучшим показателем качества на валидации; именно её результат нужно проверять, экспортировать и использовать.
В руководстве по советам для обучения модели описаны остальные аргументы, а в руководстве по настройке гиперпараметров — подбор скорости обучения и генетический оптимизатор. В руководстве по дообучению описана заморозка слоёв.
Показать решение
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
results = model.train(data="my_dataset/data.yaml", epochs=10, imgsz=320, name="pills_v1")
print(results.save_dir)  # runs/detect/pills_v1
Baseline (yolo26n.pt, no pill class): mAP50 0.001, mAP50-95 0.0002
pills_v1 (10 epochs, imgsz 320, CPU, ~1 min): mAP50 0.977, mAP50-95 0.659
Plateau: mAP50-95 gains shrink after epoch 8 (0.649 -> 0.656 -> 0.659)
train_batch0.jpg: yes, boxes sit on the pillsТочные значения немного отличаются в зависимости от оборудования и версии пакета.