Maliyet ve Gecikme Ayarı
İşlem hattının tamamını profille, gecikme ve maliyet üzerinde gerçekten etkisi olan ayarları sırasıyla değiştir ve belirlediğin bütçeye ulaştığında dur.
Ekipler, bir veritabanı yazma işlemi veya RTSP kod çözücü asıl darboğazken modelden milisaniyeler kırpmak için haftalar harcıyor. Etkisi büyük olan ayarlar az sayıdadır ve etkileri iyi ölçülmüştür: YOLO26s, CPU'da YOLO26n'den 2.2 kat daha uzun sürer ve karşılığında 7.7 daha fazla mAP puanı sağlar; algılamayı iki karede bir çalıştırmak ise iş yükünü yarıya indirir. Bu derste önce profil çıkarmayı, uygun olan en etkili ayarı değiştirmeyi ve önceden belirlediğin bütçeye ulaştığında durmayı öğreneceksin.
Uygulamalı
Önce İşlem Hattının Tamamını Ölç#
Her Results nesnesi kendi süresini aşamalara böler:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
totals = {"preprocess": 0.0, "inference": 0.0, "postprocess": 0.0}
for n, r in enumerate(model.predict(video, stream=True, verbose=False), 1):
    for stage in totals:
        totals[stage] += r.speed[stage]
print({stage: round(ms / n, 1) for stage, ms in totals.items()}, "ms per frame")
{'preprocess': 0.7, 'inference': 36.1, 'postprocess': 0.7} ms per frameBurada çıkarım, modelin süresinin %95'ini oluşturuyor; dolayısıyla model ayarları işe yarayacaktır. Kod çözme ve kendi çıktı işlemlerinin sürelerini de aynı şekilde ölç (time.perf_counter() kodunu her birinin çevresine ekle), ardından bulduğun sonuca göre şu kuralı uygula:
| Ölçümün | Önce çöz |
|---|---|
| RTSP kod çözme 60 ms, çıkarım 5 ms | Donanım kod çözme, akış çözünürlüğünü düşürme veya kod çözücü iş parçacıklarını artırma |
| Çıkarım 30 ms, Python son işlem 100 ms | NumPy ile vektörleştir veya ayrı bir çalışan sürecine taşı |
| Çıkarım 5 ms, veritabanı yazma işlemleri 200 ms | Yazma işlemlerini toplu hâle getir veya eşzamansız yap |
| Çıkarım baskın | Aşağıdaki ayar sıralaması |
Ayarların Etki Sıralaması#
En üsttekinden başla ve bütçene ulaştığında dur:
| İyileştirme | Tipik hızlanma | Tipik doğruluk maliyeti |
|---|---|---|
| Daha küçük model (m → s, s → n) | 1.5–2.5× | COCO'da 4.5–7.7 mAP puanı; dar kapsamlı görevlerde daha az |
Daha küçük imgsz (640 → 480) | yaklaşık 1.8× | Öncelikle küçük ve uzaktaki nesneler etkilenir |
| Daha hızlı çalışma zamanı, FP16 | GPU'da yaklaşık 1.5× | Genellikle yok; eşdeğerliği doğrula |
| Kalibrasyonlu INT8 | GPU'da ek olarak 1.2×; CPU'da 2.9×'e kadar | 1 puan (YOLO26n) ile 4–6 puan (daha büyük modeller) arası; QAT kaybın çoğunu telafi eder |
Daha az kare (vid_stride=N) | N×'e kadar | Hızlı hareket eden nesneler ve kısa olaylar gözden kaçabilir |
| Daha büyük toplu iş boyutu (sunucular) | Daha yüksek aktarım hızı, daha düşük gecikme değil | Yok |
Sayılar YOLO26, TensorRT ve OpenVINO kıyaslama tablolarından ve aşağıdaki ölçümlerden alınmıştır; senin sonuçların farklı olacaktır, bu yüzden ölçüm yap.
Daha Küçük Model#
COCO'daki YOLO26 kıyaslama tablosu:
| Model | mAP50-95 | CPU ONNX (ms) | T4 TensorRT10 (ms) |
|---|---|---|---|
| YOLO26n | 40.9 | 38.9 | 1.7 |
| YOLO26s | 48.6 | 87.2 | 2.5 |
| YOLO26m | 53.1 | 220.0 | 4.7 |
CPU'da model boyutunu her adım küçültmek 2.2–2.5× daha hızlı sonuç verir. COCO'daki doğruluk farkı en kötü senaryodur: büyük nesneler içeren ve 3 sınıfa odaklanan bir depo algılayıcısında m → n geçişi, 80 sınıflı genel amaçlı bir algılayıcıya kıyasla genellikle çok daha az kayba yol açar; bu yüzden daha küçük modeli her zaman kendi doğrulama kümenizde denemeye değer.
Daha Küçük Girdi#
Hesaplama yükü piksel sayısıyla yaklaşık orantılıdır; bu nedenle imgsz=480, 640 boyutundaki girdinin iş yükünün yaklaşık %56'sını gerektirir. Test dizüstü bilgisayarının CPU'sunda, ONNX Runtime ile toplu iş boyutu 1'de ölçülmüştür (bus.jpg üzerinde 25 çalıştırmanın ortanca değeri):
| Model | 640 | 480 | 320 |
|---|---|---|---|
| YOLO26n | 21.3 ms | 12.1 ms | 7.1 ms |
| YOLO26s | 55.0 ms | 24.2 ms | 12.9 ms |
Karar kuralı: yeni boyutta en küçük önemli nesnen hâlâ yaklaşık 10 piksel veya daha büyükse dene; nesneler küçük veya uzaktaysa (dronlar, kameradan uzaktaki raflar) çözünürlüğü koru ve bunun yerine modeli küçült.
Daha Az Kare#
Çıkarım kare hızını sınırlıyorsa ve sahne yavaş hareket ediyorsa, vid_stride=N ile her N'inci karede algılama çalıştır ve aradaki boşlukları izleyicinin kapatmasını sağla:
import time

from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
model.predict(video, vid_stride=30, verbose=False)  # warm up so the first timing is fair

for stride in (1, 2, 3):
    start, ids, frames = time.perf_counter(), set(), 0
    for r in model.track(video, stream=True, vid_stride=stride, tracker="bytetrack.yaml", classes=[0], verbose=False):
        frames += 1
        if r.boxes.is_track:
            ids.update(r.boxes.id.int().tolist())
    print(f"vid_stride={stride}: {frames} frames in {time.perf_counter() - start:.2f} s, {len(ids)} person IDs")
vid_stride=1: 62 frames in 2.66 s, 32 person IDs
vid_stride=2: 31 frames in 1.19 s, 30 person IDs
vid_stride=3: 20 frames in 0.95 s, 28 person IDsKarelerin yarısını işlemek yaklaşık yarı süre alır ve izleyici 32 kimliğin 30'unu korudu. vid_stride=3 değerinde 4 kimliği kaybetti; yürüme hızındaki bu sahnede durman gerektiğini gösteren işaret budur.
Bulut Maliyetini Düşür#
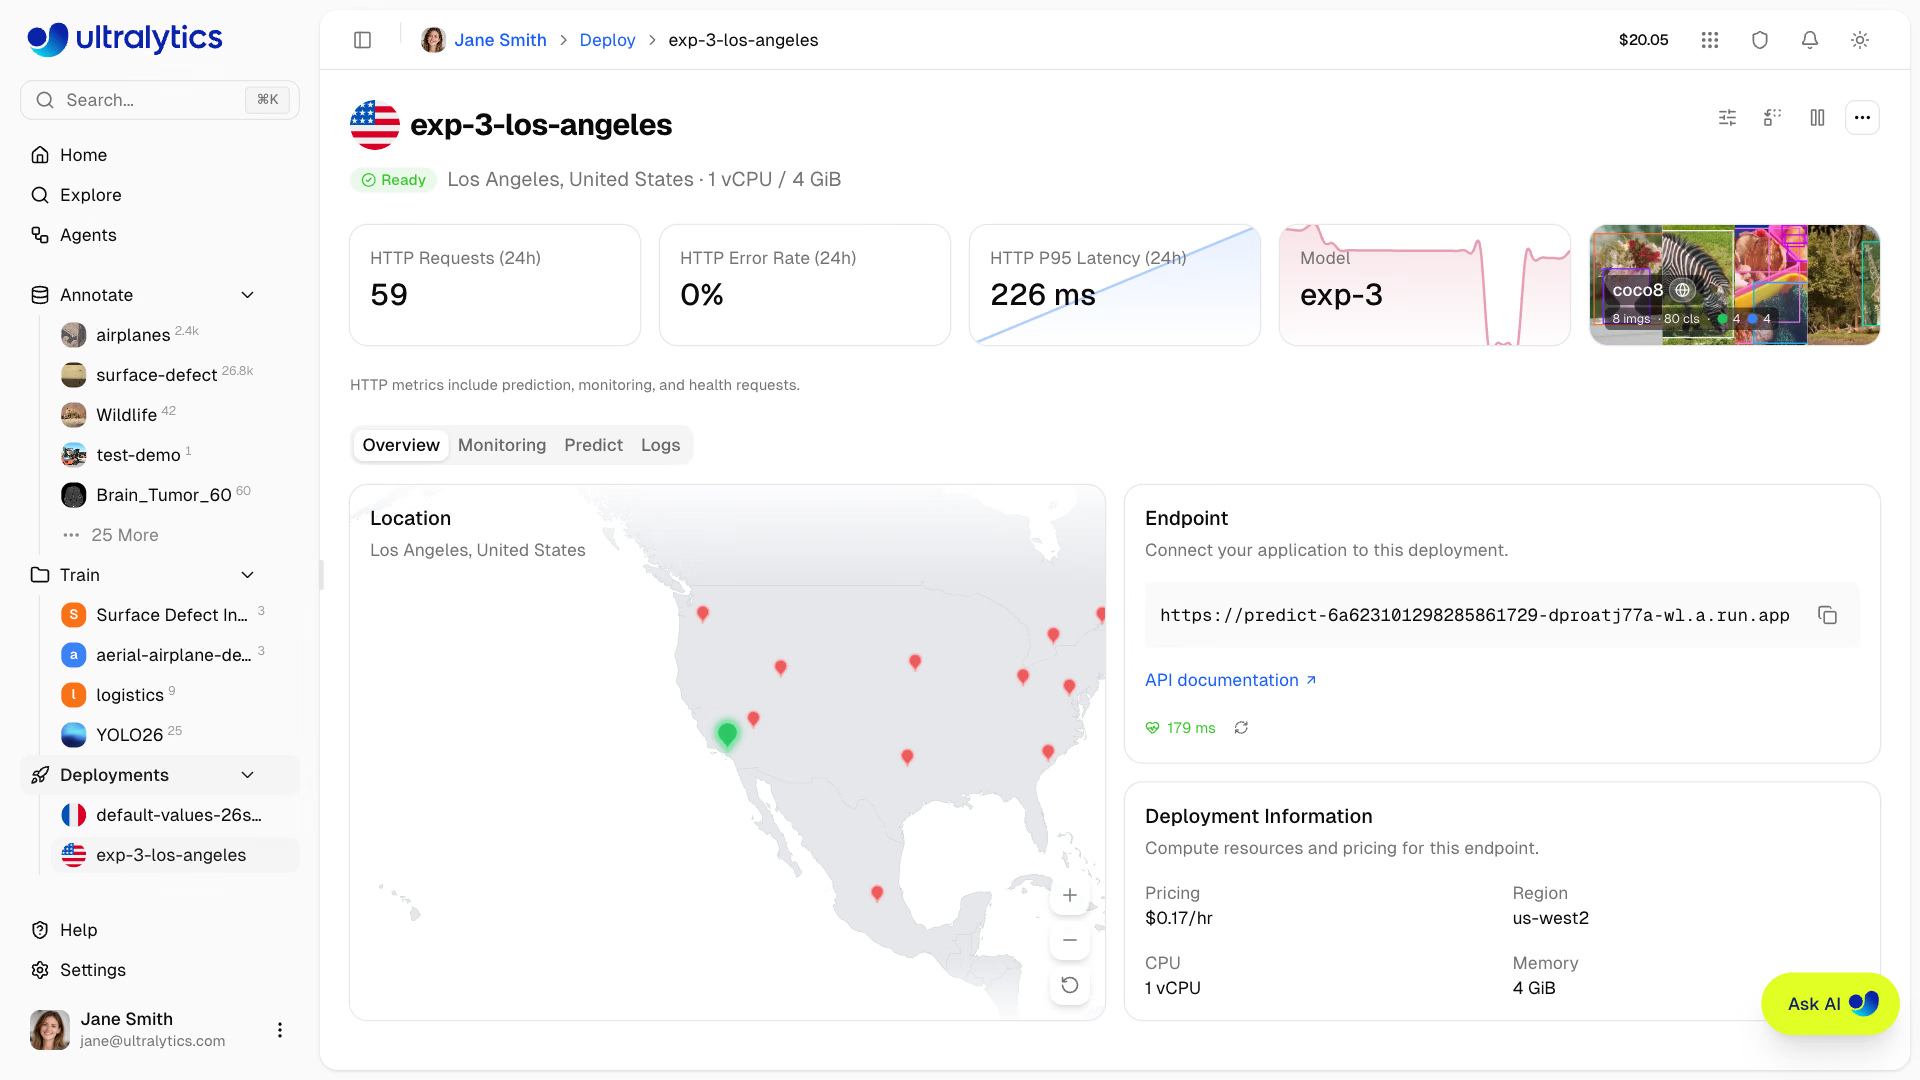
Maliyet, örnek saatlerinin yararlı iş miktarına bölünmesiyle hesaplanır. Bunun gibi bir kart, ihtiyacın olan iki sayıyı gösterir: bir saatin maliyeti (burada 1 vCPU ve 4 GiB için 0,17 $) ve yaptığı iş miktarı (çoğunlukla boşta olan bir uç noktada 226 ms P95 ile 24 saatte 59 istek). Ardından:
- Kullanım oranını artır. %30 kullanım oranındaki bir GPU, faturasının %70'ini boşa harcar. Akışları toplu olarak işle (önceki dersler) veya Triton Inference Server üzerinden hizmet sun.
- Boyutu ihtiyaca göre ayarla. Büyük bir GPU'ya ihtiyacın olduğunu varsaymadan önce daha küçük bir GPU'da veya OpenVINO ile CPU'da kıyaslama yap.
- Toplu işler için spot veya kesintiye uğratılabilir kapasite kullan. Arşivlenmiş videoları yeniden işlerken kesintiler tolere edilebilir; canlı akışlarda edilemez.
Yaygın Hatalar#
Belirti: İki haftalık ayarlama 10 ms kazandırdı ama sistem hâlâ yavaş. Çözüm: Önce tüm işlem hattının profilini çıkar ve ne olursa olsun en uzun süren aşamayı düzelt.
Belirti: Sonuç döngüsündeki if i % 2: continue hiçbir şey kazandırmıyor. Çözüm: Model o karede zaten çalıştı; atlamayı vid_stride ile kaynakta yap.
Belirti: Verim arttı ama her kare artık daha geç geliyor. Çözüm: Daha büyük gruplar, kare başına gecikmeyi değil dolar başına verimi artırır; bunları tek bir gerçek zamanlı kamera yerine çok sayıda akış veya çevrim dışı işler için kullan.
Model ayarlama seçenekleri tükendiğinde sıradaki seçenek daha iyi verilerdir. Üretime uyan bir veri kümesi, daha küçük bir modelin daha büyük bir modelin gerektirdiği doğruluğa ulaşmasını sağlar: doğruluk kaybı olmadan maliyeti düşürür.
Çözümü göster
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on macOS and Windows
    data, img = "coco8.yaml", "https://ultralytics.com/images/bus.jpg"  # use your val YAML and a production frame
    for weights, imgsz in (("yolo26s.pt", 640), ("yolo26n.pt", 640), ("yolo26n.pt", 480)):
        model = YOLO(weights)
        runs = [model(img, imgsz=imgsz, verbose=False)[0].speed["inference"] for _ in range(20)][5:]
        m = model.val(data=data, imgsz=imgsz, batch=1, plots=False, verbose=False).box.map
        print(f"{weights} imgsz={imgsz}: {sorted(runs)[len(runs) // 2]:.1f} ms, mAP50-95 {m:.3f}")
Her satırda ısınma için ilk beş çalışma atılır ve geri kalanların medyanı raporlanır. Gecikme bütçesini karşılayan ve mAP kaybı bütçenin içinde kalan ilk satırı seç. Örnek bir bütçe: "iki gün, en fazla 1 mAP puanı, mağaza bilgisayarında 20 FPS." Doğrulama kümenizde 640 boyutunda yolo26s kare başına 50 ms hedefini karşılamıyor, ancak 640 boyutunda yolo26n 1 puanlık kayıp sınırında karşılıyorsa orada dur; ikinci günü 480 boyutunu denemeye harcama.