TensorRT ile optimize et
Bir FP16 TensorRT motoru oluştur, INT8'in doğruluk maliyetine değip değmeyeceğine karar ver ve motoru kullanıma almadan önce kabul koşullarını uygula.
NVIDIA GPU'da TensorRT FP16 motoru genellikle elde edebileceğin en düşük maliyetli hız artışıdır: Ultralytics A100 kıyaslamasında mAP değişmeden yaklaşık 1,5× daha hızlıdır. INT8 daha da hızlandırır, ancak eğitim sonrası INT8, COCO'da YOLO26s ile YOLO26m arasında 4 ila 6 mAP puanına mal oldu. Bu derste hangi adımı attığını bilmeyi ve kullanıcıların fark etmesinden önce ölçüm yapmayı öğreneceksin.
Uygulamalı
Bu dersteki kod, TensorRT yüklü bir NVIDIA GPU gerektirir. Gösterilen her bağımsız değişken, Dışa aktarma modu belgelerinde format=engine için listelenmiştir.
FP16 Güvenli İlk Adımdır#
Volta ve sonraki NVIDIA GPU'larda FP16 tensor çekirdekleri bulunur; algılama modellerinin çıkarım sırasında FP32'ye nadiren ihtiyacı olur. Buradan başla:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # veya runs/detect/pills_v1/weights/best.pt
model.export(format="engine", quantize=16, workspace=4) # FP16 motoru, en fazla 4 GiB derleyici çalışma alanıworkspace, oluşturma sırasında TensorRT'nin kullanabileceği GPU belleğini sınırlar; TensorRT'nin karar vermesini istiyorsan bu ayarı yapma. TensorRT entegrasyonu sayfasında şu A100 sonucu yayımlanmıştır (YOLOv8n, 640 piksel):
| Kesinlik | Tahmin, toplu iş boyutu 8 (ms) | COCO doğrulama mAP50-95 |
|---|---|---|
| FP32 | 0.52 | 0.37 |
| FP16 | 0.34 | 0.37 |
| INT8 | 0.28 | 0.33 |
Model YOLO26'dan daha eski, ancak ödünleşimin genel görünümü geçerli: FP16 hiçbir ek maliyet olmadan yaklaşık 1,5× hız kazandırdı; INT8 ise 1,2× daha hızlandırdı ve 4 puana mal oldu. FP16 bütçeni karşılıyorsa onu kullanıma al.
Yerel NVIDIA GPU'n yok mu? Ultralytics Platform'un Export sekmesi, seçeceğin bulut GPU'sunda aynı görüntü boyutu, hassasiyet, toplu iş, dinamik, NMS ve çalışma alanı seçenekleriyle motoru oluşturur:

Dağıtımda kullanacağın GPU ailesini seç: ekran görüntüsündeki motor RTX 5090'da oluşturulmuştur ve yalnızca bu ailede çalışır.
INT8 İçin Kalibrasyon Verisi Gerekir#
INT8 kuantizasyonu, her katmanın aktivasyonlarını 256 seviyeye eşler. Bu aralıkları belirlemek için dışa aktarıcı, kalibrasyon görüntülerini modelden geçirip gördüğü aktivasyonları kaydeder; bu yüzden görüntülerin üretim verilerine benzemesi gerekir:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(
    format="engine",
    quantize=8,
    data="coco128.yaml",  # # kalibrasyon görüntüleri bu veri kümesinin val bölümünden alınır; my_dataset/data.yaml kullan
    fraction=1.0,  # # kullanılacak bu görüntülerin oranı (veya sayısı)
    batch=8,  # # daha büyük kalibrasyon toplu iş boyutları daha kararlı aralıklar sağlar
    dynamic=True,  # # batch=8 ile motor 1 ila 8 arasındaki toplu iş boyutlarını kabul eder
    workspace=4,
)
INT8'in ne kadar doğruluk kaybettireceği modele bağlıdır. Dışa aktarma modu belgelerinde COCO doğrulama verisi üzerinde YOLO26 TensorRT motorları için ölçülen mAP50-95 değerleri şöyledir:
| Model | FP32 motoru | Kalibre edilmiş INT8 (PTQ) | Kuantizasyona duyarlı eğitim (QAT) sonrasında INT8 |
|---|---|---|---|
| YOLO26n | 0.4032 | 0.3934 | 0.3935 |
| YOLO26s | 0.4794 | 0.4412 | 0.4711 |
| YOLO26m | 0.5269 | 0.4696 | 0.5137 |
Yalnızca kalibrasyon YOLO26n'de 1 puana, daha büyük modellerde ise 4–6 puana mal olur. QAT, INT8'e dayanıklı ağırlıklar elde etmek için modeli train içinde quantize=8 ile ince ayardan geçirir; kontrol noktası kendi aralıklarını içerir, INT8 dışa aktarımı kalibrasyon verisi gerektirmez ve FP32'nin 1–2 puan yakınına ulaşır. Kararını şöyle ver:
Kullanıma Almadan Önce Motoru Kabul Koşullarına Göre Değerlendir#
Her motor, dağıtım GPU'sunda aynı kontrollerden geçmelidir:
| Kontrol | Kabul koşulu |
|---|---|
| Doğrulama kümenizde mAP50-95 | FP16 için FP32'den en fazla 0,5 puan düşük olmalı; INT8 için yazılı bütçeni karşılamalı |
| Sınıf başına AP | Hiçbir sınıfta yaklaşık 1 puandan fazla düşüş olmamalı (küçük sınıflarda değişim en fazladır) |
| p95 gecikmesi | Üretim toplu iş boyutunda bütçenin altında olmalı |
| Çalışma eşiği | Motorun kendi F1 eğrisinden yeniden seçilen conf |
| Deterministiklik | Aynı görüntü iki kez verildiğinde kutular tam olarak aynı olmalı |
yolo val model=yolo26n.engine data=coco8.yaml  # or my_dataset/data.yaml
yolo benchmark model=yolo26n.pt data=coco8.yaml imgsz=640 format=engine quantize=16
Hız Artışı Nereden Geliyor?#
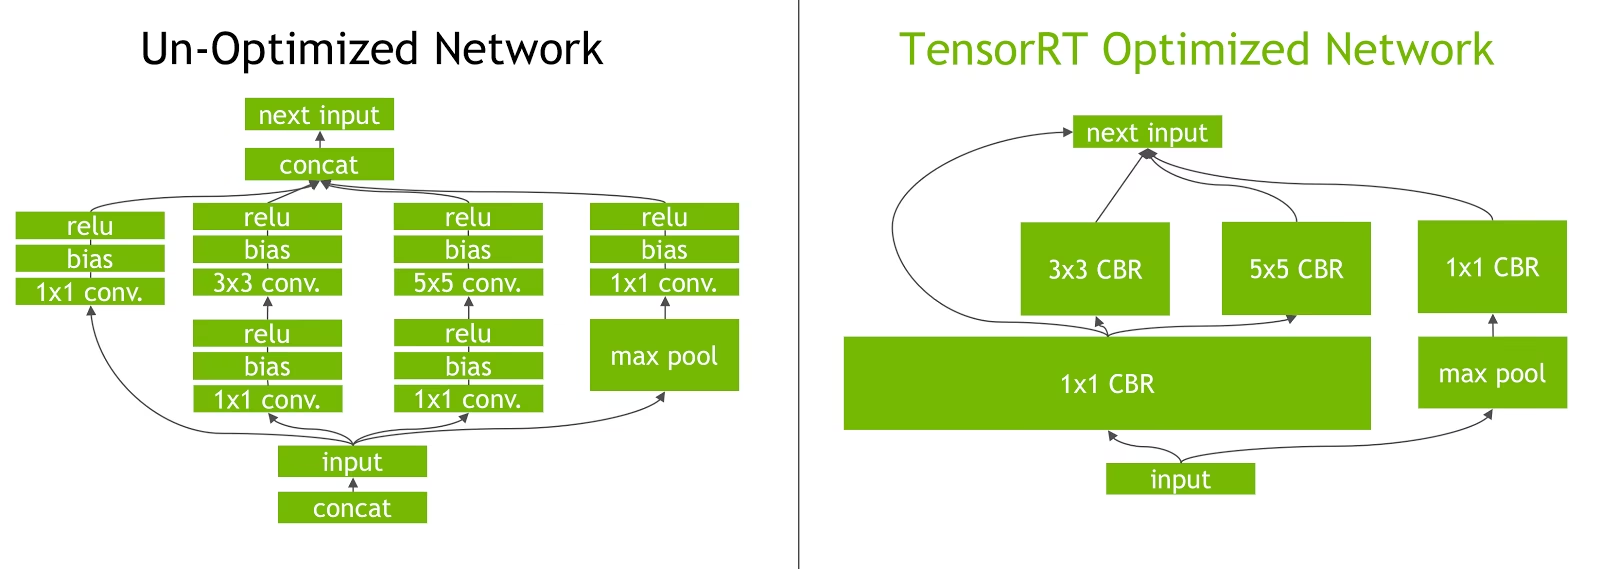
TensorRT, her evrişim, bias ve ReLU'yu tek bir çekirdekte birleştirir (sağdaki "CBR" blokları) ve concat adımlarını kaldırır; böylece GPU çok daha az çekirdek başlatır ve daha az veri taşır. YOLO26'da bu, ağın her yerindeki conv-BN-aktivasyon zincirlerinde, omurgadaki dikkat (PSA) bloğunda ve algılama başlığındaki çok sayıdaki küçük işlemde hız kazandırır. Motor hâlâ yavaşsa trtexec veya NVIDIA Nsight ile profilini çıkar: çoğu zaman tek bir katman toplam sürenin %30'unu ya da daha fazlasını alır.
Yaygın Hatalar#
Belirti: INT8, COCO'da 1 puan ve kameralarında 6 puan kaybediyor. Çözüm: Kendi doğrulama kümenin ayrılmış bir bölümünü kullanarak kalibrasyon yap; NVIDIA en az 500 temsili görüntü öneriyor. Kalibrasyon cihazlar arasında da farklılık gösterir, bu nedenle dağıtım yapacağın GPU'da kalibrasyon yap.
Belirti: Aynı conf değerinde INT8'e geçince duyarlılık düşüyor. Çözüm: INT8 güven değerlerini değiştirebilir; conf değerini INT8 motorunun kendi F1 eğrisinden yeniden seç.
Belirti: Motor, dağıtım cihazında serileştirmeden çözülemiyor veya beklenenden yavaş çalışıyor. Çözüm: Eşleşen TensorRT ve CUDA çalışma ortamıyla dağıtım GPU ailesinde oluştur ve cihazların yeniden derleyebilmesi için .onnx dosyasını gönder. Derleme sırasında kalibrasyon çökerse workspace değerini yükselt veya imgsz ya da batch değerini düşür.
Jetson'da DeepStream elde edilen motorları donanım hızlandırmalı bir video işlem hattında çalıştırır; veri merkezinde ise Triton Inference Server bu motorları sunar.
Çözümü göster
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on Windows
    data = "coco8.yaml"  # or my_dataset/data.yaml
    model = YOLO("yolo26n.pt")
    engine = model.export(format="engine", quantize=16, workspace=4)

    base = model.val(data=data, plots=False).box.map
    fp16 = YOLO(engine).val(data=data, plots=False).box.map
    print(f"PyTorch {base:.4f}  FP16 engine {fp16:.4f}  gap {abs(base - fp16) * 100:.2f} points")

    # Only if FP16 misses the latency budget:
    # model.export(format="engine", quantize=8, data=data, batch=8, dynamic=True, workspace=4)
Başarılı bir rapor şöyle görünür: fark 0,5 puanın altında, p95 bütçenin altında, karar FP16'yı kullanıma al. p95 hedefi karşılamazsa kendi kalibrasyon YAML dosyanla INT8'i dışa aktar, aynı iki satırı yeniden çalıştır ve INT8'i yalnızca farka, başlamadan önce belirlediğin bütçe içinde kalıyorsa kullanıma al; aksi hâlde QAT'yi veya daha küçük bir modeli dene.