Çoklu Akışta Çıkarım
Toplu çıkarım, sınırlı kuyruklar ve ölçülmüş kare düşüşleriyle birkaç kamerayı tek bir model üzerinden çalıştır.
Tek kamerayla başa çıkabilen bir sistem, dört kamerayla dakikalarca geride kalabilir ve hiçbir şey çökmez: bellek tükenene kadar sonuçlar giderek daha geç gelir. Burada kullanılan dizüstü bilgisayarın CPU'su tek bir 30 FPS akışı işleyebildi; dört akışta karelerin yarısı, sekiz akışta ise üçte ikisinden fazlası düştü. Bu ders, donanım kapasitesini belirlemenin yolu olduğu için bu sayıyı ölçen işlem hattını oluşturuyor.
Uygulamalı
Zaman Nerede Harcanıyor#
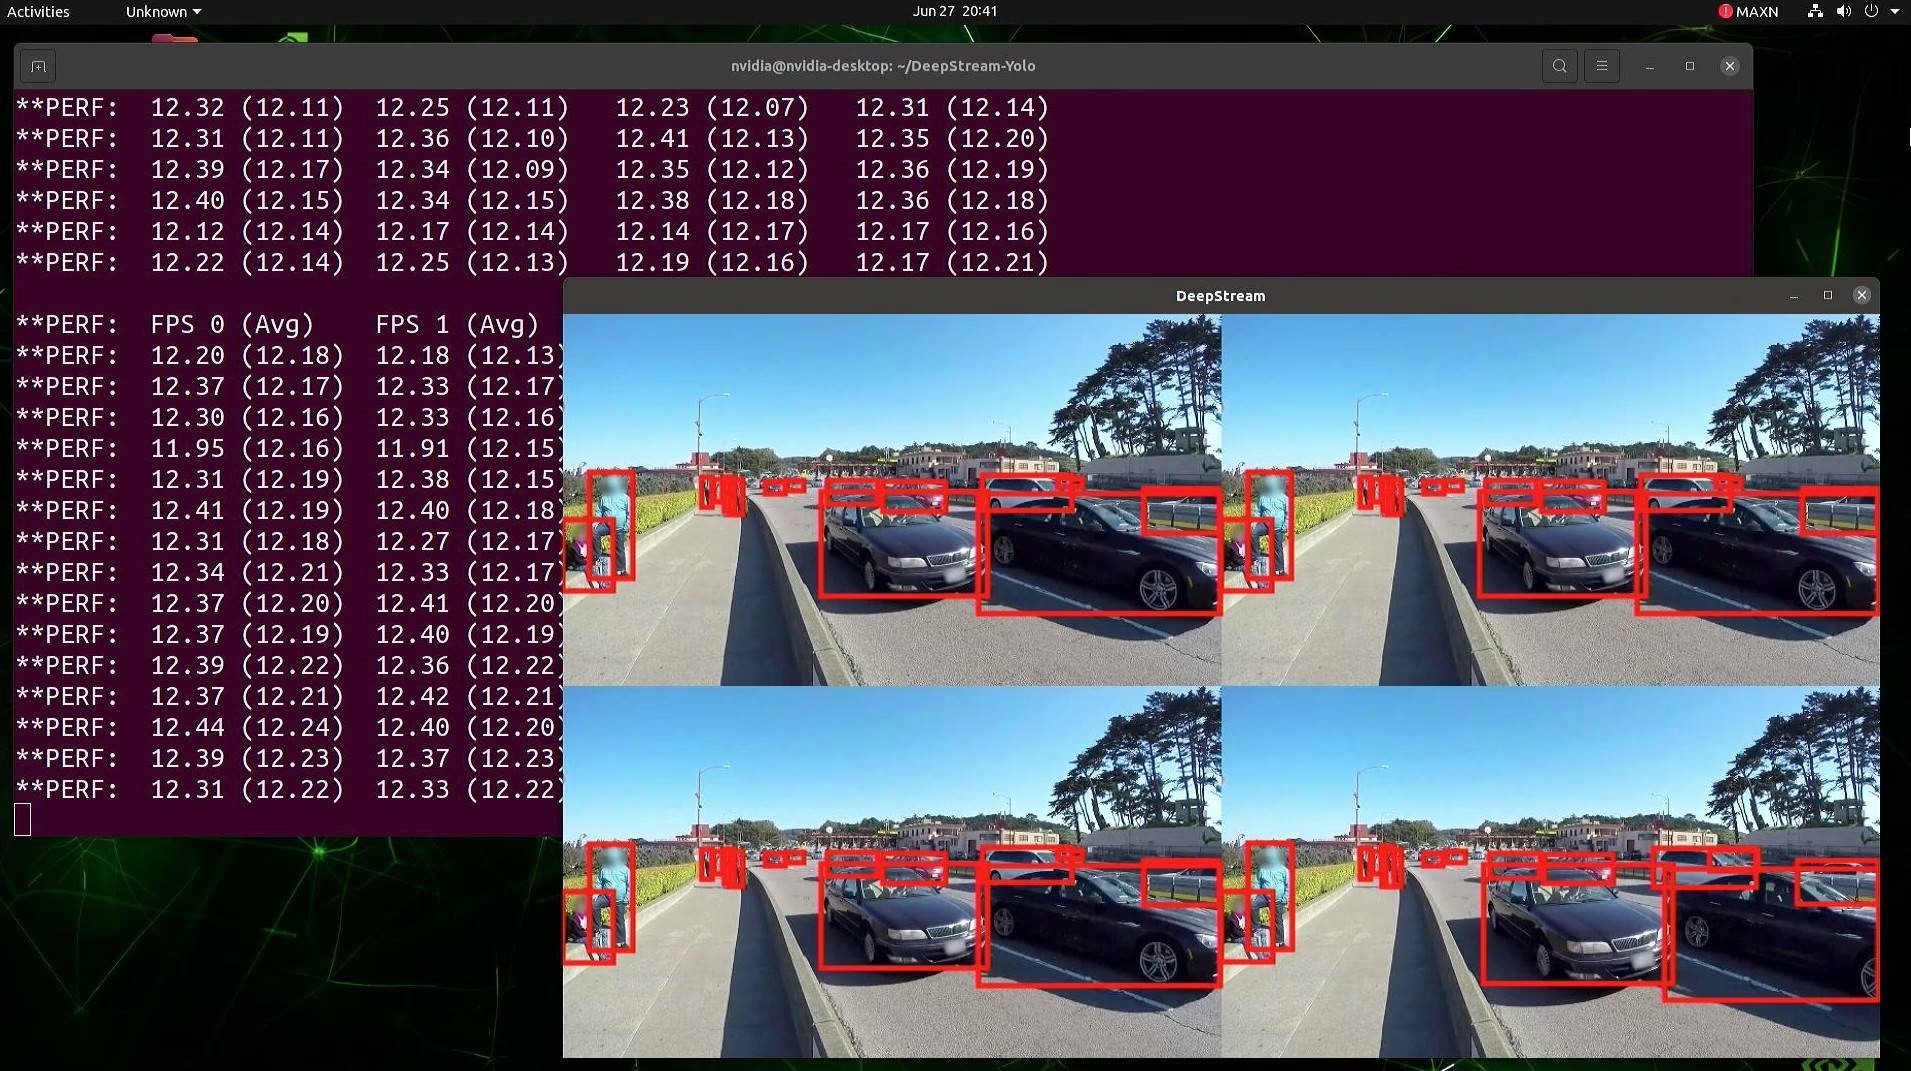
Her kare dört aşamadan geçer:
| Aşama | Tipik maliyet | Çalıştığı birim |
|---|---|---|
| Kod çözme (RTSP veya dosya → dizi) | 1080p kare başına 5–20 ms | CPU |
| Ön işleme (letterbox, normalleştirme) | yaklaşık 1 ms | CPU |
| Çıkarım | birkaç ms (GPU) ile onlarca ms (CPU) arası | Hızlandırıcı |
| Son işleme, takip, çıktı hedefleri | birkaç ms; yavaş veritabanlarında daha uzun | CPU |
Bunları tek bir iş parçacığında, kamera kamera art arda çalıştırırsan kareler çözümlenirken hızlandırıcı boşta kalır. Çözüm, yukarıdaki DeepStream işlem hattının yaptığı gibi aşamaları birbirinden ayırmaktır: dört akış tek bir aygıtı paylaşır ve her biri kendi FPS değerini (burada yaklaşık 12) raporlar. Python'da aynı yapı şöyle kurulur:
Yerleşik Yöntem: .streams Dosyası#
Ultralytics birden fazla kaynağı senin için toplu işler. Her satıra bir kaynak gelecek şekilde bir .streams dosyası oluştur ve dosyayı Predict veya Track moduna ilet. Her akış kendine ait bir okuyucu iş parçacığı ve izleyici alır; her yinelemede tüm akışlar için tek bir toplu ileri geçiş çalıştırılır:
from collections import Counter
from pathlib import Path

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
clips = [safe_download(base + name) for name in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
Path("cams.streams").write_text("\n".join(str(c) for c in clips))  # production: her satırda bir rtsp:// URL'si

model = YOLO("yolo26n.pt")  # production ortamında optimize edilmiş dışa aktarımını kullan
frames = Counter()
for r in model.track("cams.streams", stream=True, stream_buffer=True, tracker="bytetrack.yaml", verbose=False):
    frames[Path(r.path).name] += 1  # r.path, bu sonucun hangi akıştan geldiğini gösterir
print(frames)
Counter({'solutions_ci_demo.mp4': 62, 'ground-vehicles-airport.mp4': 62})En kısa akış sona erdiğinde yineleme durduğu için her iki akış da 62 sonuç üretti (havaalanı klibinde 150 kare var). stream_buffer=True her kareyi işledi; bu, kaydedilmiş dosyalar için doğru seçimdir. Canlı kameralar için varsayılan False ayarını kullan; böylece yavaş bir model geride kalmak yerine eski kareleri atlar. Akış başına en yüksek verim için bunu bir TensorRT veya OpenVINO dışa aktarımıyla birlikte kullan.
Özel Yöntem: Düşen Kare Sayaçlarıyla Üretici-Tüketici#
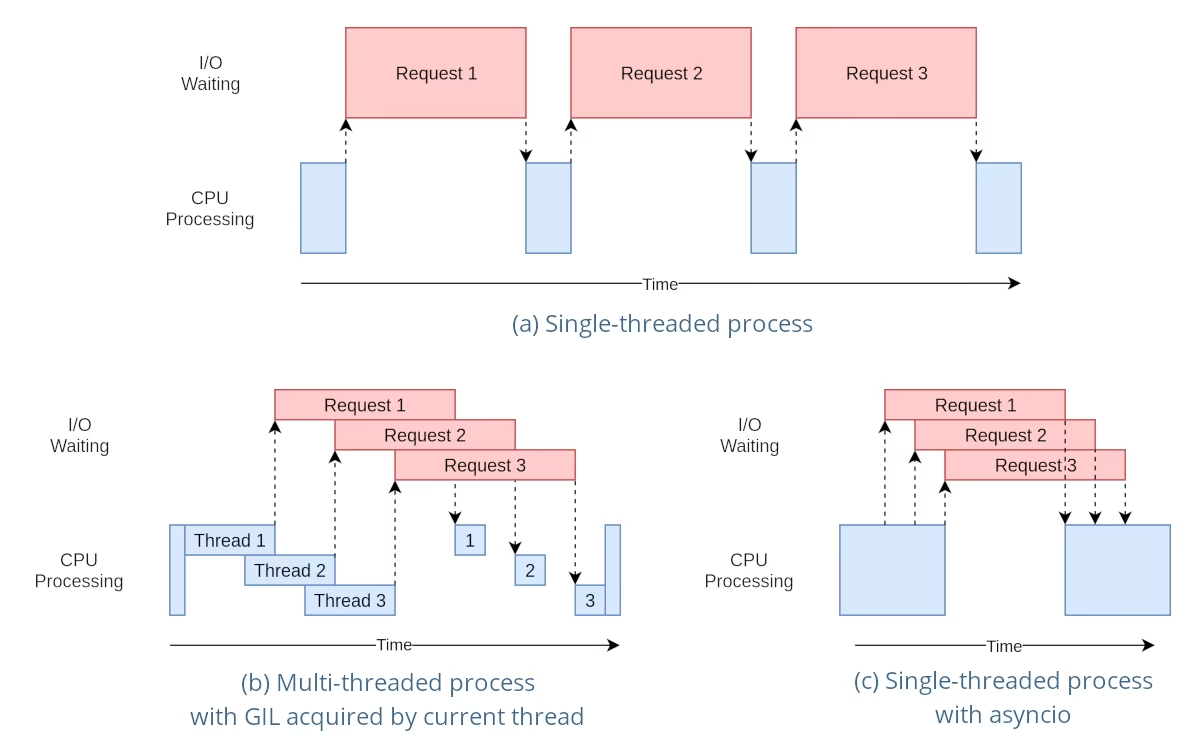
Diyagram, bu işlem hattında iş parçacıklarının neden işe yaradığını gösteriyor. Kod çözme çoğunlukla beklemeden ibarettir (pembe G/Ç çubukları); OpenCV ve PyTorch çalışırken Python GIL'ini serbest bıraktığı için kod çözücü iş parçacıkları iyi örtüşür (b paneli). Yoğun Python son işleme aşamaları örtüşmez; bunları ayrı süreçlere taşı.
Kendi çıktı hedeflerine, kamera başına özel mantığa veya açık düşen kare ölçümlerine ihtiyacın varsa işlem hattını kendin kur. Kod çözücü iş parçacıkları modele hiçbir zaman dokunmaz; modelin sahibi tek bir tüketici döngüsüdür. Bu, iş parçacığı güvenli çıkarım kurallarına uymanı da sağlar:
import queue
import threading
import time

import cv2

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
SOURCES = [str(safe_download(base + n)) for n in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
frames = queue.Queue(maxsize=16)  # bounded: memory and latency stay flat under overload
dropped = [0] * len(SOURCES)

def decode(stream_id, source):
    """Producer: read frames at the camera's pace and never block on a full queue."""
    cap = cv2.VideoCapture(source)
    interval = 1 / (cap.get(cv2.CAP_PROP_FPS) or 30)
    while True:
        ok, frame = cap.read()
        if not ok:
            break
        try:
            frames.put_nowait((stream_id, frame))
        except queue.Full:
            dropped[stream_id] += 1  # consumer is behind: drop rather than serve stale frames
        time.sleep(interval)  # pace files like a live camera; remove for RTSP sources
    cap.release()

model = YOLO("yolo26n.pt")  # one model, used only by the consumer loop below
model.predict("https://ultralytics.com/images/bus.jpg", verbose=False)  # warm up before cameras start

decoders = [threading.Thread(target=decode, args=(i, s), daemon=True) for i, s in enumerate(SOURCES)]
for t in decoders:
    t.start()

processed = [0] * len(SOURCES)
while any(t.is_alive() for t in decoders) or not frames.empty():
    batch = []
    while len(batch) < 8:  # gather up to 8 frames from any camera
        try:
            batch.append(frames.get(timeout=0.05))
        except queue.Empty:
            break
    if not batch:
        continue
    results = model([frame for _, frame in batch], verbose=False)  # one batched forward pass
    for (stream_id, _), r in zip(batch, results):
        processed[stream_id] += 1  # per-stream postprocessing and sinks go here

print(f"processed={processed} dropped={dropped}")
processed=[56, 131] dropped=[6, 19]İki klipte 62 ve 150 kare var ve her kare ya işleniyor ya da düşüyor (56 + 6 = 62, 131 + 19 = 150); dolayısıyla sayaçlar her şeyi hesaba katıyor. 212 karenin 25'i düştü: bu dizüstü bilgisayarın CPU'su PyTorch'ta yolo26n modelini iki 30 FPS akışında çalıştıramıyor. Daha fazla kamerayı taklit etmek için klipleri tekrarlayarak tek seferde yaptığımız deneme:
| Akışlar (her biri 30 FPS) | Düşen kareler |
|---|---|
| 1 | 0% |
| 2 | 12% |
| 4 | 51% |
| 8 | 69% |
Ölçümlere Göre Kapasite Planla#
Aygıt başına akış sayısı ≈ sürdürülebilir verim (modelin, belirlediğin toplu iş boyutunda saniyede işlediği kare sayısı) ÷ akış başına gereken FPS. Gerçek donanımda önceki derslerde optimize edilmiş dışa aktarımı kullanarak verimi ölç, ani yükler için %20–30 kapasite payı bırak ve düşen kare sayısı sıfırın üzerine çıktığında uyarı ver. Daha yüksek çözünürlük, piksel sayısıyla kabaca orantılı maliyet getirir: 1280×1280, 640×640'ın yaklaşık 4 katı işlem gücü gerektirir. Büyük filolar için Triton Inference Server ve Jetson'da DeepStream, doğal üretim ortamı seçenekleridir.
Yaygın Hatalar#
Belirti: model.track(["cam1.mp4", "cam2.mp4"]), listeyi akışlar olarak değil, görüntü grubu olarak değerlendiriyor. Çözüm: Kaynakları, her satırda bir tane olacak şekilde .streams dosyasına yaz.
Belirti: Her dosyadan yalnızca bir veya iki kare geliyor. Çözüm: stream_buffer=False eski kareleri bırakır ve dosya okuyucular modelden daha hızlı ilerler; dosyalar için stream_buffer=True ayarını yap, canlı kameralar için varsayılanı koru.
Belirti: Yük altındayken ara sıra yanlış veya birbirine karışmış sonuçlar alınıyor. Çözüm: Tek bir YOLO örneğini aynı anda birden fazla iş parçacığından asla çağırma. Yukarıda anlatıldığı gibi tek bir tüketicinin model örneğinin sahibi olmasını sağla veya her çıkarım iş parçacığının içinde bir model oluştur.
Belirti: Gecikme her dakika artıyor ve süreç kapanana kadar bellek kullanımı yükseliyor. Çözüm: Dolduğunda öğe düşüren sınırlı bir kuyruk ve bir düşürme sayacı kullan. Gerçek zamanlı sistemler, gecikmek yerine aşırı yük sırasında kareleri düşürmelidir.
Çözümü göster
SOURCES satırının hemen altına producer_consumer.py dosyasına şu satırları ekleyerek akış sayısını bir komut satırı argümanı hâline getir:
import sys

N = int(sys.argv[1]) if len(sys.argv) > 1 else 2  # benzetilecek kamera sayısı
SOURCES = [SOURCES[i % len(SOURCES)] for i in range(N)]
Ardından farklı değerleri dene:
for n in 1 2 4 8; do python producer_consumer.py $n; doneprocessed=[62] dropped=[0]
processed=[56, 131] dropped=[6, 19]
processed=[23, 82, 23, 81] dropped=[39, 68, 39, 69]
processed=[14, 53, 13, 53, 13, 52, 13, 53] dropped=[48, 97, 49, 97, 49, 98, 49, 97]Bu makine için sonuç tek akış: kare düşüşleri iki akışta başlıyor. Dört kameraya hizmet vermek için daha hızlı bir çalışma zamanına aktarım yap (3. ve 4. dersler), imgsz değerini düşür veya bir hızlandırıcıya geç; ardından denemeyi yeniden yap.