Chuẩn bị dataset tùy chỉnh
Sắp xếp ảnh và nhãn theo định dạng Ultralytics YOLO, chuyển đổi bounding box theo pixel thành các dòng nhãn đã chuẩn hóa và phát hiện nhãn lỗi trước khi huấn luyện.
Một thư mục đặt tên sai hoặc nhãn chưa chuẩn hóa sẽ không làm quá trình huấn luyện bị lỗi. Ultralytics bỏ qua các ảnh lỗi và tiếp tục, vì vậy bạn huấn luyện trên một phần dữ liệu, nhận được model tầm thường và mất cả buổi chiều tìm nguyên nhân ở sai chỗ.
Bài học này trình bày phần thao tác của một dataset phát hiện đối tượng: thư mục, dòng nhãn, chuyển đổi và kiểm tra. Bạn sẽ làm việc với dataset ảnh thuốc y tế thực tế gồm 115 ảnh mà các phần còn lại của khóa học sử dụng để huấn luyện. Nội dung quyết định thu thập gì và gắn nhãn ra sao được trình bày trong Các phương pháp gắn nhãn tốt nhất.
Thực hành
Lấy dataset thực hành#

Cấu trúc bên dưới cũng là định dạng zip mà hộp thoại Dataset mới của Ultralytics Platform chấp nhận, vì vậy dataset bạn chuẩn bị ở đây có thể tải lên nguyên trạng. Tải xuống 92 khung hình huấn luyện và 23 khung hình xác thực của thuốc trong vỉ, rồi giải nén vào my_dataset:
curl -L -o medical-pills.zip https://github.com/ultralytics/assets/releases/download/v0.0.0/medical-pills.zip
unzip -q medical-pills.zip -d my_dataset
my_dataset/
├── images/
│ ├── train/ Frame_0.jpg, Frame_100.jpg, ... (92 images)
│ └── val/ Frame_144.jpg, ... (23 images)
└── labels/
├── train/ Frame_0.txt, Frame_100.txt, ... (92 files)
└── val/ Frame_144.txt, ... (23 files)Không có tệp kê khai. Ultralytics tìm từng nhãn bằng cách thay /images/ bằng /labels/ trong đường dẫn ảnh và thay phần mở rộng bằng .txt, vì vậy images/val/Frame_144.jpg đọc labels/val/Frame_144.txt. Có hai hệ quả:
- Các thư mục phải được đặt tên chính xác là
imagesvàlabels, nằm cạnh nhau. - Ảnh có tệp nhãn trống hoặc bị thiếu là ảnh nền: hợp lệ và hữu ích để dạy model những gì không nên phát hiện, nhưng chỉ khi đó là chủ ý của bạn.
Đọc một dòng nhãn#
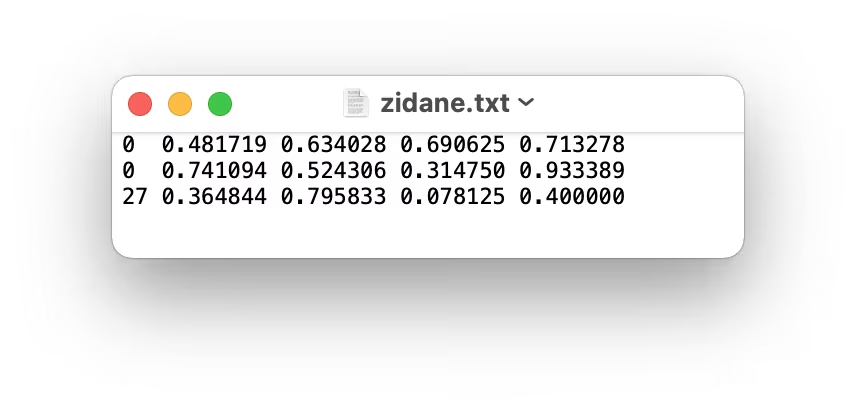
Mỗi dòng biểu thị một đối tượng: chỉ số lớp dạng số nguyên, sau đó là tâm và kích thước bounding box tính theo tỷ lệ của chiều rộng và chiều cao ảnh. Một dòng thực tế từ labels/train/Frame_0.txt:
0 0.330729 0.816204 0.103125 0.1212960: chỉ số lớp 0, được đặt tên làpilltrong YAML.0.330729 0.816204: tâm bounding box nằm ở vị trí 33% chiều ngang và 82% chiều dọc.0.103125 0.121296: bounding box rộng khoảng 10% và cao 12% so với ảnh.
Ví dụ thực tế: Chuyển đổi bounding box theo pixel#
Các công cụ gắn nhãn thường xuất tọa độ góc theo pixel (x1, y1, x2, y2). Hãy chia cho kích thước ảnh. Người ở ngoài cùng bên trái trong bus.jpg kích thước 810×1080 từ bài học trước có bounding box từ (49, 398) đến (240, 902):
| Trường | Công thức | Giá trị |
|---|---|---|
x_center | (x1 + x2) / 2 / width | (49 + 240) / 2 / 810 = 0.178395 |
y_center | (y1 + y2) / 2 / height | (398 + 902) / 2 / 1080 = 0.601852 |
width | (x2 − x1) / width | 191 / 810 = 0.235802 |
height | (y2 − y1) / height | 504 / 1080 = 0.466667 |
Hầu hết công cụ gắn nhãn và các công cụ như Roboflow đều có thể xuất trực tiếp định dạng YOLO. Với COCO JSON, hãy làm theo hướng dẫn huấn luyện COCO JSON; repository JSON2YOLO hỗ trợ các định dạng khác. Với XML VOC của Pascal, công thức trên có thể viết thành một script ngắn:
import xml.etree.ElementTree as ET
from pathlib import Path

CLASSES = ["person", "bus"]  # index = class id; must match names in data.yaml

def voc_to_yolo(xml_file: Path, out_dir: Path) -> None:
    root = ET.parse(xml_file).getroot()
    w, h = int(root.find("size/width").text), int(root.find("size/height").text)
    lines = []
    for obj in root.iter("object"):
        name = obj.find("name").text
        if name not in CLASSES:
            continue
        box = obj.find("bndbox")
        x1, y1, x2, y2 = (float(box.find(k).text) for k in ("xmin", "ymin", "xmax", "ymax"))
        xc, yc, bw, bh = (x1 + x2) / 2 / w, (y1 + y2) / 2 / h, (x2 - x1) / w, (y2 - y1) / h
        lines.append(f"{CLASSES.index(name)} {xc:.6f} {yc:.6f} {bw:.6f} {bh:.6f}")
    out_dir.mkdir(parents=True, exist_ok=True)
    (out_dir / f"{xml_file.stem}.txt").write_text("\n".join(lines) + "\n")

voc_to_yolo(Path("bus.xml"), Path("labels"))
print(Path("labels/bus.txt").read_text())
Chạy trên bus.xml chứa bounding box người và xe buýt từ bài học trước, script sẽ in ví dụ thực tế và xe buýt:
0 0.178395 0.601852 0.235802 0.466667
1 0.495679 0.454167 0.991358 0.482407
Kiểm tra trước khi huấn luyện#
Vẽ một vài tệp nhãn lên ảnh tương ứng. Lớp bị lệch, tọa độ x và y bị đảo hoặc bounding box bao quanh bóng đổ đều dễ nhận ra bằng mắt nhưng không thể hiện qua các chỉ số:
from ultralytics.data.utils import visualize_image_annotations

visualize_image_annotations(
    "my_dataset/images/train/Frame_0.jpg",
    "my_dataset/labels/train/Frame_0.txt",
    {0: "pill"},
)
Sau đó để Ultralytics kiểm tra mọi tệp. Lần đầu đọc dataset, Ultralytics quét nhãn và xác định từng ảnh có sử dụng được hay không, theo từng dòng:
Dòng quét báo cáo kết quả: 23 images, 0 backgrounds, 0 corrupt là trạng thái của một dataset tốt. Mọi kết quả khác đều là một trong những lỗi bên dưới.
Tránh những lỗi này#
Triệu chứng: ignoring corrupt image/label: non-normalized or out of bounds coordinates [634. 881. 198. 163.] và số lượng corrupt khác 0. Nguyên nhân: dùng giá trị pixel thay vì phân số. Cách khắc phục: chia cho chiều rộng và chiều cao ảnh. Bất kỳ giá trị nhãn nào lớn hơn 1 đều có nghĩa là bbox chưa từng được chuẩn hóa.
Triệu chứng: yolo val quét 0 images, 23 backgrounds và cảnh báo No labels found, rồi quá trình huấn luyện dừng với ValueError: train: No labels found — trong trường hợp này là vì thư mục nhãn được đặt tên là annotations. Cách khắc phục: đặt chính xác tên thư mục là images và labels, với tên tệp tương ứng.
Triệu chứng: Label class 1 exceeds dataset class count 1. Possible class labels are 0-0. Nguyên nhân: công cụ export đánh số lớp bắt đầu từ 1. Cách khắc phục: lớp YOLO bắt đầu từ 0; trừ 1 trong script chuyển đổi hoặc sửa thiết lập export.
Nếu các bbox được vẽ lệch xuống dưới và sang phải nửa bbox, bạn đã ghi x1 y1 w h thay vì x_center y_center w h. Vẽ một tệp sẽ phát hiện lỗi này trong vài giây; không bước kiểm tra quét nào làm được điều đó.
Để kiểm tra có hệ thống trên toàn bộ dataset, xem Kiểm soát chất lượng dataset. Các dataset tích hợp như coco8, coco128 và african-wildlife là những cấu trúc tốt để tham khảo; tổng quan về dataset liệt kê tất cả. Trainer bổ sung tăng cường dữ liệu lên trên nhãn của bạn, vì vậy dành thời gian làm sạch dữ liệu ở bước này sẽ đem lại lợi ích trong mọi epoch.
Hiển thị lời giải
for s in train val; do
  echo "$s: $(ls my_dataset/images/$s | wc -l) images, $(ls my_dataset/labels/$s | wc -l) labels"
done
# train: 92 images, 92 labels
# val:   23 images, 23 labels
from pathlib import Path
for txt in Path("my_dataset/labels").rglob("*.txt"):
for line in txt.read_text().splitlines():
values = [float(v) for v in line.split()[1:]]
if any(v < 0 or v > 1 for v in values):
print(txt, line)Script không xuất kết quả nghĩa là mọi tọa độ đều đã được chuẩn hóa. Số lượng bằng nhau trong mỗi tập nghĩa là mỗi ảnh đều có tệp nhãn; dòng quét ở bài học tiếp theo sẽ xác nhận không có tệp nào bị hỏng.