Validation và chẩn đoán
Validation best.pt so với giá trị cơ sở, đọc ma trận nhầm lẫn, số liệu theo từng lớp và ảnh dự đoán, rồi chuyển các thông tin đó thành danh sách các thay đổi cụ thể.
Một con số mAP duy nhất cho bạn biết model sai nhiều đến mức nào, chứ không cho biết sai điều gì. Bỏ sót đối tượng nhỏ, nhầm lẫn giữa hai lớp và box quá lỏng đều làm giảm mAP, nhưng mỗi vấn đề cần một cách khắc phục khác nhau. Chẩn đoán sai sẽ khiến bạn mất cả tuần thu thập nhầm dữ liệu.
Trong bài học này, bạn sẽ chạy chế độ Val trên best.pt, so sánh với giá trị cơ sở và đọc ma trận nhầm lẫn cùng ảnh dự đoán cho đến khi có thể viết danh sách thay đổi cho vòng tiếp theo. Hướng dẫn về metric hiệu năng là tài liệu chuyên sâu đi kèm.
Thực hành
Ví dụ thực hành: Validation best.pt#
from ultralytics import YOLO

model = YOLO("runs/detect/pills_v1/weights/best.pt")
metrics = model.val(data="my_dataset/data.yaml")

print(f"precision {metrics.box.mp:.3f}  recall {metrics.box.mr:.3f}")
print(f"mAP50 {metrics.box.map50:.3f}  mAP50-95 {metrics.box.map:.3f}")
Đầu ra thực tế từ val.py:
precision 0.970  recall 0.957
mAP50 0.977  mAP50-95 0.659
Các biểu đồ được lưu trong thư mục runs/detect/val mới (tiếp theo là val-2, ...). Đặt các con số cạnh giá trị cơ sở:
| Model | mAP50 | mAP50-95 |
|---|---|---|
yolo26n.pt pretrained (không có lớp viên thuốc) | 0.001 | 0.0002 |
pills_v1 (10 epoch, imgsz 320, CPU) | 0.977 | 0.659 |
Các con số cho thấy:
- Precision 0.970, recall 0.957: cân bằng. Ít cảnh báo sai, ít trường hợp bỏ sót.
- mAP50 0.977: với yêu cầu về độ chồng lấp lỏng, model tìm thấy gần như mọi viên thuốc.
- mAP50-95 0.659: với yêu cầu về độ chồng lấp nghiêm ngặt, nhiều bounding box chưa khít. Khoảng cách lớn như vậy cho thấy vấn đề nằm ở định vị — cần thêm epoch, một
imgszlớn hơn hoặc nhãn chính xác hơn — chứ không phải thiếu dữ liệu.
Để tìm hiểu sự đánh đổi giữa precision, recall và mAP, xem Đọc các chỉ số phát hiện một cách chính xác.
Tìm hiểu tệp nào trả lời câu hỏi nào#
| Câu hỏi | File |
|---|---|
| Những class nào bị nhầm lẫn, và những class nào bị bỏ sót? | confusion_matrix_normalized.png |
| Mỗi class đánh đổi precision để lấy recall như thế nào? | BoxPR_curve.png |
| Nên triển khai ở ngưỡng confidence nào? | BoxF1_curve.png: giá trị đỉnh của tệp này là một conf khởi đầu tốt |
| Các trường hợp lỗi trông như thế nào? | val_batch0_labels.jpg so với val_batch0_pred.jpg |
| Model có bị overfit không? | results.png trong thư mục training |
Đọc confusion matrix#
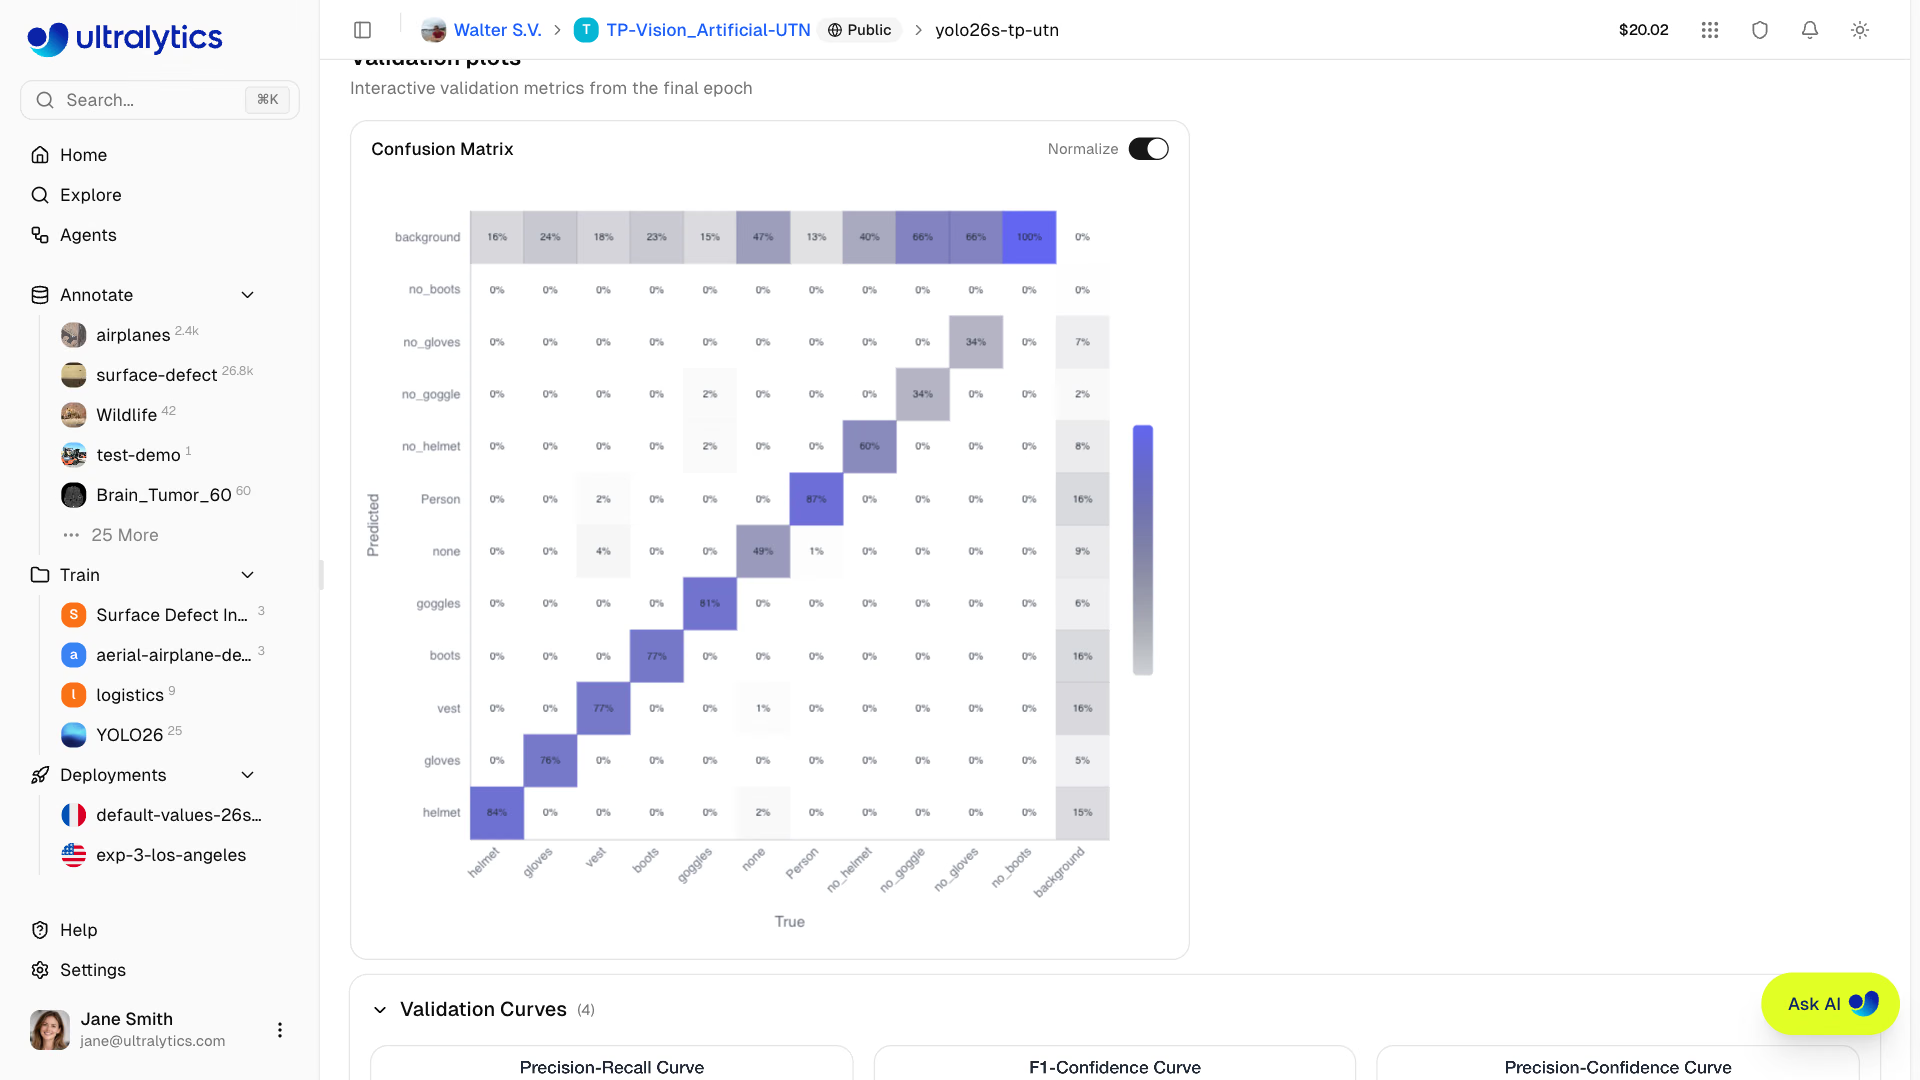
Confusion matrix là công cụ chẩn đoán hữu ích nhất. Trong các biểu đồ của Ultralytics, các cột là class thực tế và các hàng là class được dự đoán, kèm thêm một hàng và cột background. Phiên bản chuẩn hóa chia từng cột cho tổng của cột đó, vì vậy mỗi cột cho biết các đối tượng thuộc class đó được phân loại thành những loại nào. Pills chỉ có một class, vì vậy hãy thực hành với ví dụ kho hàng ba class này (các con số mang tính minh họa):
| Được dự đoán ↓ / Thực tế → | xe nâng | người | pallet | nền |
|---|---|---|---|---|
| xe nâng | 0.78 | 0.03 | 0.18 | 0.45 |
| người | 0.04 | 0.91 | 0.00 | 0.20 |
| pallet | 0.10 | 0.00 | 0.65 | 0.35 |
| nền | 0.08 | 0.06 | 0.17 | — |
- Đường chéo: tỷ lệ của mỗi class được phát hiện chính xác. Pallet là class yếu nhất, với giá trị 0.65.
- Ngoài đường chéo: các trường hợp nhầm lẫn. 18% pallet thực tế bị dự đoán là xe nâng, và 10% xe nâng bị dự đoán là pallet.
- Hàng nền: các trường hợp bỏ sót. 17% pallet hoàn toàn không được phát hiện.
- Cột nền: các false positive, tức bounding box được vẽ trên vùng trống. Trong số đó, 45% bị nhận nhầm là xe nâng.
Mỗi loại ô tương ứng với một cách khắc phục:
| Tình huống | Cách khắc phục |
|---|---|
| Hai class nhầm lẫn với nhau | Bổ sung ví dụ giúp phân biệt chúng: xe nâng chở pallet, pallet xếp cạnh xe nâng |
| Hàng nền cao (bỏ sót) | Bổ sung ví dụ về class đó trong những điều kiện mà model thường bỏ sót |
| Cột nền cao (cảnh báo sai) | Bổ sung ảnh nền của những cảnh dễ kích hoạt cảnh báo sai, chẳng hạn lối đi trống |
Đọc các con số theo từng class#
Khi có nhiều class, log validation in một hàng cho mỗi class, còn metrics.box.maps chứa mAP50-95 theo từng class để dùng trong code. Tiếp tục với ví dụ kho hàng:
                 Class     Images  Instances      Box(P          R      mAP50  mAP50-95)
                   all         50        102       0.78       0.71       0.74       0.51
              forklift         30         45       0.85       0.78       0.81       0.58
                person         40         50       0.92       0.88       0.91       0.64
                pallet          5          7       0.58       0.48       0.51       0.31
pallet thấp hơn nhiều so với các class khác và chỉ có 7 instance trong tập validation. Có thể model nhận diện pallet kém, hoặc dữ liệu validation quá ít để đưa ra kết luận. Cả hai trường hợp đều dẫn đến cùng một bước: thu thập thêm pallet cho cả training lẫn validation.
Xem các trường hợp lỗi#
Mở val_batch0_labels.jpg và val_batch0_pred.jpg cạnh nhau. Sự khác biệt giữa hai tệp thể hiện các lỗi dưới dạng hình ảnh; các quy luật lặp lại trong những lỗi đó giúp chẩn đoán vấn đề: bỏ sót ở rìa ảnh, vật thể nhỏ, một điều kiện ánh sáng cụ thể hoặc một vật thể có ngoại hình dễ gây nhầm lẫn. Các quy luật trong dataset như vậy thường có giá trị hơn việc tinh chỉnh hyperparameter.
Trong ảnh validation của model nhận diện viên thuốc, các viên thuốc nhìn rõ có confidence gần 1.0. Các bounding box confidence thấp, khoảng 0.3–0.5, tập trung quanh những viên thuốc bị vỉ thuốc khác che một phần và những viên thuốc bị cắt ở rìa ảnh. Đây không phải vấn đề có thể khắc phục bằng cách tinh chỉnh conf; đây là câu hỏi về chính sách gán nhãn. Một viên thuốc bị che khuất một nửa có được tính không? Hãy quyết định, ghi lại quy tắc và gán nhãn nhất quán cho mọi ảnh.
Sau đó mở results.png. Loss training và validation cần giảm đồng thời. Nếu loss training tiếp tục giảm trong khi loss validation tăng, model đang overfit; nếu cả hai đều ở mức cao, model đang underfit. Sự đánh đổi giữa bias và variance là lăng kính để xem xét cả hai tình trạng.
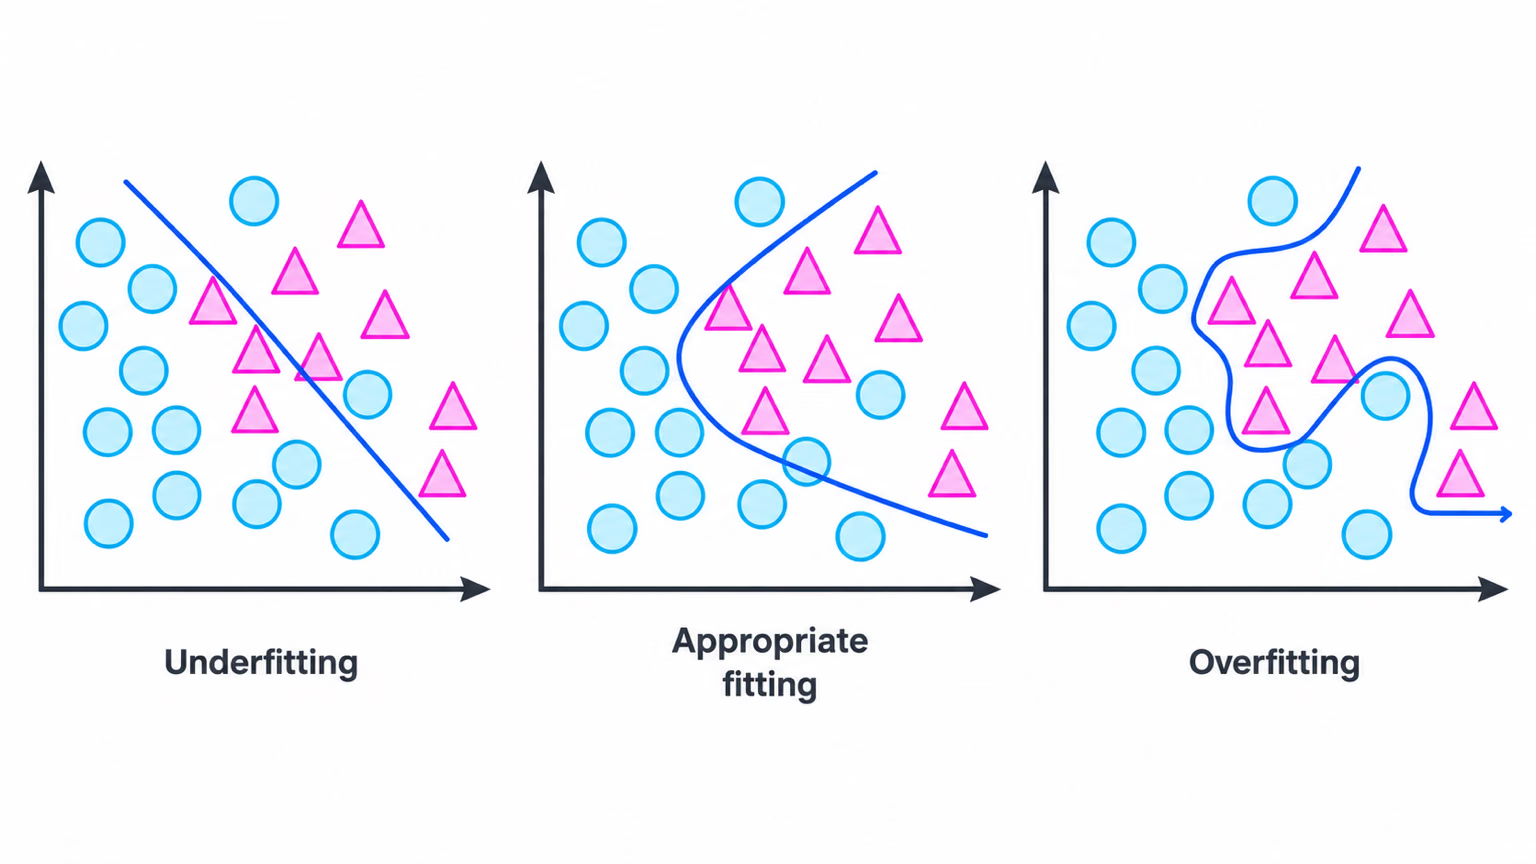
Để khắc phục overfitting, hãy thử theo thứ tự từ thường hiệu quả nhất: dữ liệu đa dạng hơn; giảm số epoch hoặc dùng patience chặt hơn; và data augmentation (hsv_h, degrees, translate, scale, fliplr, mosaic, ...). Các thiết lập augmentation mặc định đã khá mạnh; chỉ thay đổi khi có lý do cụ thể, chẳng hạn tắt fliplr khi phân biệt trái và phải là quan trọng.
Chuyển các phát hiện thành danh sách việc cần khắc phục#
Khắc phục dữ liệu trước khi tinh chỉnh hyperparameter, và mỗi vòng chỉ thay đổi một yếu tố để xác định điều gì có tác dụng. Phần dataset trong quy trình này được trình bày trong Fine-tune lần đầu và quy trình lặp.
Tránh những lỗi này#
Triệu chứng: model đạt 0.659 mAP50-95 nhưng đột nhiên chỉ còn 0.403. Nguyên nhân: pills_v1 được huấn luyện ở imgsz=320 nhưng validation ở imgsz=640; các đối tượng trông lớn gấp đôi so với mọi thứ model đã học. Cách khắc phục: validation và triển khai ở imgsz dùng khi huấn luyện, đồng thời chỉ so sánh các lần chạy ở cùng kích thước.
Validation chạy ở conf=0.001 để có thể truy vết toàn bộ đường cong precision-recall; vì vậy val_batch0_pred.jpg hiển thị các bbox mà ứng dụng của bạn sẽ không bao giờ báo cáo. Chọn ngưỡng triển khai từ BoxF1_curve.png, rồi kiểm tra bằng predict.
Với 23 ảnh, precision của một epoch dao động từ 0.93 xuống 0.80 rồi tăng trở lại. Đánh giá xu hướng qua nhiều epoch và lần chạy, đồng thời tăng kích thước tập validation trước khi tin vào các chênh lệch một hoặc hai điểm.
Hiển thị lời giải
Baseline mAP50-95 0.0002 -> pills_v1 0.659 (mAP50 0.977), both at imgsz=320

Failures:
- Low-confidence boxes (about 0.3-0.5) on pills half-hidden under another pack.
- Low-confidence or missing boxes on pills cut off at the image edge.

Overfitting: none. val/box_loss flattened near 1.05; val/cls_loss spiked at epochs 4-6
and then fell to its lowest value (1.08) at epoch 10.

Fix list:
1. Write a labeling rule for partly hidden and edge pills, then relabel the val set to match.
2. Train longer and larger: epochs=50, imgsz=640 (mAP50-95 lags mAP50, so box tightness is the gap).
3. Add 20 frames with overlapping packs, labeled under the new rule.