Huấn luyện model đầu tiên của bạn
Fine-tune YOLO26 trên bộ dữ liệu của bạn chỉ bằng một lệnh gọi, đọc log huấn luyện trực tiếp từng dòng và tìm best.pt cùng các biểu đồ quan trọng trong thư mục run.
Huấn luyện detector từ đầu mất nhiều ngày và cần bộ dữ liệu khổng lồ. Fine-tune YOLO26 pretrained trên khoảng một trăm ảnh chỉ mất khoảng một phút trên CPU laptop, vì transfer learning tái sử dụng toàn bộ kiến thức model đã học về cạnh, hình dạng và đối tượng.
Trong bài học này, bạn sẽ huấn luyện trên bộ dữ liệu viên thuốc, theo dõi mAP50-95 tăng từ mức cơ sở gần bằng 0 lên 0.66 sau mười epoch và học cách sớm nhận biết qua log liệu một lượt chạy có ổn hay đang lãng phí thời gian.
Thực hành
Ví dụ thực hành: Huấn luyện detector viên thuốc#
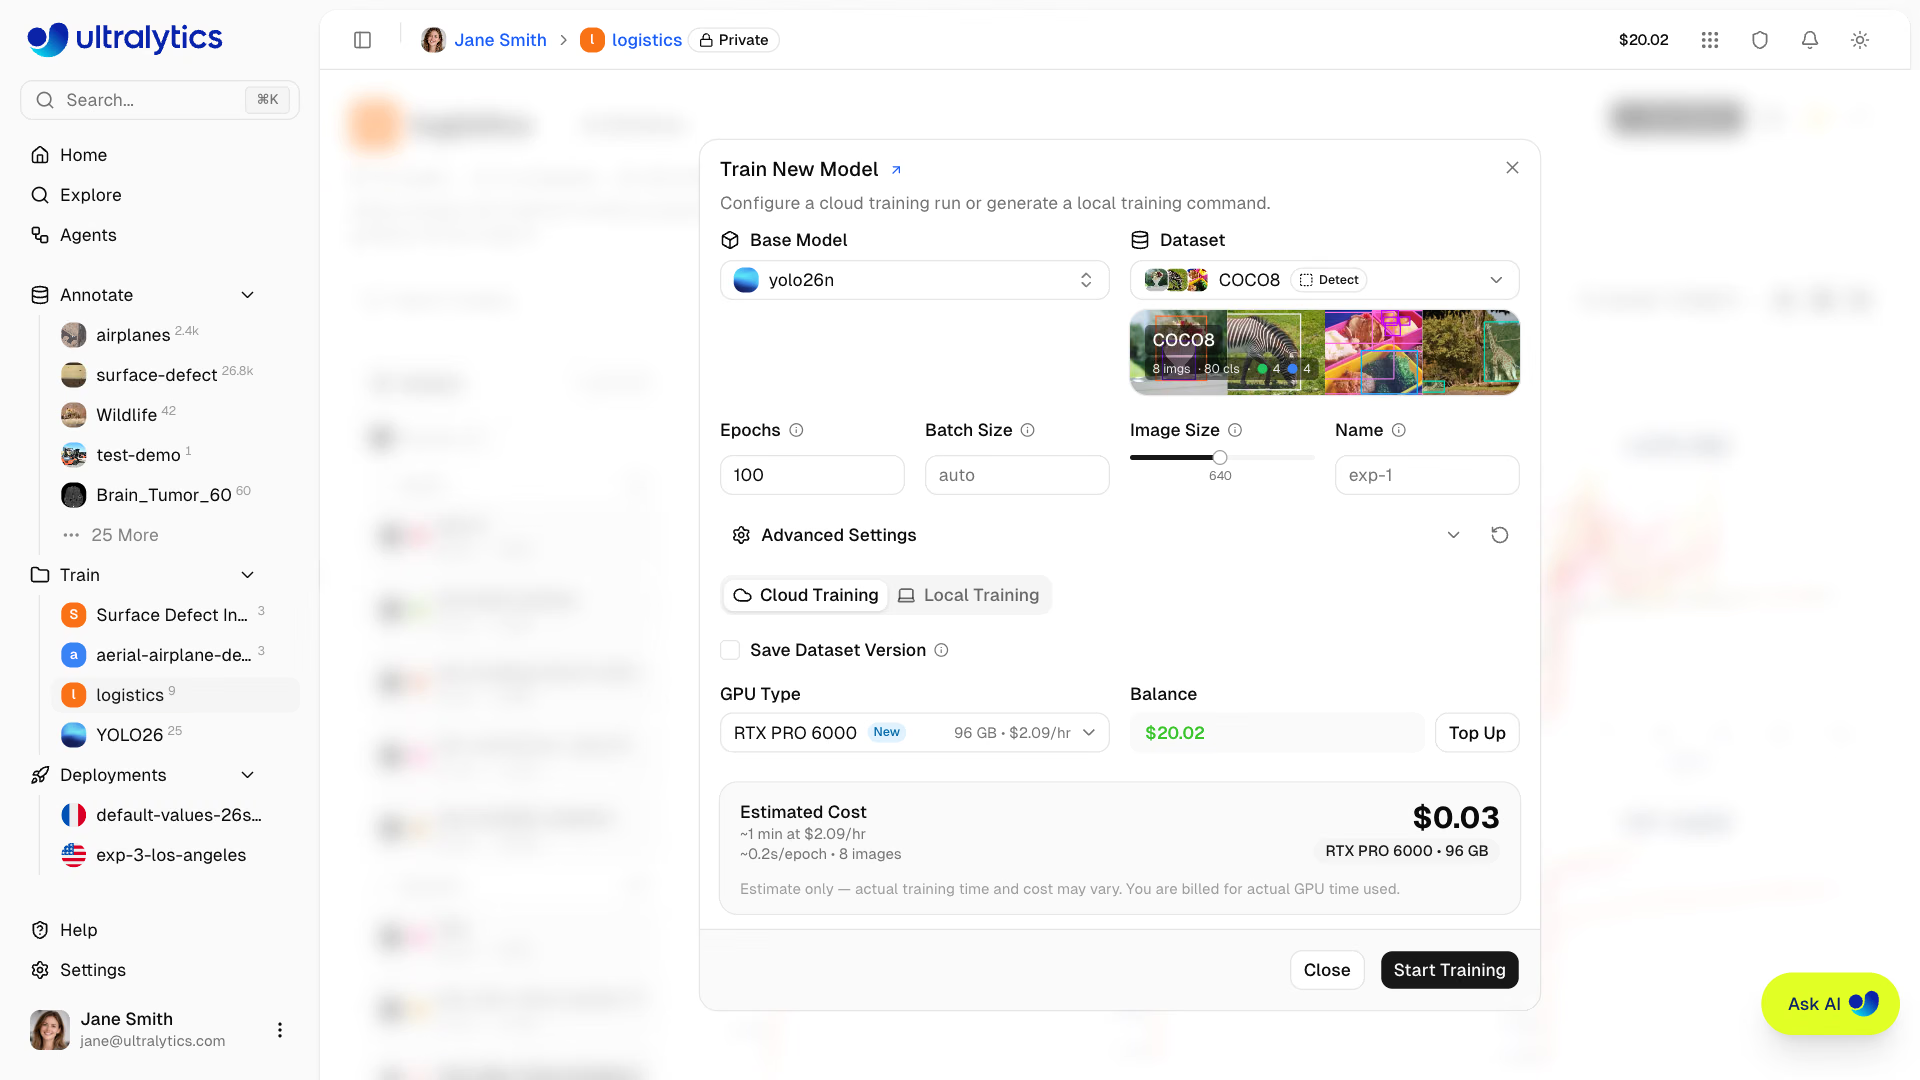
Hộp thoại Train New Model của Ultralytics Platform yêu cầu các lựa chọn giống như đoạn code bên dưới — model cơ sở, bộ dữ liệu, epoch, kích thước ảnh — rồi chạy trên GPU cloud hoặc tạo lệnh tương ứng để chạy cục bộ. Các thiết lập này hoàn tất trong khoảng một phút trên CPU laptop:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # được pretrained trên COCO
results = model.train(data="my_dataset/data.yaml", epochs=10, imgsz=320, name="pills_v1")
print(results.save_dir)
CLI và Python là tương đương. epochs=10 và imgsz=320 giúp các lượt chạy trên CPU ngắn hơn; nếu dùng GPU, hãy bỏ cả hai và chấp nhận giá trị mặc định (epochs=100, imgsz=640), vì nhiều epoch và pixel hơn hầu như luôn có lợi. Chế độ Train tự chạy vòng lặp này cho bạn:
Đọc log từng dòng#
Đầu ra thực tế, rút gọn còn hai epoch đầu và hai epoch cuối:
optimizer: AdamW(lr=0.002, momentum=0.9) with parameter groups ...
Using 92 train, 23 val images for fraction=1.0 at imgsz=320
      Epoch    GPU_mem   box_loss   cls_loss    l1_loss  Instances       Size
       1/10         0G      1.818      3.899   0.008805        206        320: 100% 6/6 3.3s
                   all         23        399      0.957      0.805      0.927      0.548
       2/10         0G      1.434      3.291   0.006285        208        320: 100% 6/6 4.4s
                   all         23        399      0.953      0.911      0.964      0.592
       ...
       9/10         0G      1.121      1.103   0.005143        194        320: 100% 6/6 5.0s
                   all         23        399      0.949      0.957      0.975      0.656
      10/10         0G      1.174      1.125   0.005068        212        320: 100% 6/6 5.1s
                   all         23        399       0.97      0.957      0.977      0.659
10 epochs completed in 0.015 hours.
optimizer: AdamW(lr=0.002 ...):optimizer=automặc định đã chọn optimizer và learning rate cho bạn.Using 92 train, 23 val images: xác nhận các giá trị này khớp với bộ dữ liệu của bạn. Số nhỏ hơn nghĩa là có ảnh bị bỏ qua.GPU_mem 0G: đang huấn luyện trên CPU. Nếu dùng GPU, tại đây bạn sẽ thấy mức sử dụng bộ nhớ;0Gtrên máy có GPU nghĩa là GPU chưa được sử dụng.- Dòng đầu tiên của mỗi epoch: ba loss trên tập huấn luyện, cùng số lượng đối tượng được gán nhãn trong batch cuối (
Instances) và kích thước ảnh. - Dòng
allcủa mỗi epoch: precision, recall, mAP50 và mAP50-95 trên tập validation. Đây là dòng cần theo dõi.
| Cột | Ý nghĩa | Xu hướng ổn định |
|---|---|---|
box_loss | Mức chênh lệch giữa các box dự đoán và box được gán nhãn | Giảm rồi chững lại |
cls_loss | Mức sai lệch của điểm số lớp | Giảm rồi chững lại |
l1_loss | Sai số trực tiếp về tọa độ box của YOLO26 | Giảm |
P, R | Precision và recall trên tập val | Tăng và duy trì cân bằng |
mAP50, mAP50-95 | Chất lượng phát hiện; mAP50-95 cũng đánh giá cao các box khít | Tăng rồi chững lại |
Ở đây, mAP50-95 tăng từ mức cơ sở 0.0002 lên 0.548 sau một epoch và 0.659 sau mười epoch. Precision giảm xuống 0.80 ở epoch 4 rồi phục hồi: kết quả từng epoch có thể dao động trên 23 ảnh validation, vì vậy hãy đánh giá xu hướng thay vì một dòng đơn lẻ. Các nguyên tắc ra quyết định khi lượt chạy đang diễn ra:
- Loss giảm và mAP tăng: để lượt chạy tiếp tục.
- Loss đi ngang từ epoch 1: dừng bằng Ctrl+C rồi kiểm tra nhãn và YAML.
- Precision cao hơn recall đáng kể: model thận trọng và bỏ sót đối tượng. Recall cao hơn precision đáng kể: model phát hiện cả những thứ không tồn tại.
- mAP đi ngang trong nhiều epoch: tăng số epoch sẽ không giúp ích; hãy thay đổi dữ liệu hoặc
imgsz.
Ba loss là các thành phần trong hàm loss của YOLO26; hướng dẫn về metric hiệu năng giải thích chi tiết từng metric.
Tìm các tệp đầu ra của lượt chạy#
Mọi thứ được lưu vào runs/detect/pills_v1/:
| File | Mục đích |
|---|---|
weights/best.pt | Checkpoint có fitness validation tốt nhất qua các epoch; dùng cho inference và export |
weights/last.pt | Checkpoint mới nhất; dùng để tiếp tục lượt chạy bị gián đoạn |
args.yaml | Mọi đối số đã dùng trong lượt chạy để tái lập kết quả |
results.csv, results.png | Loss và metric theo từng epoch, dưới dạng dữ liệu và biểu đồ |
labels.jpg | Số lượng lớp và biểu đồ phân bố kích thước, vị trí của box |
train_batch*.jpg | Các batch huấn luyện đã augmentation, có vẽ nhãn |
val_batch*_labels.jpg, val_batch*_pred.jpg | Ground truth và dự đoán trên ảnh validation |
confusion_matrix*.png, Box*_curve.png | Ma trận nhầm lẫn cùng các đường cong precision, recall, F1 và PR |
Trước tiên, mở train_batch0.jpg. Nếu các box không khớp với đối tượng thì nhãn bị sai, và tăng số epoch cũng không thể khắc phục.
Ưu tiên thay đổi các đối số này#
| Đối số | Mặc định | Thay đổi khi nào |
|---|---|---|
epochs | 100 | Các thử nghiệm ngắn trên CPU hoặc bộ dữ liệu rất nhỏ bắt đầu overfit (giảm); bộ dữ liệu lớn vẫn đang cải thiện (tăng lên 200–300) |
imgsz | 640 | Đối tượng nhỏ (tăng lên 1024 hoặc 1280) hoặc thử nghiệm trên CPU (giảm) |
batch | 16 | Batch size: giảm khi hết bộ nhớ, hoặc dùng -1 để tự động đặt kích thước bằng khoảng 60% bộ nhớ GPU |
patience | 100 | Dừng sớm khi fitness validation không cải thiện trong N epoch, ví dụ patience=20 |
device | tự động | Buộc dùng cpu, mps, chỉ số GPU như 0 hoặc nhiều GPU như [0, 1] |
name | train | Luôn đặt tên lượt chạy theo nội dung đã thay đổi |
model.train(data="my_dataset/data.yaml", epochs=200, imgsz=1024, batch=-1, patience=20, name="pills_v1_1024")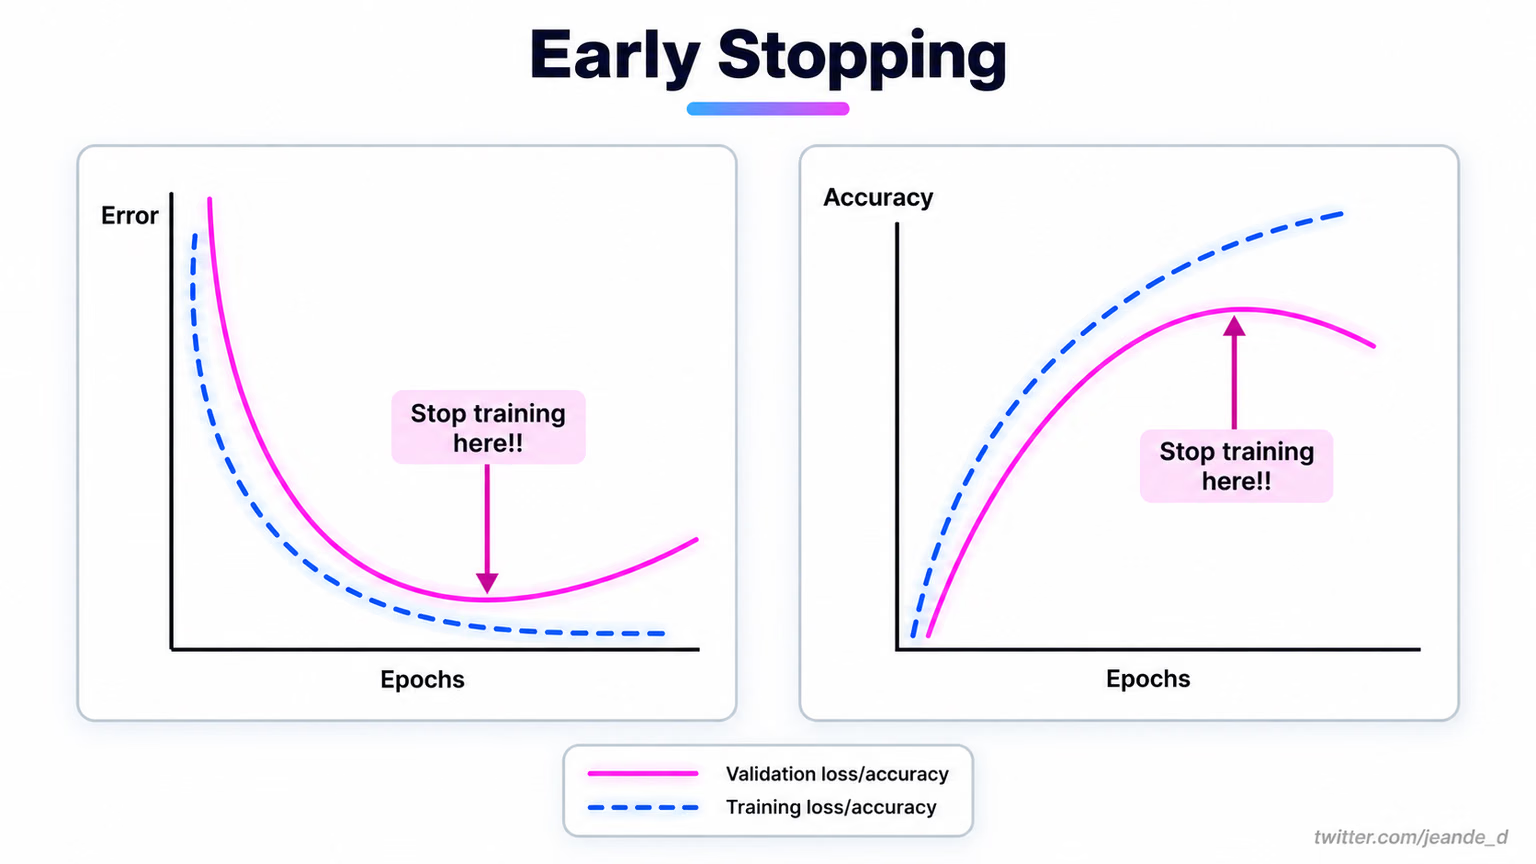
Giá trị mặc định 100 của patience có nghĩa là lượt chạy 100 epoch sẽ không bao giờ dừng sớm. Giá trị nhỏ hơn sẽ kết thúc lượt chạy bị đình trệ tại thời điểm các đường cong phía trên cho thấy nên dừng; dù thế nào thì best.pt vẫn được giữ lại.
Khi dùng nhiều GPU, hãy truyền một danh sách như device=[0, 1, 2, 3]: Ultralytics tự khởi chạy huấn luyện song song dữ liệu phân tán (DDP), batch là tổng số trên các GPU và theo mặc định, quá trình huấn luyện sử dụng mixed precision (amp=True). Khi lượt chạy vượt quá khả năng của laptop, cùng bộ dữ liệu và các đối số đó có thể chạy trên GPU cloud của Ultralytics Platform, như trình bày trong Huấn luyện, đọc và fine-tune các lượt chạy.
Tránh những lỗi này#
Triệu chứng: mAP gần bằng 0 sau nhiều epoch trên dataset nhỏ. Nguyên nhân: model xuất phát từ yolo26n.yaml (trọng số ngẫu nhiên) thay vì yolo26n.pt. Cách khắc phục: luôn bắt đầu bằng .pt đã pretrained. Huấn luyện từ đầu chỉ đáng làm trong nghiên cứu backbone hoặc với dataset rất lớn.
Triệu chứng: CUDA out of memory ngay trong epoch đầu tiên. Cách khắc phục: giảm một nửa batch hoặc đặt batch=-1 để AutoBatch chọn kích thước phù hợp với bộ nhớ. Giảm imgsz cũng hữu ích, nhưng làm thay đổi những gì model có thể nhìn thấy.
last.pt là epoch cuối cùng, có thể kém hơn một epoch trước đó. best.pt là epoch có độ phù hợp validation tốt nhất; đây là epoch cần dùng để validation, export và triển khai.
Hướng dẫn mẹo huấn luyện model trình bày các đối số còn lại; hướng dẫn tinh chỉnh hyperparameter trình bày các lần thử learning rate và genetic tuner. Hướng dẫn fine-tune trình bày cách đóng băng layer.
Hiển thị lời giải
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
results = model.train(data="my_dataset/data.yaml", epochs=10, imgsz=320, name="pills_v1")
print(results.save_dir)  # runs/detect/pills_v1
Baseline (yolo26n.pt, no pill class): mAP50 0.001, mAP50-95 0.0002
pills_v1 (10 epochs, imgsz 320, CPU, ~1 min): mAP50 0.977, mAP50-95 0.659
Plateau: mAP50-95 gains shrink after epoch 8 (0.649 -> 0.656 -> 0.659)
train_batch0.jpg: yes, boxes sit on the pillsCác con số chính xác có thể chênh lệch đôi chút tùy phần cứng và phiên bản package.