دمج المهام في مسار واحد
أنشئ تسلسلًا للكشف ثم التصنيف، وصنّف كل كائن متعقب مرة واحدة بدلًا من تصنيفه في كل إطار، وحوّل النقاط المفتاحية للوضعية إلى سلاسل زمنية لكل شخص.
تتألف الأنظمة الأكثر فائدة بعد الكشف عادةً من نموذجين لا نموذج واحد. يكتشف كاشف كل عامل، ويحدد مصنّف ما إذا كان نوع خوذة كل عامل صحيحًا؛ ويكتشف نموذج الوضعية المفاصل، ثم يحوّلها متعقب إلى خط زمني يمكن إحصاء التكرارات منه. الكود قصير، لكن ما يعطّل هذه الأنظمة هو عدم تطابق مجموعة بيانات المرحلة الثانية مع القصاصات في المرحلة الأولى، والتكلفة التي تتضاعف مع كل كائن في كل إطار — فعند التشغيل الساذج، يكلف بث بمعدل 30 إطارًا في الثانية وعشرة أشخاص 300 عملية تصنيف في الثانية.
عملي
نمطا عمل يغطيان معظم المنتجات#
يبدأ كلا النمطين من الإطار نفسه ومن واجهة Ultralytics API نفسها؛ ويختلفان في ما تستهلكه المرحلة الثانية. أما اختيار المتعقب وضبطه ومعالجة التدفقات في تتبع الكائنات فتتناولها صفحة تتبّع الكائنات باستخدام ByteTrack وBoT-SORT وTrackTrack؛ ونركز هنا على ربط المهام.
اكتشف، ثم صنّف القصاصات#
from ultralytics import YOLO

detector = YOLO("yolo26n.pt")
classifier = YOLO("yolo26n-cls.pt")  # swap in your own fine-tuned classifier

result = detector("https://ultralytics.com/images/bus.jpg", conf=0.5)[0]
crops, labels = [], []
for box in result.boxes:
    x1, y1, x2, y2 = box.xyxy[0].int().tolist()
    crops.append(result.orig_img[y1:y2, x1:x2])  # BGR numpy crop, same as the detector saw
    labels.append(result.names[int(box.cls)])

for label, crop_result in zip(labels, classifier(crops, verbose=False)):  # one batched call for all crops
    probs = crop_result.probs
    print(f"{label:6s} -> {crop_result.names[probs.top1]} ({float(probs.top1conf):.2f})")
bus -> bullet_train (0.31)
person -> sweatshirt (0.24)
person -> abaya (0.50)
person -> loudspeaker (0.49)
person -> frilled_lizard (0.24)الترابط البرمجي سليم: تُستخرج القصاصات من orig_img بالدقة الكاملة وبإحداثيات البكسل الخاصة بالكاشف، ويرى المصنّف جميع القصاصات في استدعاء واحد على دفعات. التسميات غير منطقية عمدًا.
لم يُدرَّب مصنّف ImageNet قط على أشخاص الشوارع الظاهرين في صور مقصوصة جزئيًا وبإطار ضيق، لذا فهو يخمّن — لاحظ أن الثقة لا تتجاوز 0.50. ويحدث الأمر نفسه لمصنّف مدرّب على صور منتجات واضحة ثم تُمرّر إليه قصاصات ضبابية من الكاشف.
أنشئ مجموعة بيانات المرحلة الثانية من قصاصاتك#
الطريقة الموثوقة للحصول على بيانات متطابقة هي أن تدع الكاشف ينشئها:
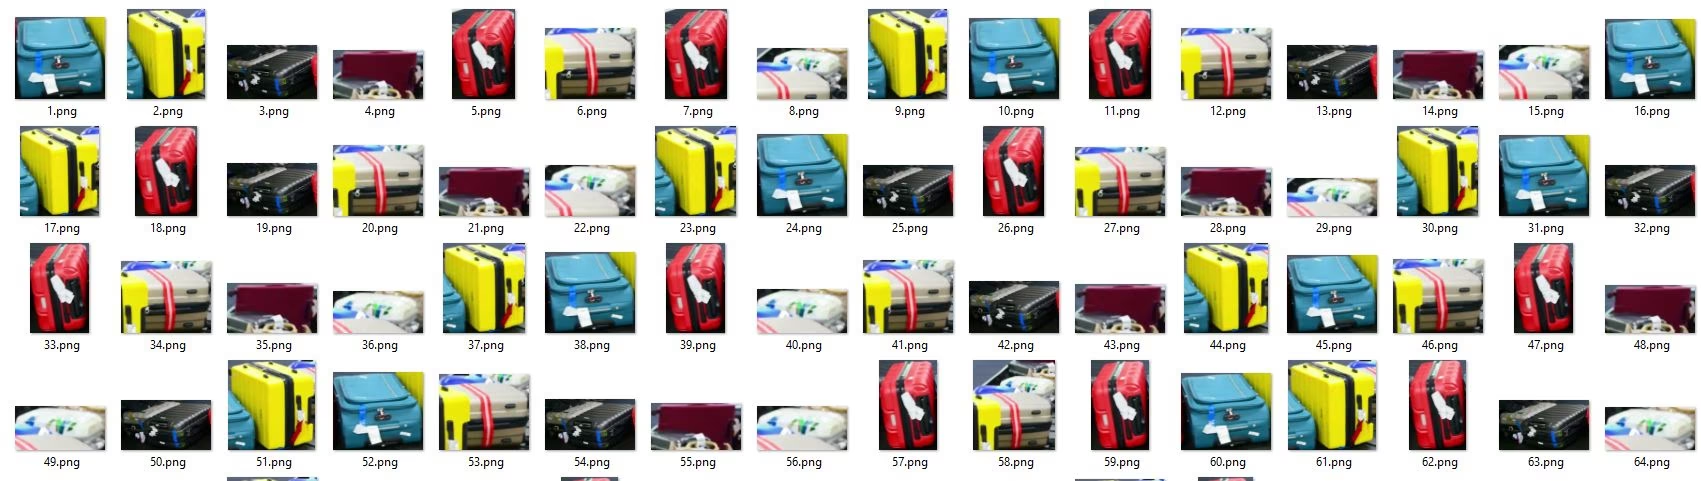
- شغّل الكاشف على لقطات ممثلة باستخدام
save_crop=True، مثلًاyolo predict model=best.pt source=footage/ save_crop=True. تُحفظ القصاصات فيruns/detect/predict/crops/<class>/. - افرز قصاصات كل فئة في مجلداتها الدقيقة (
helmet_ok/وhelmet_missing/) — فهذا هو بالفعل تخطيط التصنيف الذي تناولناه في الدرس السابق. - درّب المصنّف على تلك المجلدات، وتحقق من صحته باستخدام قصاصات من يوم أو كاميرا مختلفين.
بما أن الكاشف هو من اقتطع القصاصات، فإنها تحافظ على التأطير والتمويه والحجب الفعلي الذي ينتجه — وهو بالضبط ما سيراه المصنّف في بيئة الإنتاج — كما أن الضبط الدقيق عليها يُعد تعلمًا بالنقل اعتياديًا.
صنّف مرة واحدة لكل معرّف تتبع#
لا تتغير الخوذة بين الإطارات، لذا فإن تصنيف كل صندوق في كل إطار عمل مهدور. تتبّع الاكتشافات وصنّف كل معرّف تتبع جديد مرة واحدة:
from ultralytics import YOLO

detector = YOLO("yolo26n.pt")
classifier = YOLO("yolo26n-cls.pt")  # swap in your own fine-tuned classifier
source = "https://github.com/ultralytics/assets/releases/download/v0.0.0/decelera_portrait_min.mov"

labels = {}  # track id -> (label, confidence), filled once per person
frames = boxes_seen = 0
for result in detector.track(source, classes=[0], stream=True, persist=True, verbose=False):  # people only
    frames += 1
    if result.boxes.id is None:
        continue
    for track_id, (x1, y1, x2, y2) in zip(result.boxes.id.int().tolist(), result.boxes.xyxy.int().tolist()):
        boxes_seen += 1
        if track_id not in labels:  # first sighting: classify once, then reuse
            probs = classifier(result.orig_img[y1:y2, x1:x2], verbose=False)[0].probs
            labels[track_id] = (classifier.names[probs.top1], round(float(probs.top1conf), 2))

print(f"{frames} frames, {boxes_seen} person boxes, {len(labels)} classifier calls")
print(labels)
11 frames, 33 person boxes, 3 classifier calls
{1: ('basketball', 0.51), 2: ('maillot_(tights)', 0.14), 3: ('bulletproof_vest', 0.23)}ثلاث استدعاءات للمصنّف بدلًا من 33 في مقطع من 11 إطارًا؛ وفي بث طويل، تزداد الوفورات مع كل إطار يبقى فيه الشخص ظاهرًا. وما تزال التسميات مجرد تخمينات من ImageNet — استبدل المصنّف المضبوط بدقة، وستصبح الإجابة الخاصة بكل شخص.
صنّف مرة واحدة لكل مسار عندما يتعذر تغير السمة أثناء ظهور الجسم (نوع الخوذة، طراز المركبة، رمز المنتج). وأعِد التصنيف كل N إطارًا عندما تكون السمة قابلة للتغير (باب مفتوح، يد مرفوعة). وإذا كانت المشاهدات الأولى صغيرة وضبابية عادةً، فصنّف الإطار الذي يكون فيه صندوق المسار أكبر ما يمكن.
الوضعية مع التتبع#
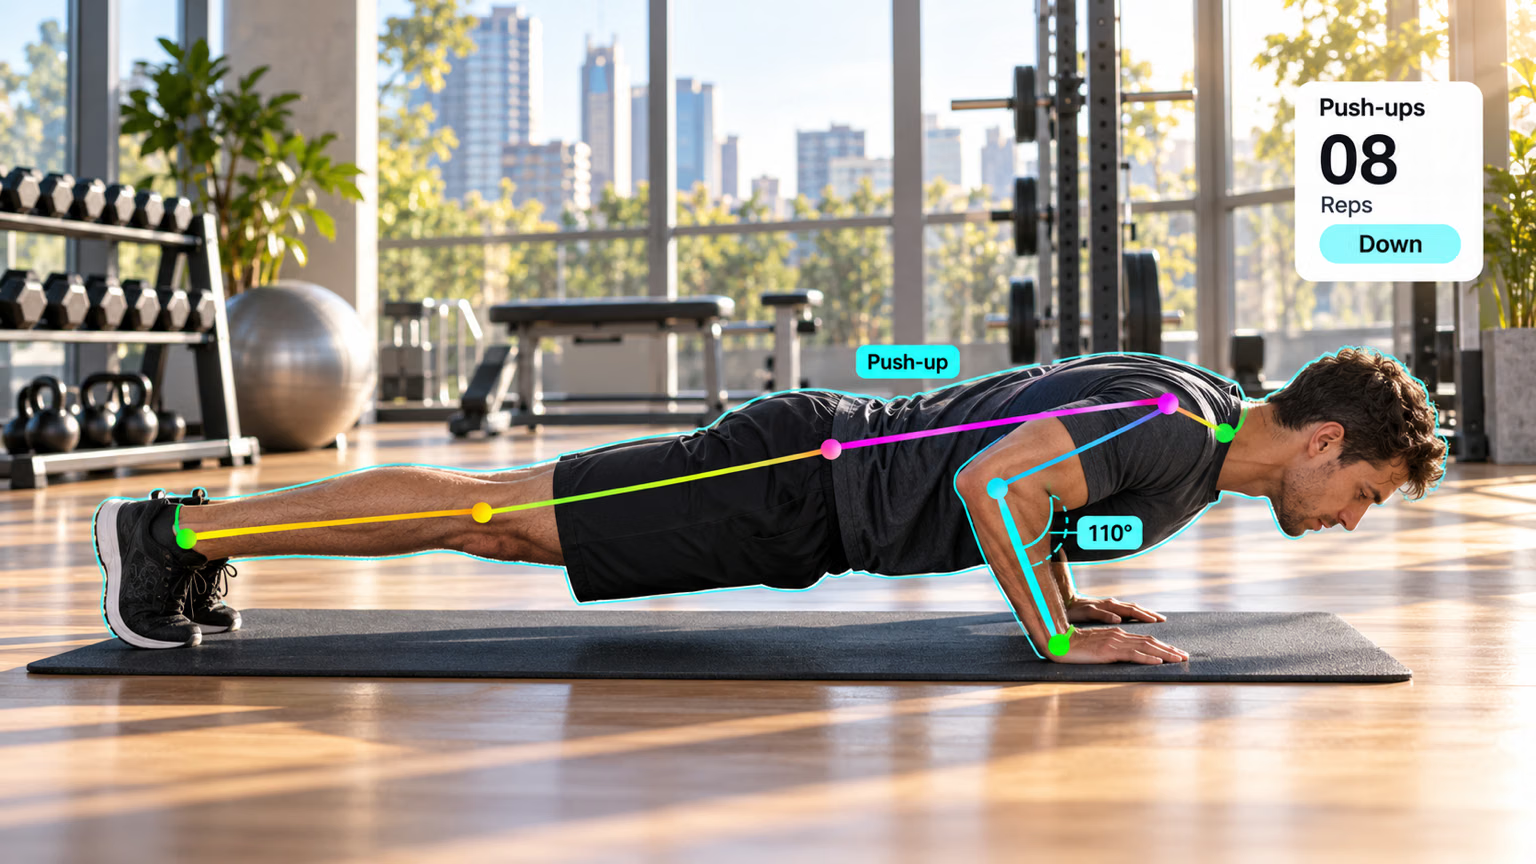
يضيف وضع التتبع result.boxes.id مستمرًا لكل شخص، فتتحول النقاط المفتاحية إلى سلسلة زمنية. يسجّل هذا السكربت زاوية الركبة اليسرى لكل شخص عبر المقطع القصير نفسه:
from collections import defaultdict

import numpy as np

from ultralytics import YOLO

def angle(a, b, c):
    """Angle at b, in degrees, formed by points a-b-c."""
    ba, bc = a - b, c - b
    return np.degrees(np.arccos(np.dot(ba, bc) / (np.linalg.norm(ba) * np.linalg.norm(bc))))

model = YOLO("yolo26n-pose.pt")
source = "https://github.com/ultralytics/assets/releases/download/v0.0.0/decelera_portrait_min.mov"
HIP, KNEE, ANKLE = 11, 13, 15  # left leg, COCO keypoint order
knee_angles = defaultdict(list)  # track id -> knee angle per frame

for result in model.track(source, stream=True, persist=True, verbose=False):
    if result.boxes.id is None:  # no confirmed tracks in this frame
        continue
    kpts = result.keypoints.cpu().numpy()
    for track_id, xy, conf in zip(result.boxes.id.int().tolist(), kpts.xy, kpts.conf):
        if conf[[HIP, KNEE, ANKLE]].min() > 0.5:  # skip occluded legs
            knee_angles[track_id].append(angle(xy[HIP], xy[KNEE], xy[ANKLE]))

for track_id, angles in sorted(knee_angles.items()):
    print(f"id {track_id}: {len(angles)} frames, left knee {min(angles):.0f}-{max(angles):.0f} deg")
id 1: 11 frames, left knee 170-176 deg
id 2: 11 frames, left knee 96-118 deg
id 3: 11 frames, left knee 177-180 degتطابق الركبة المثنية للشخص ذي المعرّف 2 وضعية الشخص الجالس في المقطع؛ أما الشخصان الآخران فيقفان بساقين مستقيمتين تقاربان 180°. ومن هنا، يكون عدّ التكرارات عملية عبور العتبات في سلسلة كل معرّف — نزولًا إلى ما دون زاوية، ثم صعودًا فوق زاوية أخرى — وهذا ما يوفّره لك حل مراقبة التمارين.
تقدير تكلفة سلسلة المعالجة#
| عامل التكلفة | الكشف ثم التصنيف | الوضعية مع التتبع |
|---|---|---|
| يتناسب مع | الكائنات في كل إطار | الإطارات |
| العامل الأهم | اقتطع دفعات من الصور؛ وصنّف مرة واحدة لكل معرّف مسار وخزّن النتيجة مؤقتًا. | خفّض imgsz أو vid_stride عندما تكون الحركة بطيئة. |
| نمط الإخفاق | يرى المصنّف اقتطاعات تختلف عن بيانات تدريبه. | تؤدي تبديلات المعرّف إلى تقسيم سجل الشخص الواحد إلى جزأين. |
العَرَض: يُعاد ضبط عدّاد التكرار في منتصف المجموعة، أو يظهر شخص واحد بمعرّفين. السبب: فقد المتعقّب الشخص (بسبب الاحتجاب أو استدارة سريعة) وأسند إليه معرّفًا جديدًا. الحل: اضبط المتعقّب كما في دورة الإنتاج، واجعل المنطق المعتمد على كل معرّف يتحمل الانقطاعات القصيرة — إذ يُعاد ببساطة احتساب تسمية المصنّف المخزّنة مؤقتًا للمعرّف الجديد.
عرض الحل
أضف save_crop=True إلى استدعاء الكاشف:
result = detector("https://ultralytics.com/images/bus.jpg", conf=0.5, save_crop=True)[0]تظهر الاقتطاعات ضمن runs/detect/predict*/crops/person/ وcrops/bus/ (يزداد رقم مجلد التشغيل مع كل عملية تنبؤ). أتاح التخزين المؤقت لكل مسار إجراء 3 استدعاءات للمصنّف لـ 33 مربعًا للأشخاص، أي توفير 30 استدعاءً في مقطع من 11 إطارًا.
لحساب عدد زوايا الركبة، استبدل الحلقة الأخيرة في pose_track.py:
for track_id, angles in sorted(knee_angles.items()):
    bent = sum(a < 120 for a in angles)
    print(f"id {track_id}: {len(angles)} frames, {bent} with knee below 120 deg")
id 1: 11 frames, 0 with knee below 120 deg
id 2: 11 frames, 11 with knee below 120 deg
id 3: 11 frames, 0 with knee below 120 degالشخص الجالس ذو المعرّف 2 لديه زاوية تقل عن 120° في الإطارات الـ11 جميعها؛ أما المعرّفان 1 و3 فلا يحدث ذلك معهما مطلقًا.