التجزئة الدلالية: تصنيف كل بكسل
تنبأ بخريطة فئات لكل بكسل باستخدام yolo26n-sem.pt، وحوّلها إلى قيم للتغطية، وأنشئ مجموعات بيانات لخرائط الفئات بصيغة PNG، واقرأ mIoU دون أن تنخدع بدقة البكسل.
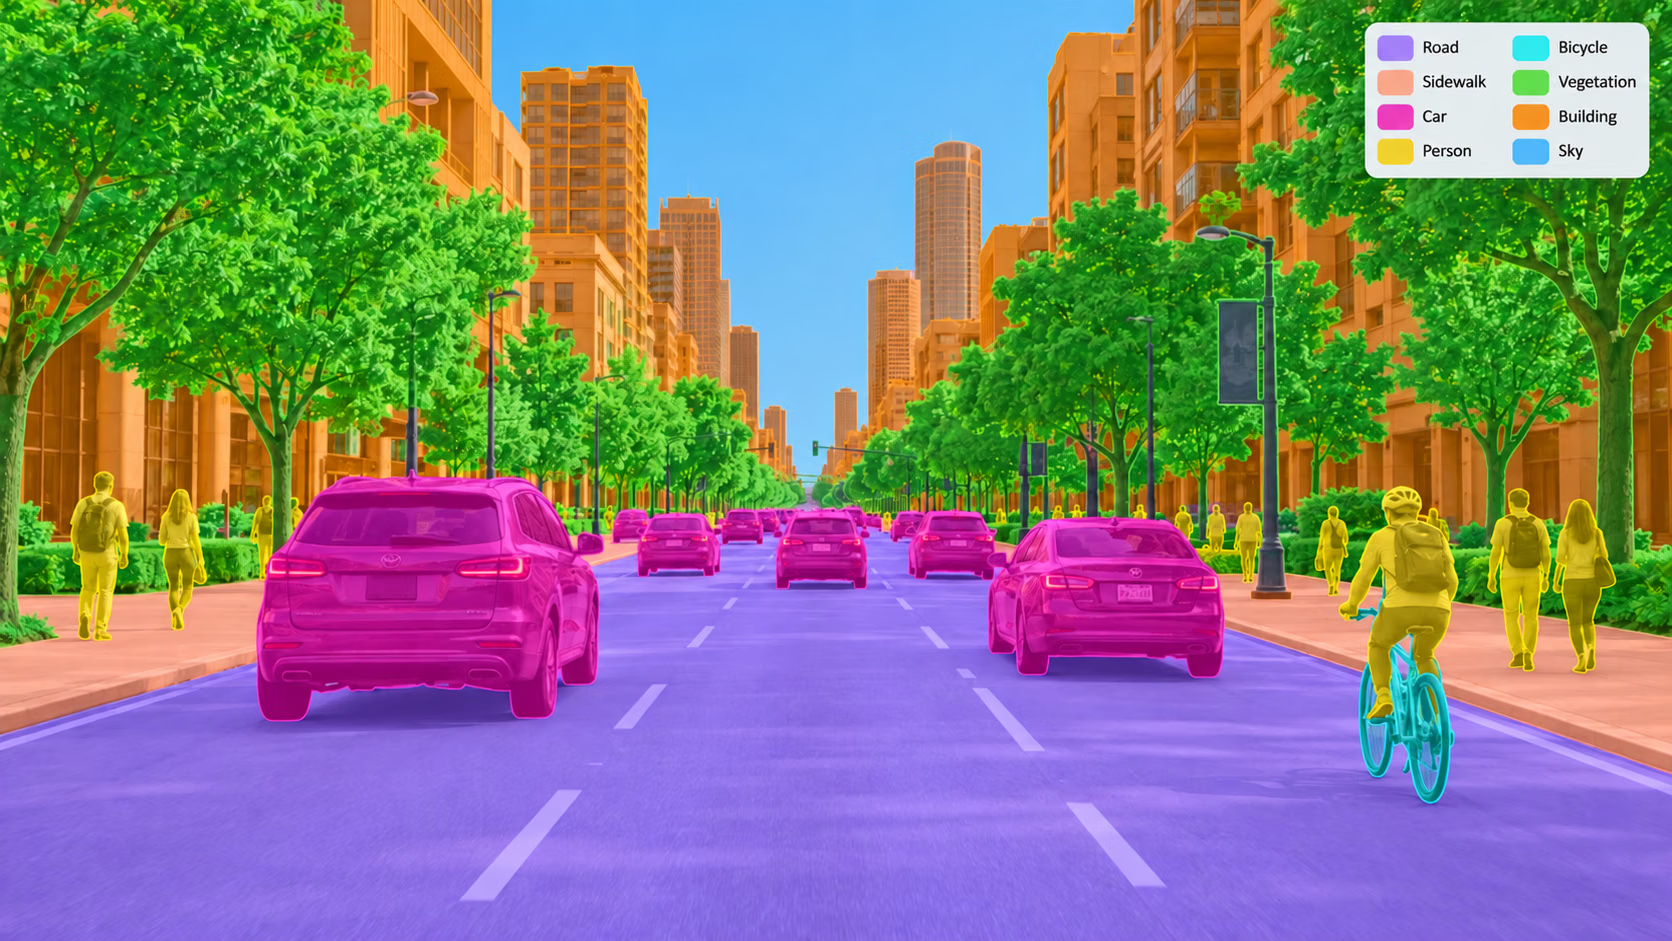
لا تتطلب بعض الأسئلة عدّ الأجسام: ما مقدار الرصيف المحجوب، وما مقدار الأعشاب الضارة في الحقل، وأين ينتهي الطريق القابل للقيادة؟ تجيب التجزئة الدلالية عن هذه الأسئلة بإسناد معرّف فئة واحد إلى كل بكسل. لكن من السهل إساءة فهم مقياسها الأبرز: يحقق النموذج الذي تدرّبه في هذا الدرس دقة بكسل تبلغ 91% من دون أن يعثر على شخص واحد.
عملي
تجزئة الأجسام أم التجزئة الدلالية؟#
تجزئة الحالات (segment) | التجزئة الدلالية (semantic) | |
|---|---|---|
| المخرجات | قناع واحد لكل جسم، بالإضافة إلى صندوق | معرّف فئة واحد لكل بكسل |
| يحصي الأجسام | نعم | لا — فالسيارتان المتلامستان تُعدّان منطقة واحدة من فئة «سيارة» |
| يتعامل مع «الأشياء الممتدة» (الطريق والسماء والعشب) | بشكل ضعيف — لا توجد حالات طبيعية | نعم |
| التسميات | مضلعات | خرائط فئات PNG أو مضلعات |
| مقياس القبول | mAP50-95 للقناع | mIoU |
| الأوزان المدرّبة مسبقًا | yolo26n-seg.pt (COCO، 80 فئة) | yolo26n-sem.pt (Cityscapes، 19 فئة) |
إذا كان السؤال اللاحق «كم عددها»، فاستخدم تقسيم المثيلات. وإذا كان السؤال «ما مقدارها» أو «أين»، فالتقسيم الدلالي أسهل في وضع التسميات وقراءة النتائج. تتضمن صفحة مهمة التقسيم الدلالي جدول النماذج.
تنبأ بخريطة فئات#
result.semantic_mask.data موتر H × W بالحجم الأصلي للصورة؛ كل قيمة فيه معرّف فئة، وتعني القيمة 255 التجاهل. يحوّل result.summary() الخريطة إلى نسب بكسلات لكل فئة:
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")  # Cityscapes, 19 classes
result = model("https://ultralytics.com/images/bus.jpg")[0]

class_map = result.semantic_mask.data  # H x W tensor of class ids, 255 = ignore
print("class map:", tuple(class_map.shape), class_map.dtype)
for row in result.summary():
    if row["pixel_ratio"] >= 0.02:
        print(f"{row['name']:12s} {row['pixel_ratio']:.1%}")
class map: (1080, 810) torch.uint8
road 27.5%
sidewalk 2.0%
building 19.3%
vegetation 4.5%
person 14.6%
train 30.9%انظر إلى الصف الأخير. لدى Cityscapes فئة bus، ومع ذلك يصنّف النموذج الحافلة على أنها train. تعلّم النموذج من لقطات صُوّرت من سيارات، ومعظمها لشوارع ألمانية، وتقع الحافلة المصوّرة عن قرب من الرصيف خارج هذا التوزيع. ترث النماذج الدلالية منظور مجموعة تدريبها وتعريفات فئاتها — أي تحيز مجموعة البيانات — بصرامة أكبر من نماذج الكشف، لذا ينبغي ضبط النموذج بدقة على كاميرتك قبل الوثوق بالخريطة.
حوّل خريطة الفئات إلى إجابة#
تتحول خريطة الفئات إلى قيمة مفيدة للمنتج عبر مقارنات موترات بسيطة. إليك سؤالًا من نوع «ما نسبة المنطقة التي قد يسير فيها أحد المشاة والتي تشغلها الطرق أو الأرصفة، وما نسبتها التي يشغلها الناس؟»:
from ultralytics import YOLO

result = YOLO("yolo26n-sem.pt")("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
class_map = result.semantic_mask.data  # H x W class ids at the original size, 255 = ignore
ids = {name: i for i, name in result.names.items()}

h = class_map.shape[0]
lower = class_map[h // 2 :]  # the half of the frame a pedestrian would walk into
walkable = (lower == ids["road"]) | (lower == ids["sidewalk"])
people = lower == ids["person"]
print(f"lower half: {walkable.float().mean():.0%} road or sidewalk, {people.float().mean():.0%} person")
result.save("semantic_overlay.jpg")  # colored class map over the photo, for a visual check
lower half: 59% road or sidewalk, 23% personثمة ثلاث عادات تجعل هذه الأرقام جديرة بالثقة:
- ابحث عن المعرّفات حسب الاسم من
result.names، ولا تستخدم أرقامًا ثابتة في الشيفرة مطلقًا؛ فالنموذج المدرّب على فئاتك الخاصة سيستخدم ترقيمًا مختلفًا. - احصر التحليل في المنطقة المهمة. تمزج النسب المحسوبة على الإطار بأكمله بين السماء والمباني؛ لذا اقتطع خريطة الفئات (أو اضربها في قناع منطقة) أولًا.
- افتح طبقة التراكب. يعرض
semantic_overlay.jpgبنظرة واحدة ما إذا كان «الطريق» الذي تحتسبه القيمة طريقًا بالفعل.
تنسيق مجموعة البيانات#
تقرن مجموعات البيانات الدلالية كل صورة بصورة قناع أحادية القناة، تكون قيم بكسلاتها معرّفات فئات. يُعد دليل مجموعة البيانات الدلالية المرجع؛ ويحاكي التخطيط بنية images/ ملفًا بملف:
cityscapes8/
├── images/
│   ├── train/aachen_000000_000019.png
│   └── val/aachen_000004_000019.png
└── masks/
    ├── train/aachen_000000_000019.png
    └── val/aachen_000004_000019.png
يضيف YAML المفتاح masks_dir، وكتلة label_mapping عند اختلاف المعرّفات المخزنة في الأقنعة عن معرّفات التدريب:
path: cityscapes8
train: images/train
val: images/val
masks_dir: masks # semantic mask directory

names:
  0: road
  1: sidewalk
  # ... 19 classes in total

label_mapping: # raw mask value -> training id
  0: ignore_label
  7: 0 # road
  8: 1 # sidewalk
  # ...
تخزّن أقنعة Cityscapes معرّفات التسميات الخام من -1 إلى 33؛ ويحتفظ التخطيط بـ19 منها، ويوجّه البقية إلى ignore_label المخزّن بالقيمة 255. تُستبعد البكسلات المضبوطة على 255 من الخسارة والمقاييس معًا؛ لذا استخدم القيمة نفسها للمناطق التي لم يستطع المعلّقون تحديدها.
إذا كانت لديك تسميات مضلعات بالفعل ولم يكن لديك masks_dir، فسيحوّل المحمّل المضلعات إلى صورة نقطية نيابةً عنك، ويضيف فئة background للبكسلات غير المغطاة.
يمزج الضغط الفاقد قيم البكسلات المتجاورة، فيحوّل الحد بين الفئتين 7 و8 إلى لطخة من قيم 7 و8 ومعرّفات غير موجودة. احفظ كل قناع بصيغة PNG أو TIFF.
التدريب وقراءة mIoU#
تضم Cityscapes8 ثماني صور لمشاهد حضرية، أربعًا للتدريب وأربعًا للتحقق، وهي كافية لاختبار أولي باستخدام CPU:
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")
model.train(data="cityscapes8.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"mIoU: {metrics.miou:.3f}  pixel accuracy: {metrics.pixel_accuracy:.3f}")
Class Images Pixels mIoU PixAcc
all 4 192315 0.415 0.906
road 4 78529 0.974 0.996
vegetation 4 37602 0.844 0.936
person 3 722 0 0
rider 1 21 0 0
mIoU: 0.415 pixel accuracy: 0.906(حُذفت بعض صفوف الفئات.) تشير الدقة على مستوى البكسل إلى 91%؛ ويبلغ mIoU نسبة 42%؛ وتُظهر صفوف الفئات أن النموذج لم يعثر على أي شخص. والنتائج الثلاث كلها صحيحة. تستحوذ الطرق والمباني والنباتات على معظم البكسلات — فالطرق وحدها تشغل 78,529 من أصل 192,315 — لذا يحقق النموذج الذي يصنّفها جيدًا دقة عالية على مستوى البكسل رغم إخفاقه في جميع الفئات الصغيرة. يحسب mIoU متوسط IoU للفئات بأوزان متساوية، لذا تخفض كل فئة فائتة قيمته.

اشترط حدًا أدنى لـ mIoU ولـ IoU الفئات التي يعتمد عليها منتجك. تفشل ميزة سلامة المشاة إذا كانت قيمة IoU للأشخاص 0، مهما كانت دقة البكسلات.
عرض الحل
في تشغيلنا: بلغ mIoU مقدار 0.415، ودقة البكسل 0.906، وكانت IoU تساوي صفرًا لفئات الجدار والشخص والراكب والدراجة النارية والدراجة، إضافةً إلى كل فئة لا تحتوي على بكسلات في صور التحقق الأربع.
دقة البكسل أعلى لأنها تحصي البكسلات، وتشغل الطرق والمباني والنباتات والسماء معظم مساحة كل إطار في Cityscapes. أما mIoU فيمنح كل فئة وزنًا متساويًا، لذا تخفض خمس فئات صغيرة فائتة المتوسط رغم أنها لا تشغل سوى بضع مئات من البكسلات. يفشل هذا النموذج في اجتياز شرط الاعتماد الخاص بمنتج يتخذ إجراءات تتعلق بالأشخاص، وذلك بسبب قيمة IoU فئة الأشخاص وحدها.