اختر المهمة وخطّط لخط الأنابيب
اربط كل سؤال متعلق بالمنتج بإحدى مهام Ultralytics YOLO السبع، وحدد أوزانها وحقل النتيجة وتنسيق التسميات ومقياس القبول، ثم أثبت صلاحية الخطة بتشغيل كل مهمة على صورة واحدة.
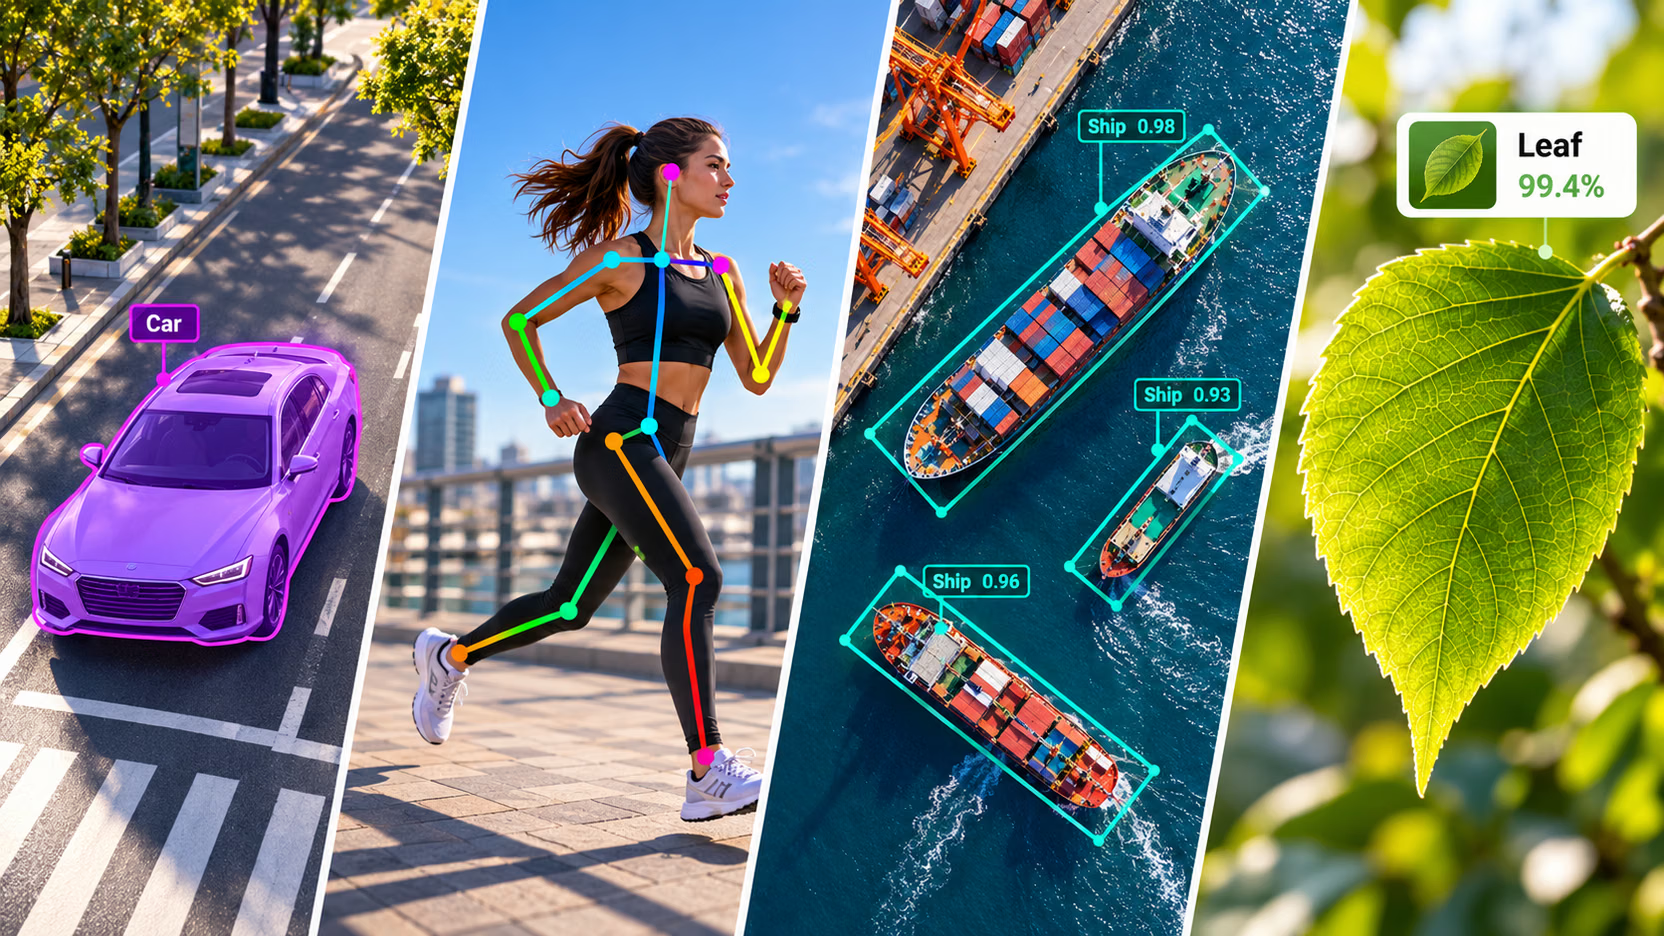
بعد إطلاق كاشف، نادرًا ما تكون الطلبات التالية «مزيدًا من الصناديق». بل تكون مثل «ما مساحة الانسكاب؟» و«هل ظهر العامل منحنٍ؟» و«إلى أي جهة تتجه السفينة؟» و«هل هذا الجزء تالف؟». في صورة الشارع المستخدمة طوال هذه الدورة، يشغل صندوق إحاطة الحافلة 48% من الإطار، بينما تشغل الحافلة نفسها 29%، لذا ستكون الإجابة المستندة إلى مساحة الصندوق أكبر من الحقيقة بأكثر من النصف. تحدد المهمة التي تختارها تنسيق التسميات، لذا فإن اختيارها قبل أن يبدأ أي شخص بوضع التسميات هو القرار الأقل تكلفة في المشروع؛ فتغييرها لاحقًا يعني إعادة وضع التسميات.
عملي
صورة واحدة، وأربع إجابات مختلفة#

اطرح سؤالًا واحدًا عن صورة واحدة — ما مقدار الإطار الذي تشغله الحافلة، وما بُعدها؟ — ودع أربع مهام من Ultralytics YOLO تجيب عنه:
from ultralytics import YOLO

image = "https://ultralytics.com/images/bus.jpg"
det = YOLO("yolo26n.pt")(image, verbose=False)[0]
seg = YOLO("yolo26n-seg.pt")(image, retina_masks=True, verbose=False)[0]
sem = YOLO("yolo26n-sem.pt")(image, verbose=False)[0]
depth = YOLO("yolo26n-depth.pt")(image, verbose=False)[0]
frame = det.orig_shape[0] * det.orig_shape[1]  # pixels in the photo

i = [det.names[int(c)] for c in det.boxes.cls].index("bus")
x1, y1, x2, y2 = det.boxes.xyxy[i].tolist()
print(f"detect    bus box covers   {(x2 - x1) * (y2 - y1) / frame:.1%} of the frame")

i = [seg.names[int(c)] for c in seg.boxes.cls].index("bus")
bus_mask = seg.masks.data[i].bool()  # H x W, True on bus pixels
print(f"segment   bus mask covers  {bus_mask.sum().item() / frame:.1%} of the frame")

ratios = {row["name"]: row["pixel_ratio"] for row in sem.summary()}
print(f"semantic  'train' pixels   {ratios['train']:.1%} of the frame")

meters = depth.depth.data[bus_mask].median().item()  # depth map and mask share the original size
print(f"depth     bus is about     {meters:.1f} m from the camera")
detect bus box covers 47.7% of the frame
segment bus mask covers 29.2% of the frame
semantic 'train' pixels 30.9% of the frame
depth bus is about 4.5 m from the cameraاقرأها سطرًا سطرًا:
- تجيب detect عن سؤال أين؟. ويشمل الصندوق أيضًا الطريق أسفل الحافلة والأشخاص الأربعة الواقفين أمامها، لذا تزيد مساحته عن الحقيقة بنسبة 63%.
- تجيب segment عن سؤال ما الشكل؟. تشغل الحافلة 29.2% من الصورة فعليًا، وهذا هو الرقم الذي ينبغي استخدامه في أي قاعدة تتعلق بالمساحة أو التغطية أو التداخل.
- تجيب semantic عن سؤال أي وحدات بكسل تنتمي إلى أي فئة؟. مساحتها قريبة من مساحة القناع، لكن النموذج يسمّي الحافلة
train: فهو يصنّف الأسطح وفق فئات مجموعة بيانات تدريبه (Cityscapes، الدرس 4)، ولا يفصل مطلقًا بين مركبة وأخرى. - يجيب depth عن سؤال ما بُعدها؟. يبلغ وسيط العمق داخل قناع الحافلة 4.5 m — وقد جُمعت مهمتان للإجابة عن سؤال لا تستطيع أي منهما الإجابة عنه بمفردها.
إذا كانت القيمة التي يعرضها منتجك مساحةً أو نسبة تغطية أو تداخلًا، فالصندوق أداة غير مناسبة. استخدم قناعًا (للكائنات) أو خريطة فئات (للأسطح).
المهام السبع في لمحة#
تتناول أسس الرؤية الحاسوبية بالتفصيل كيفية الاختيار بين المهام — راجع مهام الرؤية السبع إذا لم يكن الاختيار واضحًا. وهذا ملخص عملي لبقية الدورة. كل صف يمثل مهمة تدعمها حزمة ultralytics المثبّتة للتدريب والتحقق والتنبؤ والتصدير عبر واجهة API نفسها؛ أما نظرة عامة على المهام فهي المرجع الكامل.
| السؤال الذي تجيب عنه المخرجات | المهمة | أوزان YOLO26 | حقل النتيجة | تنسيق التسميات | مقياس القبول |
|---|---|---|---|---|---|
| أين يوجد كل كائن؟ | detect | yolo26n.pt | boxes | الفئة + الصندوق | mAP50-95 للصندوق |
| ما الشكل والمساحة الدقيقان لكل كائن؟ | segment | yolo26n-seg.pt | masks + boxes | الفئة + المضلع | mAP50-95 للقناع |
| إلى أي فئة تنتمي كل وحدة بكسل؟ | semantic | yolo26n-sem.pt | semantic_mask | خريطة فئات PNG أو مضلعات | mIoU |
| أين توجد المفاصل أو المعالم؟ | pose | yolo26n-pose.pt | keypoints + boxes | الفئة + الصندوق + النقاط المفتاحية | mAP50-95 للوضعيات (OKS) |
| كيف يكون دوران كل كائن؟ | obb | yolo26n-obb.pt | obb | الفئة + الزوايا الأربع | mAP50-95 لـ OBB |
| ما محتوى هذه الصورة كاملة (أو القصاصة)؟ | classify | yolo26n-cls.pt | probs | مجلد واحد لكل فئة | دقة top-1 |
| ما بُعد كل وحدة بكسل عن الكاميرا؟ | depth | yolo26n-depth.pt | depth | خريطة عمق لكل صورة (PNG بعمق 16 بت أو NPY) | δ1 (delta1) |
أنت تطلق الصف الأول بالفعل. تعلّمك الدروس من 2 إلى 8 الصفوف الخمسة الوسطى، ثم تربط الدروس 9 و10 هذه الصفوف وتطلقها. أما الصف الأخير، وهو تقدير العمق أحادي العين، فيقدّر مسافةً بالأمتار لكل بكسل في صورة واحدة. تُستمد تسمياته من مستشعرات العمق أو محركات التصيير 3D، لا من القائمين على التوسيم، ولذلك له تنسيق مجموعة بيانات خاص به؛ وتتناوله هذه الدورة في كل موضع يكون فيه سير العمل مشتركًا: هذه الخطة، وحلقة التحقق، وفحص التصدير في الدرس الأخير.
اختر سؤالًا واحدًا في كل مرة#
اتبع الأسئلة بالترتيب وتوقف عند أول إجابة بنعم:
يغطي المخطط الحالات الشائعة. وتغطي أربع قواعد ترجيح معظم الحالات الأخرى:
| إذا كان الطلب… | فاختر | لأن |
|---|---|---|
| يتطلب عددًا ومساحة («كم عدد الانسكابات، وما حجمها؟») | segment | تدمج التجزئة الدلالية الكائنات المتلامسة في منطقة واحدة |
| يتعلق بكائنات طويلة ورفيعة متراصة جنبًا إلى جنب، كما تُرى من الأعلى | obb | تتداخل الصناديق المحاذية للمحاور، ويُسقط NMS كائنات صحيحة، حتى إن لم تقرأ الزاوية مطلقًا |
| يتطلب تحديد الأمام مقابل الخلف، أو اليسار مقابل اليمين | pose | يوفر OBB محورًا، لا اتجاهًا |
| تظهر فيه صورة واحدة لكل عنصر بالتصميم (محطة فحص ثابتة) | classify | أقل التسميات تكلفةً وأسرع نموذج |
تُحدَّد المهمة عند إنشاء مجموعة البيانات — وفي Ultralytics Platform يكون ذلك عبر حقل Task Type في مربع حوار مجموعة البيانات الجديدة — لذا يأتي هذا الاختيار قبل أول تسمية:

واجهة API واحدة، وحقول نتائج سبعة#
تستخدم كل مهمة الاستدعاء نفسه؛ إذ يقرأ النموذج مهمته من ملف الأوزان. وما يتغير هو حقل النتيجة الذي تُملأ قيمته، وهذا هو الحقل الذي سيقرأه الكود:
from ultralytics import YOLO

WEIGHTS = ["yolo26n.pt", "yolo26n-seg.pt", "yolo26n-sem.pt", "yolo26n-pose.pt", "yolo26n-obb.pt", "yolo26n-cls.pt", "yolo26n-depth.pt"]
FIELDS = ("boxes", "masks", "semantic_mask", "keypoints", "obb", "probs", "depth")

for weights in WEIGHTS:
    model = YOLO(weights)
    result = model("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
    fields = [f for f in FIELDS if getattr(result, f) is not None]
    print(f"{weights:17s} task={model.task:9s} fields={fields}")
yolo26n.pt task=detect fields=['boxes']
yolo26n-seg.pt task=segment fields=['boxes', 'masks']
yolo26n-sem.pt task=semantic fields=['semantic_mask']
yolo26n-pose.pt task=pose fields=['boxes', 'keypoints']
yolo26n-obb.pt task=obb fields=['obb']
yolo26n-cls.pt task=classify fields=['probs']
yolo26n-depth.pt task=depth fields=['depth']تحتفظ نتائج التجزئة والوضعيات بـ boxes، لذا يستمر كود الكشف الموجود لديك في العمل معها. أما نتائج التصنيف والتجزئة الدلالية والعمق فتصف الصورة بأكملها ولا تحتوي على حقول لكل كائن.
يتوقف كود الكشف الذي يكرّر على result.boxes مع TypeError: 'NoneType' object is not iterable عند استخدام نموذج OBB: تكون result.boxes هي None، ولا توجد الاكتشافات المدارة إلا في result.obb. انقل كود الكشف إلى OBB بقراءة result.obb، بدلًا من التحقق من None والحصول على صفر من الاكتشافات.
عندما لا يكفي نموذج واحد#
تتخذ معظم أنظمة الإنتاج التي تتجاوز الكشف أحد ثلاثة أشكال:
- الكشف ثم التصنيف. يعثر الكاشف على الكائنات الصغيرة في إطار كبير؛ ويصدر مصنّف الصور حكمًا دقيقًا على كل قصاصة كاملة الدقة: نوع الخوذة، أو درجة العيب، أو رمز SKU للمنتج.
- الوضعيات مع التتبّع. تصف النقاط المفتاحية إطارًا واحدًا؛ ويحوّلها المتعقّب إلى سلسلة زمنية لكل شخص، يمكن استخدامها لعدّ التكرارات أو اكتشاف السقوط.
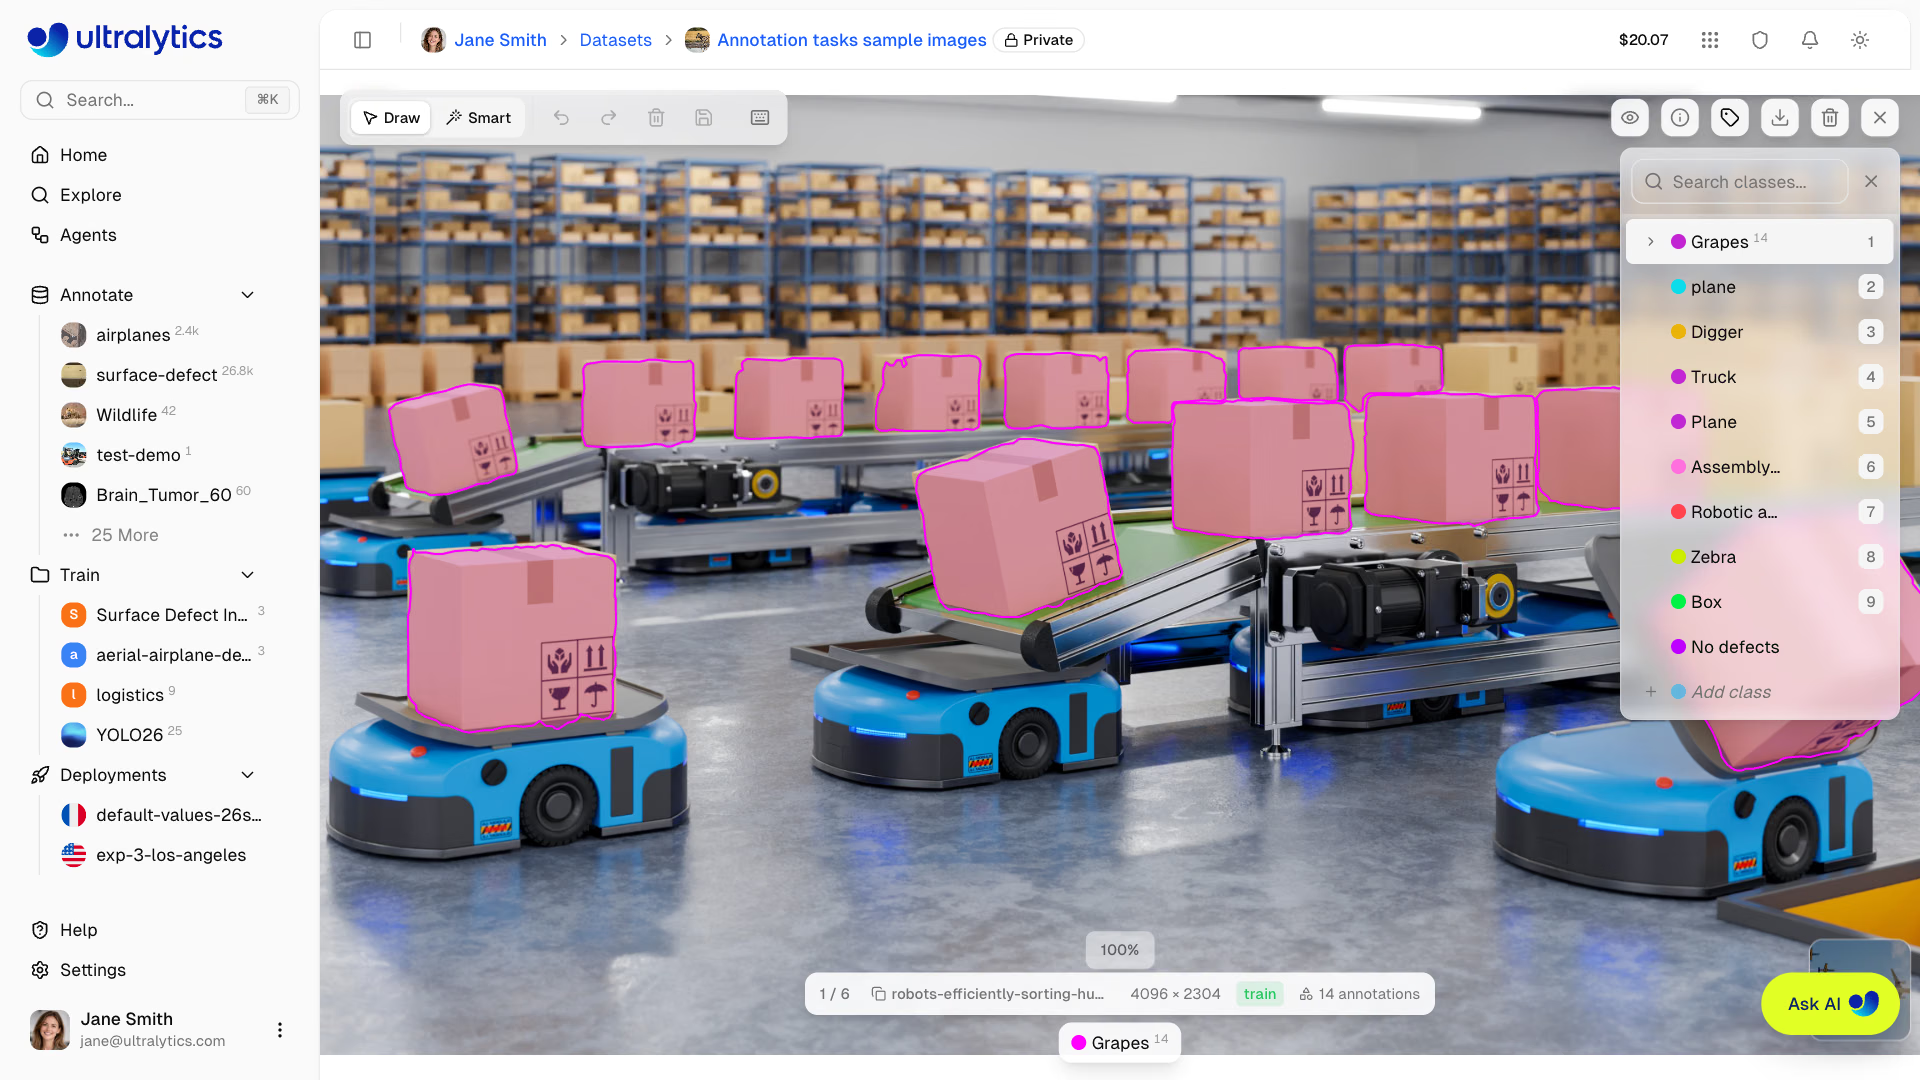
- التجزئة ثم القياس. يعيد النموذج وحدات البكسل؛ ويحوّلها كود عادي إلى مساحات أو عروض أو نسب تغطية أو مسافات (مع العمق).
تتألف التسميات التي تقف وراء خط أنابيب التجزئة ثم القياس من مضلع واحد لكل كائن، مثل هذه الطرود على روبوتات المستودع في محرر Ultralytics Platform:
يضيف النموذج الثاني زمن استدلال، ومجموعة بيانات ثانية لوضع التسميات وصيانتها، ونموذجًا ثانيًا لمراقبته. لا تربط النماذج إلا عندما تعجز مهمة واحدة عن الإجابة؛ فخطة من نموذج واحد يمكنك نشرها أفضل من خطة من ثلاثة نماذج لا يمكنك وضع التسميات لها.
مواطن الخلل#
العَرَض: يضع الفريق تسميات للمضلعات لأن الأقنعة تبدو رائعة في العرض التوضيحي، ثم لا يقرأ المنتج سوى عدد. الحل: قبل وضع التسميات، حدّد سطر الكود الذي يستهلك المخرجات. إذا لم يقرأ شيء الحدود الخارجية، فانشر كاشفًا: فالصناديق أسرع في وضع التسميات وأسرع في التشغيل.
العَرَض: بعد شهر من وضع التسميات، يلاحظ أحدهم أن المنتج يحتاج إلى اتجاه، بينما تحتوي مجموعة البيانات على تسميات OBB لا تعطي إلا محورًا. الحل: اكتب السمة الدقيقة في الخطة (result.masks.xy وresult.keypoints.xy وresult.obb.xywhr) وشغّل tasks.py باستخدام الأوزان التي اخترتها قبل وضع أول تسمية.
العَرَض: يخطئ مصنّف يحقق 95% على صور منتجات نظيفة في معظم قصاصات الكاشف ضمن الإنتاج. الحل: أنشئ مجموعة بيانات المرحلة الثانية من القصاصات التي ينتجها الكاشف في المرحلة الأولى، مع ضبابيتها وتأطيرها الفعليين؛ ويوضح الدرس 9 الطريقة.
عرض الحل
بالنسبة إلى طلب المنصات:
| الصف | الخيار |
|---|---|
| السؤال | هل يتجاوز أي جزء من المنصة خط عارضة الرف؟ |
| المهمة | segment — يعتمد تحديد التجاوز على مخطط المنصة؛ كما أن صندوقها يشمل الفجوة تحت المنصة والحمولة فوقها |
| الأوزان | yolo26n-seg.pt، مضبوط بدقة على إطارات من كاميرات المستودع |
| تنسيق التسميات | مضلع واحد لكل منصة |
| حقل النتيجة | result.masks.data مع retina_masks=True (وحدات البكسل التي تتجاوز خط العارضة) |
| مقياس القبول | mAP50-95 للقناع على كاميرا مستبعدة من التدريب |
| المرحلة الثانية | لا شيء — خط الحزمة ثابت لكل كاميرا، لذا فهو إعداد وليس نموذجًا |
تتكون قاعدة البروز بعد ذلك من ثلاثة أسطر برمجية: ارسم خط الحزمة مرة واحدة لكل كاميرا، واحسب وحدات البكسل للقناع الواقعة على جانبه الخاطئ، وأطلق تنبيهًا عند تجاوز عتبة بكسل تضبطها باستخدام بضعة أمثلة معروفة للبروز. يوضح الدرس 3 هذا النوع من الاختبارات بين القناع والمنطقة بالضبط.