تدريب مصنّف صور
نظّم مجموعة بيانات في مجلدات، ودرّب yolo26n-cls.pt على MNIST160، واقرأ الاحتمالات ودقة أفضل فئة، ووجّه التنبؤات منخفضة الثقة إلى المراجعة البشرية.
تجيب مصنّفات الصور عن سؤال واحد لكل صورة: ما هذا؟ وتحتاج إلى أبسط التسميات من بين جميع المهام — اسم مجلد — كما أنها الأسرع تشغيلًا، مما يجعلها المرحلة الثانية الافتراضية بعد الكاشف، والنموذج الأول المناسب لمحطة فحص ترى قطعة واحدة في كل إطار. لا تتضمن مجموعة بياناتها ملف YAML، لذا يكون هيكل المجلدات هو المرجع، ويعطي المصنّف دائمًا إجابة، حتى للصور التي لم يرَ شيئًا يشبهها من قبل. وتحديد الحالات التي لا ينبغي الوثوق فيها بالإجابة يشكّل نصف المهمة.
عملي
هيكل مجموعة البيانات المعتمدة على المجلدات#
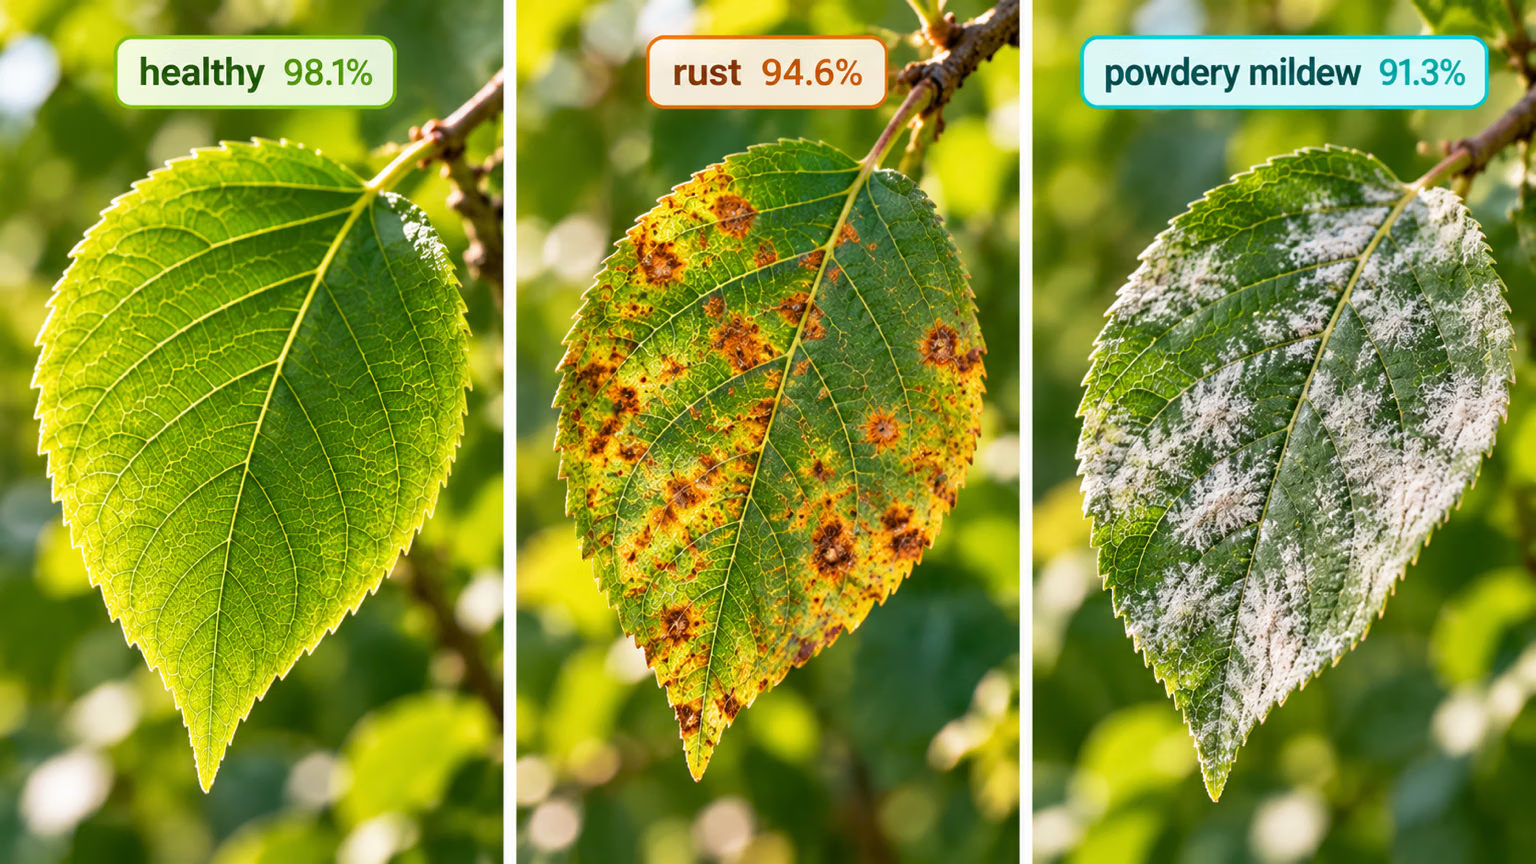
مجموعات بيانات التصنيف عبارة عن مجلدات، لا ملفات YAML. وجّه data= إلى المجلد الجذر:
parts/
├── train/
│   ├── good/      img_0001.jpg ...
│   ├── scratch/   img_0412.jpg ...
│   └── dent/      img_0733.jpg ...
└── val/
    ├── good/
    ├── scratch/
    └── dent/
إليك ما يفعله المحمّل بها، وفقًا للمصدر المثبت ودليل مجموعة بيانات التصنيف:
| الحالة | السلوك |
|---|---|
| فهارس الفئات | أسماء المجلدات داخل train/، مرتبة أبجديًا → dent=0، وgood=1، وscratch=2 |
| مجلد التحقق من الصحة | val/، ثم validation/، ثم valid/؛ ويعود إلى test/ مع إصدار تحذير |
لا يوجد مجلد train/، بل مجلدات الفئات فقط | يقسم البيانات تلقائيًا بنسبة 80/20 إلى train/ وval/ |
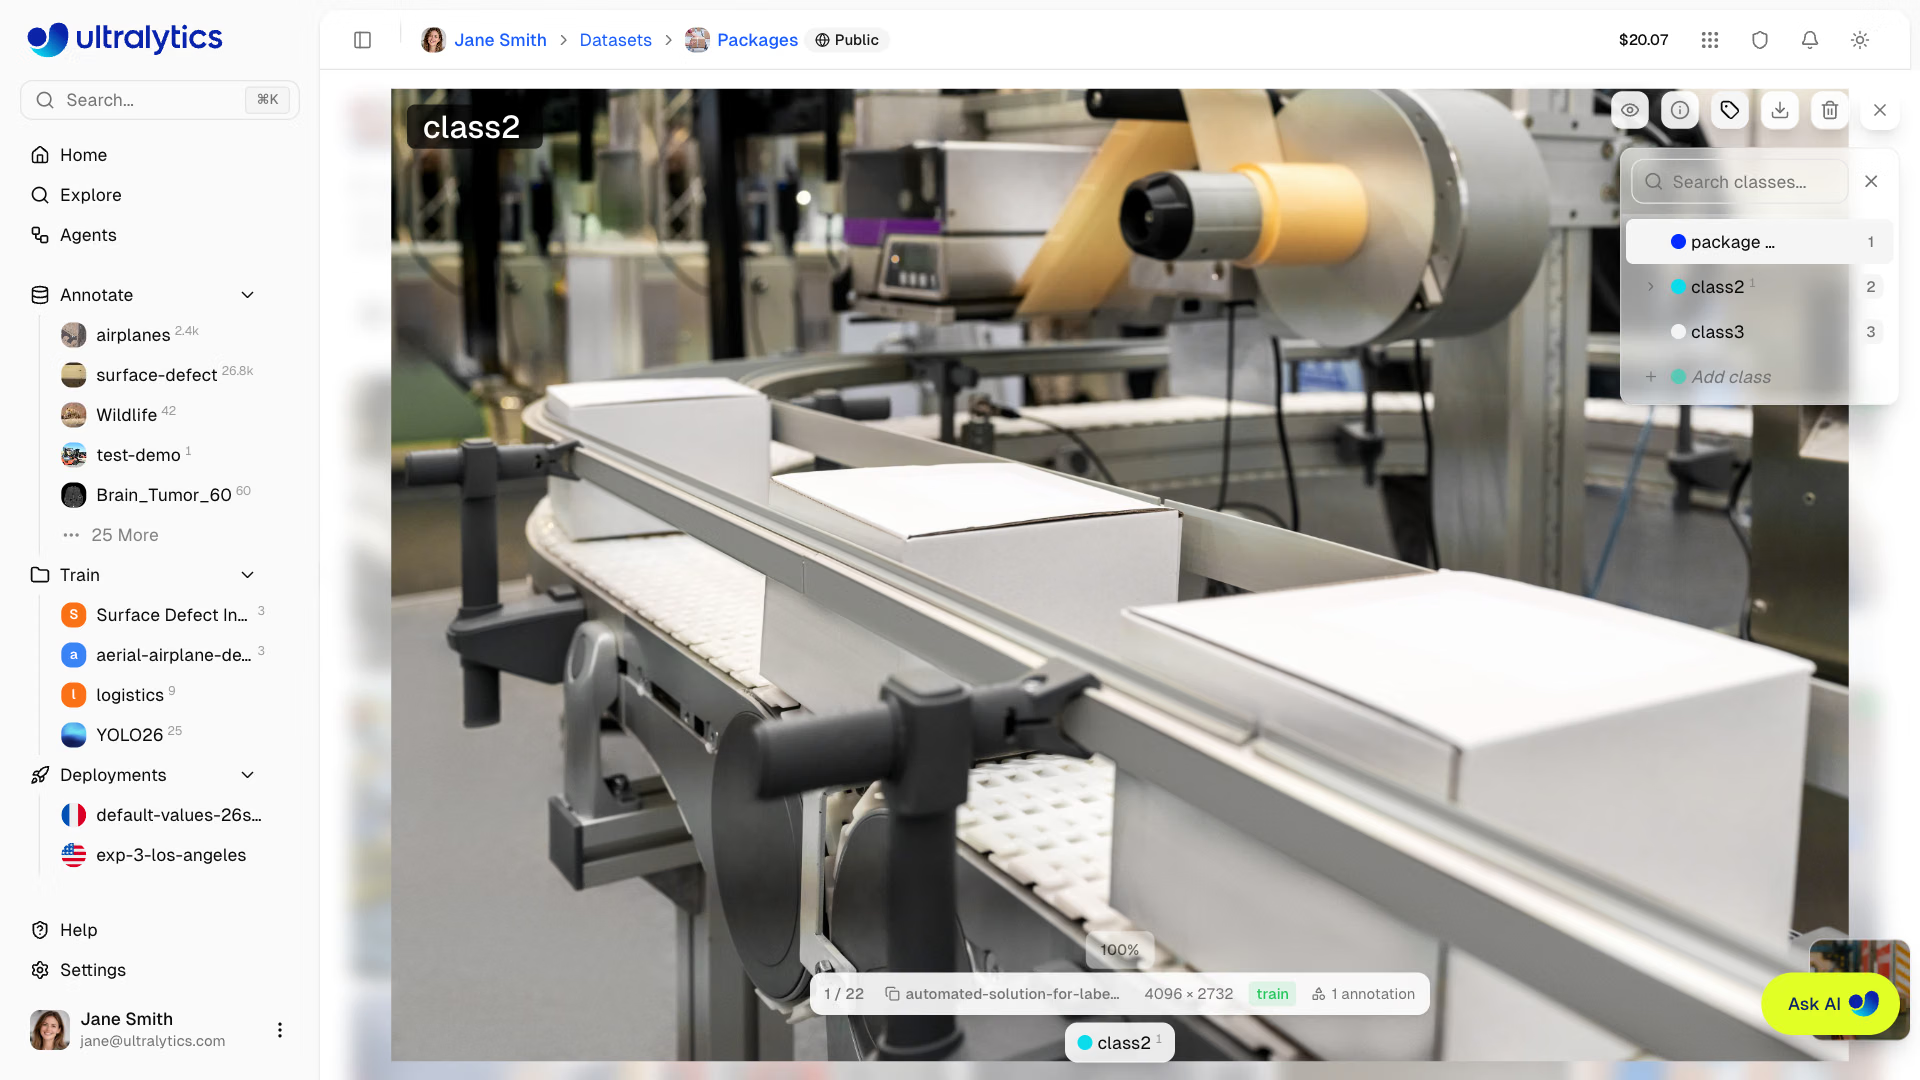
على منصة Ultralytics، تحتوي مجموعة بيانات التصنيف على تسمية واحدة على مستوى الصورة لكل صورة بدلًا من الأشكال:
العَرَض: بعد إضافة فئة، يعرض تكامل قديم أجزاء good على أنها dent. السبب: تؤدي إضافة مجلد باسم bent إلى ترتيبه أولًا، فتتغير جميع الفهارس التي تليه. الحل: اربط الفهارس دائمًا بالأسماء باستخدام model.names (أو result.names)؛ ولا تثبّت فهرسًا في الشيفرة أبدًا.
التدريب على MNIST160#
تتضمن MNIST160 160 رقمًا مكتوبًا بخط اليد، 80 في train/ و80 في test/، مقسمة كل مجموعة منها إلى عشرة مجلدات للأرقام — وهي صغيرة بما يكفي لاختبار دخاني على CPU. ولا تحتوي على مجلد val/، لذا راقب تحذير المحمّل عند عودته إلى test/:
from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")
model.train(data="mnist160", epochs=1, imgsz=64, device="cpu")
metrics = model.val()
print(f"top-1: {metrics.top1:.3f}  top-5: {metrics.top5:.3f}")
WARNING ⚠️ Dataset 'split=val' not found, using 'split=test' instead.
val: .../datasets/mnist160/test... found 80 images in 10 classes ✅
all 0.162 0.463
top-1: 0.162 top-5: 0.463لا يحقق عصر واحد تحسنًا يُذكر في الرأس الجديد ذي الفئات العشر. في تجربتنا، بلغ epochs=10 دقة أفضل فئة قدرها 0.55 ودقة أفضل خمس فئات قدرها 0.95 خلال نحو عشر ثوانٍ على CPU حاسوب محمول — حلقة التدريب تعمل، لكنها تحتاج إلى جدول تدريب. يسرد دليل مهمة التصنيف أحجام النماذج المدربة مسبقًا.
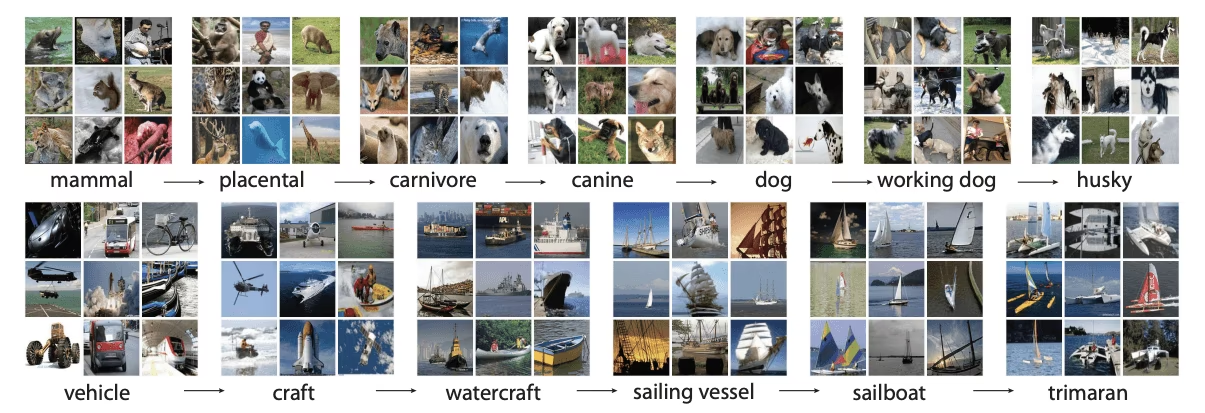
أفضل فئة هي نسبة الصور التي تكون فيها الفئة الأعلى احتمالًا صحيحة. أما أفضل خمس فئات فتحسب النتيجة إصابةً إذا كانت الفئة الصحيحة ضمن الفئات الخمس الأعلى. وتفيد دقة أفضل خمس فئات في ImageNet ذات الفئات الألف، التي تتدرج فئاتها من العامة إلى شديدة التخصص؛ أما إذا كان عدد الفئات خمسًا أو أقل فتكون الدقة دائمًا 1.0، وإذا كان العدد عشرة فهي متساهلة. اعتمد على الدقة لأفضل فئة، إلى جانب مصفوفة الالتباس لكل فئة.
قراءة الاحتمالات في الكود#
from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")  # ImageNet, 1,000 classes
result = model("https://ultralytics.com/images/bus.jpg")[0]

probs = result.probs
print(f"top-1: {result.names[probs.top1]} ({float(probs.top1conf):.2f})")
for i, conf in zip(probs.top5, probs.top5conf.tolist()):
    print(f"  {result.names[i]:20s} {conf:.3f}")
top-1: minibus (0.52)
minibus 0.516
police_van 0.369
trolleybus 0.096
minivan 0.006
ambulance 0.003probs.top1 فهرس، وprobs.top5 قائمة فهارس، وprobs.data متجه الاحتمالات الكامل. لاحظ ثقة أفضل فئة: 0.52، وهي بالكاد تتجاوز احتمالًا متساويًا بين minibus وpolice_van. هذه هي القيمة التي تستخدمها للتوجيه.
توجيه التنبؤات غير المؤكدة إلى شخص#
نادرًا ما يحتاج المصنّف في بيئة الإنتاج إلى أن يصيب في كل صورة؛ بل يحتاج إلى أن يصيب في الصور التي يقرر بشأنها بمفرده. يدرّب هذا السكربت النموذج لعشرة عصور، ثم يقيس أثر عتبات الثقة المختلفة على الأرقام الثمانين المحجوزة للاختبار:
from pathlib import Path

from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")
model.train(data="mnist160", epochs=10, imgsz=64, device="cpu", plots=False)  # model now holds best.pt
print(model.names)  # folder names, sorted, became class indices

test = Path(model.trainer.data["test"])  # mnist160/test, the split the loader validated on
images = sorted(test.rglob("*.png"))
results = model(images, imgsz=64, verbose=False)
truth = [p.parent.name for p in images]

for threshold in (0.0, 0.3, 0.6):
    kept = [(r, t) for r, t in zip(results, truth) if r.probs.top1conf >= threshold]
    correct = sum(r.names[r.probs.top1] == t for r, t in kept)
    print(f"threshold {threshold:.1f}: auto-accept {len(kept):2d}/{len(images)}, accuracy on accepted {correct / max(len(kept), 1):.0%}")
{0: '0', 1: '1', 2: '2', 3: '3', 4: '4', 5: '5', 6: '6', 7: '7', 8: '8', 9: '9'}
threshold 0.0: auto-accept 80/80, accuracy on accepted 55%
threshold 0.3: auto-accept 41/80, accuracy on accepted 68%
threshold 0.6: auto-accept 10/80, accuracy on accepted 80%يمثل كل صف مقايضة: رفع العتبة يجعل التنبؤات المقبولة أدق، ويُحيل مزيدًا من الصور إلى شخص لمراجعتها. عند 0.6، لا يقرر هذا النموذج بمفرده إلا في 10 من أصل 80 رقمًا — لذا فهو غير جاهز لأتمتة أي شيء، والحل هو مزيد من التدريب، لا عتبة أذكى. أعد تشغيل الجدول نفسه بعد كل جولة تدريب: فهو يوضح لك الدقة التي ستحصل عليها ومقدار عمل المراجعة الذي ستسببه كل عتبة بالتحديد.
اختر أدنى عتبة تحقق الدقة المطلوبة على الصور المقبولة، وقِس ذلك على بيانات محجوبة. ثم تحقق من أن فريقك قادر على التعامل مع حجم المراجعات الناتج؛ وإن لم يكن كذلك، فحسّن النموذج.
مواطن الخلل#
العَرَض: تحصل محطة فارغة أو قطعة خاطئة أو يد تغطي العدسة على تسمية فئة بدرجة ثقة عالية. السبب: مجموع احتمالات softmax يساوي دائمًا 1، لذا يختار المصنّف إحدى فئاته دائمًا. الحل: أضف مجلد other/ لا يحتوي إلا على هذه الصور، ووجّه التنبؤات ذات top1conf المنخفضة إلى المراجعة.
العَرَض: يحقق نموذج مدرّب مسبقًا درجة تقارب الصفر على مجموعة بياناتك قبل أي تدريب. السبب: يتنبأ yolo26n-cls.pt بفهارس ImageNet البالغ عددها 1,000، بينما تعيد مجلداتك استخدام الفهارس 0–9 بمعانٍ مختلفة: في MNIST160، يكون المجلد 0 ذا الفهرس 0، وهو ما يسميه الرأس المدرّب مسبقًا tench. وقد قسنا قيمة top-1 مقدارها 0.000 بهذه الطريقة. الحل: أجرِ الضبط الدقيق أولًا، ثم تحقّق من النموذج.
العَرَض: قيمة top-1 تقارب 1.0 أثناء التحقق، لكنها أقل بكثير في بيئة الإنتاج. السبب: وجود صور شبه متطابقة للقطعة نفسها في train/ وval/. الحل: قسّم البيانات حسب القطعة أو الجلسة، كما هو موضح في تقسيم مجموعة البيانات على نحو صحيح.
تُدرّب المصنّفات مسبقًا على imgsz=224، لا على 640. وتناسب الأجسام الصغيرة داخل إطار كبير طريقة الكشف ثم التصنيف (الدرس التالي) أكثر من استخدام imgsz أكبر.
عرض الحل
from ultralytics import YOLO

for epochs in (1, 10):
    model = YOLO("yolo26n-cls.pt")
    model.train(data="mnist160", epochs=epochs, imgsz=64, device="cpu")
    metrics = model.val()
    print(f"{epochs:2d} epochs  top-1: {metrics.top1:.3f}  top-5: {metrics.top5:.3f}")
print(model.names)  # {0: '0', 1: '1', ..., 9: '9'}
نتائجنا: عصر واحد → دقة أفضل فئة 0.162، ودقة أفضل خمس فئات 0.463؛ عشرة عصور → دقة أفضل فئة 0.550، ودقة أفضل خمس فئات 0.950. مع خمس فئات، تكون الإجابة الصحيحة دائمًا ضمن أفضل خمس فئات، لذا تبلغ دقتها 1.0 بحكم التصميم ولا تخبرك بأي شيء.
لتحقيق دقة 75% على الصور المقبولة، يشير route.py إلى عتبة 0.6 (دقة 80% على 10 صور مقبولة)، ما يعني إحالة 70 رقمًا من أصل 80 إلى المراجعة. هذه هي الإجابة الصريحة: تحقق العتبة شرط الدقة، لكن النموذج ليس مفيدًا بعد. درّب مدة أطول وأعد تشغيل الجدول قبل اختيار عتبة للاستخدام الفعلي.