ضبط التكلفة وزمن الاستجابة
حلّل أداء مسار المعالجة كاملًا، وطبّق الإجراءات التي تُحدث فرقًا فعليًا في زمن الاستجابة والتكلفة بالترتيب، وتوقف عند بلوغ الميزانية المحددة.
تقضي الفرق أسابيع في تقليص أجزاء من الثانية من زمن النموذج، بينما يكون عنق الزجاجة الحقيقي كتابةً في قاعدة البيانات أو مفكك ترميز RTSP. الإجراءات المؤثرة قليلة ويمكن قياسها جيدًا: يستغرق YOLO26s على CPU مدة أطول بمقدار 2.2 مرة من YOLO26n مقابل زيادة قدرها 7.7 نقطة mAP، كما أن تشغيل الكشف على إطار من كل إطارين يخفض العمل إلى النصف. يعلّمك هذا الدرس تحليل الأداء أولًا، وتطبيق أكبر إجراء مناسب، والتوقف عند الميزانية التي تحددها مسبقًا.
عملي
حلّل أداء مسار المعالجة كاملًا أولًا#
يقسّم كل كائن Results زمنه إلى مراحل:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
totals = {"preprocess": 0.0, "inference": 0.0, "postprocess": 0.0}
for n, r in enumerate(model.predict(video, stream=True, verbose=False), 1):
    for stage in totals:
        totals[stage] += r.speed[stage]
print({stage: round(ms / n, 1) for stage, ms in totals.items()}, "ms per frame")
{'preprocess': 0.7, 'inference': 36.1, 'postprocess': 0.7} ms per frameيشكّل الاستدلال هنا 95% من زمن النموذج، لذا ستفيد إجراءات تحسين النموذج. قِس زمن فك الترميز والمخرجات الخاصة بك بالطريقة نفسها (باستخدام time.perf_counter() حول كل منها)، ثم طبّق القاعدة المناسبة لما تجده:
| ما تقيسه | ما ينبغي إصلاحه أولًا |
|---|---|
| 60 مللي ثانية لفك ترميز RTSP، و5 مللي ثوانٍ للاستدلال | فك الترميز بالعتاد، أو خفض دقة البث، أو زيادة عدد خيوط مفكك الترميز |
| 30 مللي ثانية للاستدلال، و100 مللي ثانية للمعالجة اللاحقة في Python | استخدم المعالجة المتجهة مع NumPy أو انقلها إلى عملية عامل |
| 5 مللي ثوانٍ للاستدلال، و200 مللي ثانية لكتابة قاعدة البيانات | اجمع عمليات الكتابة في دفعات أو نفّذها بشكل غير متزامن |
| الاستدلال هو العامل المهيمن | قائمة الإجراءات الأبرز أدناه |
قائمة الإجراءات الأبرز#
جرّب الإجراءات بدءًا من الأعلى وتوقف عند بلوغ الميزانية:
| وسيلة التحسين | مقدار التسريع المعتاد | تكلفة الدقة المعتادة |
|---|---|---|
| نموذج أصغر (m ← s، s ← n) | 1.5–2.5× | 4.5–7.7 نقطة mAP على COCO؛ أقل في المهام محدودة النطاق |
imgsz أصغر (640 ← 480) | نحو 1.8× | تتأثر الأجسام الصغيرة والبعيدة أولًا |
| بيئة تشغيل أسرع، وFP16 | نحو 1.5× على GPU | لا شيء عادةً؛ تحقّق من التكافؤ |
| INT8 مع المعايرة | زيادة أخرى بمقدار 1.2× على GPU؛ وحتى 2.9× على CPU | نقطة واحدة (YOLO26n) إلى 4–6 نقاط (النماذج الأكبر)؛ تستعيد QAT معظمها |
عدد إطارات أقل (vid_stride=N) | حتى N× | قد لا تُكتشف الأجسام السريعة والأحداث القصيرة |
| دفعة أكبر (للخوادم) | معدل نقل أعلى، لا زمن استجابة أقل | لا شيء |
تستند الأرقام إلى جداول قياس الأداء الخاصة بـYOLO26 وTensorRT وOpenVINO، وإلى القياسات أدناه؛ وستختلف نتائجك، لذا قِس الأداء.
نموذج أصغر#
جدول قياس أداء YOLO26 على COCO:
| النموذج | mAP50-95 | زمن CPU ONNX (مللي ثانية) | زمن T4 TensorRT10 (مللي ثانية) |
|---|---|---|---|
| YOLO26n | 40.9 | 38.9 | 1.7 |
| YOLO26s | 48.6 | 87.2 | 2.5 |
| YOLO26m | 53.1 | 220.0 | 4.7 |
على CPU، تكون كل خطوة إلى نموذج أصغر أسرع بمقدار 2.2–2.5×. وتمثل فجوة الدقة على COCO أسوأ الحالات: فعادةً ما يخسر كاشف مستودع بثلاث فئات وأجسام كبيرة مقدارًا أقل بكثير عند الانتقال من m إلى n مقارنةً بكاشف عام ذي 80 فئة، لذا يجدر دائمًا اختبار النموذج الأصغر على مجموعة التحقق الخاصة بك.
مدخلات أصغر#
يتناسب الحساب تقريبًا مع عدد البكسلات، لذا يحتاج imgsz=480 إلى نحو 56% من العمل المطلوب عند 640. القياس أُجري على CPU الحاسوب المحمول المستخدم للاختبار مع ONNX Runtime وبحجم دفعة 1 (الوسيط لـ25 تشغيلًا على bus.jpg):
| النموذج | 640 | 480 | 320 |
|---|---|---|---|
| YOLO26n | 21.3 ms | 12.1 ms | 7.1 ms |
| YOLO26s | 55.0 ms | 24.2 ms | 12.9 ms |
قاعدة القرار: إذا ظل أصغر جسم مهم لديك يشغل نحو 10 بكسلات أو أكثر بالحجم الجديد، فجرّب ذلك؛ أما إذا كانت الأجسام صغيرة أو بعيدة (كالطائرات المسيّرة والرفوف البعيدة عن الكاميرا)، فأبقِ الدقة كما هي وصغّر النموذج بدلًا من ذلك.
إطارات أقل#
إذا كان الاستدلال يحد من معدل الإطارات وكان المشهد يتحرك ببطء، فشغّل الكشف على كل إطار رقم N باستخدام vid_stride=N، ودع متعقّب الأجسام يملأ الفجوات:
import time

from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
model.predict(video, vid_stride=30, verbose=False)  # warm up so the first timing is fair

for stride in (1, 2, 3):
    start, ids, frames = time.perf_counter(), set(), 0
    for r in model.track(video, stream=True, vid_stride=stride, tracker="bytetrack.yaml", classes=[0], verbose=False):
        frames += 1
        if r.boxes.is_track:
            ids.update(r.boxes.id.int().tolist())
    print(f"vid_stride={stride}: {frames} frames in {time.perf_counter() - start:.2f} s, {len(ids)} person IDs")
vid_stride=1: 62 frames in 2.66 s, 32 person IDs
vid_stride=2: 31 frames in 1.19 s, 30 person IDs
vid_stride=3: 20 frames in 0.95 s, 28 person IDsتستهلك معالجة نصف الإطارات نحو نصف الوقت، وتمكّن متعقّب الأجسام من الاحتفاظ بـ30 هوية من أصل 32. وعند vid_stride=3 فقد 4 هويات، وهذا مؤشر على التوقف عند هذا الحد في مشهد يتحرك بسرعة المشي.
خفّض التكلفة السحابية#
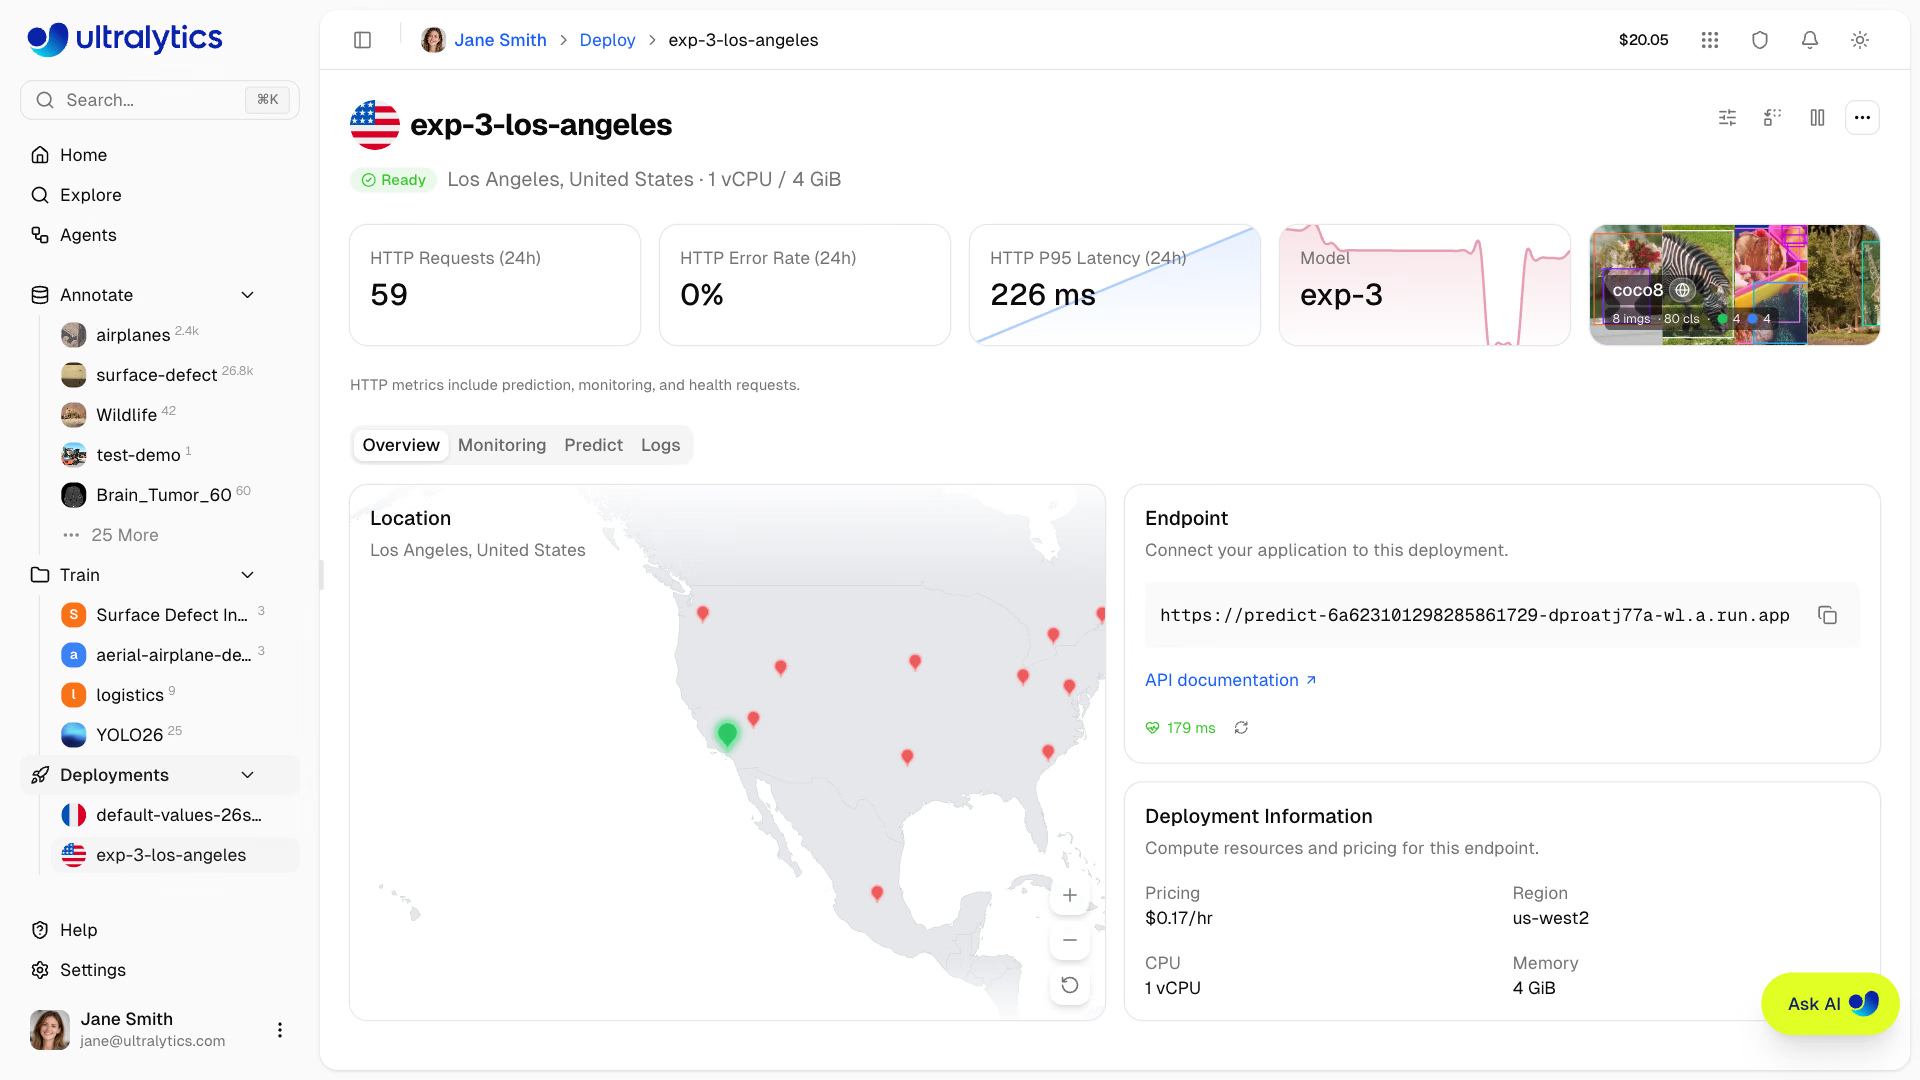
التكلفة هي ساعات تشغيل المثيل مقسومة على العمل المفيد. تعرض بطاقة كهذه الرقمين اللذين تحتاج إليهما: تكلفة الساعة (0.17 دولار مقابل 1 vCPU و4 GiB هنا)، وحجم العمل المنجز (59 طلبًا خلال 24 ساعة بزمن استجابة P95 يبلغ 226 مللي ثانية، أي إن نقطة النهاية خاملة في معظم الوقت). ثم:
- ارفع معدل الاستخدام. إن تشغيل GPU بمعدل استخدام 30% يهدر 70% من تكلفته. اجمع التدفقات في دفعات (كما في الدروس السابقة) أو قدّم الخدمة عبر Triton Inference Server.
- اختر الحجم المناسب. اختبر الأداء على GPU أصغر، أو على CPU باستخدام OpenVINO، قبل افتراض حاجتك إلى GPU كبير.
- استخدم السعة الفورية أو القابلة للإيقاف للمهام الدفعية. تتحمل إعادة معالجة الفيديو المؤرشف الانقطاعات؛ أما التدفقات المباشرة فلا تتحملها.
مواطن الخلل#
العَرَض: وفّر أسبوعان من الضبط 10 ms، وما زال النظام بطيئًا. الحل: حلّل أداء خط المعالجة كاملًا أولًا، وأصلح أكبر مراحله، أيًا كانت.
العَرَض: لا يوفّر if i % 2: continue داخل حلقة النتائج أي شيء. الحل: سبق للنموذج أن عالج ذلك الإطار؛ فتخطَّ الإطارات من المصدر باستخدام vid_stride.
العَرَض: ارتفع معدل النقل، لكن وصول كل إطار أصبح أبطأ. الحل: تزيد الدفعات الأكبر معدل النقل لكل دولار، لا سرعة الإطار الواحد؛ استخدمها مع تدفقات كثيرة أو مهام غير متصلة، لا مع كاميرا آنية واحدة.
عندما تستنفد وسائل تحسين النموذج، تكون البيانات الأفضل هي الخطوة التالية. تتيح مجموعة بيانات تطابق بيئة الإنتاج لنموذج أصغر بلوغ الدقة التي احتاج إليها نموذج أكبر: خفض في التكلفة من دون خسارة في الدقة.
عرض الحل
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on macOS and Windows
    data, img = "coco8.yaml", "https://ultralytics.com/images/bus.jpg"  # use your val YAML and a production frame
    for weights, imgsz in (("yolo26s.pt", 640), ("yolo26n.pt", 640), ("yolo26n.pt", 480)):
        model = YOLO(weights)
        runs = [model(img, imgsz=imgsz, verbose=False)[0].speed["inference"] for _ in range(20)][5:]
        m = model.val(data=data, imgsz=imgsz, batch=1, plots=False, verbose=False).box.map
        print(f"{weights} imgsz={imgsz}: {sorted(runs)[len(runs) // 2]:.1f} ms, mAP50-95 {m:.3f}")
يُسقط كل صف أول خمس عمليات تشغيل باعتبارها فترة إحماء، ويعرض وسيط بقية العمليات. اختر أول صف يحقق ميزانية زمن الاستجابة مع خسارة mAP ضمن الحد الذي حددته. مثال على ميزانية عملية: «يومان، وبحد أقصى نقطة واحدة من mAP، و20 FPS على جهاز المتجر». إذا لم يحقق yolo26s عند 640 زمنًا قدره 50 ms لكل إطار، بينما حققه yolo26n عند 640 مع خسارة لا تتجاوز نقطة واحدة على مجموعة التحقق، فتوقف عند ذلك؛ ولا تقضِ اليوم الثاني على 480.