التحسين باستخدام TensorRT
أنشئ محرك TensorRT بدقة FP16، وحدد ما إذا كانت INT8 تستحق كلفتها من حيث الدقة، واجتز المحرك بوابة التحقق قبل شحنه.
على وحدة GPU من NVIDIA، يكون محرك TensorRT بدقة FP16 عادةً أرخص مكسب في السرعة ستحصل عليه على الإطلاق: أسرع بنحو 1.5× في معيار Ultralytics على A100، دون أي تغيير في mAP. تحقق INT8 سرعة أكبر، لكن استخدام INT8 بعد التدريب خفّض mAP لطرازي YOLO26s إلى YOLO26m بمقدار 4 إلى 6 نقاط على COCO. يعلّمك هذا الدرس تحديد الخطوة التي تنفذها وقياس أثرها قبل أن يفعل المستخدمون ذلك.
عملي
يتطلب الكود في هذا الدرس GPU من NVIDIA مثبتًا عليه TensorRT. جميع الوسائط المعروضة مُدرجة لـ format=engine في وثائق وضع التصدير.
FP16 هي الخطوة الأولى الآمنة#
تحتوي وحدات GPU من NVIDIA، بدءًا من Volta، على أنوية موتر FP16، ونادرًا ما تحتاج نماذج الكشف إلى FP32 وقت الاستدلال. ابدأ هنا:
from ultralytics import YOLO
model = YOLO("yolo26n.pt") # or runs/detect/pills_v1/weights/best.pt
model.export(format="engine", quantize=16, workspace=4) # محرك FP16، ومساحة عمل للباني تصل إلى 4 GiBيحدّ workspace من ذاكرة GPU التي يمكن لـ TensorRT استخدامها أثناء الإنشاء؛ اتركه دون تعيين ليحدد TensorRT ذلك. تنشر صفحة تكامل TensorRT نتيجة A100 هذه (YOLOv8n، 640 بكسل):
| الدقة | التنبؤ، الدفعة 8 (مللي ثانية) | mAP50-95 لمجموعة تحقق COCO |
|---|---|---|
| FP32 | 0.52 | 0.37 |
| FP16 | 0.34 | 0.37 |
| INT8 | 0.28 | 0.33 |
النموذج أقدم من YOLO26، لكن شكل المقايضة يظل كما هو: كانت FP16 أسرع بنحو 1.5× دون تكلفة؛ أما INT8 فحققت سرعة إضافية قدرها 1.2× مقابل خسارة 4 نقاط. إذا حققت FP16 ميزانيتك، فاشحنها.
لا تملك وحدة GPU محلية من NVIDIA؟ تنشئ علامة التبويب Export في منصة Ultralytics المحرك على وحدة GPU سحابية تختارها، مع خيارات حجم الصورة والدقة والدفعة والديناميكية وNMS ومساحة العمل نفسها:

اختر عائلة وحدات GPU التي ستنشر عليها: أُنشئ المحرك الظاهر في لقطة الشاشة على RTX 5090، ولن يعمل إلا على تلك العائلة.
تتطلب INT8 بيانات معايرة#
تعيّن آلية التكميم في INT8 تنشيطات كل طبقة إلى 256 مستوى. لاختيار هذه النطاقات، يمرر المُصدِّر صور المعايرة عبر النموذج ويسجل التنشيطات التي يرصدها؛ لذلك يجب أن تشبه الصور بيانات الإنتاج:
from ultralytics import YOLO
model = YOLO("yolo26n.pt")
model.export(
format="engine",
quantize=8,
data="coco128.yaml", # تأتي صور المعايرة من قسم التحقق في مجموعة البيانات هذه؛ استخدم my_dataset/data.yaml
fraction=1.0, # حصة هذه الصور التي ينبغي استخدامها (أو عددها)
batch=8, # تؤدي دفعات المعايرة الأكبر إلى نطاقات أكثر استقرارًا
dynamic=True, # عند batch=8، يقبل المحرك دفعات من 1 إلى 8
workspace=4,
)تختلف كلفة INT8 باختلاف النموذج. قاست وثائق وضع التصدير محركات YOLO26 TensorRT على قسم التحقق من COCO (mAP50-95):
| النموذج | محرك FP32 | INT8، مع المعايرة (PTQ) | INT8 بعد التدريب المدرك للتكميم (QAT) |
|---|---|---|---|
| YOLO26n | 0.4032 | 0.3934 | 0.3935 |
| YOLO26s | 0.4794 | 0.4412 | 0.4711 |
| YOLO26m | 0.5269 | 0.4696 | 0.5137 |
تؤدي المعايرة وحدها إلى خسارة YOLO26n نقطة واحدة، والنماذج الأكبر 4–6 نقاط. يضبط QAT النموذج بدقة باستخدام quantize=8 في train كي تتحمل أوزانه INT8؛ فتحتفظ نقطة التحقق بنطاقاتها الخاصة، ولا يحتاج تصدير INT8 إلى بيانات معايرة، ويكون فارقه عن FP32 نقطة إلى نقطتين. القرار:
اجتز المحرك بوابة التحقق قبل شحنه#
اجتز كل محرك الاختبارات نفسها على وحدة GPU المستهدفة للنشر:
| الفحص | معيار التحقق |
|---|---|
| mAP50-95 على مجموعة التحقق الخاصة بك | ضمن 0.5 نقطة من FP32 عند استخدام FP16؛ أو ضمن ميزانيتك المكتوبة لـ INT8 |
| AP لكل فئة | ألا تتراجع أي فئة بأكثر من نقطة واحدة تقريبًا (تتباين الفئات الصغيرة أكثر من غيرها) |
| زمن الاستجابة عند p95 | ضمن الميزانية عند حجم دفعة الإنتاج |
| عتبة التشغيل | إعادة اختيار conf من منحنى F1 الخاص بالمحرك نفسه |
| الحتمية | تعطي الصورة نفسها الصناديق نفسها تمامًا عند تمريرها مرتين |
yolo val model=yolo26n.engine data=coco8.yaml  # or my_dataset/data.yaml
yolo benchmark model=yolo26n.pt data=coco8.yaml imgsz=640 format=engine quantize=16
مصدر تسارع الأداء#
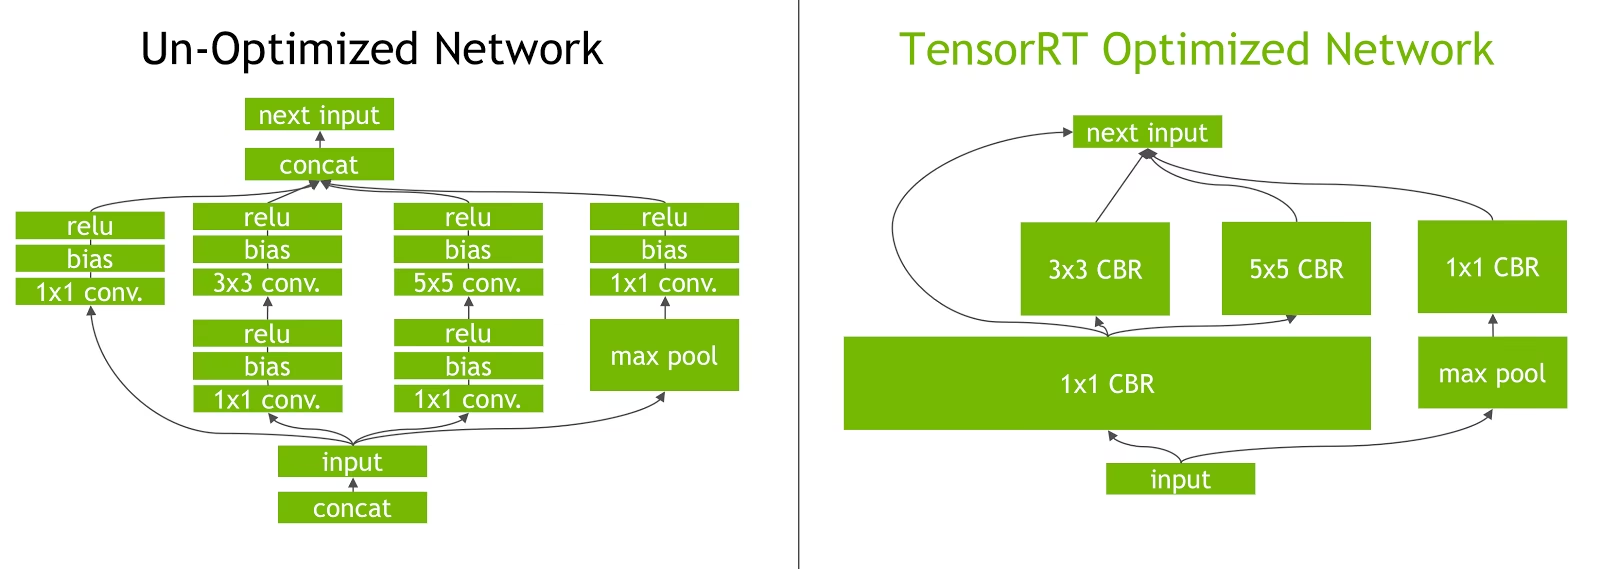
يدمج TensorRT كلًا من الالتفاف والانحياز وReLU في نواة واحدة (كتل «CBR» على اليمين)، ويحذف خطوات الدمج، فتطلق وحدة GPU عددًا أقل بكثير من الأنوية وتنقل بيانات أقل. في YOLO26، يظهر أثر ذلك في سلاسل الالتفاف وBN والتنشيط في أنحاء الشبكة، وكتلة الانتباه (PSA) في العمود الفقري، والعمليات الصغيرة الكثيرة في رأس الكشف. إذا ظل المحرك بطيئًا، فحلل أداءه باستخدام trtexec أو NVIDIA Nsight: غالبًا ما تستغرق طبقة واحدة 30% أو أكثر من الوقت.
مواطن الخلل#
العَرَض: يخسر INT8 نقطة واحدة على COCO وست نقاط على كاميراتك. الحل: عاير باستخدام جزء محجوب من مجموعة التحقق الخاصة بك؛ وتوصي NVIDIA بما لا يقل عن 500 صورة تمثيلية. تختلف المعايرة أيضًا بين الأجهزة، لذا أجرِ المعايرة على GPU الذي ستنشر عليه.
العَرَض: ينخفض الاستدعاء بعد التحويل إلى INT8 مع إبقاء conf كما هو. الحل: قد يغيّر INT8 قيم الثقة؛ أعد اختيار conf من منحنى F1 الخاص بمحرك INT8.
العَرَض: يتعذر إلغاء تسلسل المحرك، أو يكون تشغيله أبطأ من المتوقع، على جهاز النشر. الحل: ابنِه على عائلة GPU المستخدمة في النشر، مع إصدارَي TensorRT وCUDA متوافقين، واشحن .onnx كي تتمكن الأجهزة من إعادة البناء. إذا تعطلَت المعايرة أثناء البناء، فارفع workspace أو اخفض imgsz أو batch.
على Jetson، يشغّل DeepStream المحركات الناتجة ضمن مسار فيديو مُسرّع عتاديًا؛ وفي مركز البيانات، يقدّمها Triton Inference Server للخدمة.
عرض الحل
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on Windows
    data = "coco8.yaml"  # or my_dataset/data.yaml
    model = YOLO("yolo26n.pt")
    engine = model.export(format="engine", quantize=16, workspace=4)

    base = model.val(data=data, plots=False).box.map
    fp16 = YOLO(engine).val(data=data, plots=False).box.map
    print(f"PyTorch {base:.4f}  FP16 engine {fp16:.4f}  gap {abs(base - fp16) * 100:.2f} points")

    # Only if FP16 misses the latency budget:
    # model.export(format="engine", quantize=8, data=data, batch=8, dynamic=True, workspace=4)
يُظهر التقرير الناجح فارقًا يقل عن 0.5 نقطة، وزمن استجابة عند p95 ضمن الميزانية، وقرارًا هو شحن FP16. إذا تجاوز زمن الاستجابة عند p95 الميزانية، فصدّر INT8 باستخدام ملف YAML للمعايرة الخاص بك، وأعد تشغيل السطرين نفسيهما، ولا تشحن INT8 إلا إذا ظل الفارق ضمن الميزانية التي دوّنتها قبل البدء؛ وإلا فجرّب QAT أو نموذجًا أصغر.