الاستدلال متعدد التدفقات
شغّل عدة كاميرات باستخدام نموذج واحد، مع الاستدلال على دفعات، وطوابير محدودة السعة، وقياس الإطارات التي يتم إسقاطها.
قد يتأخر نظام يواكب كاميرا واحدة دقائقَ عن الوقت الفعلي عند تشغيل أربع كاميرات، من دون أن يتعطل أي شيء؛ إذ تصل النتائج متأخرة أكثر فأكثر إلى أن تنفد الذاكرة. على وحدة المعالجة المركزية في الحاسوب المحمول المستخدمة هنا، واكب تدفق واحد بمعدل 30 FPS سرعة الإدخال، بينما أسقطت أربعة تدفقات نصف إطاراتها، وأسقطت ثمانية أكثر من ثلثيها. يبني هذا الدرس خط المعالجة الذي يقيس هذا العدد، لأنه أساس تحديد حجم العتاد.
عملي
أين يُستهلك الوقت#
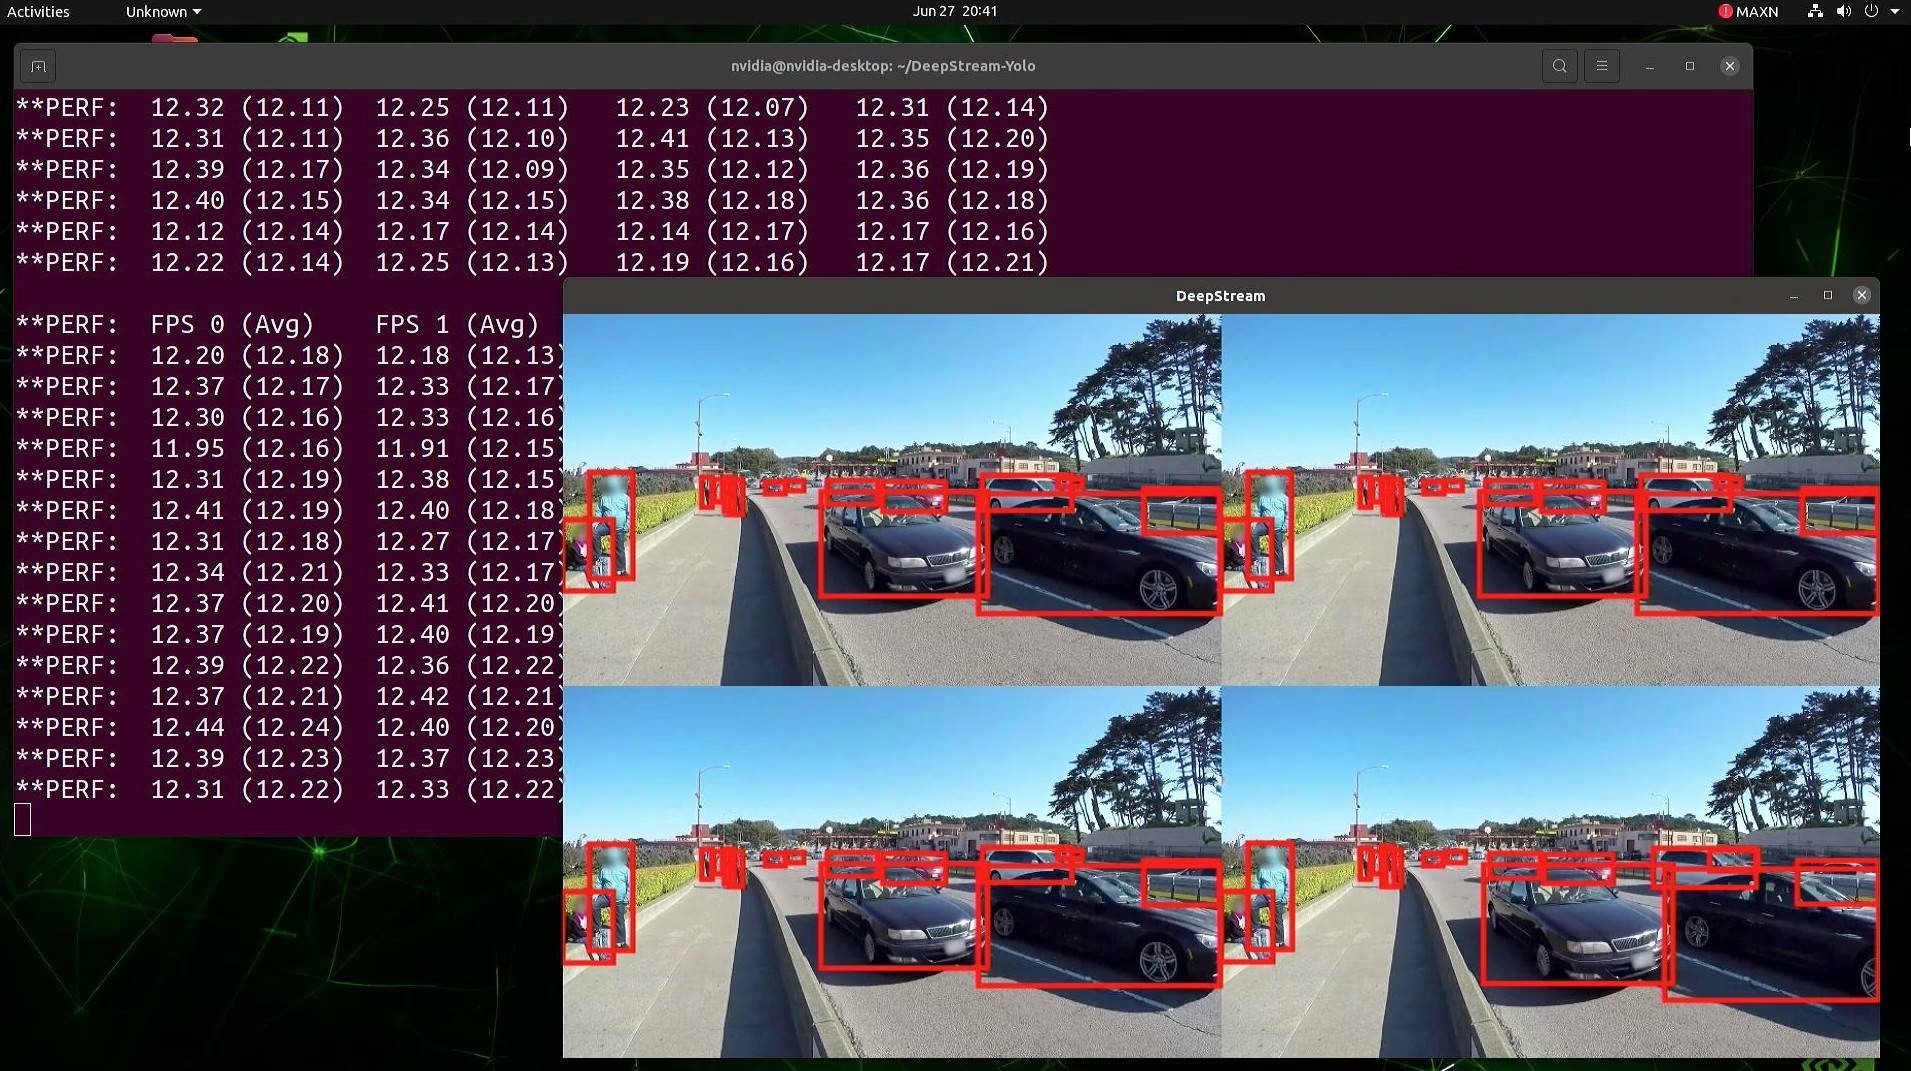
يمر كل إطار بأربع مراحل:
| المرحلة | التكلفة المعتادة | يعمل على |
|---|---|---|
| فك الترميز (RTSP أو ملف → مصفوفة) | 5–20 ms لكل إطار بدقة 1080p | CPU |
| المعالجة المسبقة (letterbox والتطبيع) | نحو 1 ms | CPU |
| الاستدلال | بضعة ms (GPU) إلى عشرات ms (CPU) | مسرّع |
| المعالجة اللاحقة والتتبع ومخازن الإخراج | بضعة ms، وأكثر مع قواعد البيانات البطيئة | CPU |
شغّل هذه المراحل واحدة تلو الأخرى، وكاميرا تلو الأخرى، ضمن خيط واحد، وسيظل المسرّع خاملاً أثناء فك ترميز الإطارات. والحل هو فصل المراحل، وهذا ما يفعله خط معالجة DeepStream أعلاه: تتشارك أربعة تدفقات جهازًا واحدًا، ويعرض كل منها قيمة FPS الخاصة به (نحو 12 هنا). البنية نفسها في Python:
الطريقة المضمّنة: ملف .streams#
يعالج Ultralytics عدة مصادر على دفعات نيابةً عنك. ضع مصدرًا واحدًا في كل سطر من ملف .streams ومرّره إلى وضع Predict أو Track. يحصل كل تدفق على خيط قارئ ومتتبّع خاصين به، وتُنفّذ كل دورة تمريرة أمامية واحدة على دفعة تضم جميع التدفقات:
from collections import Counter
from pathlib import Path
from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download
base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
clips = [safe_download(base + name) for name in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
Path("cams.streams").write_text("\n".join(str(c) for c in clips)) # للإنتاج: عنوان URL واحد من نوع rtsp:// في كل سطر
model = YOLO("yolo26n.pt") # استخدم النسخة المُصدّرة والمحسّنة في بيئة الإنتاج
frames = Counter()
for r in model.track("cams.streams", stream=True, stream_buffer=True, tracker="bytetrack.yaml", verbose=False):
frames[Path(r.path).name] += 1 # يخبرك r.path بالتدفق الذي جاءت منه هذه النتيجة
print(frames)Counter({'solutions_ci_demo.mp4': 62, 'ground-vehicles-airport.mp4': 62})أنتج كلا التدفقين 62 نتيجة لأن التكرار يتوقف عند انتهاء التدفق الأقصر (يحتوي مقطع المطار على 150 إطارًا). عالج stream_buffer=True كل إطار، وهذا مناسب للملفات المسجلة؛ أما مع الكاميرات المباشرة، فأبقِ False على الإعداد الافتراضي كي يتجاوز النموذج البطيء الإطارات القديمة بدلًا من التأخر عن الوقت الفعلي. استخدم ذلك مع نسخة مُصدّرة إلى TensorRT أو OpenVINO للحصول على أفضل معدل معالجة لكل تدفق.
مخصص: نمط المنتج-المستهلك مع عدّادات الإسقاط#
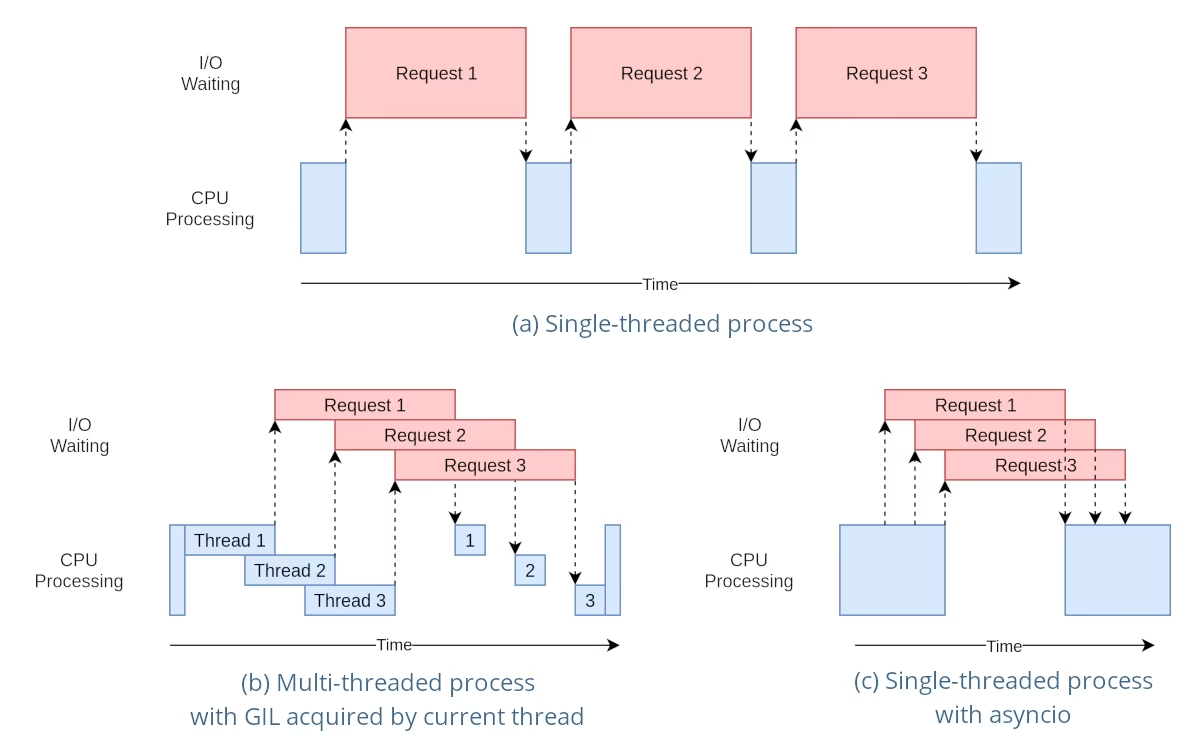
يوضح المخطط سبب ملاءمة الخيوط لخط المعالجة هذا. يتضمن فك الترميز انتظارًا في معظمه (أشرطة الإدخال والإخراج الوردية)، كما أن OpenCV وPyTorch يحرران GIL الخاص بـ Python أثناء عملهما، لذا تتداخل خيوط فك الترميز بكفاءة (اللوحة b). أما المعالجة اللاحقة المكثفة المكتوبة بلغة Python فلا تتداخل؛ انقلها إلى عمليات منفصلة.
عندما تحتاج إلى مخازن إخراج خاصة بك، أو منطق لكل كاميرا، أو مقاييس إسقاط صريحة، أنشئ خط المعالجة بنفسك. لا تتعامل خيوط فك الترميز مطلقًا مع النموذج؛ إذ تتولى حلقة مستهلك واحدة ملكيته، ما يضمن أيضًا التزامك بقواعد الاستدلال الآمن للخيوط:
import queue
import threading
import time

import cv2

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
SOURCES = [str(safe_download(base + n)) for n in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
frames = queue.Queue(maxsize=16)  # bounded: memory and latency stay flat under overload
dropped = [0] * len(SOURCES)

def decode(stream_id, source):
    """Producer: read frames at the camera's pace and never block on a full queue."""
    cap = cv2.VideoCapture(source)
    interval = 1 / (cap.get(cv2.CAP_PROP_FPS) or 30)
    while True:
        ok, frame = cap.read()
        if not ok:
            break
        try:
            frames.put_nowait((stream_id, frame))
        except queue.Full:
            dropped[stream_id] += 1  # consumer is behind: drop rather than serve stale frames
        time.sleep(interval)  # pace files like a live camera; remove for RTSP sources
    cap.release()

model = YOLO("yolo26n.pt")  # one model, used only by the consumer loop below
model.predict("https://ultralytics.com/images/bus.jpg", verbose=False)  # warm up before cameras start

decoders = [threading.Thread(target=decode, args=(i, s), daemon=True) for i, s in enumerate(SOURCES)]
for t in decoders:
    t.start()

processed = [0] * len(SOURCES)
while any(t.is_alive() for t in decoders) or not frames.empty():
    batch = []
    while len(batch) < 8:  # gather up to 8 frames from any camera
        try:
            batch.append(frames.get(timeout=0.05))
        except queue.Empty:
            break
    if not batch:
        continue
    results = model([frame for _, frame in batch], verbose=False)  # one batched forward pass
    for (stream_id, _), r in zip(batch, results):
        processed[stream_id] += 1  # per-stream postprocessing and sinks go here

print(f"processed={processed} dropped={dropped}")
processed=[56, 131] dropped=[6, 19]يحتوي المقطعان على 62 و150 إطارًا، وقد عولج كل إطار أو أُسقط (56 + 6 = 62، و131 + 19 = 150)، لذا تشمل العدّادات جميع الإطارات. أُسقط 25 إطارًا من أصل 212: تعجز وحدة المعالجة المركزية في هذا الحاسوب المحمول عن تشغيل yolo26n باستخدام PyTorch على تدفقين بمعدل 30 FPS. إليك تكرار المقاطع لمحاكاة عدد أكبر من الكاميرات في اختبار واحد:
| التدفقات (30 FPS لكل تدفق) | الإطارات المُسقطة |
|---|---|
| 1 | 0% |
| 2 | 12% |
| 4 | 51% |
| 8 | 69% |
خطط للسعة استنادًا إلى القياسات#
عدد التدفقات لكل جهاز ≈ معدل المعالجة المستدام (عدد الإطارات في الثانية التي يعالجها النموذج عند حجم الدفعة لديك) ÷ قيمة FPS المطلوبة لكل تدفق. قِس معدل المعالجة باستخدام النسخة المُصدّرة والمحسّنة من الدروس السابقة على العتاد الفعلي، واترك هامشًا احتياطيًا بنسبة 20–30% لمواجهة الذروات، وأطلق تنبيهًا عند ارتفاع عدد الإطارات المُسقطة فوق الصفر. تزداد التكلفة مع عدد البكسلات تقريبًا: تتطلب دقة 1280×1280 قدرة حوسبة تقارب 4× ما تتطلبه دقة 640×640. وللأساطيل الكبيرة، يُعد Triton Inference Server وDeepStream على Jetson الخيارين الطبيعيين لبيئات الإنتاج.
مواطن الخلل#
العَرَض: يتعامل model.track(["cam1.mp4", "cam2.mp4"]) مع القائمة كدفعة من الصور، لا كتدفقات. الحل: اكتب المصادر في ملف .streams، مصدرًا واحدًا في كل سطر.
العَرَض: لا ينتج كل ملف إلا إطارًا أو إطارين. الحل: يسقط stream_buffer=False الإطارات القديمة، بينما تسبق قارئات الملفات النموذج؛ اضبط stream_buffer=True للملفات وأبقِ القيمة الافتراضية للكاميرات المباشرة.
العَرَض: تظهر أحيانًا نتائج خاطئة أو مختلطة تحت الحمل. الحل: لا تستدعِ أبدًا نسخة YOLO واحدة من عدة خيوط في الوقت نفسه. اجعل مستهلكًا واحدًا مسؤولًا عنها كما سبق، أو أنشئ نموذجًا داخل كل خيط استدلال.
العَرَض: يزداد زمن الاستجابة كل دقيقة، وتتزايد الذاكرة حتى تتوقف العملية. الحل: استخدم قائمة انتظار محدودة تسقط العناصر عند امتلائها، مع عدّاد للإطارات المسقطة. ينبغي للأنظمة الآنية إسقاط الإطارات عند زيادة الحمل، لا التأخر.
عرض الحل
اجعل عدد التدفقات وسيطًا لسطر الأوامر بإضافة هذه الأسطر إلى producer_consumer.py، مباشرة بعد سطر SOURCES:
import sys
N = int(sys.argv[1]) if len(sys.argv) > 1 else 2 # عدد الكاميرات المحاكاة
SOURCES = [SOURCES[i % len(SOURCES)] for i in range(N)]ثم اختبر الأعداد بالتتابع:
for n in 1 2 4 8; do python producer_consumer.py $n; doneprocessed=[62] dropped=[0]
processed=[56, 131] dropped=[6, 19]
processed=[23, 82, 23, 81] dropped=[39, 68, 39, 69]
processed=[14, 53, 13, 53, 13, 52, 13, 53] dropped=[48, 97, 49, 97, 49, 98, 49, 97]الإجابة لهذا الجهاز هي تدفق واحد: يبدأ إسقاط الإطارات عند تدفقين. لتشغيل أربع كاميرات، صدّر النموذج إلى بيئة تشغيل أسرع (الدرسان 3 و4)، أو خفّض imgsz، أو انتقل إلى مسرّع، ثم أعد الاختبار.