OpenVINO على وحدة CPU
صدّر نماذج OpenVINO بدقة FP32 وFP16 وINT8، وتحقق من صلاحية كل منها، واحتفظ بـ INT8 فقط عندما تحقق فائدة على وحدة CPU الخاصة بك.
يمكن لوحدة CPU من Intel تملكها بالفعل أن تحل غالبًا محل مثيل GPU: في معايير Ultralytics، انخفض زمن YOLO26m من 192 مللي ثانية في PyTorch إلى 36 مللي ثانية مع OpenVINO INT8 على وحدة CPU محمولة من Core Ultra. لكن المكاسب تعتمد على الشريحة؛ وعلى الحاسوب المحمول للاختبار المزود بمعالج ARM المستخدم في هذه الدورة، خسر تصدير INT8 عُيّر على أربع صور 3 نقاط mAP. ستتعلم قياس الحالة التي تنطبق عليك قبل الشحن.
عملي
ما الذي يقدمه OpenVINO#
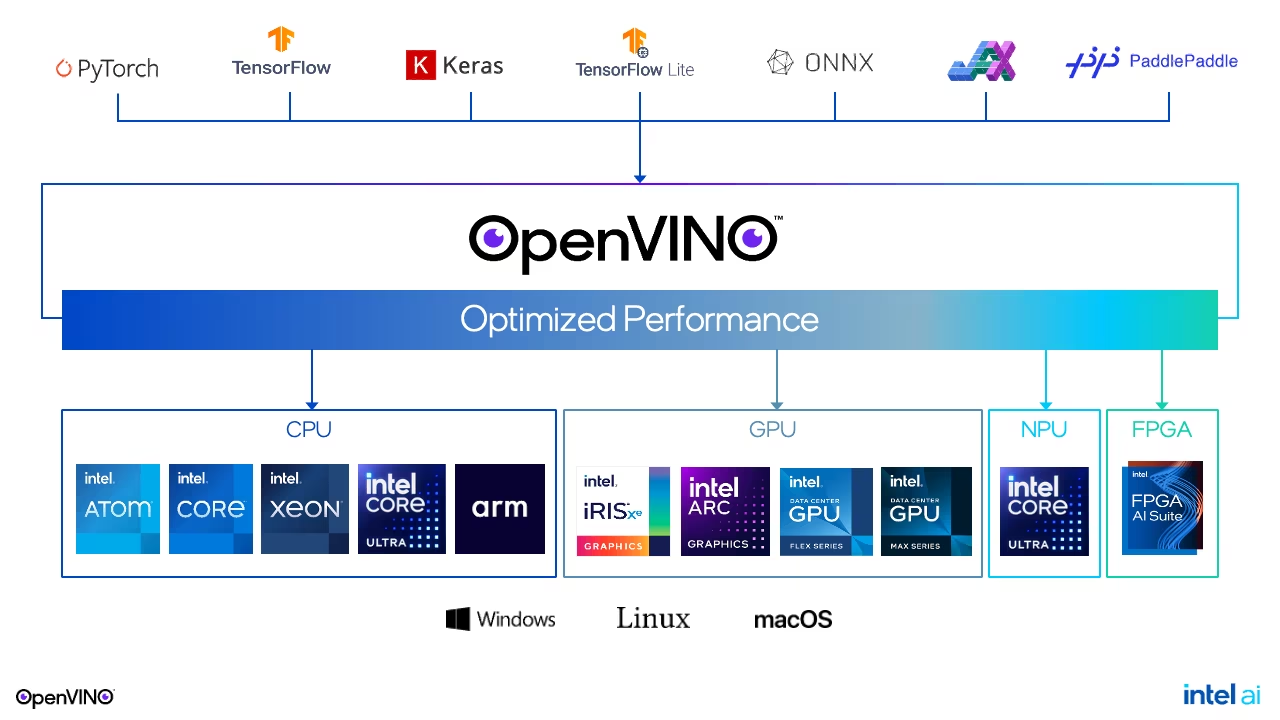
يستقبل OpenVINO النماذج من PyTorch وONNX ويشغّلها على وحدات CPU من Intel، ووحدات GPU المدمجة والمنفصلة، ووحدات NPU عبر API واحدة. تستهدف أنوية CPU مجموعات تعليمات Intel (AVX2 وAVX-512 وAMX)، كما أن مسار INT8 ناضج. لاحظ مربع ARM في عمود CPU: يعمل OpenVINO على ARM أيضًا، لكن أنويته محسّنة لـ Intel؛ لذا قِس الأداء قبل الاعتماد عليه هناك.
المعيار المنشور على وحدة CPU من Intel Core Ultra 7 155H (COCO128):
| النموذج | PyTorch FP32 | OpenVINO FP32 | OpenVINO INT8 | mAP50-95 من FP32 إلى INT8 |
|---|---|---|---|---|
| YOLO26n | 33.19 ms | 13.43 ms | 11.40 ms | 0.4734 → 0.4611 |
| YOLO26s | 70.92 ms | 36.16 ms | 15.54 ms | 0.5632 → 0.5471 |
| YOLO26m | 192.45 ms | 102.52 ms | 35.72 ms | 0.6191 → 0.6025 |
تنبثق عن هذا الجدول ثلاث قواعد:
- يخفض OpenVINO FP32 وحده زمن استجابة PyTorch إلى النصف تقريبًا على وحدة CPU من Intel. ابدأ بذلك.
- تزداد فائدة INT8 مع كبر النموذج: 1.2× لـ
nو2.9× لـm، مقابل خسارة 1.2–1.7 نقطة mAP. أما علىnفنادرًا ما تستحق INT8 خسارة الدقة. - جرّب وحدة GPU المدمجة قبل شراء العتاد: شغّلت وحدة Arc iGPU (
device="intel:gpu") في الشريحة نفسها YOLO26n بدقة FP32 خلال 9.13 مللي ثانية وYOLO26m خلال 34.47 مللي ثانية.
قارن الدقات على وحدة CPU الخاصة بك#
صدّر كل دقة، وتحقق من صلاحيتها فورًا، ثم صدّر الدقة التالية فقط:
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on macOS and Windows
    model = YOLO("yolo26n.pt")  # or runs/detect/pills_v1/weights/best.pt
    for name, quantize in (("FP32", None), ("FP16", 16), ("INT8", 8)):
        path = model.export(format="openvino", quantize=quantize, data="coco8.yaml")  # or my_dataset/data.yaml
        m = YOLO(path).val(data="coco8.yaml", batch=1, plots=False, verbose=False)  # before the next export overwrites it
        print(f"{name}: mAP50-95 {m.box.map:.4f}  -> {path}")
OpenVINO: export success ✅ 2.3s, saved as 'yolo26n_openvino_model/' (9.6 MB)
FP32: mAP50-95 0.6783 -> yolo26n_openvino_model/
OpenVINO: export success ✅ 1.6s, saved as 'yolo26n_openvino_model/' (5.1 MB)
FP16: mAP50-95 0.6783 -> yolo26n_openvino_model/
WARNING ⚠️ OpenVINO: >300 images recommended for INT8 calibration, found 4 images.
OpenVINO: export success ✅ 11.3s, saved as 'yolo26n_int8_openvino_model/' (3.2 MB)
INT8: mAP50-95 0.6460 -> yolo26n_int8_openvino_model/ما الذي يخبرك به كل سطر:
- حققت FP32 وFP16 الدقة نفسها، وحجم FP16 نصف حجم FP32 (5.1 مقابل 9.6 ميغابايت)، لكنهما كُتبتا في المجلد نفسه. لو كنت قد صدّرت كليهما أولًا ثم تحققت منهما لاحقًا، لَقِست أداء FP16 مرتين.
- حجم INT8 هو 3.2 ميغابايت، وقد خسرت 3.2 نقطة، لأنها عُيّرت على الصور الأربع في COCO8. ويشير التحذير إلى ذلك: تتطلب المعايرة الفعلية مئات الصور التي تحاكي بيانات الإنتاج من ملف YAML الخاص بك (
fractionيحدد الحد الأقصى لعدد الصور المستخدمة). - لا يقيس أي مما سبق السرعة. استخدم المعيار أدناه لذلك.
لتشغيل نموذج مُصدّر على جهاز Intel محدد:
from ultralytics import YOLO

ov_model = YOLO("yolo26n_openvino_model/")
results = ov_model("https://ultralytics.com/images/bus.jpg", device="intel:cpu")  # or intel:gpu, intel:npu
اشحن المجلد بأكمله: yolo26n.xml (المخطط الحسابي)، وyolo26n.bin (الأوزان)، وmetadata.yaml. يتطلب intel:gpu وintel:npu عتاد Intel.
قارن زمن التنفيذ بـ ONNX Runtime#
حُسم أمر الدقة؛ أما السرعة فتُحدَّد على الجهاز المستهدف وتحت الحمل الذي سيواجهه فعلًا. شغّل pick_runtime.py من الدرس الأول مع CANDIDATES = ("onnx", "openvino"). على الحاسوب المحمول للاختبار المزود بمعالج Apple silicon، بينما كانت مهام أخرى تشارك وحدة CPU:
onnx      p50  30.0 ms  p95  46.4 ms  misses the 30 ms budget
openvino  p50  22.8 ms  p95 113.5 ms  misses the 30 ms budget
حقق OpenVINO وسيطًا أفضل وذيلًا أسوأ بكثير. يترجم غلاف Ultralytics نموذج OpenVINO باستخدام تلميح LATENCY (يشير السجل إلى Using OpenVINO LATENCY mode for batch=1 inference on CPU)، ما يوزع كل طلب على أنوية وحدة CPU؛ وعندما تنافسها أعمال أخرى على تلك الأنوية، تتأثر الطلبات الأبطأ أكثر من غيرها. يكون الأداء عادةً كما في النتائج المنشورة أعلاه على جهاز Intel مخصص، لكن زمن الاستجابة عند p95 الذي تقيسه بنفسك وحده يخبرك بالحقيقة.
قواعد اتخاذ القرار:
مواطن الخلل#
العَرَض: حجم تصدير FP16 نصف حجم الأصل، لكنه بالبطء نفسه تمامًا. الحل: يختار المكوّن الإضافي دقة التنفيذ بنفسه على معظم وحدات CPU؛ استخدم FP16 لتقليل حجم التنزيلات، وINT8 أو iGPU لزيادة السرعة.
العَرَض: تعرض تقارير FP32 وFP16 الأرقام نفسها لأنهما كانا الملف نفسه. الحل: تشترك صادرات FP32 وFP16 في المجلد *_openvino_model/؛ أجرِ التحقق (أو أعد تسمية المجلد) فور كل عملية تصدير.
العَرَض: يبدو المتوسط جيدًا، ومع ذلك تستمر الإطارات في السقوط خلال فترات الانشغال. الحل: قِس زمن الاستدلال مع تشغيل حمل الإنتاج، واعتمد p95 لا المتوسط. ولتشغيل تدفقات عديدة على خادم واحد، ترجم باستخدام تلميح THROUGHPUT عبر تحميل .xml مباشرةً باستخدام بيئة تشغيل OpenVINO، كما يوضح دليل أوضاع زمن الاستجابة مقابل معدل النقل.
على macOS وWindows، يبدأ التحقق عمليات عاملة تعيد استيراد البرنامج النصي. ومن دون if __name__ == "__main__":، كرر الاختبار في هذا الدرس عمليات التصدير داخل تلك العمليات العاملة، ما أهدر دقائق وتنافس على وحدة CPU التي كان يحاول قياس أدائها.
عرض الحل
python ov_compare.py    # accuracy and size of FP32, FP16, INT8
python pick_runtime.py  # p50 and p95 for ONNX Runtime and OpenVINO
مثال عملي لاتخاذ القرار باستخدام الأرقام أعلاه لمعالج Core Ultra 7 155H:
| الخيار | mAP50-95 | الحجم | مللي ثانية لكل صورة |
|---|---|---|---|
| OpenVINO FP32 | 0.4734 | 9.6 MB | 13.43 |
| OpenVINO INT8 | 0.4611 | 3.2 MB | 11.40 |
iGPU FP32 (intel:gpu) | 0.4758 | 9.6 MB | 9.13 |
انشر OpenVINO FP32 على وحدة معالجة الرسومات المدمجة: فهو الخيار الأسرع ولا يتسبب في أي خسارة، بينما تكلف INT8 على وحدة المعالجة المركزية 1.2 نقطة مقابل توفير 2 مللي ثانية. أما عند نشر YOLO26m، فينعكس القرار لصالح INT8 على وحدة المعالجة المركزية (أسرع بمقدار 2.9× مقابل 1.7 نقطة)، إذا كانت هذه الخسارة ضمن ميزانيتك.