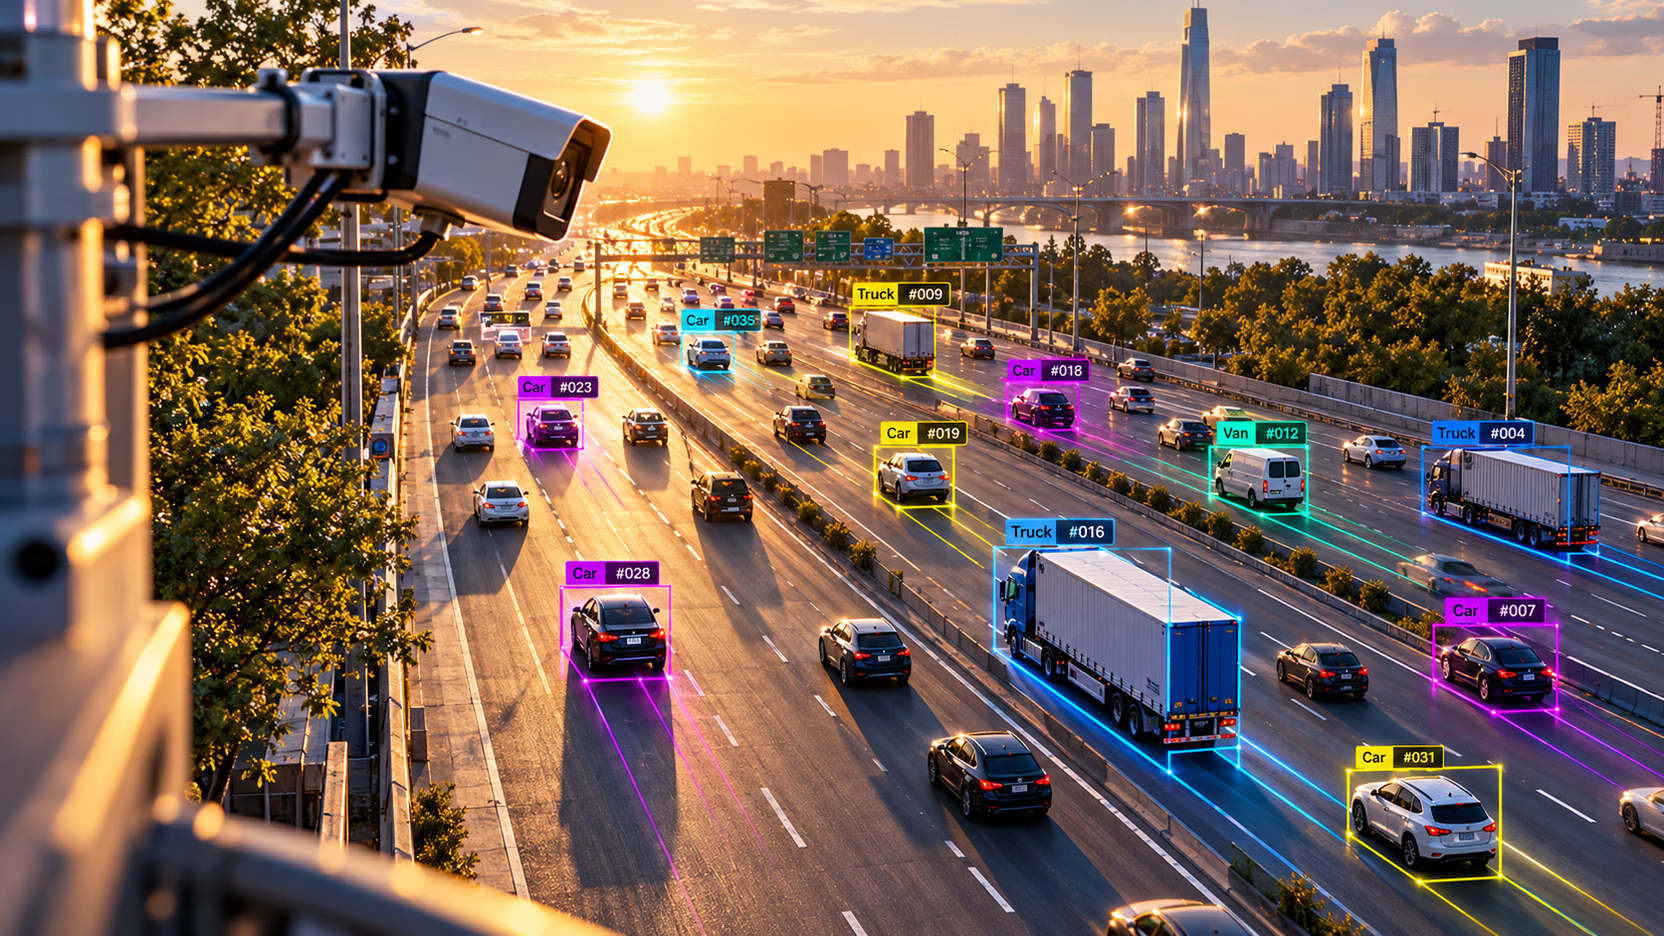
Ultralytics YOLO in der Produktion
Überführe ein trainiertes Ultralytics-YOLO-Modell in die Produktion: Wähle eine Laufzeitumgebung, exportiere und überprüfe das Modell, optimiere es für deine Hardware, verfolge Objekte, erstelle Zählpipelines, verarbeite viele Streams und erkenne Drift, bevor sie den Nutzern auffällt.
Von Ultralytics Academy
Setze ein YOLO26-Modell mit der passenden Laufzeitumgebung und nachgewiesener Übereinstimmung ein, wandle Erkennungen über viele Streams hinweg in verfolgte IDs und Zählungen um und überwache das System so, dass dich Probleme mit Latenz, Genauigkeit und Drift erreichen, bevor sie den Nutzern auffallen.
Wähle anhand des Geräts, des Latenzbudgets und der Geräteflotte eine Laufzeitumgebung und einen Wert für
format=aus und bestätige die Wahl mit wiederholten Benchmarks.Exportiere nach ONNX und weise die Übereinstimmung mit PyTorch nach, einschließlich der Tücke des Letterboxing bei statischen Formen.
Entscheide dich mit Kalibrierungsdaten und einer Genauigkeitsschranke zwischen FP32, FP16 und INT8 auf TensorRT und OpenVINO.
Verfolge Objekte mit ByteTrack, BoT-SORT oder TrackTrack und stimme die Schwellenwerte des Trackers auf die Konfidenzwerte deines Detektors ab.
Erstelle auf Basis des Trackings Zähllinien, Belegungswerte für Bereiche, Heatmaps und kalibrierte Geschwindigkeitsschätzungen.
Verarbeite mehrere Kamerastreams mit einem Modell durch gebündelte Inferenz, begrenzte Warteschlangen und gemessene Bildverluste.
Protokolliere Metriken für jedes Bild, erkenne Konfidenzdrift mit einem KS-Test und nutze den kostengünstigsten Hebel für Latenz und Kosten.
Eine Laufzeitentscheidung für dein Gerät, gestützt auf wiederholte Benchmarkwerte und ein Latenzbudget in Millisekunden.
Ein ONNX-Export mit dokumentierter Übereinstimmungsprüfung (Boxen, Konfidenzwerte und mAP) im Vergleich zum PyTorch-Modell.
Ein optimierter Export (OpenVINO oder TensorRT), der die mAP- und Latenzschranken auf der Zielhardware erfüllt hat.
Eine Zählpipeline mit einer Zähllinie, einer Bereichszählung, einer Heatmap und einer kalibrierten Geschwindigkeitsschätzung für echtes Videomaterial.
Ein Worker für mehrere Streams, der Bilder von mehreren Kameras bündelt und für jeden Stream die verarbeiteten und verworfenen Bilder meldet.
Eine Überwachungsschleife: JSON-Metriken pro Bild, ein KS-Drifttest für Konfidenzwerte und eine wöchentliche Validierung anhand eines zurückgehaltenen Datensatzes.
Ein trainiertes Modell, zum Beispiel
runs/detect/pills_v1/weights/best.ptaus Trainiere dein erstes YOLO-Modell, oder der vortrainierte Prüfpunktyolo26n.pt, um den Schritten zu folgen.Python 3.10+ mit
pip install "ultralytics[solutions]" onnxruntime scipy(solutions installiert shapely und lap).Vertrautheit mit Python, der Befehlszeile und Videoquellen (Dateien, Webcams, RTSP).
Empfehlung: Schließe zuerst Trainiere dein erstes YOLO-Modell und Leistungsstarke YOLO-Datensätze erstellen ab.
Kursinhalt
4 Module · 9 LektionenModul 1
Bereitstellungsziel auswählen
Leite aus dem Gerät, dem Latenzbudget und der Geräteflotte eine Laufzeitumgebung und ein Exportformat ab und überprüfe sie anschließend auf dem Gerät.
Nach ONNX exportieren (und Übereinstimmung überprüfen)
Exportiere ein portables ONNX-Modell und weise anschließend nach, dass es bei BBoxen, Konfidenzen und mAP mit PyTorch übereinstimmt, bevor du etwas bereitstellst.
Modul 2
Mit TensorRT optimieren
Erstelle eine FP16-TensorRT-Engine, entscheide, ob sich INT8 angesichts der Genauigkeitseinbußen lohnt, und prüfe die Engine vor der Bereitstellung.
OpenVINO auf der CPU
Exportiere OpenVINO-Modelle in FP32, FP16 und INT8, validiere jedes Modell und behalte INT8 nur dann, wenn es auf deiner CPU Vorteile bringt.
Modul 3
Objekte mit ByteTrack, BoT-SORT und TrackTrack verfolgen
Gib jedem Objekt über mehrere Bilder hinweg eine stabile ID, wähle einen Tracker und passe seine Schwellenwerte an deinen Detektor an.
Zählungen, Wärmekarten und Geschwindigkeitsschätzung
Erstelle auf Basis von Tracking Linienzählungen, Belegungsmessungen für Zonen, Wärmekarten und Geschwindigkeitsschätzungen und kalibriere sie zuverlässig.
Modul 4
Inferenz mit mehreren Streams
Verarbeite mehrere Kameras mit einem Modell, indem du Stapelverarbeitung, begrenzte Warteschlangen und gemessene Frame-Verluste verwendest.
Beobachtbarkeit und Drift
Protokolliere Kennzahlen, die einen unbemerkten Genauigkeitsverlust aufdecken, prüfe Konfidenzverteilungen auf Drift und richte nur bei Signalen mit konkretem Handlungsbedarf Alarme ein.
Kosten und Latenz optimieren
Erstelle ein Profil der gesamten Pipeline, betätige der Reihe nach die Stellschrauben, die Latenz und Kosten tatsächlich beeinflussen, und höre auf, sobald du dein Budget einhältst.