Inferenz mit mehreren Streams
Verarbeite mehrere Kameras mit einem Modell, indem du Stapelverarbeitung, begrenzte Warteschlangen und gemessene Frame-Verluste verwendest.
Ein System, das mit einer Kamera Schritt hält, kann bei vier Kameras Minuten zurückfallen, ohne dass etwas abstürzt: Die Ergebnisse treffen einfach immer später ein, bis der Speicher erschöpft ist. Auf der hier verwendeten Laptop-CPU kam ein Stream mit 30 FPS mit, bei vier Streams ging die Hälfte der Frames verloren und bei acht mehr als zwei Drittel. In dieser Lektion erstellst du eine Pipeline, die diese Zahl misst – denn sie hilft dir, die Hardware richtig auszulegen.
Praxisnah
Wofür die Zeit draufgeht#
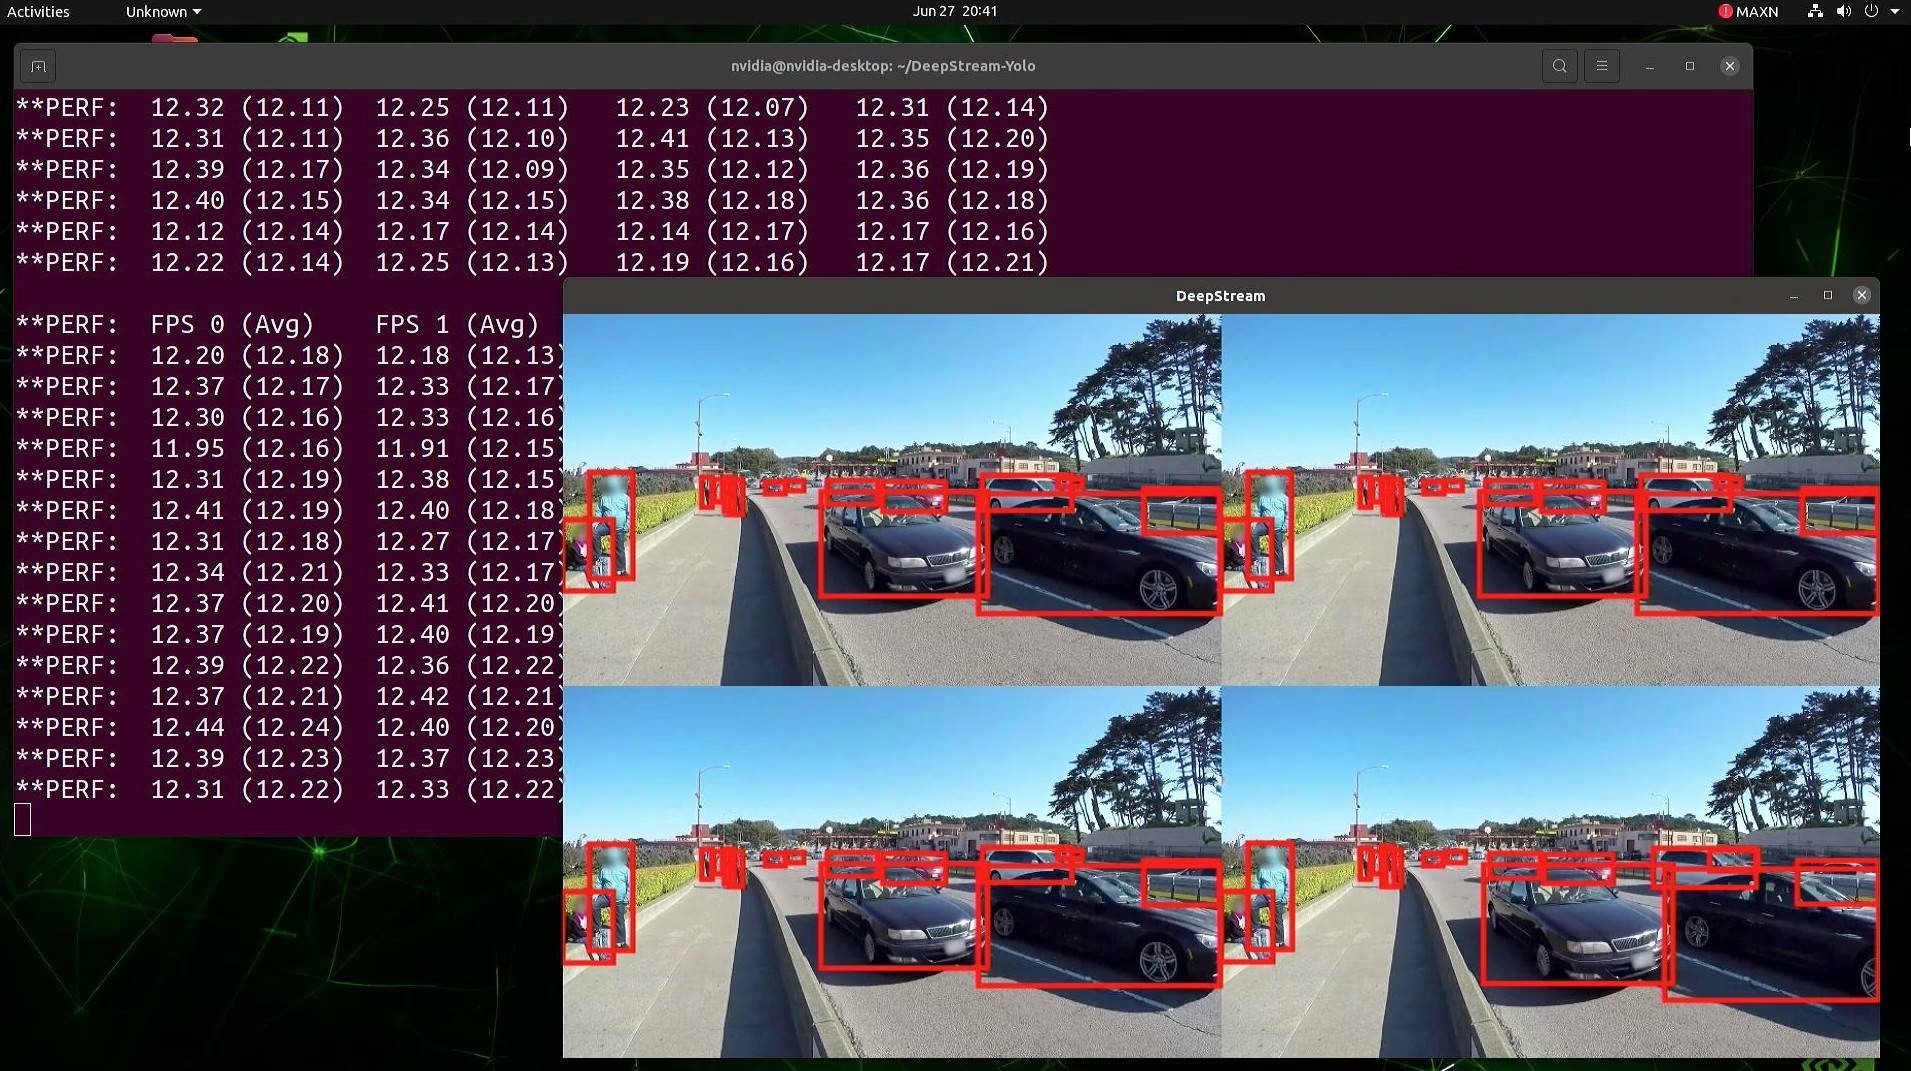
Jeder Frame durchläuft vier Phasen:
| Phase | Typischer Aufwand | Läuft auf |
|---|---|---|
| Dekodierung (RTSP oder Datei → Array) | 5–20 ms pro 1080p-Frame | CPU |
| Vorverarbeitung (Letterbox, Normalisierung) | etwa 1 ms | CPU |
| Inferenz | einige ms (GPU) bis einige zehn ms (CPU) | Beschleuniger |
| Nachverarbeitung, Tracking, Datensenken | einige ms, bei langsamen Datenbanken mehr | CPU |
Führst du diese Schritte nacheinander, Kamera für Kamera und in einem Thread aus, bleibt der Beschleuniger untätig, während Frames dekodiert werden. Die Lösung besteht darin, die Phasen zu trennen – genau das macht die obige DeepStream-Pipeline: Vier Streams teilen sich ein Gerät und melden jeweils ihre eigene FPS (hier etwa 12). Dieselbe Struktur in Python:
Integrierte Funktion: eine .streams-Datei#
Ultralytics verarbeitet mehrere Quellen in Stapeln für dich. Trage in einer .streams-Datei eine Quelle pro Zeile ein und übergib die Datei an Predict oder den Track-Modus. Jeder Stream erhält einen eigenen Lesethread und Tracker, und jede Iteration führt einen gemeinsamen Vorwärtsdurchlauf für alle Streams aus:
from collections import Counter
from pathlib import Path

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
clips = [safe_download(base + name) for name in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
Path("cams.streams").write_text("\n".join(str(c) for c in clips))  # Produktion: eine rtsp://-URL pro Zeile

model = YOLO("yolo26n.pt")  # Verwende in der Produktion deinen optimierten Export
frames = Counter()
for r in model.track("cams.streams", stream=True, stream_buffer=True, tracker="bytetrack.yaml", verbose=False):
    frames[Path(r.path).name] += 1  # r.path gibt an, aus welchem Stream dieses Ergebnis stammt
print(frames)
Counter({'solutions_ci_demo.mp4': 62, 'ground-vehicles-airport.mp4': 62})Beide Streams erzeugten 62 Ergebnisse, weil die Iteration endet, sobald der kürzeste Stream zu Ende ist (der Flughafen-Clip hat 150 Frames). stream_buffer=True verarbeitete jeden Frame, was für aufgezeichnete Dateien richtig ist. Lass bei Live-Kameras die Standardeinstellung False aktiv, damit ein langsames Modell veraltete Frames überspringt, statt in Rückstand zu geraten. Kombiniere das mit einem TensorRT- oder OpenVINO-Export, um den Durchsatz pro Stream zu maximieren.
Individuelle Umsetzung: Erzeuger und Verbraucher mit Zählern für verworfene Frames#
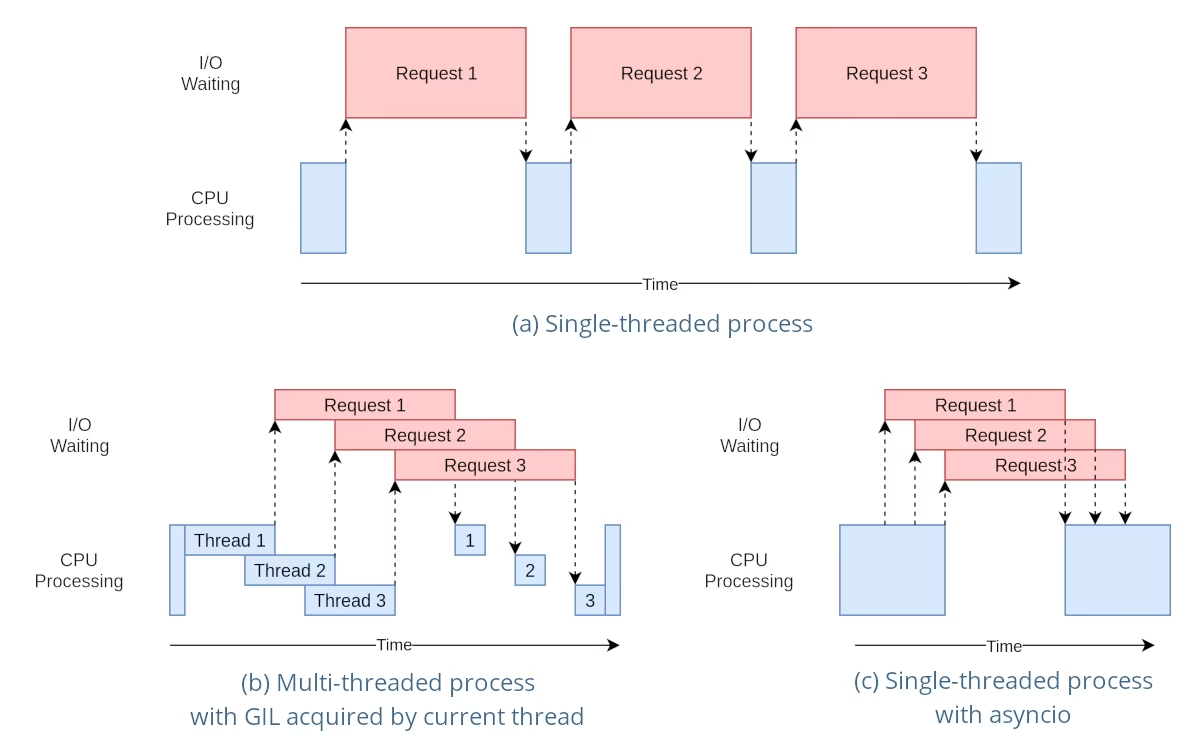
Das Diagramm zeigt, warum Threads für diese Pipeline geeignet sind. Beim Dekodieren wird größtenteils gewartet (die rosa E/A-Balken), und OpenCV sowie PyTorch geben den Python-GIL während ihrer Arbeit frei. Deshalb lassen sich Decoder-Threads gut überlappen (Abbildung b). Aufwendige Python-Nachverarbeitung lässt sich nicht überlappen; verlagere sie in separate Prozesse.
Wenn du eigene Datensenken, Logik pro Kamera oder explizite Kennzahlen zu verworfenen Frames benötigst, erstelle die Pipeline selbst. Decoder-Threads greifen nie auf das Modell zu; eine Verbraucherschleife verwaltet es allein und hält dich dadurch auch an die Regeln für threadsichere Inferenz:
import queue
import threading
import time

import cv2

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
SOURCES = [str(safe_download(base + n)) for n in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
frames = queue.Queue(maxsize=16)  # bounded: memory and latency stay flat under overload
dropped = [0] * len(SOURCES)

def decode(stream_id, source):
    """Producer: read frames at the camera's pace and never block on a full queue."""
    cap = cv2.VideoCapture(source)
    interval = 1 / (cap.get(cv2.CAP_PROP_FPS) or 30)
    while True:
        ok, frame = cap.read()
        if not ok:
            break
        try:
            frames.put_nowait((stream_id, frame))
        except queue.Full:
            dropped[stream_id] += 1  # consumer is behind: drop rather than serve stale frames
        time.sleep(interval)  # pace files like a live camera; remove for RTSP sources
    cap.release()

model = YOLO("yolo26n.pt")  # one model, used only by the consumer loop below
model.predict("https://ultralytics.com/images/bus.jpg", verbose=False)  # warm up before cameras start

decoders = [threading.Thread(target=decode, args=(i, s), daemon=True) for i, s in enumerate(SOURCES)]
for t in decoders:
    t.start()

processed = [0] * len(SOURCES)
while any(t.is_alive() for t in decoders) or not frames.empty():
    batch = []
    while len(batch) < 8:  # gather up to 8 frames from any camera
        try:
            batch.append(frames.get(timeout=0.05))
        except queue.Empty:
            break
    if not batch:
        continue
    results = model([frame for _, frame in batch], verbose=False)  # one batched forward pass
    for (stream_id, _), r in zip(batch, results):
        processed[stream_id] += 1  # per-stream postprocessing and sinks go here

print(f"processed={processed} dropped={dropped}")
processed=[56, 131] dropped=[6, 19]Die beiden Clips haben 62 und 150 Frames, und jeder Frame wird entweder verarbeitet oder verworfen (56 + 6 = 62, 131 + 19 = 150). Die Zähler erfassen also alles. 25 von 212 Frames wurden verworfen: Die CPU dieses Laptops kann yolo26n nicht mit PyTorch auf zwei Streams mit jeweils 30 FPS ausführen. Hier eine Messreihe, in der die Clips wiederholt werden, um mehr Kameras zu simulieren:
| Streams (je 30 FPS) | Verworfene Frames |
|---|---|
| 1 | 0% |
| 2 | 12% |
| 4 | 51% |
| 8 | 69% |
Kapazität anhand von Messungen planen#
Streams pro Gerät ≈ anhaltender Durchsatz (Frames pro Sekunde, die das Modell bei deiner Stapelgröße verarbeitet) ÷ erforderliche FPS pro Stream. Miss den Durchsatz mit dem optimierten Export aus früheren Lektionen auf der tatsächlichen Hardware, plane für Spitzenlasten 20–30 % Reserve ein und richte einen Alarm ein, wenn Frames verworfen werden. Ein höheres Auflösungsvermögen erhöht den Aufwand ungefähr proportional zur Pixelanzahl: 1280×1280 benötigt etwa viermal so viel Rechenleistung wie 640×640. Für große Installationen sind Triton Inference Server und DeepStream auf Jetson die naheliegenden Lösungen für den Produktionseinsatz.
Stolperfallen#
Symptom: model.track(["cam1.mp4", "cam2.mp4"]) behandelt die Liste als Stapel von Bildern statt als Streams. Lösung: Schreibe die Quellen in eine .streams-Datei, jeweils eine pro Zeile.
Symptom: Jede Datei liefert nur ein oder zwei Frames. Lösung: stream_buffer=False verwirft veraltete Frames, und Dateileser laufen dem Modell davon; setze für Dateien stream_buffer=True und behalte für Live-Kameras den Standardwert bei.
Symptom: Unter Last treten gelegentlich falsche oder durcheinandergebrachte Ergebnisse auf. Lösung: Rufe niemals dieselbe YOLO-Instanz gleichzeitig aus mehreren Threads auf. Lass sie wie oben von einem einzigen Verbraucher verwenden oder erstelle in jedem Inferenz-Thread ein eigenes Modell.
Symptom: Die Latenz steigt jede Minute und der Speicherverbrauch wächst, bis der Prozess abstürzt. Lösung: Verwende eine begrenzte Warteschlange, die bei voller Kapazität Frames verwirft, und zähle die verworfenen Frames. Echtzeitsysteme sollten bei Überlast Frames verwerfen, statt in Verzug zu geraten.
Lösung anzeigen
Mache die Stream-Anzahl zu einem Befehlszeilenargument, indem du diese Zeilen direkt nach der Zeile SOURCES zu producer_consumer.py hinzufügst:
import sys

N = int(sys.argv[1]) if len(sys.argv) > 1 else 2  # Anzahl der simulierten Kameras
SOURCES = [SOURCES[i % len(SOURCES)] for i in range(N)]
Führe dann eine Messreihe aus:
for n in 1 2 4 8; do python producer_consumer.py $n; doneprocessed=[62] dropped=[0]
processed=[56, 131] dropped=[6, 19]
processed=[23, 82, 23, 81] dropped=[39, 68, 39, 69]
processed=[14, 53, 13, 53, 13, 52, 13, 53] dropped=[48, 97, 49, 97, 49, 98, 49, 97]Das Ergebnis für diesen Rechner lautet ein Stream: Ab zwei Streams gehen Frames verloren. Um vier Kameras zu bedienen, exportiere das Modell in eine schnellere Laufzeitumgebung (Lektionen 3 und 4), reduziere imgsz oder wechsle zu einem Beschleuniger und führe die Messreihe erneut aus.