Kosten und Latenz optimieren
Erstelle ein Profil der gesamten Pipeline, betätige der Reihe nach die Stellschrauben, die Latenz und Kosten tatsächlich beeinflussen, und höre auf, sobald du dein Budget einhältst.
Teams verlieren Wochen damit, Millisekunden bei einem Modell einzusparen, während ein Datenbank-Schreibvorgang oder ein RTSP-Decoder der eigentliche Engpass ist. Es gibt nur wenige große Stellschrauben, deren Wirkung gut messbar ist: YOLO26s benötigt auf einer CPU 2.2-mal so lange wie YOLO26n und erzielt dabei 7.7 mAP-Punkte mehr; eine Erkennung nur in jedem zweiten Bild halbiert den Aufwand. In dieser Lektion lernst du, zuerst ein Profil zu erstellen, die wirksamste passende Stellschraube zu betätigen und aufzuhören, sobald du ein vorab festgelegtes Budget einhältst.
Praxisnah
Zuerst die gesamte Pipeline messen#
Jedes Results-Objekt teilt seine eigene Laufzeit in Stufen auf:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
totals = {"preprocess": 0.0, "inference": 0.0, "postprocess": 0.0}
for n, r in enumerate(model.predict(video, stream=True, verbose=False), 1):
    for stage in totals:
        totals[stage] += r.speed[stage]
print({stage: round(ms / n, 1) for stage, ms in totals.items()}, "ms per frame")
{'preprocess': 0.7, 'inference': 36.1, 'postprocess': 0.7} ms per frameHier entfallen 95 % der Modelllaufzeit auf die Inferenz, daher helfen Stellschrauben am Modell. Miss Dekodierung und deine eigenen Senken auf dieselbe Weise (jeweils time.perf_counter() darum herum) und wende dann die passende Regel an:
| Deine Messwerte | Zuerst beheben |
|---|---|
| 60 ms für RTSP-Dekodierung, 5 ms für Inferenz | Hardwaredekodierung, niedrigere Streamauflösung oder mehr Decoder-Threads |
| 30 ms für Inferenz, 100 ms für Python-Nachverarbeitung | Mit NumPy vektorisieren oder in einen Worker-Prozess auslagern |
| 5 ms für Inferenz, 200 ms für Datenbankschreibvorgänge | Schreibvorgänge bündeln oder asynchron ausführen |
| Die Inferenz ist der Engpass | Die Rangliste der Stellschrauben unten |
Die Rangliste der Stellschrauben#
Probiere sie von oben nach unten aus und höre auf, sobald du dein Budget einhältst:
| Stellschraube | Typische Beschleunigung | Typischer Genauigkeitsverlust |
|---|---|---|
| Kleineres Modell (m → s, s → n) | 1.5–2.5× | 4.5–7.7 mAP-Punkte auf COCO; bei eng umrissenen Aufgaben weniger |
Kleinere imgsz (640 → 480) | etwa 1.8× | Zuerst kleine und weit entfernte Objekte betroffen |
| Schnellere Laufzeitumgebung, FP16 | etwa 1.5× auf der GPU | Normalerweise keiner; Ergebnisgleichheit überprüfen |
| INT8 mit Kalibrierung | zusätzlich 1.2× auf der GPU; bis zu 2.9× auf der CPU | 1 Punkt (YOLO26n) bis 4–6 Punkte (größere Modelle); QAT gleicht den größten Teil aus |
Weniger Bilder (vid_stride=N) | bis zu N× | Schnelle Objekte und kurze Ereignisse können übersehen werden |
| Größere Batchgröße (Server) | Höherer Durchsatz, aber keine geringere Latenz | Keine |
Die Zahlen stammen aus den Benchmarktabellen für YOLO26, TensorRT und OpenVINO sowie aus den folgenden Messungen; deine Ergebnisse werden abweichen, also miss selbst.
Kleineres Modell#
Die YOLO26-Benchmarktabelle auf COCO:
| Modell | mAP50-95 | CPU ONNX (ms) | T4 TensorRT10 (ms) |
|---|---|---|---|
| YOLO26n | 40.9 | 38.9 | 1.7 |
| YOLO26s | 48.6 | 87.2 | 2.5 |
| YOLO26m | 53.1 | 220.0 | 4.7 |
Auf der CPU ist jeder Schritt zur nächstkleineren Variante 2.2–2.5× schneller. Der Genauigkeitsabstand auf COCO stellt den ungünstigsten Fall dar: Ein Lagerdetektor mit 3 Klassen und großen Objekten verliert beim Wechsel von m zu n üblicherweise deutlich weniger als ein allgemeiner Detektor mit 80 Klassen. Daher solltest du das kleinere Modell immer mit deinem eigenen Validierungsdatensatz testen.
Kleinere Eingabegröße#
Der Rechenaufwand skaliert ungefähr mit der Pixelzahl, daher benötigt imgsz=480 etwa 56 % des Rechenaufwands von 640. Gemessen auf der CPU des Testlaptops mit ONNX Runtime bei Batchgröße 1 (Median aus 25 Durchläufen auf bus.jpg):
| Modell | 640 | 480 | 320 |
|---|---|---|---|
| YOLO26n | 21.3 ms | 12.1 ms | 7.1 ms |
| YOLO26s | 55.0 ms | 24.2 ms | 12.9 ms |
Entscheidungsregel: Wenn dein kleinstes wichtiges Objekt bei der neuen Größe noch etwa 10 Pixel oder mehr umfasst, probiere es aus; wenn die Objekte klein oder weit entfernt sind (Drohnen, Regale weit von der Kamera entfernt), behalte die Auflösung bei und verkleinere stattdessen das Modell.
Weniger Bilder#
Wenn die Inferenz deine Bildrate begrenzt und sich die Szene langsam bewegt, führe die Erkennung mit vid_stride=N nur in jedem N-ten Bild aus und lass den Tracker die Lücken überbrücken:
import time

from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
model.predict(video, vid_stride=30, verbose=False)  # warm up so the first timing is fair

for stride in (1, 2, 3):
    start, ids, frames = time.perf_counter(), set(), 0
    for r in model.track(video, stream=True, vid_stride=stride, tracker="bytetrack.yaml", classes=[0], verbose=False):
        frames += 1
        if r.boxes.is_track:
            ids.update(r.boxes.id.int().tolist())
    print(f"vid_stride={stride}: {frames} frames in {time.perf_counter() - start:.2f} s, {len(ids)} person IDs")
vid_stride=1: 62 frames in 2.66 s, 32 person IDs
vid_stride=2: 31 frames in 1.19 s, 30 person IDs
vid_stride=3: 20 frames in 0.95 s, 28 person IDsBei der Hälfte der Bilder halbiert sich ungefähr auch der Zeitaufwand, und der Tracker behielt 30 von 32 Identitäten bei. Bei vid_stride=3 gingen 4 verloren – ein Zeichen dafür, dass du bei dieser Szene mit Gehgeschwindigkeit aufhören solltest.
Cloud-Kosten senken#
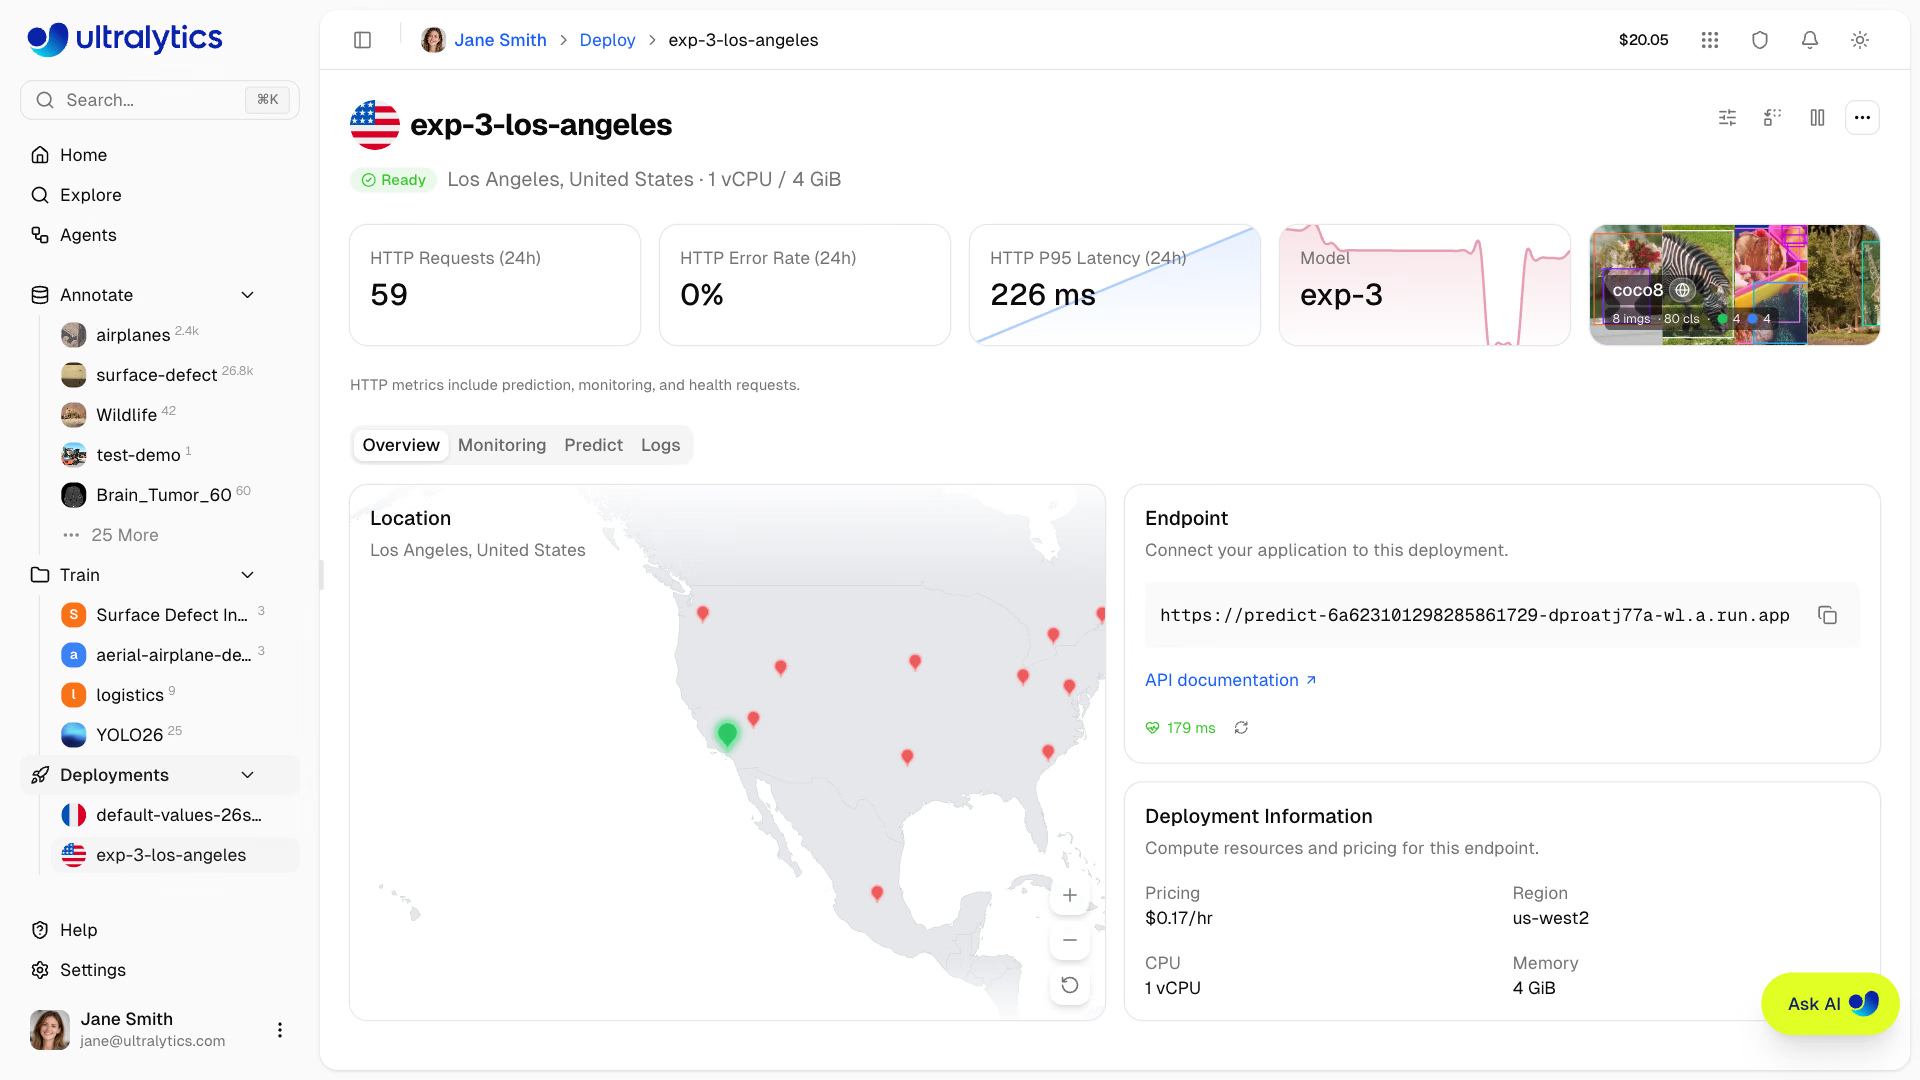
Die Kosten entsprechen den Instanzstunden geteilt durch die nützliche Arbeit. Eine Karte wie diese enthält die beiden benötigten Zahlen: die Kosten pro Stunde (hier 0.17 $ für 1 vCPU und 4 GiB) und die geleistete Arbeit (59 Anfragen in 24 Stunden bei 226 ms P95 – ein größtenteils ungenutzter Endpunkt). Dann:
- Auslastung erhöhen. Eine GPU mit 30 % Auslastung bedeutet, dass 70 % ihrer Kosten verschwendet werden. Bündle Streams (siehe frühere Lektionen) oder stelle sie über den Triton Inference Server bereit.
- Ressourcen passend dimensionieren. Führe Benchmarks auf einer kleineren GPU oder auf einer CPU mit OpenVINO aus, bevor du davon ausgehst, dass du eine große GPU benötigst.
- Nutze Spot- oder unterbrechbare Kapazitäten für Batch-Aufträge. Bei der erneuten Verarbeitung archivierter Videos sind Unterbrechungen tolerierbar; bei Live-Streams nicht.
Stolperfallen#
Symptom: Zwei Wochen Abstimmung sparen 10 ms, aber das System ist weiterhin langsam. Lösung: Erstelle zuerst ein Profil der gesamten Pipeline und behebe die größte Verzögerung – unabhängig davon, wodurch sie verursacht wird.
Symptom: if i % 2: continue innerhalb der Ergebnisschleife spart nichts. Lösung: Das Modell wurde bereits auf diesem Frame ausgeführt; überspringe Frames an der Quelle mit vid_stride.
Symptom: Der Durchsatz ist gestiegen, aber jeder Frame kommt jetzt später an. Lösung: Größere Stapel steigern den Durchsatz pro Euro, nicht die Latenz pro Frame; verwende sie für viele Streams oder Offline-Aufträge, nicht für eine einzelne Echtzeitkamera.
Wenn die Möglichkeiten zur Modelloptimierung ausgeschöpft sind, sind bessere Daten der nächste Hebel. Mit einem Datensatz, der der Produktion entspricht, kann ein kleineres Modell die Genauigkeit erreichen, für die ein größeres Modell nötig war: geringere Kosten ohne Genauigkeitsverlust.
Lösung anzeigen
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on macOS and Windows
    data, img = "coco8.yaml", "https://ultralytics.com/images/bus.jpg"  # use your val YAML and a production frame
    for weights, imgsz in (("yolo26s.pt", 640), ("yolo26n.pt", 640), ("yolo26n.pt", 480)):
        model = YOLO(weights)
        runs = [model(img, imgsz=imgsz, verbose=False)[0].speed["inference"] for _ in range(20)][5:]
        m = model.val(data=data, imgsz=imgsz, batch=1, plots=False, verbose=False).box.map
        print(f"{weights} imgsz={imgsz}: {sorted(runs)[len(runs) // 2]:.1f} ms, mAP50-95 {m:.3f}")
Jede Zeile lässt die ersten fünf Durchläufe zum Aufwärmen aus und gibt den Median der übrigen Durchläufe an. Wähle die erste Zeile, die das Latenzbudget einhält und deren mAP-Verlust innerhalb deines Budgets liegt. Ein Beispiel für ein festgelegtes Budget: „zwei Tage, höchstens 1 mAP-Punkt Verlust, 20 FPS auf dem Rechner im Geschäft“. Wenn yolo26s bei 640 die Grenze von 50 ms pro Frame verfehlt und yolo26n bei 640 sie auf deinem Validierungsdatensatz mit höchstens 1 Punkt Verlust einhält, hör dort auf; verwende den zweiten Tag nicht für 480.