OpenVINO auf der CPU
Exportiere OpenVINO-Modelle in FP32, FP16 und INT8, validiere jedes Modell und behalte INT8 nur dann, wenn es auf deiner CPU Vorteile bringt.
Eine Intel-CPU, die du bereits besitzt, kann oft eine GPU-Instanz ersetzen: In den Ultralytics-Benchmarks sinkt die Laufzeit von YOLO26m von 192 ms in PyTorch auf 36 ms mit OpenVINO INT8 auf einer Core-Ultra-CPU eines Laptops. Die Vorteile hängen jedoch vom Chip ab. Auf dem ARM-Testlaptop dieses Kurses verlor ein INT8-Export, der mit vier Bildern kalibriert wurde, 3 mAP-Punkte. Du lernst, vor der Bereitstellung herauszufinden, welcher Fall auf dich zutrifft.
Praxisnah
Was OpenVINO bietet#
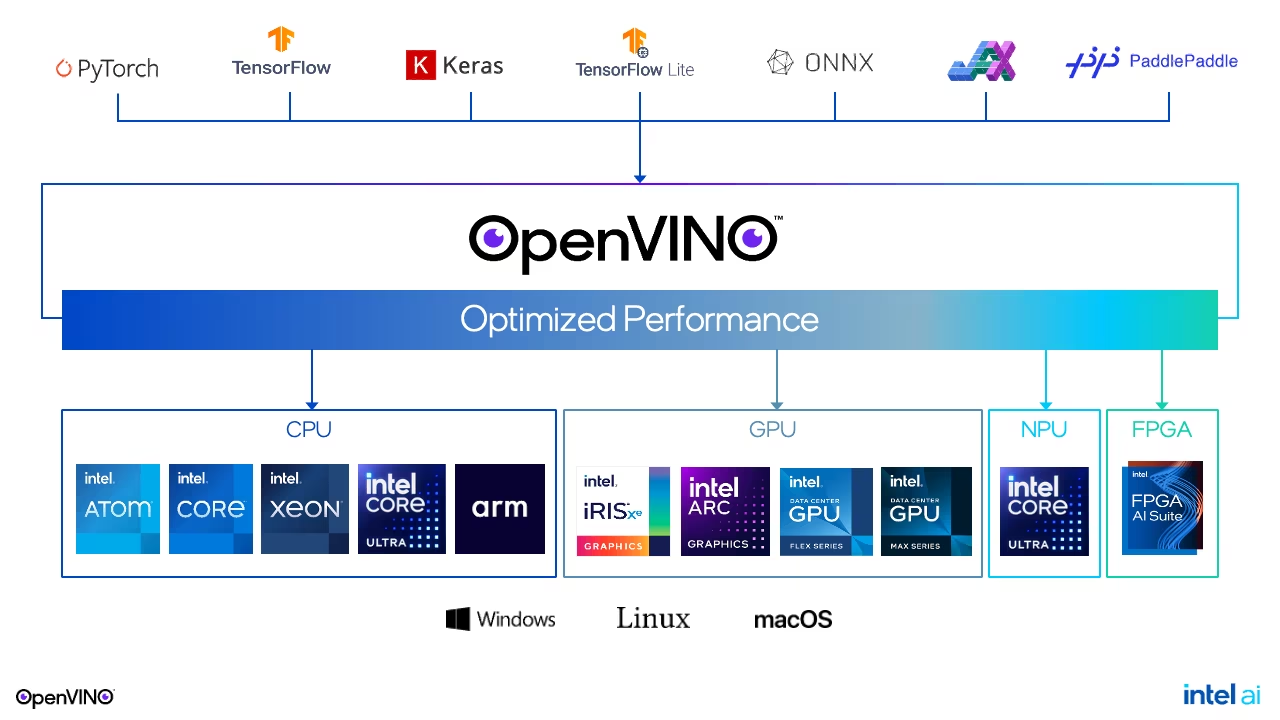
OpenVINO führt Modelle aus PyTorch und ONNX über eine einzige API auf Intel-CPUs, integrierten und diskreten GPUs sowie NPUs aus. Die CPU-Kernel nutzen Intel-Befehlssätze (AVX2, AVX-512, AMX), und die INT8-Unterstützung ist ausgereift. Beachte den ARM-Eintrag in der CPU-Spalte: OpenVINO läuft auch auf ARM, seine Kernel sind jedoch für Intel optimiert. Miss daher die Leistung, bevor du dich darauf verlässt.
Der veröffentlichte Benchmark auf einer Intel Core Ultra 7 155H-CPU (COCO128):
| Modell | PyTorch FP32 | OpenVINO FP32 | OpenVINO INT8 | mAP50-95 FP32 → INT8 |
|---|---|---|---|---|
| YOLO26n | 33.19 ms | 13.43 ms | 11.40 ms | 0.4734 → 0.4611 |
| YOLO26s | 70.92 ms | 36.16 ms | 15.54 ms | 0.5632 → 0.5471 |
| YOLO26m | 192.45 ms | 102.52 ms | 35.72 ms | 0.6191 → 0.6025 |
Aus dieser Tabelle ergeben sich drei Regeln:
- OpenVINO FP32 halbiert auf einer Intel-CPU ungefähr die PyTorch-Latenz. Beginne damit.
- INT8 lohnt sich bei größeren Modellen stärker: 1,2× für
n, 2,9× fürm, bei einem Verlust von 1,2–1,7 mAP-Punkten. Beinlohnt sich INT8 wegen des Genauigkeitsverlusts selten. - Probiere die integrierte GPU aus, bevor du Hardware kaufst: Die Arc-iGPU desselben Chips (
device="intel:gpu") führte YOLO26n FP32 in 9.13 ms und YOLO26m in 34.47 ms aus.
Vergleiche die Genauigkeitsstufen auf deiner eigenen CPU#
Exportiere jede Genauigkeitsstufe, validiere sie sofort und exportiere erst danach die nächste:
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on macOS and Windows
    model = YOLO("yolo26n.pt")  # or runs/detect/pills_v1/weights/best.pt
    for name, quantize in (("FP32", None), ("FP16", 16), ("INT8", 8)):
        path = model.export(format="openvino", quantize=quantize, data="coco8.yaml")  # or my_dataset/data.yaml
        m = YOLO(path).val(data="coco8.yaml", batch=1, plots=False, verbose=False)  # before the next export overwrites it
        print(f"{name}: mAP50-95 {m.box.map:.4f}  -> {path}")
OpenVINO: export success ✅ 2.3s, saved as 'yolo26n_openvino_model/' (9.6 MB)
FP32: mAP50-95 0.6783 -> yolo26n_openvino_model/
OpenVINO: export success ✅ 1.6s, saved as 'yolo26n_openvino_model/' (5.1 MB)
FP16: mAP50-95 0.6783 -> yolo26n_openvino_model/
WARNING ⚠️ OpenVINO: >300 images recommended for INT8 calibration, found 4 images.
OpenVINO: export success ✅ 11.3s, saved as 'yolo26n_int8_openvino_model/' (3.2 MB)
INT8: mAP50-95 0.6460 -> yolo26n_int8_openvino_model/Was dir die einzelnen Zeilen sagen:
- FP32 und FP16 erzielen dieselben Werte, und FP16 ist nur halb so groß (5.1 statt 9.6 MB). Beide wurden jedoch in denselben Ordner geschrieben. Hättest du beide zuerst exportiert und erst danach validiert, hättest du FP16 zweimal gemessen.
- INT8 ist 3.2 MB groß und büßte 3.2 Punkte ein, weil die Kalibrierung mit den vier Bildern von COCO8 durchgeführt wurde. Die Warnung weist darauf hin: Für eine echte Kalibrierung brauchst du Hunderte produktionsnahe Bilder aus deiner eigenen YAML-Datei (
fractionbegrenzt ihre Anzahl). - Nichts davon misst die Geschwindigkeit. Verwende dafür den folgenden Benchmark.
So führst du ein exportiertes Modell auf einem bestimmten Intel-Gerät aus:
from ultralytics import YOLO

ov_model = YOLO("yolo26n_openvino_model/")
results = ov_model("https://ultralytics.com/images/bus.jpg", device="intel:cpu")  # or intel:gpu, intel:npu
Stelle den gesamten Ordner bereit: yolo26n.xml (der Graph), yolo26n.bin (die Gewichte) und metadata.yaml. Für intel:gpu und intel:npu brauchst du Intel-Hardware.
Vergleiche die Laufzeit mit ONNX Runtime#
Die Genauigkeit steht fest; die Geschwindigkeit wird auf dem Zielsystem unter der tatsächlichen Last gemessen. Führe pick_runtime.py aus der ersten Lektion mit CANDIDATES = ("onnx", "openvino") aus. Auf dem Testlaptop mit Apple-Chip, während sich andere Aufgaben die CPU teilten:
onnx      p50  30.0 ms  p95  46.4 ms  misses the 30 ms budget
openvino  p50  22.8 ms  p95 113.5 ms  misses the 30 ms budget
OpenVINO hatte den besseren Medianwert, aber deutlich schlechtere Spitzenwerte. Der Ultralytics-Wrapper kompiliert OpenVINO mit dem Hinweis LATENCY (im Protokoll steht Using OpenVINO LATENCY mode for batch=1 inference on CPU), wodurch jede Anfrage über die CPU-Kerne verteilt wird. Wenn andere Aufgaben dieselben Kerne beanspruchen, leiden die langsamsten Anfragen am stärksten. Auf einem dedizierten Intel-System entspricht das Bild meist dem oben veröffentlichten Benchmark. Aufschluss gibt aber nur dein eigener p95-Wert.
Entscheidungsregeln:
Stolperfallen#
Symptom: Der FP16-Export ist halb so groß, aber genauso langsam. Lösung: Auf den meisten CPUs wählt das Plugin selbst die Ausführungsgenauigkeit; verwende FP16 für kleinere Downloads und INT8 oder die integrierte GPU für mehr Geschwindigkeit.
Symptom: FP32 und FP16 melden identische Werte, weil es sich um dieselbe Datei handelt. Lösung: FP32- und FP16-Exporte verwenden denselben Ordner *_openvino_model/; validiere direkt nach jedem Export oder benenne den Ordner um.
Symptom: Der Durchschnitt sieht gut aus, trotzdem werden in Stoßzeiten Frames ausgelassen. Lösung: Miss die Inferenz bei laufender Produktionslast und richte dich nach p95 statt nach dem Mittelwert. Für viele Streams auf einem Server kannst du mit dem THROUGHPUT-Hinweis kompilieren, indem du das .xml direkt mit der OpenVINO-Laufzeit lädst, wie im Leitfaden zu Latenz- und Durchsatzmodi gezeigt.
Unter macOS und Windows startet die Validierung Worker-Prozesse, die dein Skript erneut importieren. Ohne if __name__ == "__main__": wiederholte der Testlauf für diese Lektion die Exporte in diesen Workern, was Minuten kostete und mit der CPU konkurrierte, deren Leistung gemessen werden sollte.
Lösung anzeigen
python ov_compare.py    # accuracy and size of FP32, FP16, INT8
python pick_runtime.py  # p50 and p95 for ONNX Runtime and OpenVINO
Eine konkrete Entscheidung anhand der obigen Werte für den Core Ultra 7 155H:
| Option | mAP50-95 | Umfang | ms pro Bild |
|---|---|---|---|
| OpenVINO FP32 | 0.4734 | 9.6 MB | 13.43 |
| OpenVINO INT8 | 0.4611 | 3.2 MB | 11.40 |
iGPU FP32 (intel:gpu) | 0.4758 | 9.6 MB | 9.13 |
Setze OpenVINO FP32 auf der integrierten GPU ein: Das ist die schnellste Option ohne Genauigkeitsverlust, während INT8 auf der CPU 1,2 Punkte kosten würde, um 2 ms einzusparen. Bei einer YOLO26m-Bereitstellung fällt die Entscheidung anders aus: CPU INT8 ist 2,9× schneller und kostet 1,7 Punkte, sofern dieser Verlust innerhalb deines Budgets liegt.