Elige la tarea y planifica la canalización
Asocia cada pregunta sobre el producto con una de las siete tareas YOLO de Ultralytics, junto con sus pesos, campo de resultado, formato de etiquetas y métrica de aceptación, y demuestra el plan ejecutando cada tarea sobre una imagen.
Una vez que se pone en producción un detector, las siguientes peticiones rara vez son «más cajas». Suelen ser «¿qué tamaño tiene el vertido?», «¿tiene la espalda encorvada el trabajador?», «¿hacia dónde apunta el barco?» y «¿esta pieza es defectuosa?». En la foto de una calle que se usa a lo largo de este curso, la caja delimitadora del autobús ocupa el 48 % del fotograma, mientras que el propio autobús ocupa el 29 %, así que calcular el área a partir de la caja daría un resultado con más de la mitad de error. La tarea que elijas determina el formato de las etiquetas, por lo que elegirla antes de que nadie etiquete nada es la decisión más barata del proyecto; cambiarla más adelante implica volver a etiquetar.
Práctico
Una foto, cuatro respuestas diferentes#

Haz una pregunta sobre una foto: ¿qué parte de este fotograma ocupa el autobús y a qué distancia está?; deja que cuatro tareas YOLO de Ultralytics respondan:
from ultralytics import YOLO

image = "https://ultralytics.com/images/bus.jpg"
det = YOLO("yolo26n.pt")(image, verbose=False)[0]
seg = YOLO("yolo26n-seg.pt")(image, retina_masks=True, verbose=False)[0]
sem = YOLO("yolo26n-sem.pt")(image, verbose=False)[0]
depth = YOLO("yolo26n-depth.pt")(image, verbose=False)[0]
frame = det.orig_shape[0] * det.orig_shape[1]  # pixels in the photo

i = [det.names[int(c)] for c in det.boxes.cls].index("bus")
x1, y1, x2, y2 = det.boxes.xyxy[i].tolist()
print(f"detect    bus box covers   {(x2 - x1) * (y2 - y1) / frame:.1%} of the frame")

i = [seg.names[int(c)] for c in seg.boxes.cls].index("bus")
bus_mask = seg.masks.data[i].bool()  # H x W, True on bus pixels
print(f"segment   bus mask covers  {bus_mask.sum().item() / frame:.1%} of the frame")

ratios = {row["name"]: row["pixel_ratio"] for row in sem.summary()}
print(f"semantic  'train' pixels   {ratios['train']:.1%} of the frame")

meters = depth.depth.data[bus_mask].median().item()  # depth map and mask share the original size
print(f"depth     bus is about     {meters:.1f} m from the camera")
detect bus box covers 47.7% of the frame
segment bus mask covers 29.2% of the frame
semantic 'train' pixels 30.9% of the frame
depth bus is about 4.5 m from the cameraLéelo línea por línea:
- detect responde dónde. La caja también incluye la carretera bajo el autobús y a las cuatro personas que están delante, así que el área resulta un 63 % demasiado grande.
- segment responde qué forma. El 29,2 % es la huella real del autobús en la imagen, el valor que debes usar para cualquier regla de área, cobertura o solapamiento.
- semantic responde qué píxeles pertenecen a cada clase. El área se aproxima a la de la máscara, pero el modelo clasifica el autobús como
train: etiqueta las superficies con las clases de su conjunto de entrenamiento (Cityscapes, lección 4) y nunca distingue un vehículo de otro. - depth responde a qué distancia. La profundidad mediana dentro de la máscara del autobús es de 4,5 m: se combinan dos tareas para responder a una pregunta que ninguna de ellas puede contestar por sí sola.
Si el valor que informa tu producto es un área, una proporción de cobertura o un solapamiento, un cuadro no es la herramienta adecuada. Usa una máscara (segmentación de objetos) o un mapa de clases (segmentación semántica) para las superficies.
Resumen de las siete tareas#
Fundamentos de visión artificial explica en detalle cómo elegir entre tareas: vuelve a consultar Las siete tareas de visión si la elección no está clara. Este es el resumen práctico para el resto del curso. Cada fila corresponde a una tarea que el paquete ultralytics instalado entrena, valida, ejecuta y exporta con la misma API; la descripción general de las tareas es la referencia completa.
| Pregunta que responde la salida | Tarea | Pesos de YOLO26 | Campo de resultado | Formato de etiquetas | Métrica de aceptación |
|---|---|---|---|---|---|
| ¿Dónde está cada objeto? | detect | yolo26n.pt | boxes | clase + caja | mAP50-95 de cajas |
| ¿Qué forma y área exactas tiene cada objeto? | segment | yolo26n-seg.pt | masks + boxes | clase + polígono | mAP50-95 de máscaras |
| ¿A qué clase pertenece cada píxel? | semantic | yolo26n-sem.pt | semantic_mask | Mapa de clases PNG o polígonos | mIoU |
| ¿Dónde están las articulaciones o los puntos de referencia? | pose | yolo26n-pose.pt | keypoints + boxes | clase + caja + puntos clave | mAP50-95 de pose (OKS) |
| ¿Cómo está girado cada objeto? | obb | yolo26n-obb.pt | obb | clase + 4 esquinas | mAP50-95 de OBB |
| ¿Qué es esta imagen completa (o recorte)? | classify | yolo26n-cls.pt | probs | una carpeta por clase | precisión top-1 |
| ¿A qué distancia de la cámara está cada píxel? | depth | yolo26n-depth.pt | depth | mapa de profundidad por imagen (PNG de 16 bits o NPY) | δ1 (delta1) |
Ya pones en producción la primera fila. Las lecciones 2 a 8 enseñan las cinco filas intermedias, y las lecciones 9 y 10 las encadenan y las ponen en producción. La última fila, la estimación monocular de profundidad, predice una distancia en metros para cada píxel de una sola imagen. Las etiquetas proceden de sensores de profundidad o renderizadores 3D, en lugar de anotadores, por lo que tienen su propio formato de conjunto de datos; este curso las incluye donde se comparte el flujo de trabajo: en este plan, el ciclo de validación y la comprobación de exportación de la última lección.
Elige una pregunta cada vez#
Recorre las preguntas en orden y detente en la primera respuesta afirmativa:
El diagrama cubre los casos habituales. Cuatro criterios de desempate cubren la mayoría de los demás:
| Si la petición… | Elige | Porque |
|---|---|---|
| necesita un recuento y un área («¿cuántos vertidos hay y qué tamaño tienen?») | segment | la segmentación semántica fusiona los objetos que se tocan en una sola región |
| incluye objetos largos y estrechos, muy juntos y vistos desde arriba | obb | las cajas alineadas con los ejes se solapan y NMS descarta objetos reales, aunque nunca consultes el ángulo |
| necesita distinguir delante de detrás o izquierda de derecha | pose | un OBB proporciona un eje, no un rumbo |
| muestra exactamente un elemento por imagen por diseño (una estación de inspección fija) | classify | las etiquetas más baratas y el modelo más rápido |
La tarea queda fijada al crear el conjunto de datos —en Ultralytics Platform es el campo Task Type del cuadro de diálogo New Dataset—, así que debes tomar esta decisión antes de crear la primera etiqueta:

Una API, siete campos de resultado#
Todas las tareas usan la misma llamada; el modelo obtiene la tarea del archivo de pesos. Lo que cambia es el campo del resultado que se rellena, y ese es el campo que leerá tu código:
from ultralytics import YOLO

WEIGHTS = ["yolo26n.pt", "yolo26n-seg.pt", "yolo26n-sem.pt", "yolo26n-pose.pt", "yolo26n-obb.pt", "yolo26n-cls.pt", "yolo26n-depth.pt"]
FIELDS = ("boxes", "masks", "semantic_mask", "keypoints", "obb", "probs", "depth")

for weights in WEIGHTS:
    model = YOLO(weights)
    result = model("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
    fields = [f for f in FIELDS if getattr(result, f) is not None]
    print(f"{weights:17s} task={model.task:9s} fields={fields}")
yolo26n.pt task=detect fields=['boxes']
yolo26n-seg.pt task=segment fields=['boxes', 'masks']
yolo26n-sem.pt task=semantic fields=['semantic_mask']
yolo26n-pose.pt task=pose fields=['boxes', 'keypoints']
yolo26n-obb.pt task=obb fields=['obb']
yolo26n-cls.pt task=classify fields=['probs']
yolo26n-depth.pt task=depth fields=['depth']Los resultados de segmentación y pose conservan boxes, así que el código de detección que ya tienes también funciona con ellos. Los resultados de clasificación, segmentación semántica y profundidad describen la imagen completa y no tienen campos por objeto.
El código de detección que recorre result.boxes se detiene con TypeError: 'NoneType' object is not iterable si se usa un modelo OBB: result.boxes es None, y las detecciones rotadas solo están en result.obb. Adapta el código de detección a OBB leyendo result.obb, en lugar de comprobar None y acabar sin detecciones.
Cuando un modelo no basta#
La mayoría de los sistemas de producción que van más allá de la detección adoptan una de estas tres formas:
- Detectar y después clasificar. El detector encuentra objetos pequeños en un fotograma grande; un clasificador de imágenes toma una decisión detallada sobre cada recorte a resolución completa: tipo de casco, grado de defecto o SKU del producto.
- Pose más seguimiento. Los puntos clave describen un fotograma; un rastreador los convierte en una serie temporal por persona que permite contar repeticiones o detectar caídas.
- Segmentar y después medir. El modelo devuelve píxeles; un código sencillo los convierte en áreas, anchuras, proporciones de cobertura o distancias (con profundidad).
Las etiquetas de una canalización que segmenta y después mide consisten en un polígono por objeto, como estos paquetes sobre robots de almacén en el editor de Ultralytics Platform:
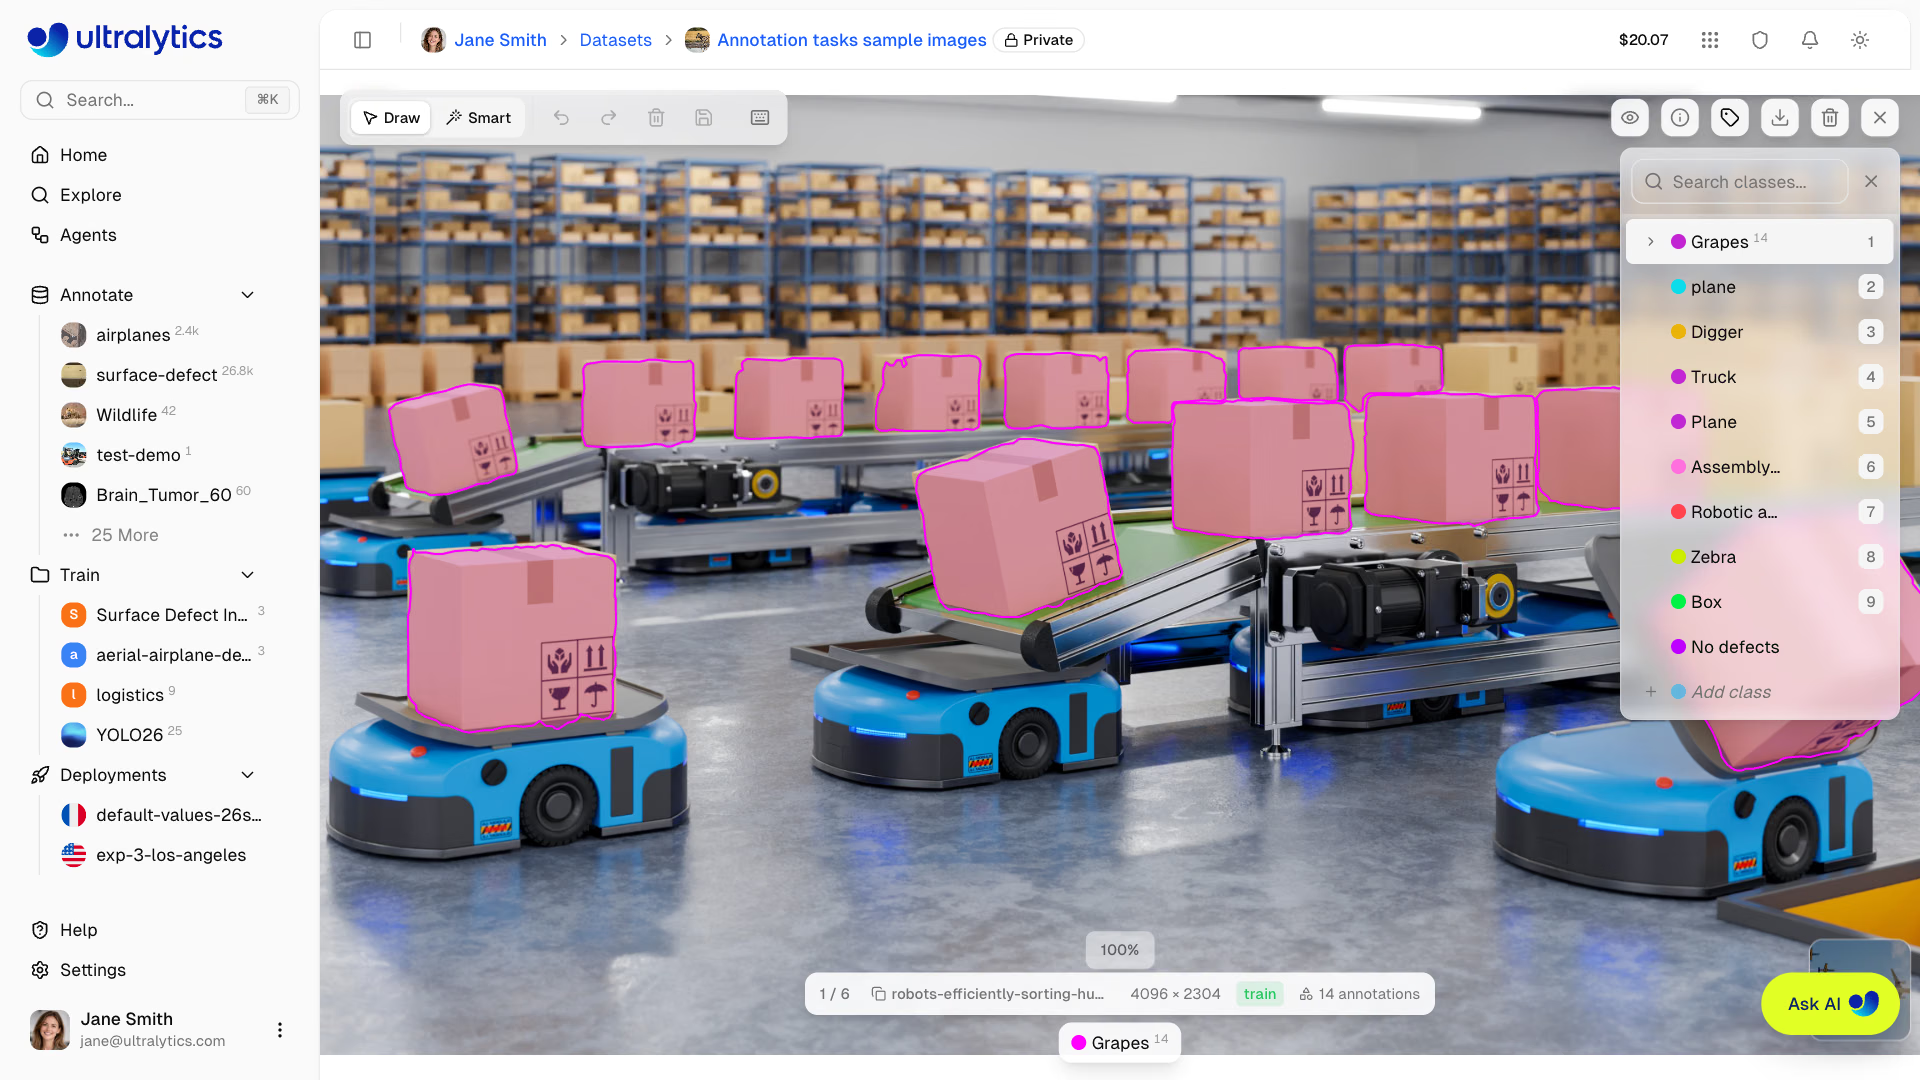
Un segundo modelo añade latencia de inferencia, un segundo conjunto de datos que etiquetar y mantener, y un segundo modelo que supervisar. Encadena modelos solo cuando una tarea no pueda responder a la pregunta: un plan con un modelo que puedas distribuir es mejor que uno con tres modelos que no puedas etiquetar.
Errores habituales#
Síntoma: el equipo etiqueta polígonos porque las máscaras quedan bien en las demostraciones, pero el producto solo utiliza un recuento. Solución: antes de etiquetar, identifica la línea de código que consume el resultado. Si nadie usa el contorno, distribuye un detector: los cuadros se etiquetan y se procesan más rápido.
Síntoma: tras un mes de etiquetado, alguien se da cuenta de que el producto necesita una orientación y el conjunto de datos contiene etiquetas OBB, que solo proporcionan un eje. Solución: escribe el atributo exacto en el plan (result.masks.xy, result.keypoints.xy, result.obb.xywhr) y ejecuta tasks.py con los pesos elegidos antes de crear la primera etiqueta.
Síntoma: un clasificador que obtiene un 95 % en fotos de productos nítidas falla con la mayoría de los recortes del detector en producción. Solución: crea el conjunto de datos de la segunda etapa con los propios recortes de la primera, incluidos el desenfoque y el encuadre reales; la lección 9 explica cómo.
Mostrar solución
Para la petición sobre palés:
| Fila | Opción |
|---|---|
| Pregunta | ¿Sobresale alguna parte de un palé de la línea de la viga de la estantería? |
| Tarea | segment: para determinar si sobresale algo, hace falta el contorno del palé; su caja también abarca el hueco bajo el palé y la carga que lleva encima |
| Pesos | yolo26n-seg.pt, ajustado con imágenes de las cámaras del almacén |
| Formato de etiquetas | Un polígono por palé |
| Campo de resultado | result.masks.data con retina_masks=True (píxeles que sobresalen de la línea de la viga) |
| Métrica de aceptación | mAP50-95 de máscaras en una cámara excluida del entrenamiento |
| Segunda fase | Ninguna: la línea de la viga es fija para cada cámara, así que es una configuración, no un modelo. |
La regla del voladizo se reduce entonces a tres líneas de código: dibuja la línea de la viga una vez para cada cámara, cuenta los píxeles de la máscara que quedan al lado incorrecto y genera una alerta cuando se supere un umbral de píxeles que calibres con unos cuantos voladizos conocidos. La lección 3 muestra exactamente este tipo de prueba entre máscara y región.