Entrena un clasificador de imágenes
Organiza un conjunto de datos en carpetas, entrena yolo26n-cls.pt con MNIST160, consulta probs y la precisión top-1, y envía las predicciones con poca confianza a revisión humana.
La clasificación de imágenes responde a una pregunta por imagen: ¿qué es esto? Solo necesita las etiquetas más sencillas de cualquier tarea —el nombre de una carpeta— y es la más rápida, por lo que es la segunda etapa predeterminada después de un detector y el primer modelo adecuado para una estación de inspección que ve una pieza por fotograma. Su conjunto de datos no tiene YAML, así que la estructura de carpetas es el contrato, y un clasificador siempre responde, incluso ante imágenes que no se parecen en nada a las que ha visto. Decidir cuándo no fiarse de él es la mitad del trabajo.
Práctico
Estructura del conjunto de datos en carpetas#
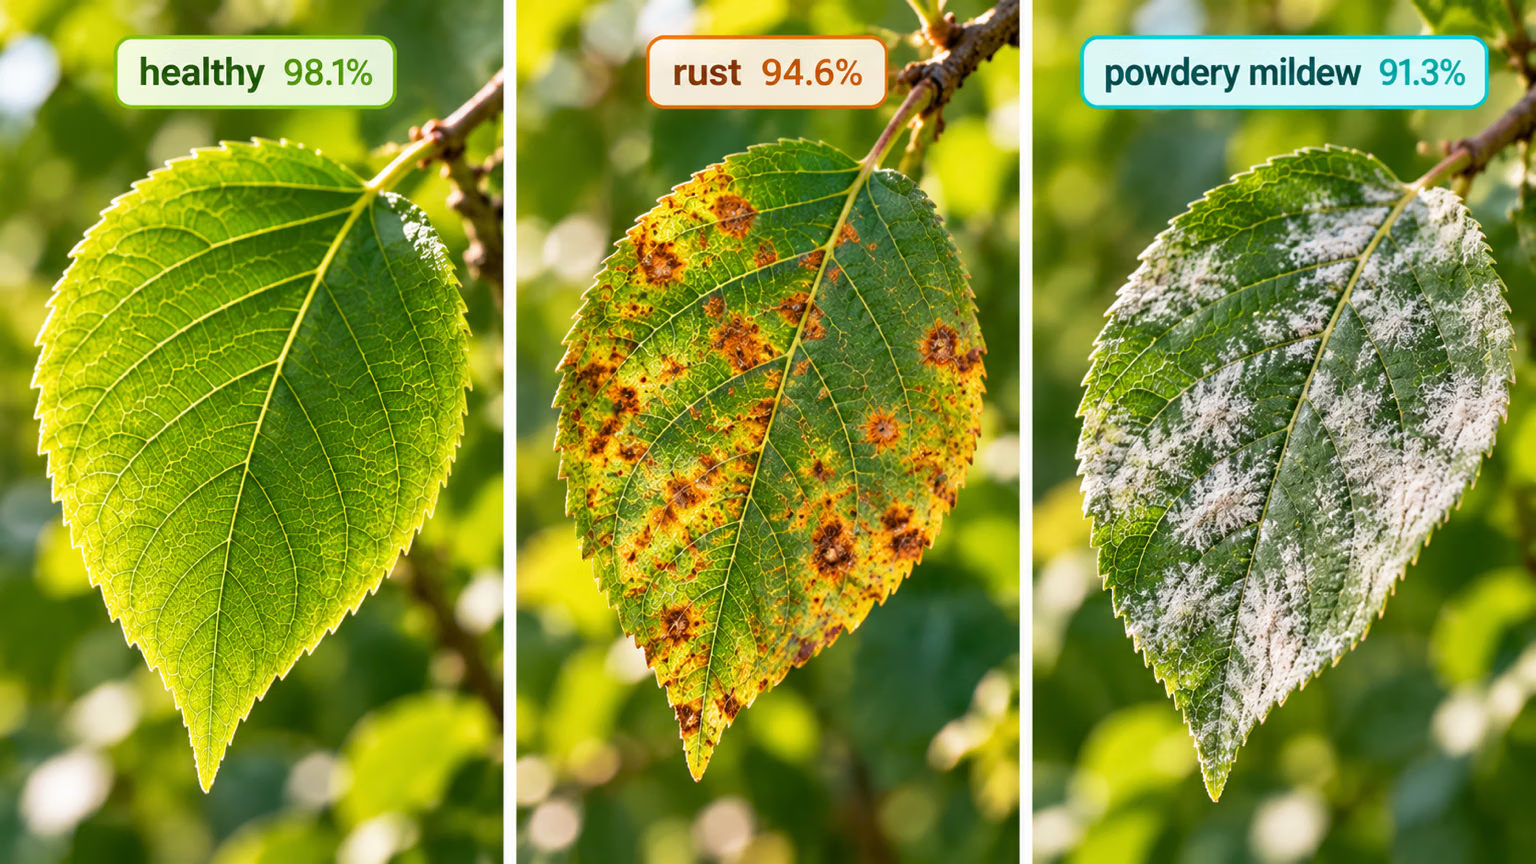
Los conjuntos de datos de clasificación son directorios, no archivos YAML. Indica la carpeta raíz en data=:
parts/
├── train/
│   ├── good/      img_0001.jpg ...
│   ├── scratch/   img_0412.jpg ...
│   └── dent/      img_0733.jpg ...
└── val/
    ├── good/
    ├── scratch/
    └── dent/
Esto es lo que hace el cargador con el conjunto, según el código fuente instalado y la guía de conjuntos de datos de clasificación:
| Situación | Comportamiento |
|---|---|
| Índices de clase | nombres de carpetas dentro de train/, ordenados alfabéticamente → dent=0, good=1, scratch=2 |
| Carpeta de validación | val/, luego validation/ y después valid/; recurre a test/ con un aviso |
No hay carpeta train/, solo carpetas de clase | Divide automáticamente los datos en un 80/20 entre train/ y val/ |
En Ultralytics Platform, un conjunto de datos de clasificación lleva una etiqueta por imagen, en lugar de formas:
Síntoma: después de añadir una clase, una integración antigua identifica partes good como dent. Causa: al añadir una carpeta llamada bent, esta queda la primera en el orden y desplaza todos los índices posteriores. Solución: asigna siempre los índices a los nombres con model.names (o result.names); nunca fijes un índice en el código.
Entrena con MNIST160#
MNIST160 contiene 160 dígitos escritos a mano: 80 en train/ y 80 en test/, cada grupo dividido en diez carpetas de dígitos; es lo bastante pequeño para una prueba de humo en CPU. No tiene carpeta val/, así que observa cómo el cargador muestra un aviso y recurre a test/:
from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")
model.train(data="mnist160", epochs=1, imgsz=64, device="cpu")
metrics = model.val()
print(f"top-1: {metrics.top1:.3f}  top-5: {metrics.top5:.3f}")
WARNING ⚠️ Dataset 'split=val' not found, using 'split=test' instead.
val: .../datasets/mnist160/test... found 80 images in 10 classes ✅
all 0.162 0.463
top-1: 0.162 top-5: 0.463Una época apenas mejora la nueva cabeza de diez clases. En nuestra ejecución, epochs=10 alcanzó una precisión top-1 de 0.55 y top-5 de 0.95 en unos diez segundos con la CPU de un portátil: el ciclo funciona, pero necesita más épocas. La guía de la tarea de clasificación enumera los tamaños preentrenados.
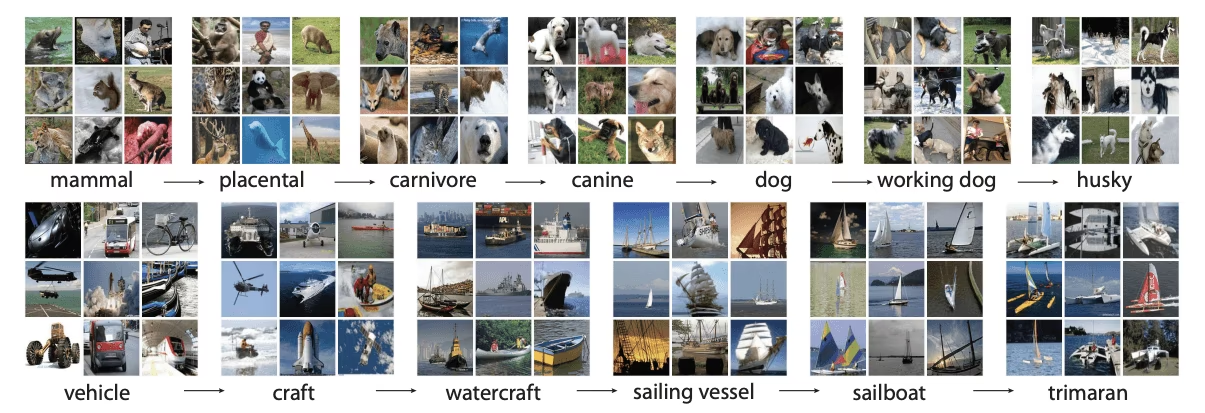
Top-1 es la proporción de imágenes cuya clase con mayor probabilidad es correcta. Top-5 considera que hay acierto si la clase correcta está entre las cinco de mayor probabilidad. Top-5 es informativa en ImageNet, con 1000 clases que van de categorías generales a otras muy específicas; con cinco clases o menos, siempre es 1.0, y con diez es poco exigente. Evalúa según la precisión top-1 y una matriz de confusión por clase.
Consulta las probabilidades en el código#
from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")  # ImageNet, 1,000 classes
result = model("https://ultralytics.com/images/bus.jpg")[0]

probs = result.probs
print(f"top-1: {result.names[probs.top1]} ({float(probs.top1conf):.2f})")
for i, conf in zip(probs.top5, probs.top5conf.tolist()):
    print(f"  {result.names[i]:20s} {conf:.3f}")
top-1: minibus (0.52)
minibus 0.516
police_van 0.369
trolleybus 0.096
minivan 0.006
ambulance 0.003probs.top1 es un índice, probs.top5 es una lista de índices y probs.data es el vector completo de probabilidades. Fíjate en la confianza top-1: 0.52 apenas supera el azar al elegir entre minibus y police_van. Ese es el valor que usarás para decidir.
Envía las predicciones dudosas a una persona#
Un clasificador en producción rara vez tiene que acertar en todas las imágenes; tiene que acertar en las imágenes que procesa por sí solo. Este script entrena el modelo durante 10 épocas y luego mide el efecto de distintos umbrales de confianza en los 80 dígitos reservados para la evaluación:
from pathlib import Path

from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")
model.train(data="mnist160", epochs=10, imgsz=64, device="cpu", plots=False)  # model now holds best.pt
print(model.names)  # folder names, sorted, became class indices

test = Path(model.trainer.data["test"])  # mnist160/test, the split the loader validated on
images = sorted(test.rglob("*.png"))
results = model(images, imgsz=64, verbose=False)
truth = [p.parent.name for p in images]

for threshold in (0.0, 0.3, 0.6):
    kept = [(r, t) for r, t in zip(results, truth) if r.probs.top1conf >= threshold]
    correct = sum(r.names[r.probs.top1] == t for r, t in kept)
    print(f"threshold {threshold:.1f}: auto-accept {len(kept):2d}/{len(images)}, accuracy on accepted {correct / max(len(kept), 1):.0%}")
{0: '0', 1: '1', 2: '2', 3: '3', 4: '4', 5: '5', 6: '6', 7: '7', 8: '8', 9: '9'}
threshold 0.0: auto-accept 80/80, accuracy on accepted 55%
threshold 0.3: auto-accept 41/80, accuracy on accepted 68%
threshold 0.6: auto-accept 10/80, accuracy on accepted 80%Cada fila representa una contrapartida: al subir el umbral, las predicciones aceptadas son más precisas y se envían más imágenes a una persona. Con 0.6, este modelo decide por sí solo solo en 10 de los 80 dígitos: aún no está listo para automatizar nada, y la solución es entrenar más, no elegir un umbral más ingenioso. Vuelve a ejecutar la misma tabla después de cada ronda de entrenamiento: te indica tanto la precisión que obtendrás como la cantidad exacta de trabajo de revisión que genera cada umbral.
Elige el umbral más bajo cuya precisión en las imágenes aceptadas cumpla tus requisitos, medida con datos reservados. Después, comprueba que tu equipo puede gestionar el volumen de revisiones que genera; si no, mejora el modelo.
Errores habituales#
Síntoma: una estación vacía, una pieza incorrecta o una mano delante de la lente reciben una etiqueta de clase con mucha confianza. Causa: las probabilidades de softmax siempre suman 1, por lo que el clasificador siempre elige una de sus clases. Solución: añade una carpeta other/ que contenga únicamente esas imágenes y envía a revisión las predicciones con un valor bajo de top1conf.
Síntoma: un modelo preentrenado obtiene una puntuación cercana a cero en tu conjunto de datos antes de entrenarlo. Causa: yolo26n-cls.pt predice 1.000 índices de ImageNet, y tus carpetas reutilizan los índices del 0 al 9 con significados distintos: en MNIST160, la carpeta 0 es el índice 0, al que la cabeza preentrenada asigna tench. Así medimos un top-1 de 0.000. Solución: ajusta el modelo primero y valídalo después.
Síntoma: el top-1 se acerca a 1.0 en validación, pero es mucho más bajo en producción. Causa: hay fotos casi duplicadas de la misma pieza en train/ y val/. Solución: divide los datos por pieza o por sesión, como se explica en Divide correctamente el conjunto de datos.
Los clasificadores se preentrenan con imgsz=224, no con 640. Para los objetos pequeños dentro de un fotograma grande, es mejor detectar y luego clasificar (la siguiente lección) que usar un imgsz más grande.
Mostrar solución
from ultralytics import YOLO

for epochs in (1, 10):
    model = YOLO("yolo26n-cls.pt")
    model.train(data="mnist160", epochs=epochs, imgsz=64, device="cpu")
    metrics = model.val()
    print(f"{epochs:2d} epochs  top-1: {metrics.top1:.3f}  top-5: {metrics.top5:.3f}")
print(model.names)  # {0: '0', 1: '1', ..., 9: '9'}
Nuestras ejecuciones: 1 época → top-1 0.162, top-5 0.463; 10 épocas → top-1 0.550, top-5 0.950. Con cinco clases, la respuesta correcta siempre está entre las cinco primeras, así que top-5 es 1.0 por definición y no aporta información.
Para lograr una precisión del 75 % en las imágenes aceptadas, route.py indica 0.6 (un 80 % en 10 imágenes aceptadas), lo que envía 70 de los 80 dígitos a revisión. Esa es la respuesta honesta: el umbral cumple el requisito de precisión, pero el modelo aún no es útil. Entrena durante más tiempo y vuelve a ejecutar la tabla antes de elegir un umbral para un caso real.