Segmentación semántica: etiqueta cada píxel
Predice un mapa de clases por píxel con yolo26n-sem.pt, conviértelo en cifras de cobertura, crea conjuntos de datos de mapas de clases PNG e interpreta mIoU sin dejarte engañar por la precisión por píxel.
Algunas preguntas no requieren contar objetos: ¿qué parte de la acera está bloqueada?, ¿qué parte de un campo son malas hierbas?, ¿dónde termina la calzada? La segmentación semántica responde con un ID de clase por píxel. Sin embargo, su métrica principal es fácil de malinterpretar: el modelo que entrenas en esta lección obtiene una precisión por píxel del 91 % sin detectar ni a una sola persona.
Práctico
¿Instancias o semántica?#
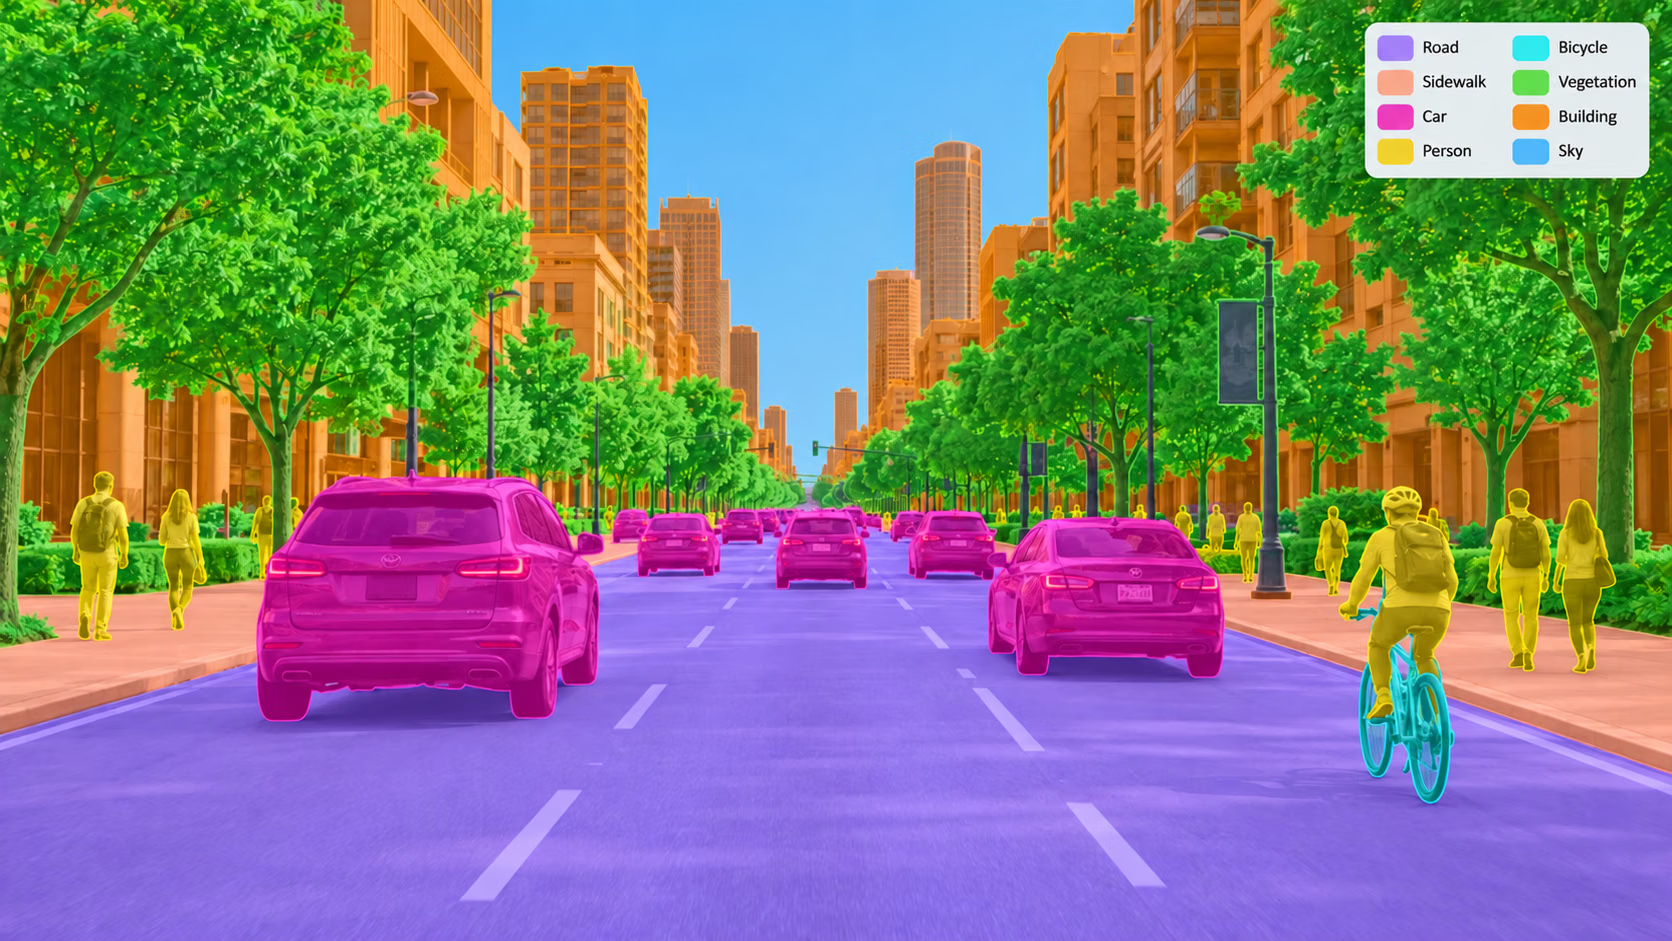
Segmentación de instancias (segment) | Segmentación semántica (semantic) | |
|---|---|---|
| Salida | una máscara por objeto, además de una caja | un ID de clase por píxel |
| Cuenta objetos | sí | no: dos coches en contacto forman una sola región de «coche» |
| Gestiona elementos de tipo «fondo» (calzada, cielo, hierba) | mal: no hay instancias naturales | sí |
| Etiquetas | polígonos | mapas de clases PNG o polígonos |
| Métrica de aceptación | mAP50-95 de máscaras | mIoU |
| Pesos preentrenados | yolo26n-seg.pt (COCO, 80 clases) | yolo26n-sem.pt (Cityscapes, 19 clases) |
Si la pregunta posterior es «¿cuántos?», usa segmentación de instancias. Si es «¿cuánto?» o «¿dónde?», la segmentación semántica es más sencilla de etiquetar e interpretar. La página de la tarea de segmentación semántica contiene la tabla de modelos.
Predice un mapa de clases#
result.semantic_mask.data es un tensor H × W al tamaño original de la imagen; cada valor es un ID de clase y 255 significa ignorar. result.summary() lo convierte en proporciones de píxeles por clase:
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")  # Cityscapes, 19 classes
result = model("https://ultralytics.com/images/bus.jpg")[0]

class_map = result.semantic_mask.data  # H x W tensor of class ids, 255 = ignore
print("class map:", tuple(class_map.shape), class_map.dtype)
for row in result.summary():
    if row["pixel_ratio"] >= 0.02:
        print(f"{row['name']:12s} {row['pixel_ratio']:.1%}")
class map: (1080, 810) torch.uint8
road 27.5%
sidewalk 2.0%
building 19.3%
vegetation 4.5%
person 14.6%
train 30.9%Fíjate en la última fila. Cityscapes tiene una clase bus, pero el modelo clasifica el autobús como train. Ha aprendido a partir de imágenes grabadas desde coches, principalmente en calles alemanas, y un autobús fotografiado desde la acera y de cerca queda fuera de esa distribución. Los modelos semánticos heredan el punto de vista y las definiciones de clase del conjunto de entrenamiento —su sesgo del conjunto de datos— con más rigidez que los detectores; por eso, ajusta el modelo con imágenes de tu cámara antes de confiar en el mapa.
Convierte el mapa de clases en una respuesta#
Un mapa de clases se convierte en una cifra de producto con simples comparaciones de tensores. Por ejemplo: «¿qué parte de la zona por la que caminaría un peatón es calzada o acera, y qué parte está ocupada por personas?»:
from ultralytics import YOLO

result = YOLO("yolo26n-sem.pt")("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
class_map = result.semantic_mask.data  # H x W class ids at the original size, 255 = ignore
ids = {name: i for i, name in result.names.items()}

h = class_map.shape[0]
lower = class_map[h // 2 :]  # the half of the frame a pedestrian would walk into
walkable = (lower == ids["road"]) | (lower == ids["sidewalk"])
people = lower == ids["person"]
print(f"lower half: {walkable.float().mean():.0%} road or sidewalk, {people.float().mean():.0%} person")
result.save("semantic_overlay.jpg")  # colored class map over the photo, for a visual check
lower half: 59% road or sidewalk, 23% personTres hábitos hacen que estas cifras sean fiables:
- Busca los ID por nombre en
result.names, nunca con un número fijo: un modelo entrenado con tus propias clases les asignará números distintos. - Limítate a la región relevante. Las proporciones de todo el fotograma incluyen el cielo y los edificios; primero recorta el mapa de clases o multiplícalo por una máscara de región.
- Abre la superposición.
semantic_overlay.jpgmuestra de un vistazo si lo que la cifra cuenta como «calzada» es realmente calzada.
El formato del conjunto de datos#
Los conjuntos de datos semánticos asocian cada imagen con una imagen de máscara de un solo canal cuyos valores de píxel son ID de clase. La guía de conjuntos de datos semánticos es la referencia; la estructura replica images/ archivo por archivo:
cityscapes8/
├── images/
│   ├── train/aachen_000000_000019.png
│   └── val/aachen_000004_000019.png
└── masks/
    ├── train/aachen_000000_000019.png
    └── val/aachen_000004_000019.png
El YAML añade masks_dir y, cuando los ID almacenados en tus máscaras difieren de los ID de entrenamiento, un bloque label_mapping:
path: cityscapes8
train: images/train
val: images/val
masks_dir: masks # semantic mask directory

names:
  0: road
  1: sidewalk
  # ... 19 classes in total

label_mapping: # raw mask value -> training id
  0: ignore_label
  7: 0 # road
  8: 1 # sidewalk
  # ...
Las máscaras de Cityscapes almacenan ID de etiquetas sin procesar de -1 a 33; la asignación conserva 19 de ellos y asigna el resto a ignore_label, almacenado como 255. Los píxeles con valor 255 se excluyen tanto de la función de pérdida como de las métricas: usa el mismo valor para las regiones sobre las que tus anotadores no pudieron decidirse.
Si ya tienes etiquetas de polígonos y no tienes masks_dir, el cargador rasteriza los polígonos por ti y añade una clase background para los píxeles sin cubrir.
La compresión con pérdida mezcla los valores de píxeles vecinos y convierte el límite entre las clases 7 y 8 en una mezcla de 7, 8 e identificadores que no existen. Guarda todas las máscaras como PNG o TIFF.
Entrena e interpreta mIoU#
Cityscapes8 tiene 8 imágenes de escenas urbanas, 4 para entrenamiento y 4 para validación: suficientes para una prueba rápida en CPU:
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")
model.train(data="cityscapes8.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"mIoU: {metrics.miou:.3f}  pixel accuracy: {metrics.pixel_accuracy:.3f}")
Class Images Pixels mIoU PixAcc
all 4 192315 0.415 0.906
road 4 78529 0.974 0.996
vegetation 4 37602 0.844 0.936
person 3 722 0 0
rider 1 21 0 0
mIoU: 0.415 pixel accuracy: 0.906(Se han omitido algunas filas por clase). La precisión por píxel indica un 91 %; mIoU indica un 42 %; y las filas por clase muestran que el modelo no ha detectado ni a una sola persona. Las tres cifras son correctas. La calzada, los edificios y la vegetación ocupan la mayoría de los píxeles —solo la calzada ocupa 78,529 de 192,315—, así que un modelo que los clasifica bien obtiene una precisión por píxel alta aunque no detecte ninguna de las clases pequeñas. mIoU calcula la media del IoU por clase con el mismo peso, así que cada clase que no se detecta reduce el resultado.

Establece un umbral tanto para mIoU como para la IoU de las clases en las que actúa tu producto. Una función de seguridad para peatones con una IoU de persona de 0 falla, independientemente de lo que indique la precisión por píxel.
Mostrar solución
En nuestra ejecución: mIoU 0.415, precisión por píxel 0.906 e IoU 0 para pared, persona, ciclista, motocicleta y bicicleta, además de para todas las clases sin píxeles en las cuatro imágenes de validación.
La precisión por píxel es mayor porque cuenta píxeles, y la calzada, los edificios, la vegetación y el cielo ocupan la mayor parte de cada fotograma de Cityscapes. mIoU da el mismo peso a cada clase, así que cinco clases pequeñas no detectadas reducen la media aunque solo ocupen unos cientos de píxeles. En un producto que actúa sobre personas, este modelo no supera el umbral de calidad solo por su IoU de persona.