Etiquetar y entrenar la segmentación de instancias
Escribe etiquetas de polígonos, compruébalas en el código, entrena yolo26n-seg.pt con COCO8-seg y diagnostica un modelo a partir de la diferencia entre sus métricas de cajas y máscaras.
La segmentación de instancias proporciona a cada objeto su propio contorno, algo necesario cuando la decisión depende del área, el solapamiento o un límite. Los polígonos son las etiquetas más costosas que compran la mayoría de los equipos, y una fila mal formada no hace que falle el entrenamiento: entrena silenciosamente con la forma incorrecta. En esta lección se corrige el formato de las filas, se comprueba un conjunto de etiquetas con código y se entrena un primer modelo para que veas qué aporta el etiquetado adicional: una segunda métrica que evalúa los contornos, no solo las posiciones.
Práctico
La fila de etiqueta del polígono#
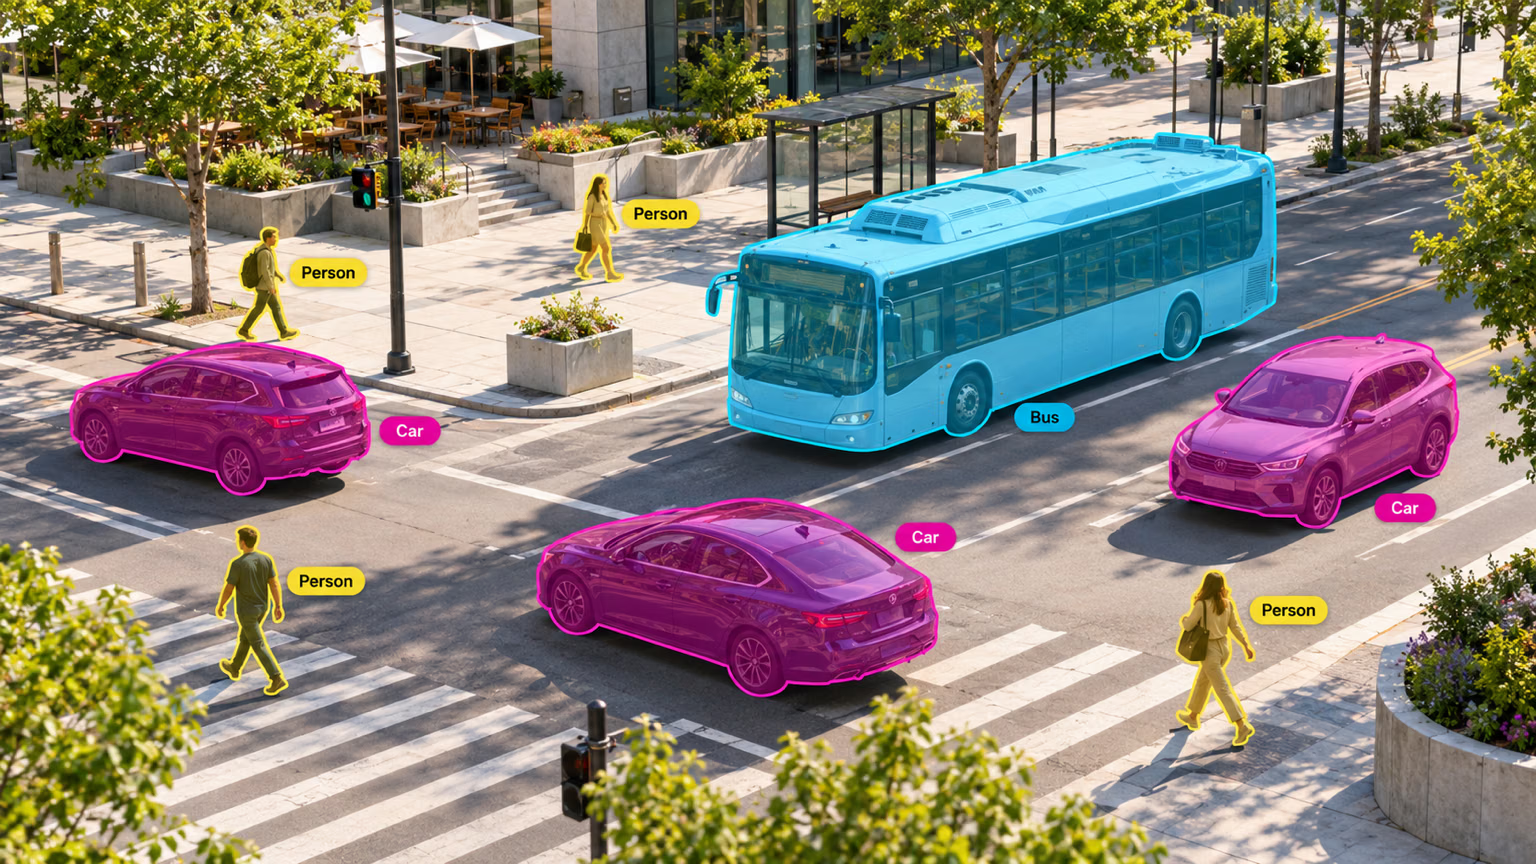
Un archivo de etiquetas de segmentación tiene una fila por objeto, como una etiqueta de detección, pero en lugar de una caja enumera el contorno del objeto mediante pares de vértices normalizados. Una fila real de COCO8-seg, recortada:
45 0.782016 0.986521 0.937078 0.874167 0.957297 0.782021 0.950562 0.739333 0.825844 0.561792 ...| Posición | Fila de detección | Fila de segmentación |
|---|---|---|
| 1 | índice de clase (45 es bowl) | índice de clase |
| 2–5 | x_center y_center width height | los dos primeros vértices, x1 y1 x2 y2 |
| 6+ | — | más vértices, tantos como necesite el contorno |
| Unidades | normalizado de 0 a 1 | normalizado de 0 a 1 (x del píxel ÷ anchura de la imagen, y del píxel ÷ altura de la imagen) |
Tres reglas son fundamentales: al menos tres vértices por objeto, coordenadas divididas por el tamaño de la imagen y una fila por instancia, incluso cuando se tocan dos objetos de la misma clase. La guía de conjuntos de datos de segmentación contiene la especificación completa.
Los polígonos son un superconjunto de las etiquetas de cuadros. La misma carpeta de etiquetas sirve para entrenar yolo26n.pt (Ultralytics obtiene cada cuadro a partir de su polígono) y yolo26n-sem.pt (rasteriza los polígonos y los convierte en mapas de clases); entrenamos ambos con coco8-seg.yaml. Si el plan cambia después del etiquetado, el presupuesto no se pierde.
Comprueba las etiquetas antes de entrenar#
Una fila con un número impar de valores, una coordenada escrita en píxeles o un contorno trazado alrededor del elemento equivocado no detendrá el entrenamiento. Este comprobador lee el conjunto de datos con el cargador propio de Ultralytics, rechaza las filas mal formadas e imprime el área de cada polígono junto a la caja que Ultralytics derivará de él:
from pathlib import Path

import numpy as np

from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("coco8-seg.yaml")  # resolves paths, downloads if needed
for label in sorted(Path(data["path"], "labels", "train").glob("*.txt"))[:2]:
    for n, row in enumerate(label.read_text().splitlines(), 1):
        cls, *coords = row.split()
        if len(coords) % 2 or len(coords) < 6:
            print(f"{label.name}:{n} BAD: needs an even number of values and at least 3 vertices")
            continue
        xy = np.array(coords, dtype=float).reshape(-1, 2)
        if xy.min() < 0 or xy.max() > 1:
            print(f"{label.name}:{n} BAD: coordinates must be normalized to 0-1")
            continue
        x, y = xy[:, 0], xy[:, 1]
        area = 0.5 * abs(np.dot(x, np.roll(y, 1)) - np.dot(y, np.roll(x, 1)))  # shoelace formula
        w, h = xy.max(0) - xy.min(0)  # the box Ultralytics derives from the polygon
        name = data["names"][int(cls)]
        print(f"{label.stem} {name:9s} {len(xy):3d} vertices  polygon {area:.3f}  box {w * h:.3f}  fill {area / (w * h):.2f}")
000000000009 bowl 12 vertices polygon 0.391 box 0.569 fill 0.69
000000000009 bowl 14 vertices polygon 0.145 box 0.238 fill 0.61
000000000009 broccoli 50 vertices polygon 0.161 box 0.252 fill 0.64
000000000009 bowl 55 vertices polygon 0.079 box 0.531 fill 0.15
000000000009 orange 13 vertices polygon 0.007 box 0.011 fill 0.64
000000000009 orange 13 vertices polygon 0.005 box 0.009 fill 0.61
000000000009 orange 18 vertices polygon 0.012 box 0.019 fill 0.61
000000000009 orange 12 vertices polygon 0.010 box 0.022 fill 0.44
000000000025 giraffe 82 vertices polygon 0.072 box 0.234 fill 0.31
000000000025 giraffe 19 vertices polygon 0.010 box 0.027 fill 0.38Las áreas son fracciones de la imagen, así que el primer cuenco ocupa el 39 % de su foto. Relleno es el área del polígono dividida por el área de la caja, y es la columna que debes revisar:
- La mayoría de los objetos compactos (cuencos, naranjas, brócoli) se sitúan en torno a 0,6–0,7.
- El 0,31 de la jirafa es real: las patas largas y el cuello dejan vacía la mayor parte de su caja; por eso este objeto necesita una máscara.
- El 0,15 del tercer cuenco es la fila que debería revisar una persona. Solo se ve un borde fino del cuenco alrededor de la comida, así que su contorno es una banda estrecha dentro de una caja grande. En este caso es correcto; en tus datos, un relleno tan bajo suele indicar que se ha trazado el contorno alrededor del objeto equivocado.
Corrige todas las filas BAD antes de entrenar. Después, ordénalas por relleno y abre en una herramienta de anotación el porcentaje más bajo de filas de cada clase: un relleno bajo indica un objeto fino u ocluido (consérvalo) o un contorno incorrecto (corrígelo).
Consigue polígonos sin trazar cada borde#
Trazar contornos a mano es la parte costosa del etiquetado de datos. Antes de que nadie empiece, comprueba qué método abreviado puedes usar:
| Ya tienes | Herramienta |
|---|---|
| JSON de COCO con segmentación | convert_coco(labels_dir, use_segments=True) de ultralytics.data.converter |
| Máscaras PNG (valor del píxel = índice de clase + 1; 0 = fondo) | convert_segment_masks_to_yolo_seg(masks_dir, output_dir, classes): los objetos de una misma clase que se tocan se convierten en un solo polígono, así que sepáralos durante la revisión |
| Solo etiquetas de cajas | yolo_bbox2segment(im_dir): solicita a SAM que genere un polígono para cada caja |
| Aún no tienes nada | Anotación inteligente y etiquetado por lotes: haz clic una vez y revisa el polígono |
En Ultralytics Platform, el modo Smart ejecuta SAM: un clic positivo sobre el objeto y otro negativo sobre lo que debe excluirse generan una máscara que después revisas.
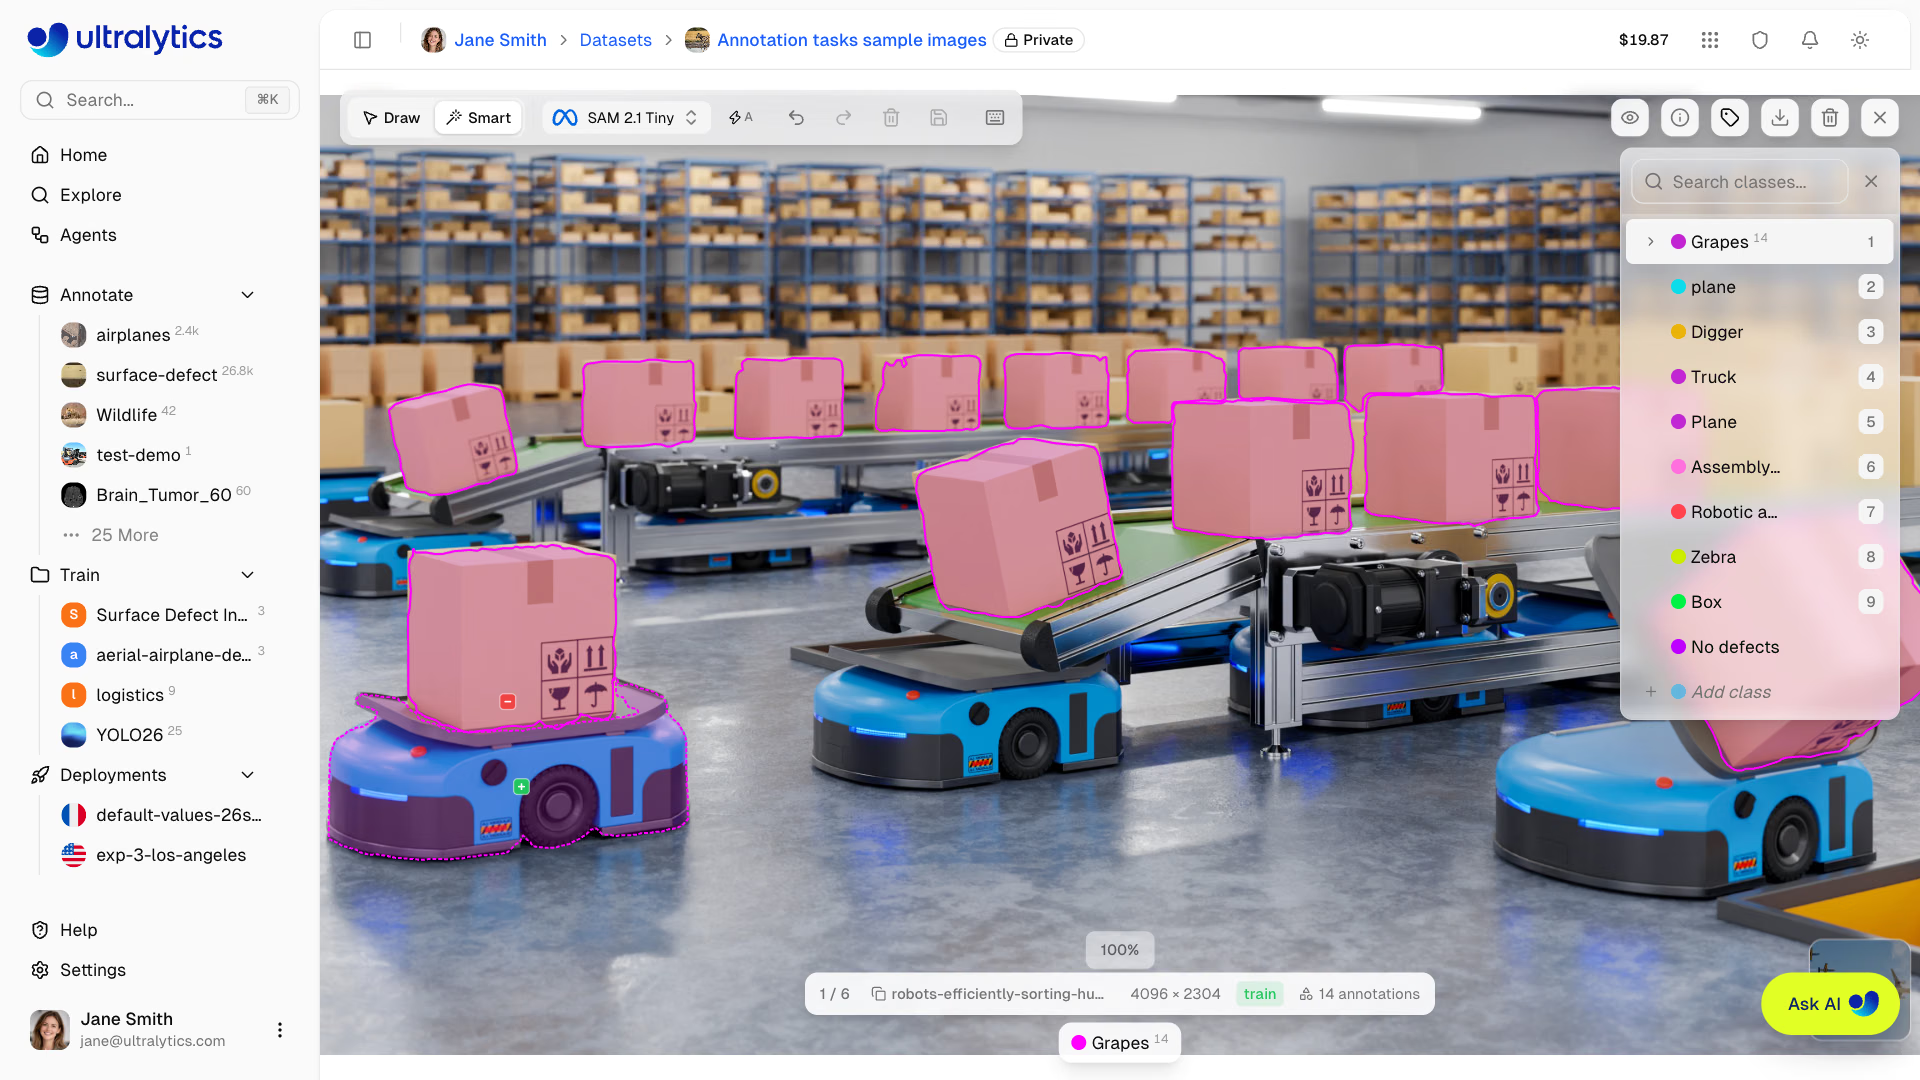
Una máscara que se extiende al fondo enseña al modelo a hacer lo mismo. Revisa los polígonos generados automáticamente según el criterio de calidad de Cuadros frente a máscaras y vuelve a ejecutar la comprobación de etiquetas anterior.
Entrena con COCO8-seg#
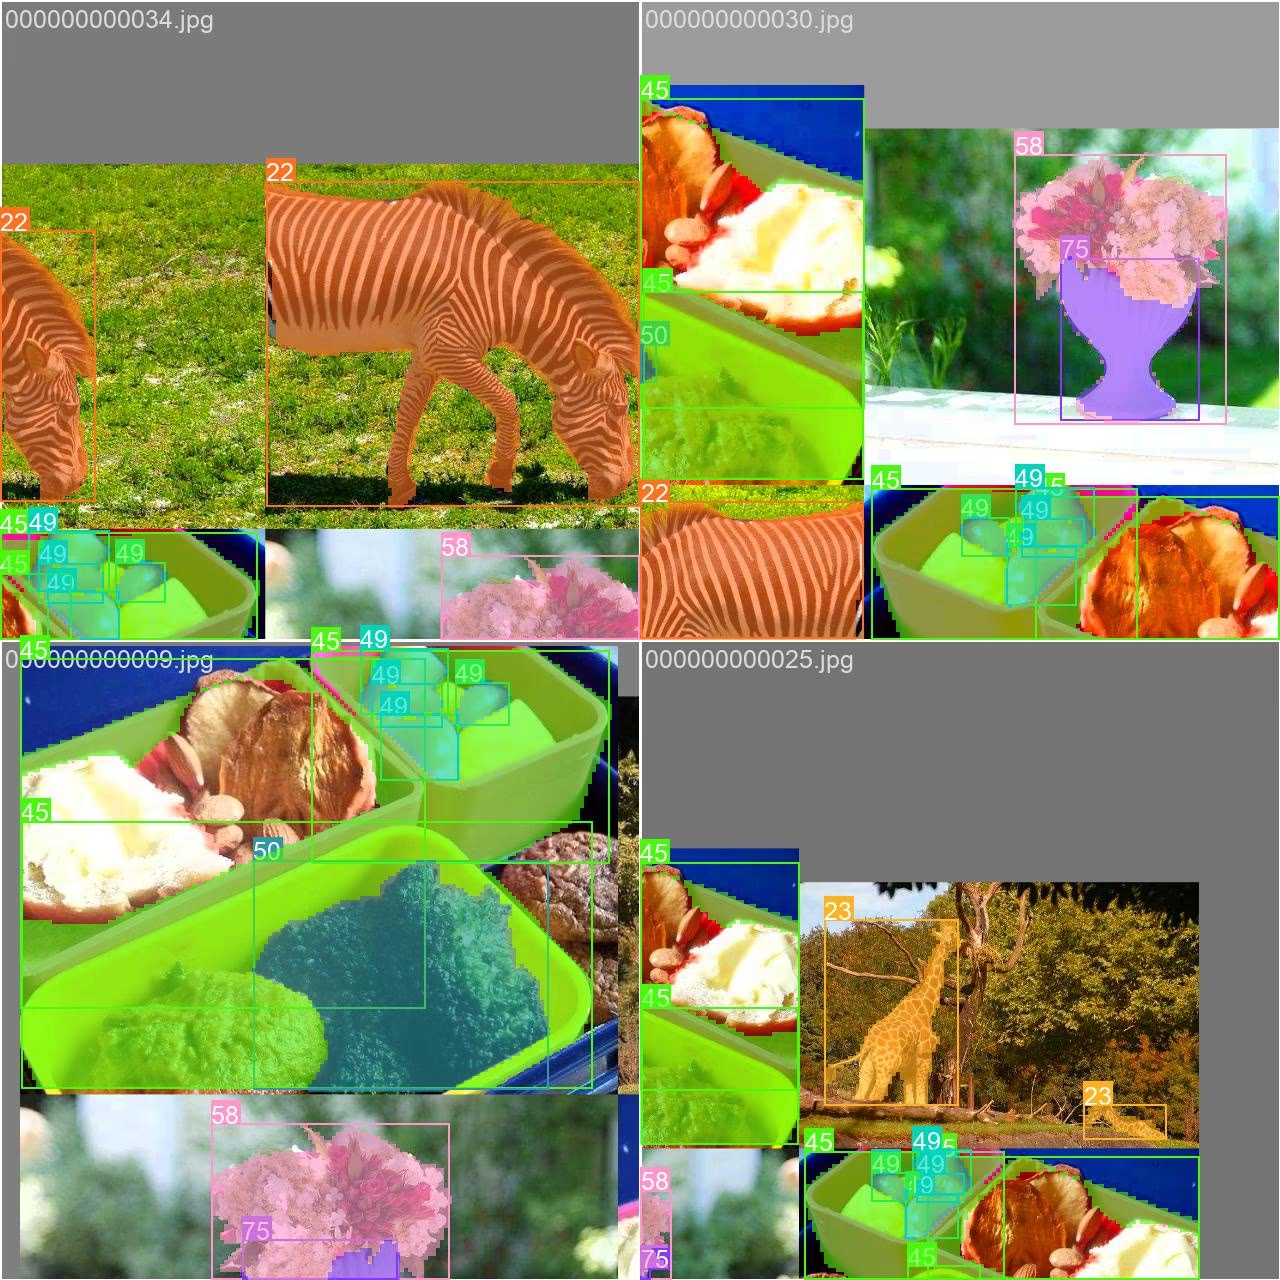
El entrenamiento sigue el flujo de trabajo de detección, pero con un modelo -seg y un conjunto de datos de segmentación. Una época con imgsz=320 en la CPU de un portátil termina en segundos, suficiente para comprobar todo el proceso:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"box  mAP50-95: {metrics.box.map:.3f}")
print(f"mask mAP50-95: {metrics.seg.map:.3f}")
Class Images Instances Box(P R mAP50 mAP50-95) Mask(P R mAP50 mAP50-95)
all 4 17 0.909 0.449 0.661 0.482 0.685 0.409 0.557 0.377
horse 1 2 1 0.993 0.995 0.564 0.619 0.857 0.663 0.199
box mAP50-95: 0.482
mask mAP50-95: 0.377Cuatro imágenes de validación hacen que estos números sean poco fiables; lo importante es que la ejecución termine y escriba weights/best.pt en runs/segment/. Para datos reales, sigue la guía de la tarea Segment y entrena durante todo el programa en una GPU.
Lee en paralelo las métricas de cajas y máscaras#
La tabla de validación tiene dos bloques. Box compara cada caja predicha con la caja que implica la etiqueta; Mask compara los píxeles predichos con el polígono etiquetado. Ambos usan el mismo mecanismo de mAP; solo cambia la IoU.
El mAP50-95 de máscaras casi siempre es inferior al de cajas, porque la IoU de píxeles es más estricta: una caja desplazada unos pocos píxeles sigue solapándose bastante, mientras que una máscara a la que le falta un brazo o que se extiende sobre la calzada pierde IoU rápidamente en los umbrales de 0,75–0,95. La fila horse es el caso más extremo: mAP50-95 de cajas de 0,564 y de máscaras de 0,199. El modelo encontró los dos caballos y los encuadró bien, pero no perfiló las patas ni las colas. Usa la diferencia para decidir qué corregir:
- Ambas bajas: el problema es encontrar los objetos, no perfilar sus contornos. Primero, añade datos de las condiciones en las que no se detectaron.
- Cajas buenas, máscaras mucho peores: el modelo encuentra los objetos, pero perfila mal sus contornos. Ejecuta la comprobación de etiquetas, prueba un modelo más grande o entrena y valida con un valor de
imgszmayor. - Las máscaras mejoran mientras las cajas se estancan: no pasa nada; en un producto de segmentación, el mAP50-95 de máscaras es el criterio de lanzamiento.
overlap_mask=True combina las máscaras de instancias en una sola imagen durante el entrenamiento, y mask_ratio=4 reduce la resolución de las máscaras de entrenamiento. Ninguno de los dos cambia la resolución de las máscaras predichas: eso depende de retina_masks, que se explica en la siguiente lección. Déjalos con sus valores predeterminados salvo que hayas medido un motivo para cambiarlos.
Mostrar solución
Para comprobar todas las particiones, sustituye la carpeta del bucle por Path(data["path"], "labels").rglob("*.txt"). Después, entrena:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"box  mAP50-95: {metrics.box.map:.3f}")   # 0.482 in our run
print(f"mask mAP50-95: {metrics.seg.map:.3f}")   # 0.377 in our run
La diferencia de 0,1 es normal: la IoU de máscaras penaliza cada píxel del contorno; la IoU de cajas solo penaliza los cuatro bordes. En nuestra ejecución, la mayor diferencia corresponde a horse (cajas: 0,564; máscaras: 0,199). El mAP de cajas es bueno y el de máscaras es muy inferior, así que el diagrama apunta a la calidad de los contornos: comprueba primero esos polígonos y después prueba un modelo más grande o un valor de imgsz mayor.