Distribuire e chiamare un endpoint
Crea un endpoint dedicato in una delle 42 regioni, dimensionane le risorse in base al traffico e chiamalo con un client che gestisce avvii a freddo, errori 429 e chiavi non valide.
Un endpoint gratuito con scalabilità fino a zero può impiegare fino a un minuto per rispondere alla prima richiesta; un client ingenuo trasforma questo ritardo in un timeout visibile all'utente. Una chiave divulgata continua a funzionare anche dopo che l'hai eliminata. In questa lezione distribuirai il modello vincente, dimensionerai attentamente l'endpoint e scriverai il piccolo client necessario per ogni integrazione di produzione.
Pratico
Inferenza condivisa o endpoint dedicato#
Ogni modello può già essere chiamato tramite l'API di inferenza condivisa di Platform, adatta ai test. Per il traffico di produzione, usa un endpoint dedicato:
| Inferenza condivisa | Endpoint dedicato | |
|---|---|---|
| Servizio | Condiviso tra gli utenti di Platform | Un modello, tenant singolo |
| Regioni | La tua regione dati (US, EU o AP) | Una qualsiasi delle 42 regioni |
| Limite di frequenza | 20 richieste al minuto per chiave | Nessun limite di Platform per le chiamate dirette |
| Dimensione della richiesta | Circa 4.5 MB | 32 MB, fino a 1 ora per richiesta (supporta i video) |
| Autenticazione | Qualsiasi chiave API dell'area di lavoro | Solo la chiave associata alla distribuzione |
Crea e dimensiona l'endpoint#
Apri la scheda Deploy del modello. Il browser misura la latenza verso tutte le 42 regioni (14 nelle Americhe, 13 in Europa, 12 nell'Asia-Pacifico, 3 in Medio Oriente e Africa) e ordina la tabella in base a questo valore:
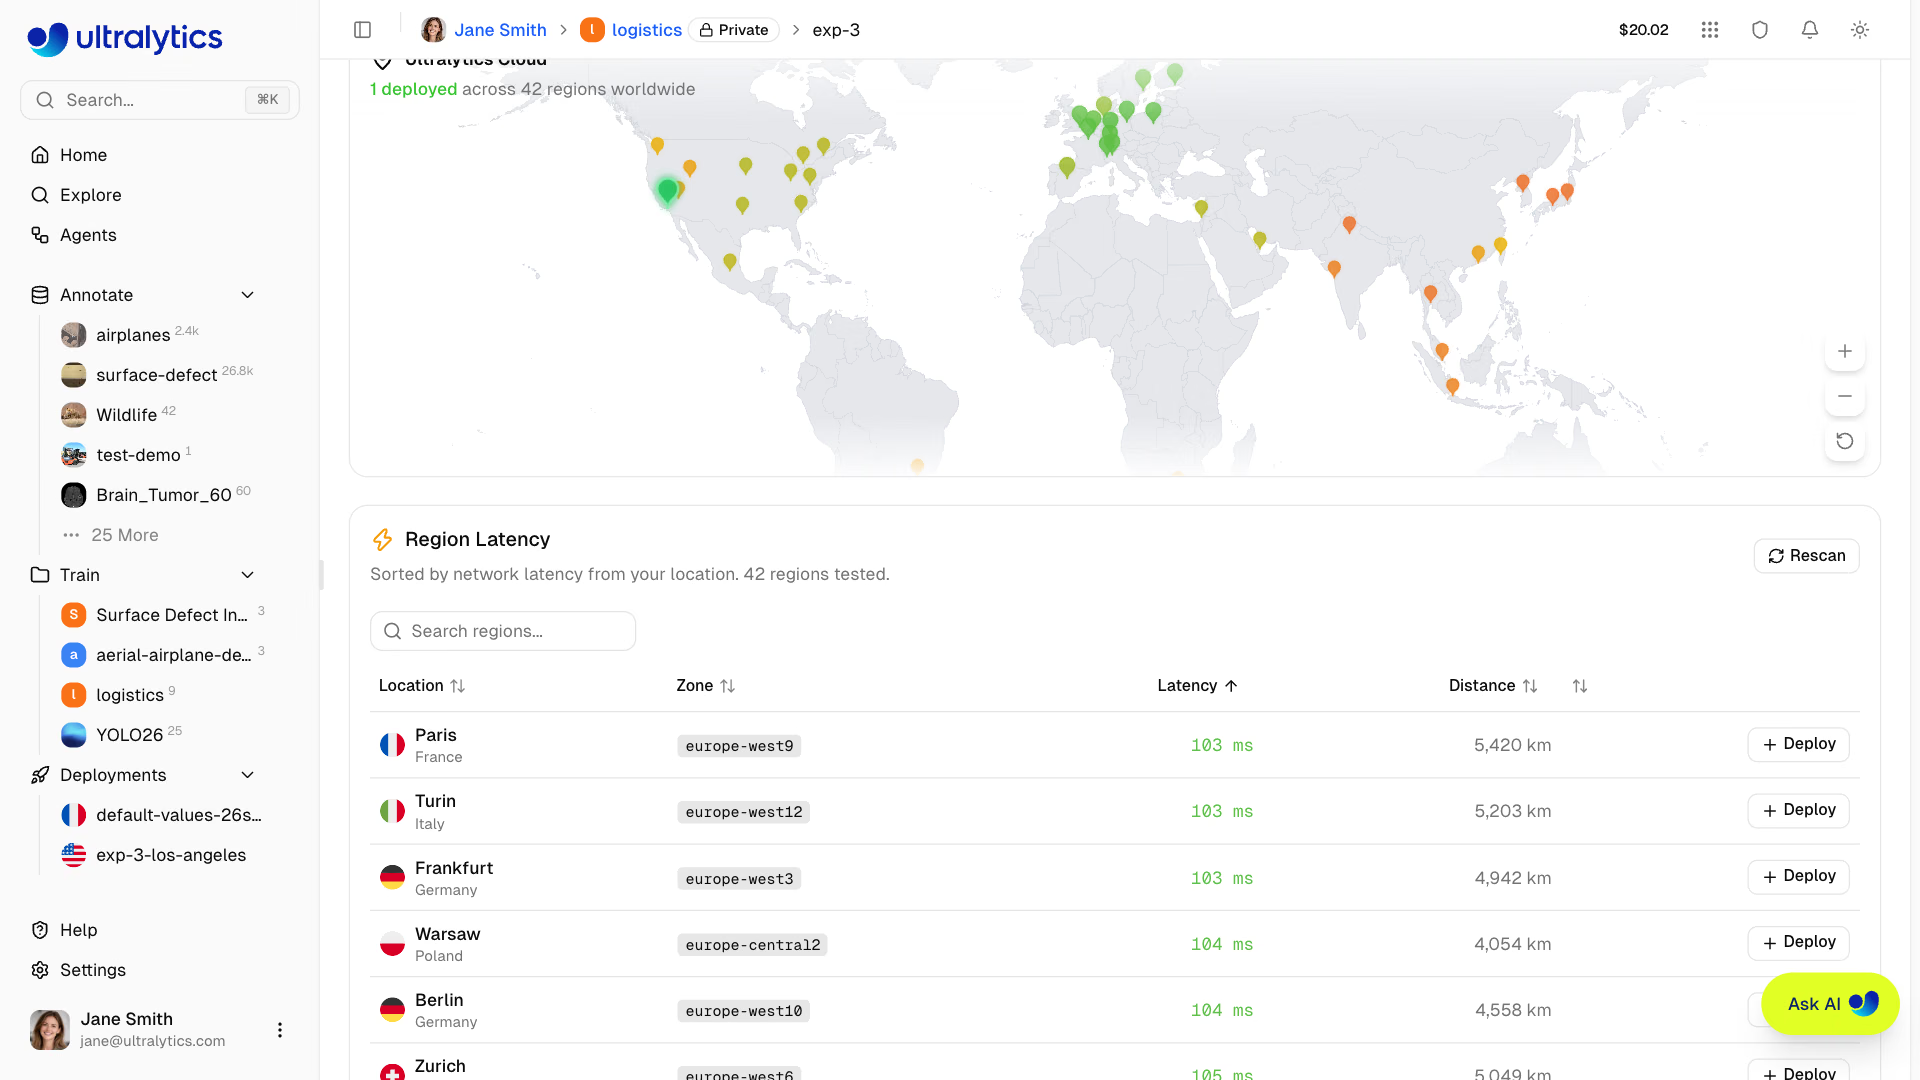
Fai clic su Deploy nella riga più vicina ai tuoi utenti, controlla CPU, memoria, prezzo e nome generato (ad esempio yolo26n-iowa), quindi fai clic su Create Deployment. Puoi anche iniziare da New Deployment nella scheda Deployments del tuo profilo:
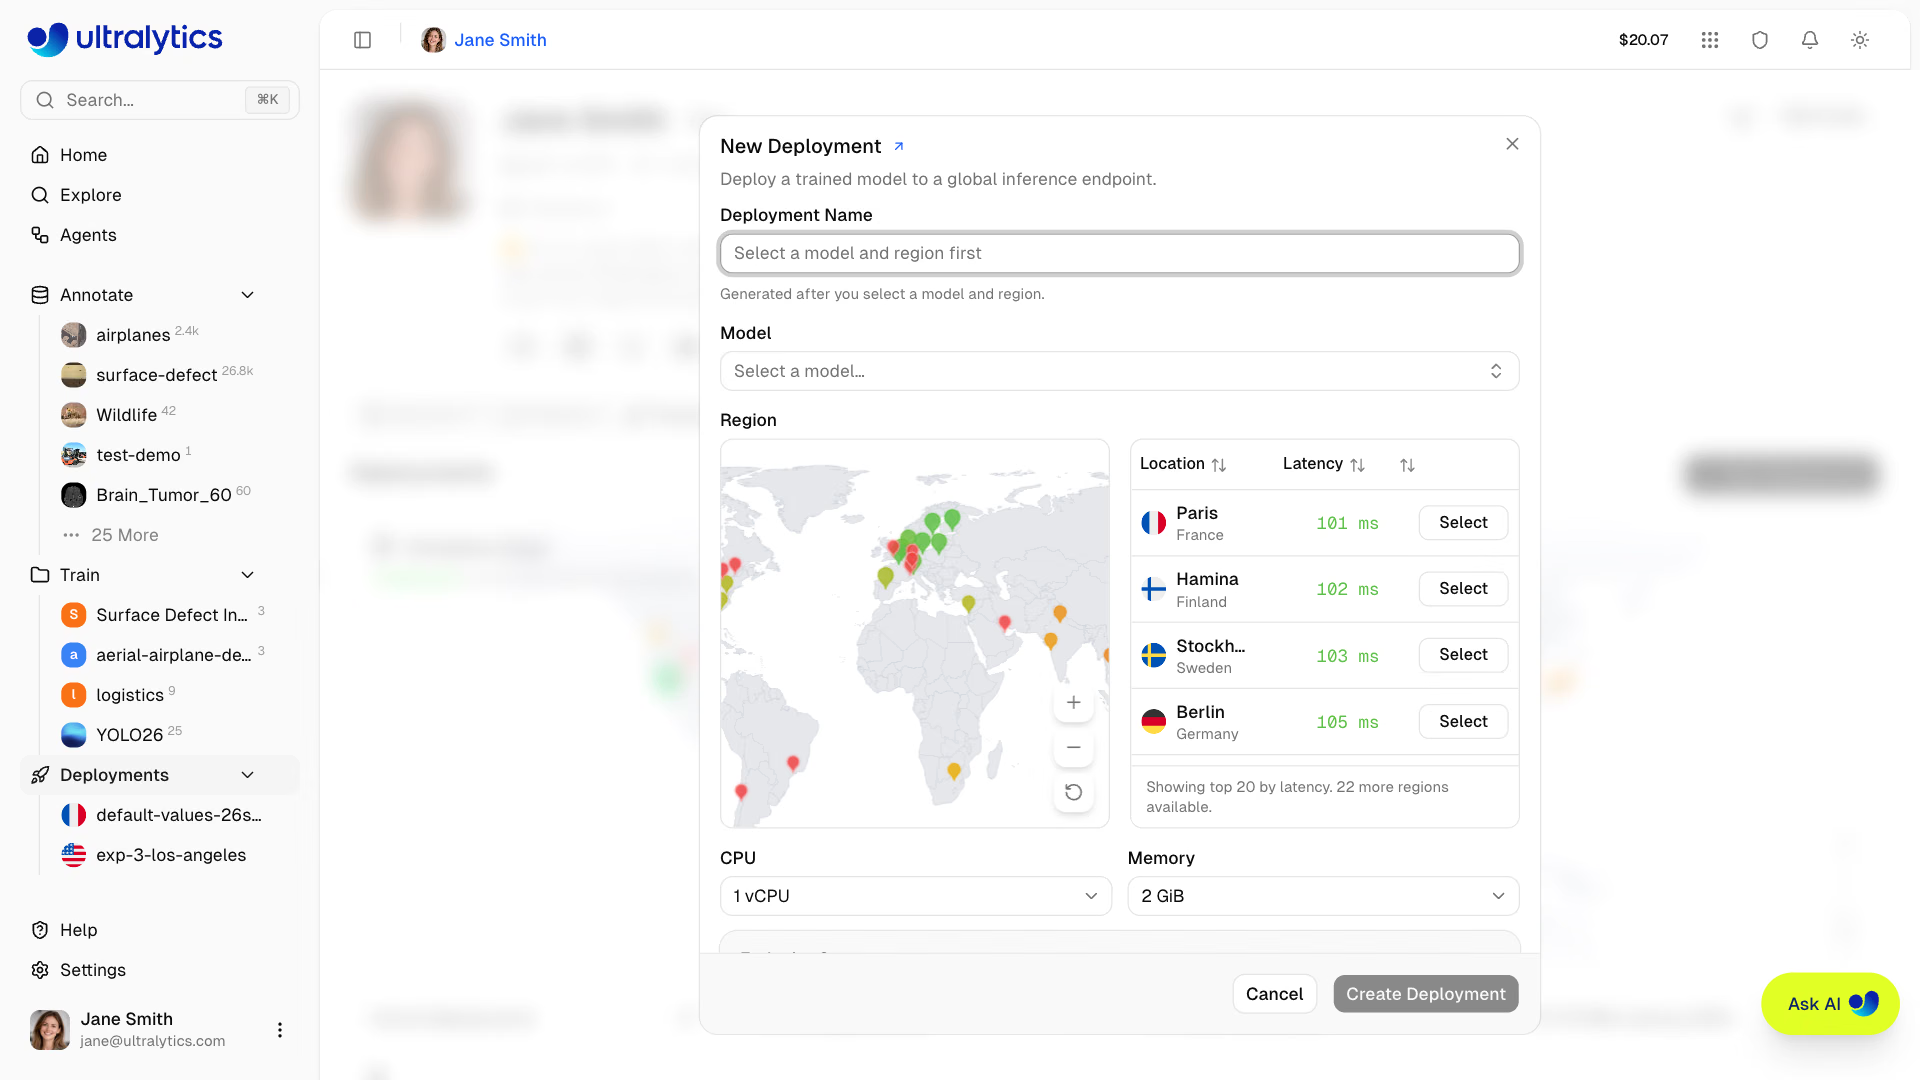
Scegli le dimensioni in base al tipo di traffico:
| Traffico | Dimensione | Costo |
|---|---|---|
| Processi batch, strumenti interni, demo con picchi di traffico | Predefinito: 1 vCPU, 2 GiB; scala fino a zero | Gratis con tutti i piani |
| Traffico costante in tempo reale che non può attendere un avvio a freddo | Dimensioni personalizzate (1–8 vCPU, 2–32 GiB) con un'istanza sempre attiva | Fatturazione oraria dal momento in cui è pronta fino all'arresto, anche durante l'inattività: circa $0.12/h per 1 vCPU e 4 GiB in Iowa |
| Utenti in più continenti | Un endpoint per regione, dietro il tuo router | Ogni endpoint è fatturato in base alle sue dimensioni |
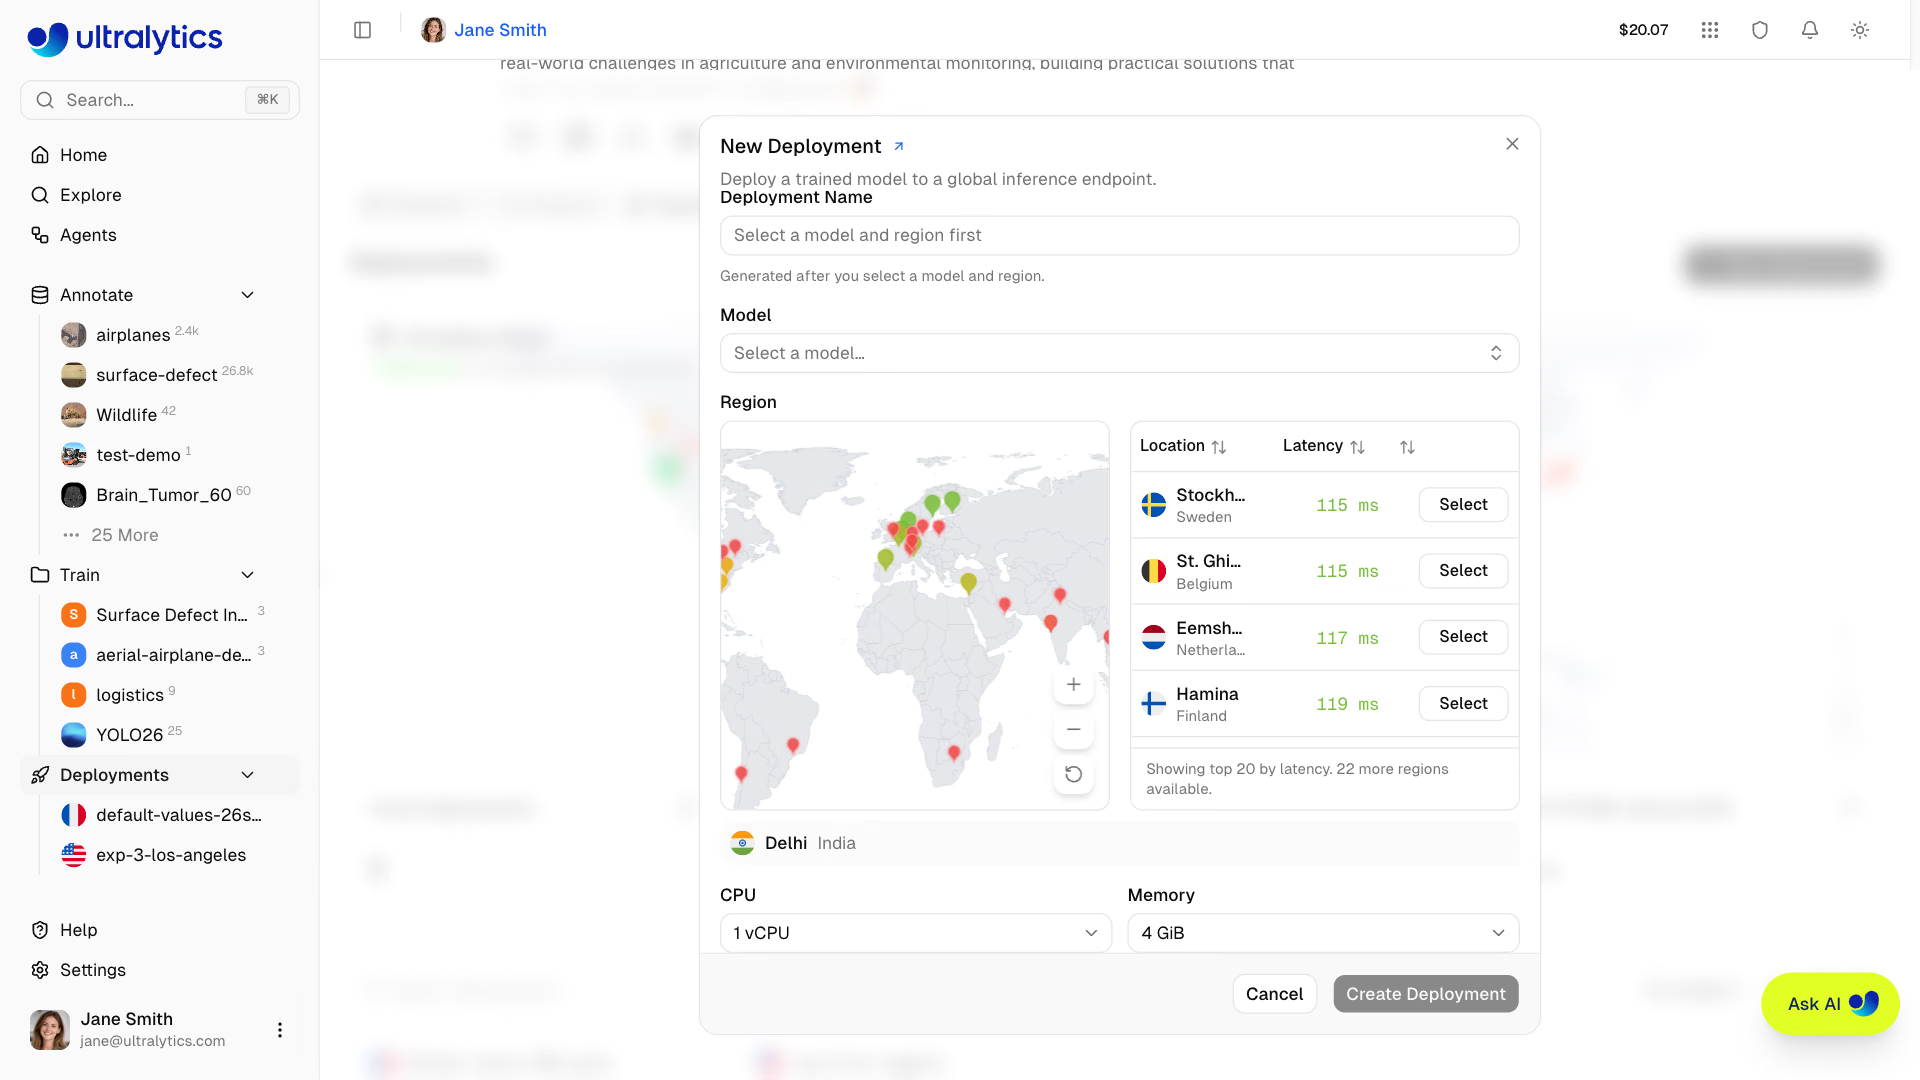
I piani consentono 3 (Free), 10 (Pro) o un numero illimitato (Enterprise) di distribuzioni; anche gli endpoint arrestati vengono conteggiati. L'endpoint accetta traffico quando il badge indica Ready:
Esempio pratico: un client pronto per la produzione#
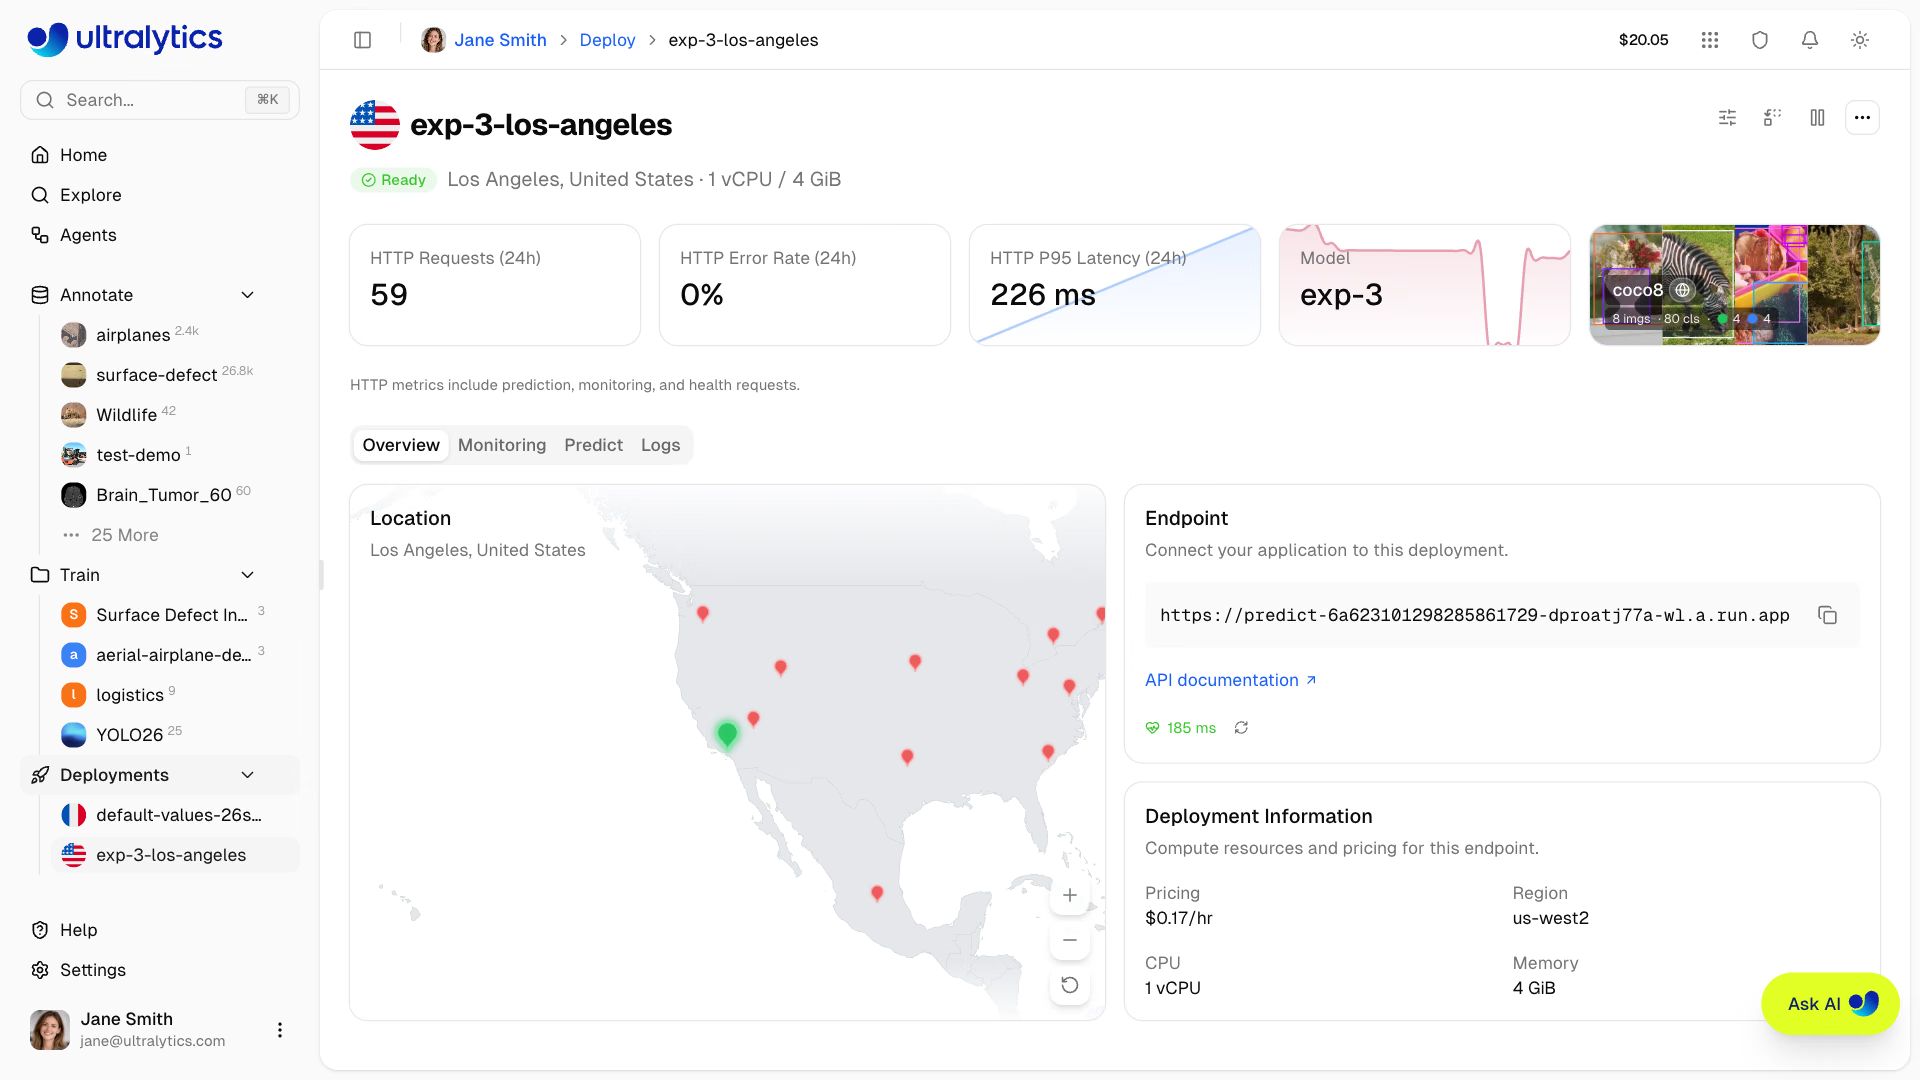
Ogni endpoint ha un URL come https://predict-<id>-<hash>-<region>.a.run.app e serve /predict (POST), /health e una pagina interattiva /docs. Accetta solo la chiave API associata al momento della creazione; i proprietari dell'area di lavoro vedono quella chiave già compilata nella scheda Predict della distribuzione, sotto Docs, accanto agli snippet per Python, JavaScript e cURL. Gli snippet effettuano una singola richiesta; il codice di produzione deve gestire anche un avvio a freddo e un'istanza sotto carico:
import os
import time
from collections import Counter

import httpx

URL = "https://YOUR_DEPLOYMENT_URL.run.app/predict"
HEADERS = {"Authorization": f"Bearer {os.environ['ULTRALYTICS_API_KEY']}"}  # the deployment's bound key, server-side only

def predict(client, path, conf=0.25, attempts=4):
    """POST one image; retry timeouts, 429, and 5xx with backoff; fail fast on other errors."""
    for attempt in range(attempts):
        try:
            with open(path, "rb") as f:
                r = client.post(URL, headers=HEADERS, data={"conf": conf}, files={"file": f}, timeout=90)
            if r.status_code < 400:
                return r.json()
            if r.status_code != 429 and r.status_code < 500:
                r.raise_for_status()  # 401 wrong key, 413 too large: retrying won't help
            wait, reason = float(r.headers.get("Retry-After", 2**attempt)), r.status_code
        except httpx.TimeoutException:  # a scaled-to-zero endpoint can take up to a minute to wake
            wait, reason = 2**attempt, "timeout"
        print(f"attempt {attempt + 1}: {reason}, retrying in {wait:.0f} s")
        time.sleep(wait)
    raise RuntimeError(f"endpoint still unavailable after {attempts} attempts")

with httpx.Client() as client:
    response = predict(client, "bus.jpg")
for image in response["images"]:
    counts = Counter(d["name"] for d in image["results"])
    print(f"{sum(counts.values())} objects {dict(counts)} in {image['speed']['inference']:.1f} ms")
Lo abbiamo testato con uno stub locale che risponde una volta a 429 e poi restituisce un risultato reale di YOLO26n per bus.jpg nel formato di risposta dell'endpoint:
attempt 1: 429, retrying in 2 s
5 objects {'bus': 1, 'person': 4} in 34.9 ms
Ecco, riga per riga, le decisioni importanti:
timeout=90copre un avvio a freddo che può durare fino a circa un minuto; i timeout predefiniti della maggior parte dei client HTTP sono molto più brevi.- Gli errori 429 e 5xx vengono ritentati, rispettando
Retry-Afterquando l'endpoint lo invia. Ogni endpoint serve le richieste da una singola istanza e, quando è sotto carico, rifiuta le richieste con429. - Gli altri errori 4xx interrompono subito l'operazione:
401indica una chiave errata e413un corpo superiore a 32 MB; nessuno dei due problemi si risolve da solo. - La risposta contiene una voce per ogni immagine (o fotogramma video) in
images, ciascuna conresults(class,name,confidence,boxconx1,y1,x2,y2) espeedin millisecondi.
I campi facoltativi del modulo sono conf (predefinito 0.25), iou (0.7), imgsz (la dimensione di addestramento del modello), vid_stride per i video e normalize=true per le coordinate da 0 a 1. L'equivalente in cURL prevede una riga per campo:
curl -X POST "https://YOUR_DEPLOYMENT_URL.run.app/predict" \
  -H "Authorization: Bearer $ULTRALYTICS_API_KEY" \
  -F "file=@bus.jpg" -F "conf=0.25" -F "iou=0.7" -F "imgsz=640"
Distribuisci nuove versioni senza cambiare l'URL#
Replace model nella pagina della distribuzione sostituisce il modello con un altro modello completato della stessa area di lavoro. Il vecchio modello continua a servire le richieste finché il nuovo non è pronto; URL, regione e chiave rimangono invariati e, se il rilascio non riesce, il modello precedente resta attivo. Per ripristinare la versione precedente basta eseguire la stessa operazione selezionando il modello precedente: conservalo quindi nel progetto. Update configuration modifica le dimensioni senza ricreare l'endpoint e Stop sospende la fatturazione mantenendo l'URL.
Alcune modifiche richiedono un nuovo endpoint: le regioni sono fisse (per spostarlo, devi eliminarlo e ricrearlo ottenendo un nuovo URL) e i domini personalizzati non sono supportati; se i client hanno bisogno di un nome host stabile e personalizzato, anteponi il tuo gateway. Per eseguire il modello al di fuori della piattaforma, esportalo (Esporta per la distribuzione) oppure ospitalo autonomamente dietro Triton Inference Server.
Insidie#
Sintomo: il tuo endpoint riceve traffico che non riesci a giustificare. Soluzione: non inserire mai la chiave in un'app web o mobile; chiama l'endpoint dal tuo backend. Eliminare o disattivare la chiave associata non blocca l'endpoint, perché continua ad accettare quella stringa della chiave. Per revocare l'accesso, interrompi o elimina il deployment e creane uno nuovo associato a una chiave appena generata.
Sintomo: la prima richiesta del mattino non va a buon fine, mentre il tentativo successivo riesce. Soluzione: gli endpoint di dimensione predefinita scalano fino a zero. Imposta un timeout di almeno 90 secondi, riscalda l'endpoint con una chiamata /health prima del traffico previsto oppure passa a una dimensione personalizzata se ogni richiesta deve essere rapida.
Sintomo: i caricamenti non vanno a buon fine con 413. Soluzione: gli endpoint dedicati accettano corpi delle richieste fino a 32 MB. Dividi i video lunghi in clip più brevi o invia fotogrammi campionati e passa vid_stride per saltare i fotogrammi sul server.
Mostra la soluzione
Esempio di risposta per la videocamera della linea di produzione delle pillole: distribuisci v2-finetune in europe-west1 (St. Ghislain, la regione con la latenza più bassa rispetto allo stabilimento tedesco) con le dimensioni predefinite. Richiesta a freddo dopo un'ora di inattività: 38 s, un tempo coperto dal timeout di 90 secondi; richiesta a caldo: 0.3 s. Decisione: durante i turni, il PLC della linea invia un fotogramma ogni 30 secondi, quindi l'endpoint rimane attivo per tutto il turno e solo il primo fotogramma subisce un avvio a freddo. Una chiamata /health dal controller della linea 2 minuti prima di ogni turno elimina anche questo ritardo, quindi manteniamo le dimensioni predefinite gratuite e risparmiamo circa $90 al mese rispetto a un'istanza personalizzata con 1 vCPU e 4 GiB. Sostituendo di nuovo il modello con v1-baseline, lo stesso URL restituisce i risultati di v1; sostituiscilo ancora con v2 per concludere.