Selezione, deduplicazione e suddivisione
Individua i duplicati tra split e le lacune nelle classi con due brevi script, suddividi i dati in base all'unità rilevante e blocca una versione del dataset verificata.
L'affidabilità di un punteggio di validazione dipende da quanto è corretto lo split. COCO128, un popolare dataset dimostrativo, usa intenzionalmente le stesse 128 immagini per train e val; una versione accidentale di questo scenario nei tuoi dati ti dà un modello «ottimo» che fallisce con la fotocamera successiva. In questa lezione eseguirai due verifiche su dati reali, un controllo dei duplicati e un controllo delle classi per split, quindi suddividerai i dati per fotocamera e bloccherai una versione che ha superato entrambi.
Pratico
Esempio pratico: trovare immagini condivise tra gli split#
La piattaforma conserva una sola copia di un'immagine per split e chiede come gestire le collisioni durante il caricamento, ma nulla impedisce alla stessa immagine o scena di finire sia in train sia in val. Controlla prima di caricare e di nuovo dopo aver unito i dataset:
import hashlib
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("coco128.yaml")  # any local YOLO dataset YAML before you upload it

def hashes(split_dir):
    return {hashlib.md5(p.read_bytes()).hexdigest(): p.name for p in Path(split_dir).rglob("*.jpg")}

train, val = hashes(data["train"]), hashes(data["val"])
shared = train.keys() & val.keys()
print(f"train {len(train)} images, val {len(val)} images, identical in both: {len(shared)}")
print("examples:", sorted(val[h] for h in shared)[:3])
train 128 images, val 128 images, identical in both: 128
examples: ['000000000009.jpg', '000000000025.jpg', '000000000030.jpg']Ogni immagine di validazione di COCO128 è anche un'immagine di training. È intenzionale per un dataset di test rapido, ed è proprio per questo che il suo mAP di validazione non dice nulla sulla generalizzazione. Nei tuoi dati, qualsiasi conteggio diverso da zero indica una contaminazione: sposta o elimina una copia di ciascuna immagine prima del training.
Individua i quasi duplicati con Clustering#
Gli hash rilevano solo byte identici. I fotogrammi video consecutivi, le foto a raffica e le copie ricodificate differiscono per pochi pixel. Apri l'icona del grafico a dispersione nella barra degli strumenti della galleria e fai clic su Analyze Dataset (da 20 a 200,000 immagini, solo dataset caricati):
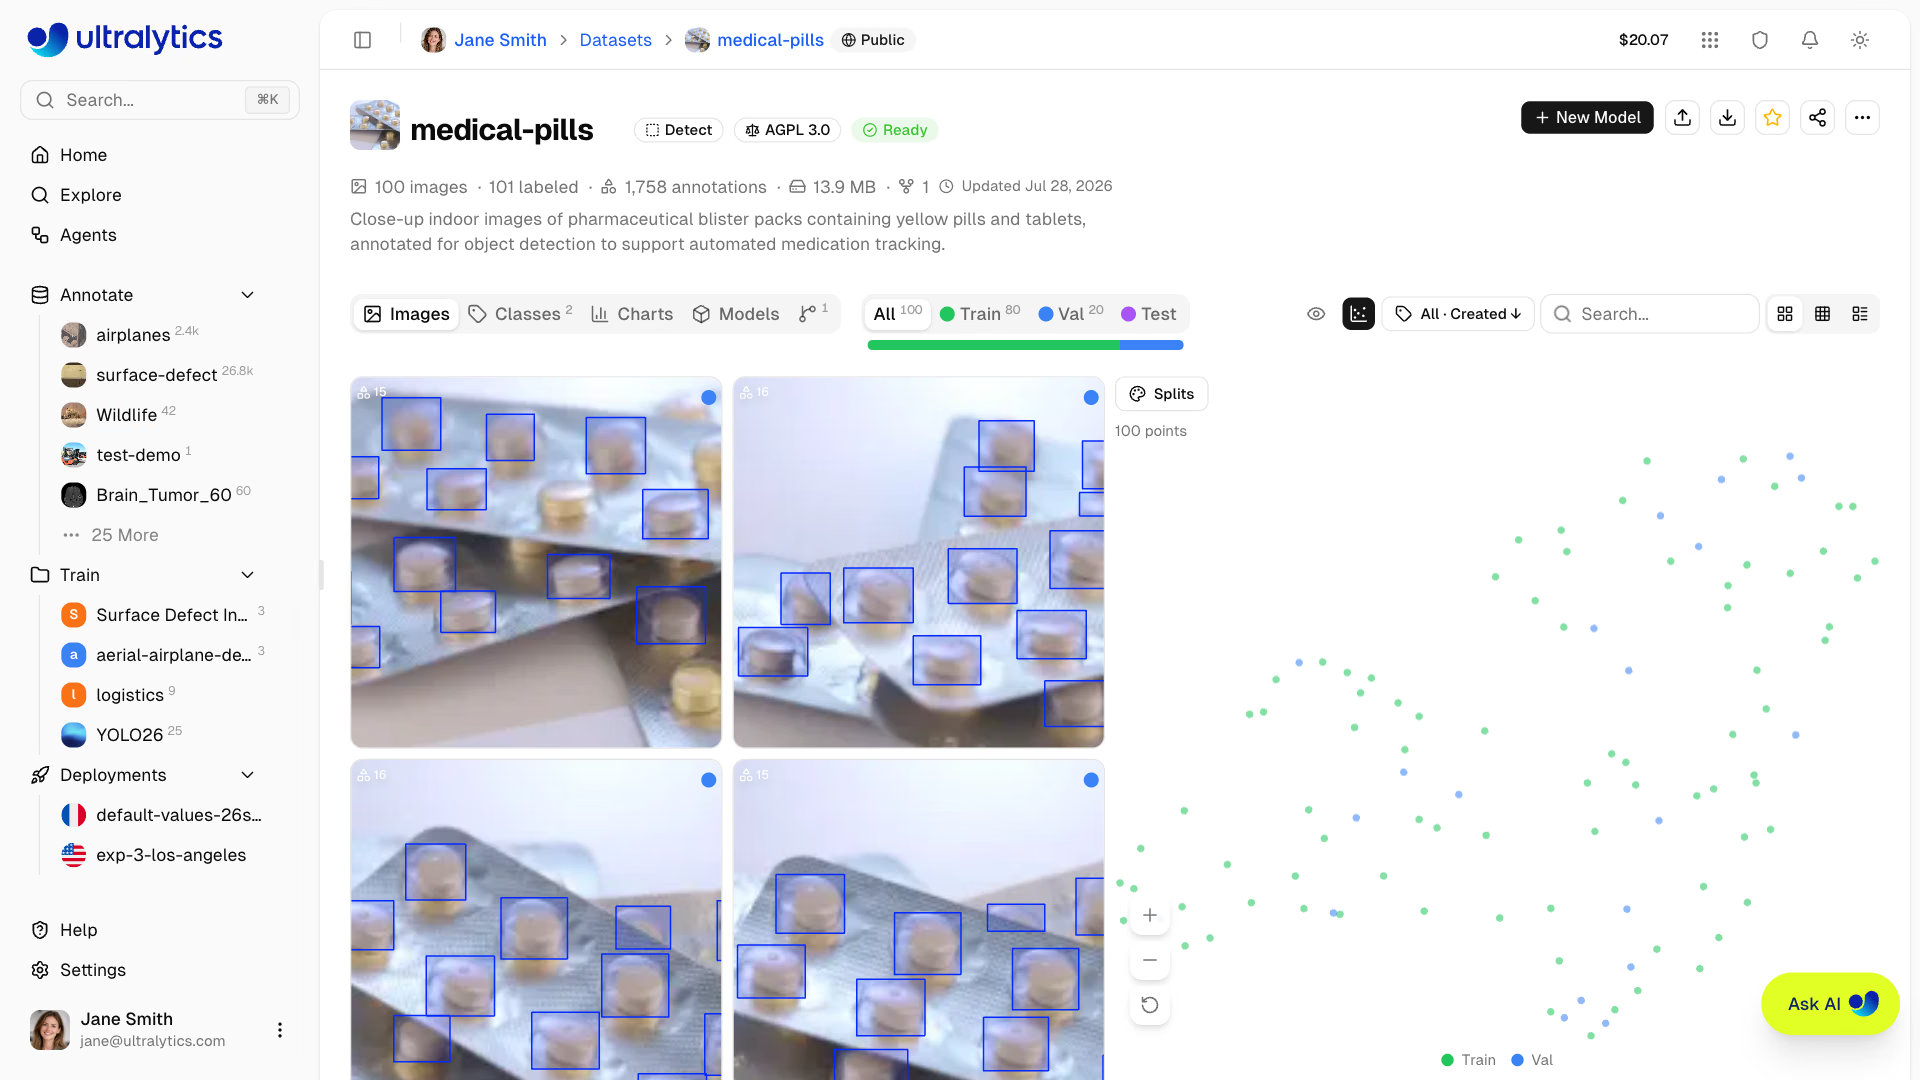
- Colora per split: un gruppo compatto che mescola punti train e val indica una contaminazione da quasi duplicati.
- Colora per cluster o classi: un grande gruppo composto da una sola classe mostra quali elementi sono sovrarappresentati nel dataset; i punti isolati sono valori anomali (fotocamera sbagliata, fotogramma danneggiato, immagine etichettata in modo errato).
- Seleziona con il lazo o fai clic su una regione per filtrare la galleria e mostrare quelle immagini (fino a 1,000), quindi eliminale, spostale o rietichettale.
Gli stessi embedding alimentano Trova immagini simili nel menu contestuale dell'immagine, che aggiunge a train immagini simili provenienti da dataset pubblici e del team, come immagini non etichettate: il modo più rapido per colmare una lacuna individuata dalla verifica qui sotto.
Esempio pratico: verifica delle classi per split#
Scarica l'esportazione NDJSON dall'intestazione del dataset o dalla scheda Versions. Ogni riga dopo l'intestazione corrisponde a un'immagine con il relativo split e le etichette, quindi bastano poche righe di Python per contare ogni classe in ogni split. Qui viene usata l'esportazione pubblica di COCO8:
import json
from collections import Counter, defaultdict

counts = defaultdict(Counter)  # split -> class name -> instances
images = Counter()
with open("coco8.ndjson") as f:  # the NDJSON export from the dataset header or Versions tab
    header = json.loads(f.readline())
    names = header["class_names"]
    for line in f:
        record = json.loads(line)
        images[record["split"]] += 1
        for box in (record.get("annotations") or {}).get("boxes", []):
            counts[record["split"]][names[str(box[0])]] += 1

print("images per split:", dict(images))
for name in sorted(set(counts["train"]) | set(counts["val"])):
    train, val = counts["train"][name], counts["val"][name]
    flag = "missing in train" if not train else "too few in val" if val < 10 else ""
    print(f"{name:<14} train {train:>3}  val {val:>3}  {flag}")
images per split: {'train': 4, 'val': 4}
bowl train 3 val 0 too few in val
broccoli train 1 val 0 too few in val
dog train 0 val 1 missing in train
elephant train 0 val 2 missing in train
giraffe train 2 val 0 too few in val
horse train 0 val 2 missing in train
orange train 4 val 0 too few in val
person train 0 val 10 missing in train
potted plant train 1 val 1 too few in val
umbrella train 0 val 1 missing in train
vase train 1 val 0 too few in val
zebra train 1 val 0 too few in valCome leggerla: la riga di intestazione contiene class_names; ogni box di rilevamento è [class, x, y, w, h]. Assente in train significa che il modello non può imparare affatto la classe e che il suo AP in val sarà zero. Troppo poche istanze in val significa che il suo AP varierà molto da un'esecuzione all'altra: con 7 pallet in val, un pallet mancato sposta l'AP dei pallet di circa 14 punti. COCO8 è un test rapido con 8 immagini, quindi tutte le classi non superano il controllo; la tua versione di produzione non dovrebbe generare alcuna segnalazione. Colma le lacune raccogliendo altri esempi, non modificando i parametri.
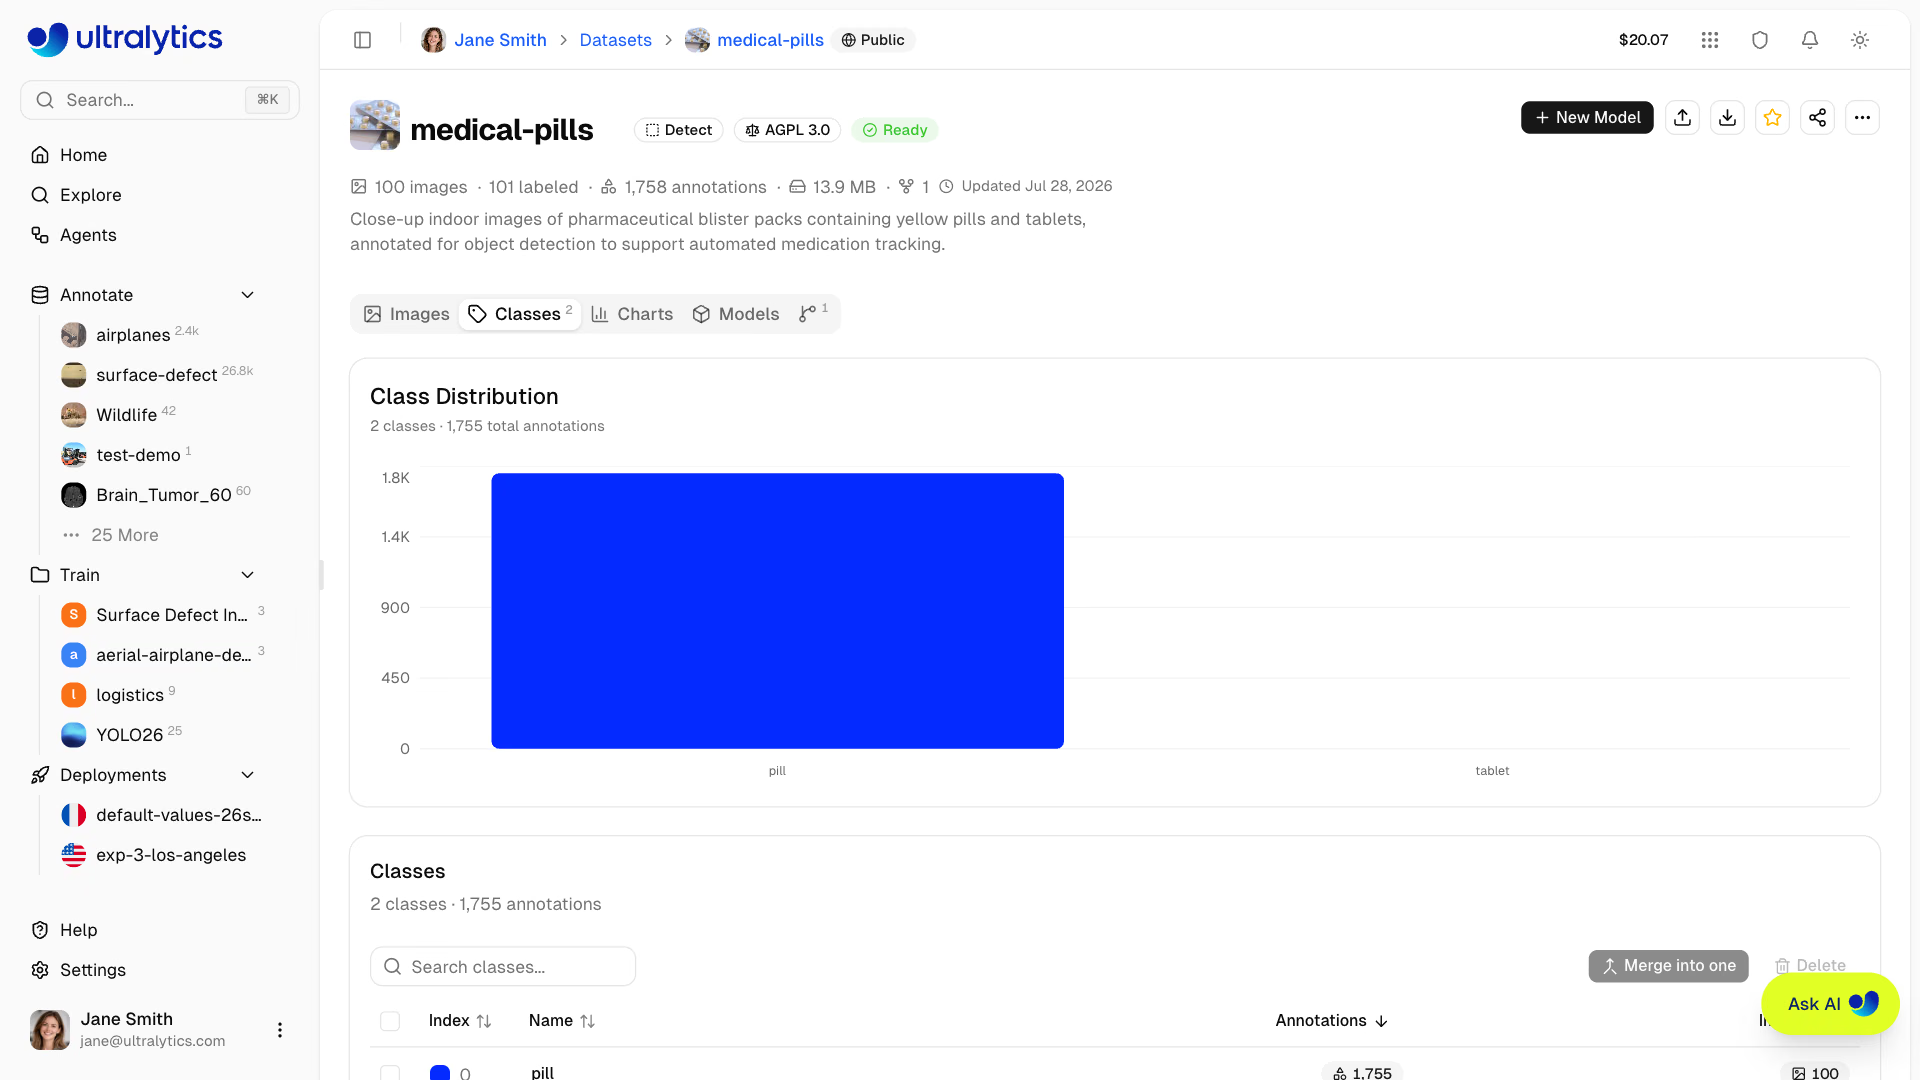
La scheda Classes mostra gli stessi conteggi per il dataset attivo, con un'opzione per la scala logaritmica per i dati sbilanciati. Unisci in una raggruppa classi duplicate come car, automobile e vehicle in un'unica classe senza perdere annotazioni; Elimina rimuove una classe e tutte le sue annotazioni.
Suddividi in base all'unità rispetto a cui vuoi generalizzare#
I fotogrammi della stessa fotocamera, sessione o giornata sono correlati. Se compaiono sia in train sia in val, il modello viene valutato su scene che ha già visto. Escludi intere unità relative a ciò che varia in produzione: se variano le fotocamere, escludi alcune fotocamere; se sono le stesse fotocamere in giornate diverse, escludi alcune giornate.
Gli strumenti di suddivisione della piattaforma si differenziano proprio per questo:
| Strumento | Modalità di assegnazione | Usala per |
|---|---|---|
Cartelle train/, val/, test/ in un caricamento | Mantiene la tua assegnazione | Split di gruppi preparati offline |
| Filtro dello split impostato prima del caricamento | Tutti i file di quel caricamento vengono assegnati allo split selezionato | Caricamento di una fotocamera per split |
| Sposta nello split nella vista Table | Sposta le immagini selezionate | Correzione di immagini specifiche |
| Barra degli split, Ridistribuisci split | Riassegna casualmente tutte le immagini | Solo foto indipendenti |

La lezione Suddividere correttamente il dataset spiega come scegliere l'unità; per dataset molto piccoli, la convalida incrociata k-fold permette di ottenere più informazioni. Per controllare i gruppi dopo il caricamento, aggiungi una chiave di gruppo alla verifica delle classi (per esempio record["file"].split("_")[0] per i file chiamati cam07_000123.jpg, oppure un campo camera nei metadati dell'immagine) e segnala ogni gruppo presente in due split.
Blocca una versione che ha superato i controlli#
Il training richiede uno snapshot fisso. Nella scheda Versions, inserisci una descrizione («v5: cam07 esclusa, +80 immagini di pallet») e fai clic su New Version. Ogni versione è uno snapshot NDJSON numerato e immutabile che puoi scaricare, confrontare o ripristinare; la finestra di dialogo del training, con Save Dataset Version, fa lo stesso all'avvio e riutilizza una versione corrispondente se non è cambiato nulla. Le versioni non sono disponibili per i dataset cloud connessi o On Premise.
Insidie#
Sintomo: dopo aver fatto clic su Auto 80/20, la mAP di convalida aumenta, ma l'accuratezza in produzione no. Soluzione: Ridistribuisci partizioni riassegna casualmente ogni immagine (rimuovendo anche i duplicati esatti) e inserisce fotogrammi adiacenti nelle partizioni di addestramento e convalida. Per i dati raggruppati, usa le cartelle di caricamento o Sposta nella partizione.
Sintomo: un'esportazione precedente o le predizioni di un modello iniziano improvvisamente a riportare nomi di classe errati. Soluzione: gli ID delle classi sono posizionali, quindi unire o eliminare una classe sposta verso il basso tutti gli indici successivi. Crea una versione prima di qualsiasi modifica alle classi e riaddestra il modello invece di riutilizzare i vecchi file di etichette.
Sintomo: una nuova esecuzione ottiene un punteggio inferiore di 5 punti e non è cambiato nient'altro. Soluzione: le metriche sono confrontabili solo se calcolate sulla stessa partizione. Quando modifichi la partizione, annotalo nella descrizione della versione e riesegui il baseline sulla nuova versione prima di fare qualsiasi confronto.
Mostra la soluzione
Soluzione svolta per un dataset di carrelli elevatori ripresi da 8 fotocamere. Il controllo dei duplicati rileva 41 immagini identiche tra train e val, tutte provenienti da una cartella caricata di nuovo; elimina le copie in val. La verifica, ampliata con group = record['file'].split('_')[0], mostra cam02 sia in train sia in val: seleziona quindi le sue immagini in val nella vista Table e scegli Sposta nello split > Train. Segnala anche pallet: train 63, val 7, too few in val: usa Trova immagini simili su due immagini di pallet per aggiungere 40 immagini simili non etichettate, etichettale e sposta 15 immagini di pallet di cam07 in val, così cam07 rimane interamente nello stesso split. Ripeti i controlli: 0 duplicati, 0 gruppi con contaminazioni, 22 pallet in val. Clustering con la colorazione per split non mostra gruppi misti. Salva v5: cam07 val, cam08 test, +40 pallets.