Suddividi correttamente il dataset
Misura quanto i suddivisi casuali causano leakage, suddividi gruppi interi come clip, telecamere o giornate con uno script, controlla la copertura delle classi e blocca il test set.
Una suddivisione approssimativa produce una metrica di cui ti fidi, ma che non è vera. Quando frame video adiacenti finiscono sia nel train sia nel val, il mAP del val misura la memorizzazione invece della capacità di generalizzare, e il divario emerge solo in produzione. Ogni valore che riporti sul modello dipende da questa suddivisione, quindi sceglila con attenzione una volta e mantienila fissa.
Pratico
Tre suddivisioni, tre funzioni#
| Suddivisione | Percentuale tipica | Funzione |
|---|---|---|
| Train | 70% | Il modello apprende i propri pesi da questo set |
| Val | 15% | Scegliere l'epoca migliore, confrontare le esecuzioni, regolare le impostazioni |
| Test | 15% | Un'unica decisione finale go/no-go rispetto al test di accettazione |
Le guide Ultralytics indicano un intervallo del 70–80% per il train e del 10–20% ciascuno per val e test: fasi di un progetto CV suggerisce il 10–15% ciascuno, mentre la guida al preprocessing usa 70/20/10. Calcola le percentuali in base agli oggetti oltre che alle immagini, perché un'immagine affollata può contenere più etichette di dieci immagini con pochi oggetti. Le percentuali esatte contano molto meno dell'uso previsto per ciascuna suddivisione.
I suddivisi casuali causano leakage con dati correlati#
I frame 124 e 125 della stessa clip sono quasi identici. Se uno finisce nel train e l'altro nel val, il val valuta il modello su immagini che ha di fatto già visto. Misura il fenomeno sul set di esercitazione di Raccogliere dati rappresentativi di alta qualità, i cui nomi file iniziano con una chiave di gruppo telecamera-giorno:
import random
from pathlib import Path

images = sorted(Path("datasets/practice/images").glob("*.jpg"))
random.Random(0).shuffle(images)
train, val = images[:90], images[90:109]  # a random per-image 70/15 split

def group(image):
    return image.stem.rsplit("_", 1)[0]

shared = {group(p) for p in train} & {group(p) for p in val}
print(f"{len(shared)} of {len({group(p) for p in val})} val groups also appear in train")
13 of 13 val groups also appear in trainOgni gruppo telecamera-giorno presente nel val compare anche nel train. Con riprese reali, questo significa che i frame del val condividono illuminazione, sfondo e spesso gli stessi oggetti dei frame di training; perciò il mAP del val sembra ottimo, mentre quello in produzione no.
Scegli l'unità di suddivisione#
Scegli il gruppo che corrisponde alla capacità di generalizzazione richiesta in fase di deployment:
In caso di dubbio, suddividi usando l'unità più generale che puoi permetterti: otterrai il valore più attendibile. I suddivisi casuali per immagine sono sicuri solo quando ogni immagine è una ripresa indipendente, come le foto di prodotti scattate a distanza di settimane.
Suddividi per gruppi nel codice#
Questo script assegna gruppi interi alle suddivisioni finché ciascuna non raggiunge la propria quota del 70/15/15, scrive gli elenchi di file accettati da un YAML dei dati e segnala la copertura delle classi:
import random
from collections import Counter, defaultdict
from pathlib import Path

root = Path("datasets/practice")  # contains images/ and labels/

def group(image):
    return image.stem.rsplit("_", 1)[0]  # "cam2_2026-05-01_000124" -> "cam2_2026-05-01"

groups = defaultdict(list)
for image in sorted((root / "images").glob("*.jpg")):
    groups[group(image)].append(image)

keys = sorted(groups)
random.Random(0).shuffle(keys)  # fixed seed: the same split on every run
total, assigned = sum(len(v) for v in groups.values()), 0
splits = {"train": [], "val": [], "test": []}
for key in keys:  # assign whole groups until each split reaches its 70/15/15 share
    share = assigned / total
    splits["train" if share < 0.70 else "val" if share < 0.85 else "test"] += groups[key]
    assigned += len(groups[key])

counts = {}
for split, images in splits.items():
    (root / f"{split}.txt").write_text("".join(f"./images/{p.name}\n" for p in images))
    labels = [root / "labels" / f"{p.stem}.txt" for p in images]
    counts[split] = Counter(int(r.split()[0]) for f in labels if f.exists() for r in f.read_text().splitlines() if r.strip())

all_classes = set().union(*counts.values())
for split, images in splits.items():
    missing = len(all_classes - set(counts[split]))
    print(f"{split:>5}: {len(images):3d} images, {len({group(p) for p in images}):2d} groups, {missing} of {len(all_classes)} classes missing")
train: 90 images, 11 groups, 5 of 71 classes missing
val: 20 images, 2 groups, 36 of 71 classes missing
test: 18 images, 3 groups, 41 of 71 classes missingCome interpretarlo:
- Per costruzione, nessun gruppo attraversa una suddivisione. Il leakage è risolto.
- Il val contiene 2 gruppi e non include 36 classi, quindi non è possibile misurarne l'AP. Con 71 classi in 128 immagini, nessun seed può risolvere il problema: la soluzione reale è aggiungere gruppi (altre telecamere o giornate), come avviene in un dataset di produzione con oltre 1.500 immagini per classe.
- Nel train mancano 5 classi presenti solo nel val o nel test. Con questa suddivisione il modello non potrà mai apprenderle.
La regola decisionale: quando una classe manca da una suddivisione, aggiungi o sposta gruppi interi che la contengono, mai singoli frame, che reintrodurrebbero il leakage. Imposta le chiavi train, val e test dello YAML dei dati in modo che puntino ai tre file .txt; Scrivere uno YAML del dataset spiega il resto del file.
Bilancia le classi tra le suddivisioni#
Per la classificazione, train_test_split(..., stratify=labels) di scikit-learn mantiene uguali le proporzioni delle classi tra le suddivisioni con un solo argomento. Le immagini di rilevamento contengono più classi contemporaneamente, quindi bilancia a livello di gruppo: dopo group_split.py, confronta il conteggio per classe tra le suddivisioni e scambia gruppi interi finché ogni classe rientra circa entro ±20% della quota prevista.

Su Ultralytics Platform, Redistribute Splits riassegna le immagini casualmente e Auto imposta la suddivisione train/val consigliata 80/20 (documentazione sulla suddivisione). Rimuove le immagini duplicate esatte durante il processo, ma non riconosce i tuoi gruppi; usalo quindi per riprese indipendenti e carica suddivisioni raggruppate per i dati video o multi-camera.
Monitora separatamente due set di val#
Spesso servono due set di val: una suite di regressione stabile e curata e un set realistico per la produzione, aggiornato con i frame raccolti di recente. Lo YAML dei dati accetta un elenco di cartelle val, ma le unisce in un unico set val con un solo punteggio:
path: ./datasets/forklift
train: images/train
val:
  - images/val_curated      # stable, your regression suite
  - images/val_production   # rotates with newly collected frames
test: images/test
Per visualizzare i singoli punteggi, mantieni uno YAML dei dati per ogni set val (stessi train e names, val diversi) e convalida i pesi addestrati su ciascun set:
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")  # your fine-tuned checkpoint
for data in ("val_curated.yaml", "val_production.yaml"):
    metrics = model.val(data=data)
    print(f"{data:<20} mAP50-95={metrics.box.map:.3f}")
Un calo sul set curato indica una regressione; un calo sul set di produzione indica uno spostamento di dominio.
Blocca il test set#
L'errore di suddivisione più costoso è confrontare dieci varianti del modello sul set di test. Una volta che il test ha influenzato una qualsiasi decisione, il punteggio finale è ottimistico. Regola i parametri e confronta le esecuzioni sul set di validazione; esegui il test di accettazione sul set di test una sola volta, alla fine.
Ogni metrica che pubblichi dipende da questa suddivisione. Rimescolare i dati in seguito cambia ogni numero e rende impossibile confrontare le esecuzioni vecchie e nuove. Conserva con il dataset l'unità di suddivisione, il seed e i tre elenchi di file.
Convalida incrociata K-fold per dataset piccoli#
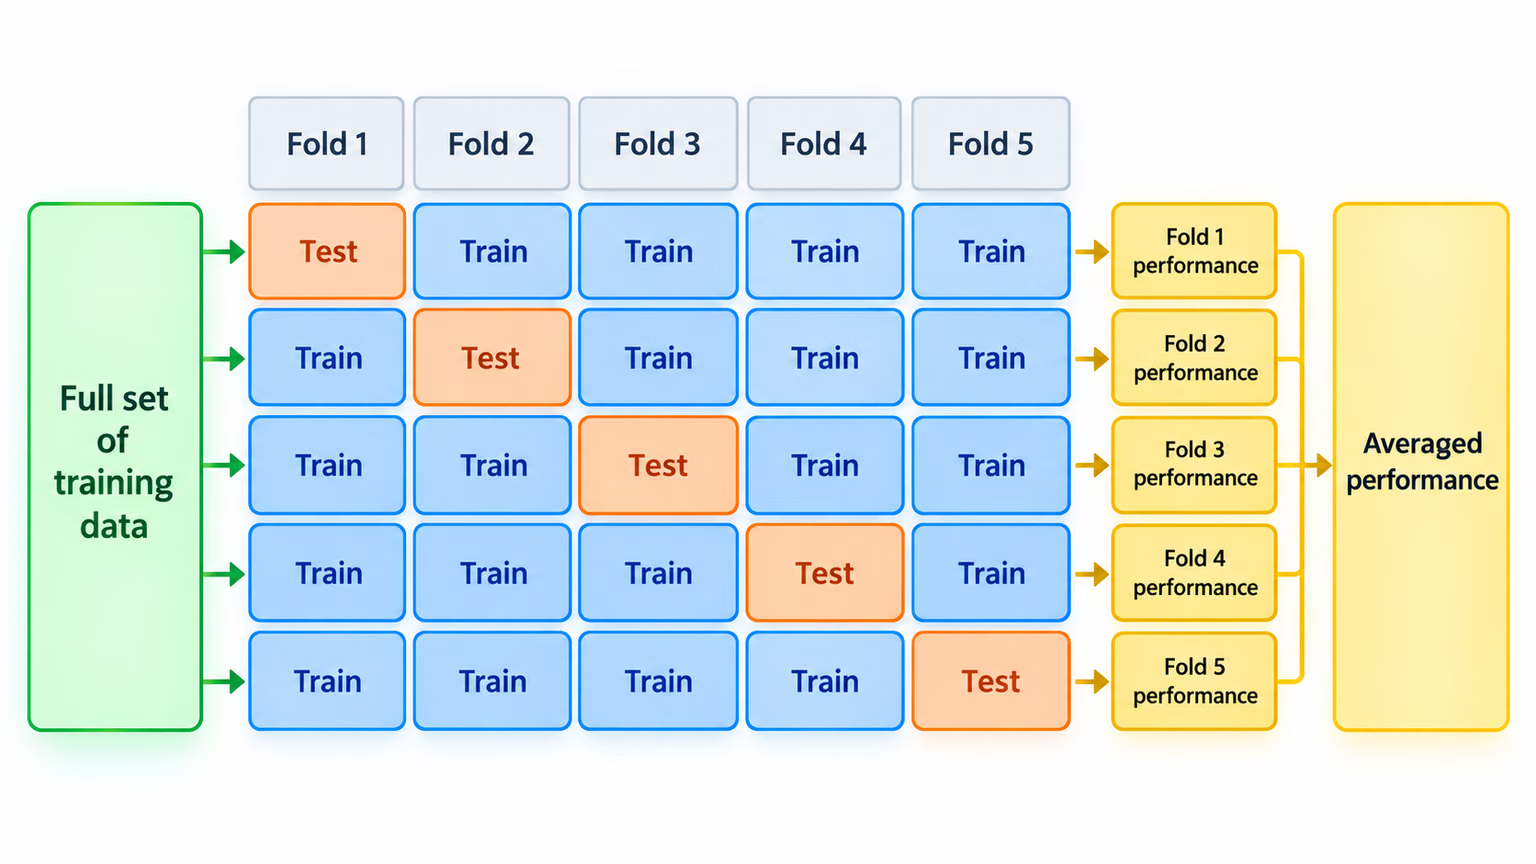
Quando il dataset è piccolo (meno di circa 500 immagini per classe) e una singola suddivisione sembra statisticamente poco affidabile, la convalida incrociata K-fold addestra k modelli su suddivisioni a rotazione e calcola la media dei risultati: k volte il costo di calcolo per una stima molto più stabile. Crea i fold a partire dai gruppi allo stesso modo, altrimenti ogni fold sarà soggetto a leakage.
Mostra la soluzione
Per telecamere fisse in magazzino che devono continuare a funzionare nei giorni successivi, suddividi per telecamera-giorno: cam2_2026-05-01. Dopo group_split.py, verifica che nessun gruppo attraversi il confine tra suddivisioni:
from pathlib import Path

root = Path("datasets/practice")
groups = {s: {Path(p).stem.rsplit("_", 1)[0] for p in (root / f"{s}.txt").read_text().split()} for s in ("train", "val", "test")}
print("train & val: ", groups["train"] & groups["val"] or "none")
print("train & test:", groups["train"] & groups["test"] or "none")
print("val & test:  ", groups["val"] & groups["test"] or "none")
train & val: none
train & test: none
val & test: noneLa suddivisione di esercitazione supera il controllo del leakage, ma non quello della copertura: nel val mancano 36 classi su 71. La soluzione è un piano di raccolta, non una riorganizzazione. Acquisisci almeno altre due giornate di riprese per val e test, ognuna delle quali copra le classi più importanti per le specifiche, poi esegui di nuovo entrambi gli script.