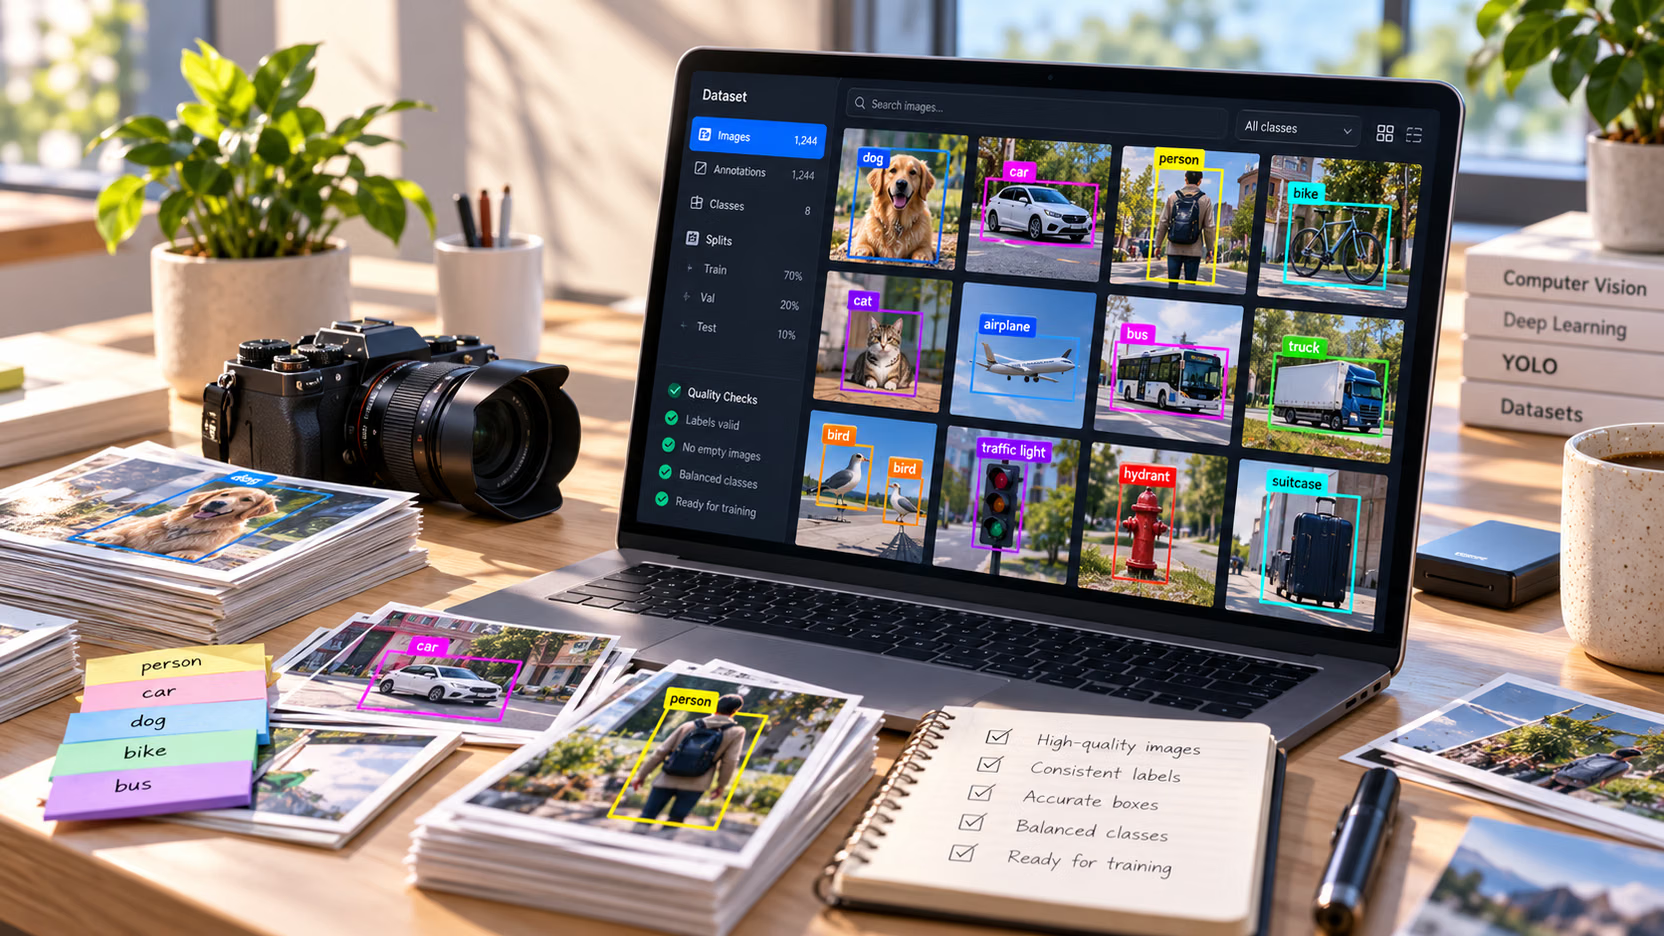
Creare dataset YOLO ad alte prestazioni
Una guida pratica al lavoro da fare prima dell'addestramento: trasforma un obiettivo aziendale in un test di accettazione, definisci e raccogli dati rappresentativi, annota in modo coerente, verifica la qualità con script, crea split senza leakage, ottimizza l'augmentation e avvia il primo fine-tuning di Ultralytics YOLO26 solo dopo aver superato un controllo di idoneità.
Di Ultralytics Academy
Trasforma un obiettivo aziendale in un dataset documentato, bilanciato e senza leakage, pronto per il fine-tuning di Ultralytics YOLO26, e scopri esattamente cosa correggere se non è ancora pronto.
Trasforma un obiettivo aziendale in un task di visione, definisci le classi e crea un test di accettazione eseguibile come codice.
Scrivi una specifica del dataset con quote per scenario, dimensionata in base agli obiettivi di Ultralytics: ≥1.500 immagini e ≥10.000 istanze etichettate per classe, con lo 0–10% di immagini di background.
Raccogli dati nelle reali condizioni di deployment, conserva i metadati di acquisizione nei nomi dei file e campiona i video senza sovraccaricare il dataset.
Annota in modo coerente, basandoti su una guida scritta, un turno di calibrazione misurato e la consapevolezza dei dieci errori di annotazione più comuni.
Verifica le etichette, il bilanciamento delle classi, i duplicati e le probabili etichette mancanti con brevi script Python.
Crea gli split per gruppo (clip, telecamera, giorno, sito) in modo che i punteggi di validazione rispecchino la produzione, e blocca il test set.
Scegli impostazioni di augmentation adatte al deployment e verificale nei batch di training.
Subordina l'addestramento a un controllo di idoneità in otto punti e usa il primo fine-tuning di base per individuare la prossima correzione da apportare al dataset.
Una descrizione dell'obiettivo di una pagina e uno script di test di accettazione che stampa PASS o FAIL.
Una specifica del dataset con quote per scenario, casi limite e una percentuale di immagini di background.
Un dataset di prova con i metadati di acquisizione in ogni nome file, più un report di copertura rispetto alle tue quote.
Una guida all'annotazione perfezionata con un turno di calibrazione e un punteggio di accordo misurato.
Un controllo QC e una revisione delle etichette sospette con brevi note QC.
Elenchi di file train / val / test raggruppati, senza clip, telecamere o giorni condivisi tra gli split.
Un controllo di idoneità con punteggio, un primo fine-tuning ordinato per classe e una checklist di avvio riutilizzabile.
Non è richiesta alcuna esperienza di machine learning: ogni concetto viene spiegato prima di essere usato.
Python 3.10+ con
pip install ultralyticsper eseguire gli script; per tutti gli esempi è sufficiente una CPU.Consigliato: Fondamenti di visione artificiale per acquisire il vocabolario di base.
Contenuti del corso
5 moduli · 10 lezioniModulo 1
Parti dall'obiettivo aziendale
Trasforma un obiettivo aziendale in un task di visione, definisci le classi e crea un test di accettazione eseguibile come codice, prima di raccogliere anche una sola immagine.
Definisci la specifica del dataset
Pianifica scenari, quote, variabilità, casi limite e immagini di sfondo prima della raccolta, e dimensiona il piano in base agli obiettivi di volume di Ultralytics.
Modulo 3
Best practice per l'annotazione
Scrivi una guida all'etichettatura, scegli uno strumento, evita i dieci errori che compromettono silenziosamente la precisione e misura con uno script l'accordo tra annotatori prima di aumentare la scala.
Controllo qualità del dataset
Verifica le etichette, il bilanciamento delle classi, i duplicati e la copertura degli split con uno script; chiedi a un modello di segnalare le probabili etichette mancanti e correggi i problemi prima del training.
Modulo 4
Suddividi correttamente il dataset
Misura quanto i suddivisi casuali causano leakage, suddividi gruppi interi come clip, telecamere o giornate con uno script, controlla la copertura delle classi e blocca il test set.
Usa l'aumento dei dati con attenzione
Verifica ogni trasformazione di aumento dei dati rispetto alla telecamera di deployment, crea un profilo motivato, usalo per il training e controlla il risultato nei batch di training.
Modulo 5
Sapere quando il set di dati è pronto
Subordina la prima esecuzione di addestramento a otto controlli superato/non superato, automatizza i tre verificabili da uno script e individua la correzione necessaria per ogni controllo non superato.
Primo fine-tuning e ciclo iterativo
Esegui il fine-tuning dei pesi YOLO26 preaddestrati con le impostazioni predefinite, ordina le classi in base all'AP e ai conteggi di mancate rilevazioni e confusioni, quindi trasforma la classe più debole nella prossima correzione del dataset.
Checklist per i clienti aziendali
Una checklist di avvio di una pagina, destinata al cliente, che registra ogni decisione sul dataset prima della raccolta e stabilisce i criteri per ogni nuovo training.