Sapere quando il set di dati è pronto
Subordina la prima esecuzione di addestramento a otto controlli superato/non superato, automatizza i tre verificabili da uno script e individua la correzione necessaria per ogni controllo non superato.
Ogni progetto arriva al momento in cui il team vuole avviare l'addestramento. A volte il set di dati è pronto; altre volte presenta ancora una fuga tra le suddivisioni o una classe con etichette insufficienti, che farà sprecare una settimana di tempo GPU e produrrà un numero di cui nessuno dovrebbe fidarsi. Otto controlli, ciascuno valutato come sì, no o eccezione documentata, rendono la decisione oggettiva anziché dettata dall'umore.
Pratico
Gli otto controlli#
| # | Controllo | Criteri per superare il controllo | Se non lo supera, torna a |
|---|---|---|---|
| 1 | Obiettivo chiaro | Obiettivo, attività, classi e test di accettazione sono documentati e approvati | Parti dall'obiettivo aziendale |
| 2 | Classi definite | Ogni classe ha una definizione e un elemento simile, indicato per nome, che ne è escluso | Obiettivo e guida all'etichettatura |
| 3 | Immagini rappresentative | Ogni scenario delle specifiche raggiunge la propria quota, prevalentemente con fonti di produzione | Raccogliere dati rappresentativi e di alta qualità |
| 4 | Volume sufficiente | ≥ 1.500 immagini e ≥ 10.000 istanze per classe, oppure un'eccezione documentata | Specifiche e raccolta |
| 5 | Etichette coerenti | Guida redatta, sessione di calibrazione completata, accordo ≥ 90% | Best practice per l'annotazione |
| 6 | Controllo qualità completato | Script di audit senza errori, casi sospetti esaminati, note sul controllo qualità redatte | Controllo qualità del set di dati |
| 7 | Suddivisioni pulite | Suddivisione per gruppi, nessun gruppo presente in due suddivisioni, ogni classe presente in ciascuna suddivisione | Suddividere correttamente il set di dati |
| 8 | Immagini di sfondo | Tra lo 0 e il 10% delle immagini sono fotogrammi senza etichette | Specifiche e raccolta |
La checklist verifica una per una le stesse decisioni trattate dalla guida alla raccolta e all'annotazione dei dati; qui diventano un'unica decisione di via libera o di stop.
Automatizza i controlli quantificabili#
I controlli 4, 7 e 8 si basano su calcoli, quindi uno script li valuta sempre allo stesso modo. Questo script legge il set di esercitazione e gli elenchi delle suddivisioni creati da group_split.py nella lezione precedente:
from collections import Counter
from pathlib import Path

root = Path("datasets/practice")  # images/, labels/, and the train/val/test.txt lists from group_split.py
splits = {s: [Path(p).stem for p in (root / f"{s}.txt").read_text().split()] for s in ("train", "val", "test")}

def classes(stem):
    label = root / "labels" / f"{stem}.txt"
    return [int(r.split()[0]) for r in label.read_text().splitlines() if r.strip()] if label.exists() else []

stems = [s for split in splits.values() for s in split]
instances = Counter(c for s in stems for c in classes(s))
images = Counter(c for s in stems for c in set(classes(s)))
background = sum(not classes(s) for s in stems) / len(stems)
groups = {split: {s.rsplit("_", 1)[0] for s in names} for split, names in splits.items()}
per_split = {split: {c for s in names for c in classes(s)} for split, names in splits.items()}
shared = (groups["train"] & groups["val"]) | (groups["train"] & groups["test"]) | (groups["val"] & groups["test"])
weakest = min(instances, key=lambda c: (images[c], instances[c]))

checks = {
    "4 volume": (images[weakest] >= 1500 and instances[weakest] >= 10_000,
                 f"weakest class {weakest}: {images[weakest]} images, {instances[weakest]} instances"),
    "7 no shared groups": (not shared, f"{len(shared)} groups appear in more than one split"),
    "7 every class in every split": (all(per_split[s] == set(instances) for s in splits),
                                     ", ".join(f"{s} misses {len(set(instances) - per_split[s])}" for s in splits)),
    "8 background 0-10%": (background <= 0.10, f"{background:.1%} background images"),
}
for name, (ok, detail) in checks.items():
    print(f"{'PASS' if ok else 'FAIL'}  {name:<29} {detail}")
FAIL 4 volume weakest class 30: 1 images, 1 instances
PASS 7 no shared groups 0 groups appear in more than one split
FAIL 7 every class in every split train misses 5, val misses 36, test misses 41
PASS 8 background 0-10% 1.6% background imagesLa suddivisione per gruppi ha risolto la fuga, ma il set di esercitazione è ben lontano dall'essere pronto: la classe più debole (30, skis) ha una sola istanza etichettata e val non può valutare metà delle classi. È il verdetto atteso per 128 immagini dimostrative, ed è proprio il verdetto che questo controllo deve fornire prima di una settimana di addestramento.
Lo script copre ciò che si può contare. Per i controlli 1, 2, 3, 5 e 6 serve una persona: un obiettivo concordato, definizioni scritte, copertura della specifica, un punteggio di accordo misurato e note di controllo qualità. Assegnagli un punteggio manualmente, con una riga di evidenza per ciascuno.
Decidi: addestrare, procedere con una lacuna o correggere#
Quando un controllo non viene superato, il passo successivo più allettante è quasi sempre qualcosa di diverso dal correggere i dati:
| Scorciatoia allettante | Perché non funziona |
|---|---|
| "Prova un modello più grande." | Un modello più grande impara il rumore nelle etichette con altrettanta fedeltà. |
| "Regola il tasso di apprendimento." | Nessuna impostazione dell'ottimizzatore aggiunge una classe o uno scenario mancante. |
| "Addestra per più epoche." | Più epoche su dati poco vari tendono a causare prima l'overfitting. |
| "Aggiungi altro aumento dei dati." | L'aumento dei dati non può creare scenari assenti dai dati originali. |
Tre situazioni quasi pronte#
| Situazione | Controllo non superato | Come si presenta | Soluzione |
|---|---|---|---|
| Volume senza variabilità | 3 | 5.000 immagini, una telecamera, nessun caso limite | Raccogli dati da più telecamere, siti e orari prima dell'addestramento |
| Variabilità senza coerenza | 5 | Gli annotatori non concordano sull'estensione dei riquadri e sull'occlusione | Completa la guida, calibra e rietichetta il campione interessato |
| Fuga non evidente | 7 | Suddivisione casuale per immagine dei fotogrammi video | Suddividi di nuovo per clip, telecamera o giorno; aspettati che il mAP di validazione diminuisca, perché questo calo riflette la realtà |
Rilascia con una lacuna nota#
Spesso la scelta giusta è un primo modello mirato prima che tutti i controlli siano superati: un progetto pilota, un prototipo o una v1 su un sottoinsieme di telecamere. Un modello in produzione mostra cosa non va davvero più in fretta che perfezionare il dataset senza vedere i risultati. Quando rilasci con una lacuna, annota tre cose:
- Quale controllo non è stato superato.
- L'impatto previsto, per esempio "nessun dato notturno; aspettati un richiamo inferiore dopo il tramonto".
- Il piano di raccolta dati per colmare la lacuna mentre la v1 è in esecuzione.
"Volume: eccezione" non dice nulla alla persona successiva. "Volume: pallet a 700 istanze; aspettati un richiamo inferiore dei pallet nelle aree di carico affollate; altre 2.000 etichette entro giugno" è un rischio gestito. Per ogni eccezione, indica l'impatto previsto sul test di accettazione.
Ripeti i controlli prima di ogni nuovo addestramento#
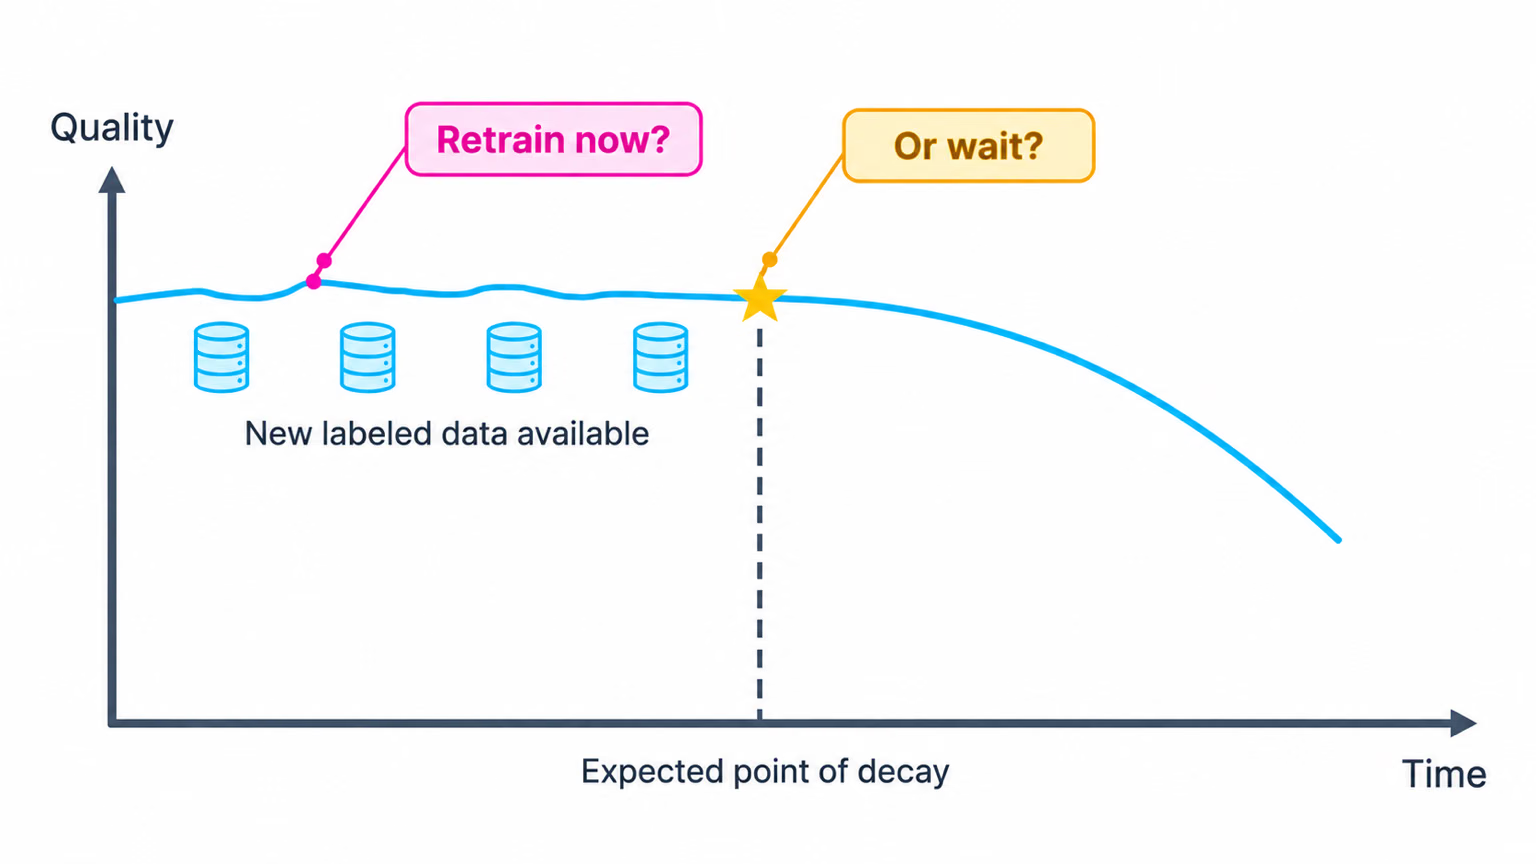
Un dataset pronto per la v1 non è automaticamente pronto per la v3. Nuove classi, nuove fonti e nuovi annotatori possono ciascuno compromettere un controllo che prima veniva superato, mentre i dati di produzione cambiano man mano che si accumulano nuove etichette. Esegui di nuovo readiness.py e valuta nuovamente i controlli manuali prima di ogni nuovo addestramento; bastano pochi minuti, mentre saltarli può costarti una settimana di addestramento su un dataset compromesso.
Mostra la soluzione
Una checklist con punteggi per il set di esercitazione:
| # | Controllo | Punteggio | Evidenza |
|---|---|---|---|
| 1 | Obiettivo chiaro | sì | objective.md e acceptance_test.py della lezione 1 |
| 2 | Classi definite | no | Gli 80 nomi di COCO non hanno definizioni scritte né esempi simili da escludere |
| 3 | Immagini rappresentative | no | coverage.py: cam2–cam4 sotto la quota |
| 4 | Volume sufficiente | no | readiness.py: la classe più debole ha 1 immagine |
| 5 | Etichette coerenti | no | Accordo del 47% nel turno di calibrazione |
| 6 | Controllo qualità completato | parziale | Verifica eseguita; i casi sospetti in 000000000438.jpg sono ancora da risolvere |
| 7 | Suddivisioni senza contaminazioni | no | Nessun gruppo condiviso, ma val non include 36 delle 71 classi |
| 8 | Immagini di sfondo | sì | 1.6% |
Decisione: correggere prima. In ordine di rischio per il test di accettazione: (1) riduci l'elenco delle classi a quelle necessarie per l'obiettivo, così da semplificare contemporaneamente i controlli 2, 4 e 7; (2) raccogli altri gruppi per quelle classi; (3) completa la regola della guida sulle persone distanti e rietichetta. Un set dimostrativo non supera questo controllo, e dovrebbe essere così.