Primo fine-tuning e ciclo iterativo
Esegui il fine-tuning dei pesi YOLO26 preaddestrati con le impostazioni predefinite, ordina le classi in base all'AP e ai conteggi di mancate rilevazioni e confusioni, quindi trasforma la classe più debole nella prossima correzione del dataset.
L'esercitazione di questa lezione ottiene 0.66 mAP50, un risultato che sembra indicare un problema con il tasso di apprendimento. Una tabella per classe dimostra il contrario: cup contiene 14 oggetti etichettati in val e il modello non ne trova nessuno. È un problema dei dati, che nessun iperparametro avrebbe risolto. Considera la prima esecuzione come una diagnosi che ti indica quale classe correggere dopo.
Pratico
Parti dai pesi preaddestrati#
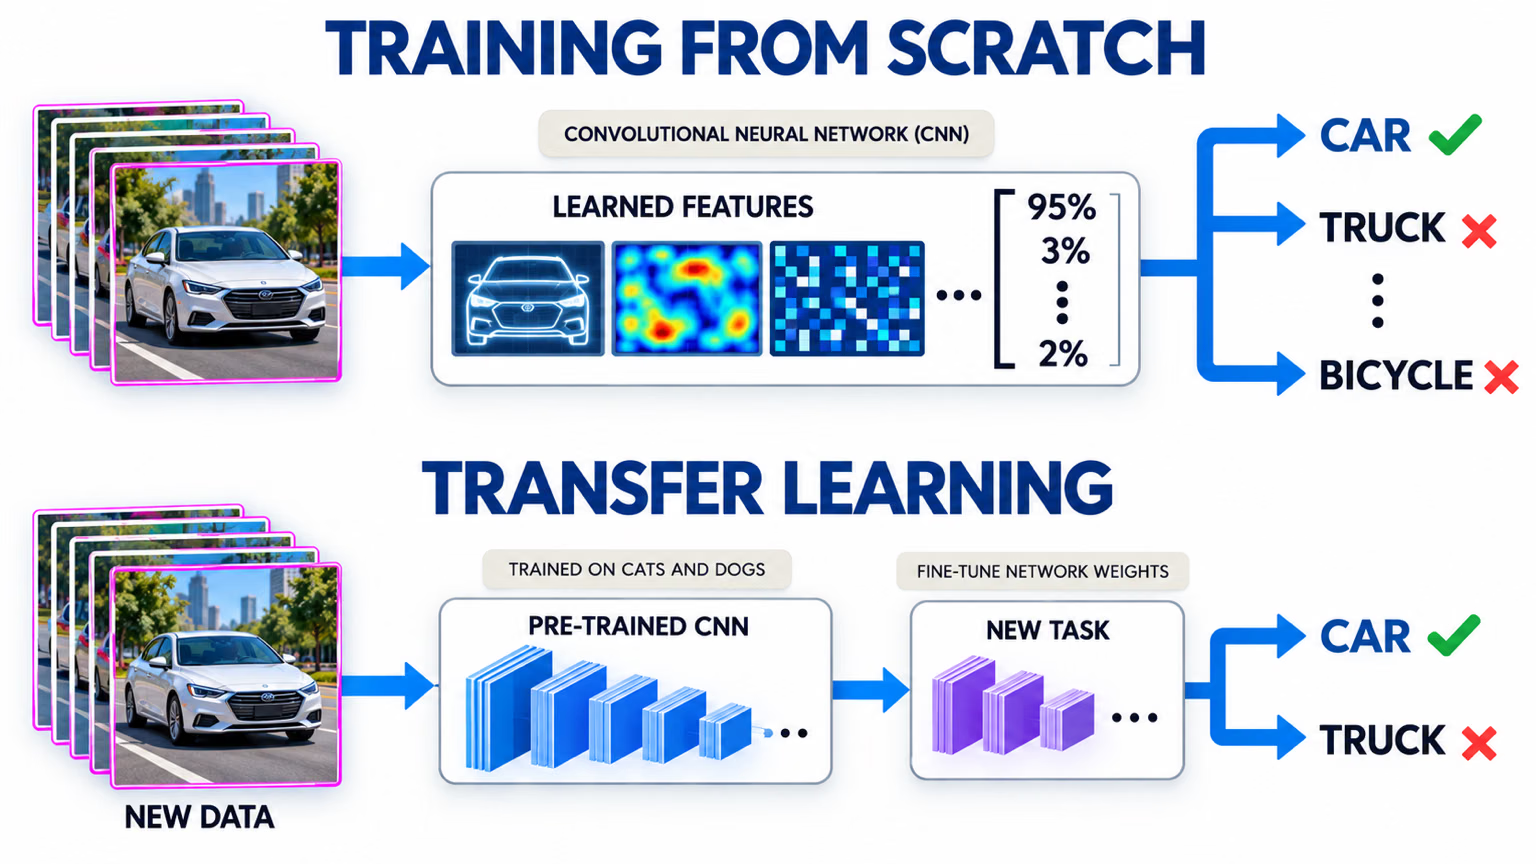
Il fine-tuning parte da pesi che riconoscono già bordi, texture e forme, quindi converge più rapidamente e richiede molti meno dati rispetto all'addestramento con pesi casuali. Scegli il checkpoint YOLO26 adatto alla tua attività:
| Task | Checkpoint preaddestrato | Preaddestrato su |
|---|---|---|
| Rilevamento | yolo26n.pt | COCO |
| Segmentazione | yolo26n-seg.pt | COCO |
| Semantica | yolo26n-sem.pt | Cityscapes |
| Posa | yolo26n-pose.pt | Punti chiave COCO |
| OBB | yolo26n-obb.pt | DOTAv1 |
| Classificazione | yolo26n-cls.pt | ImageNet |
| Profondità | yolo26n-depth.pt | Un ampio insieme di dati di profondità per ambienti interni ed esterni |
Il backbone e il neck vengono trasferiti così come sono; la testa del task viene in parte reinizializzata per adattarsi al numero di classi. L'addestramento da zero conviene solo con dataset molto grandi in domini molto insoliti. Inizia dal modello nano (n) per ottenere rapidamente un riferimento iniziale e passa a dimensioni maggiori solo quando il ciclo sui dati non dà più risultati. La guida al fine-tuning spiega cosa succede internamente.
Esegui il modello di base#
Usa le impostazioni predefinite: lo scopo della prima esecuzione è ottenere un riferimento, non stabilire un record. Questa esecuzione usa la suddivisione del set di esercitazione descritta in Suddividere correttamente il dataset, iniziando con la scrittura del file YAML dei dati:
from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset
from ultralytics.utils import YAML

names = check_det_dataset("coco128.yaml")["names"]  # il set di esercitazione mantiene i nomi delle classi di COCO
YAML.save("practice.yaml", {"path": "datasets/practice", "train": "train.txt", "val": "val.txt", "test": "test.txt", "names": names})

model = YOLO("yolo26n.pt")  # preaddestrato su COCO; usa il checkpoint per la tua attività
model.train(data="practice.yaml", epochs=3, imgsz=320)  # un'esecuzione reale: epochs=100, imgsz=640
Class Images Instances Box(P R mAP50 mAP50-95)
all 20 143 0.614 0.6 0.664 0.486La cartella dell'esecuzione (runs/detect/train/) ora contiene weights/best.pt. Nella prima esecuzione vale la pena considerare solo tre argomenti:
| Argomento | Predefinita | Quando modificare |
|---|---|---|
epochs | 100 | Meno per i dataset minuscoli; 200–300 per quelli molto grandi |
imgsz | 640 | 1024 o 1280 se nell'immagine ci sono molti oggetti piccoli |
batch | 16 | -1 per il batch automatico; riducilo in caso di errori di memoria esaurita |
Addestra il tuo primo modello illustra nel dettaglio la chiamata di addestramento e il relativo log in tempo reale.
Ordina le classi e analizza gli errori di rilevamento#
Il mAP complessivo non mostra dove si trova il problema. Ordina le classi in base ad AP50-95 e usa la matrice di confusione per suddividere gli errori di ogni classe tra gli oggetti che il modello non ha rilevato affatto e quelli a cui ha assegnato un'altra classe:
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")  # your fine-tuned checkpoint
metrics = model.val(data="practice.yaml", imgsz=320, verbose=False)  # same data YAML and imgsz as training

matrix = metrics.confusion_matrix.matrix  # rows: predicted class, columns: true class; last row = background
for ap, cls in sorted(zip(metrics.box.ap, metrics.box.ap_class_index))[:5]:  # weakest five classes first
    total, missed, correct = matrix[:, cls].sum(), matrix[-1, cls], matrix[cls, cls]
    print(f"{model.names[cls]:>8}  AP50-95={ap:.3f}  {total:2.0f} labeled: {correct:2.0f} found, "
          f"{missed:2.0f} missed, {total - correct - missed:2.0f} called another class")
car AP50-95=0.000 4 labeled: 0 found, 4 missed, 0 called another class
fork AP50-95=0.000 1 labeled: 0 found, 0 missed, 1 called another class
handbag AP50-95=0.025 1 labeled: 1 found, 0 missed, 0 called another class
cup AP50-95=0.039 14 labeled: 0 found, 10 missed, 4 called another class
sink AP50-95=0.075 1 labeled: 1 found, 0 missed, 0 called another classOgni tipo di errore indica una correzione diversa per il dataset:
- Troppi pochi esempi in val (
fork,handbag,sink, con 1 ciascuno): l'AP è rumore. Non intervenire su una classe finché val non contiene almeno alcune decine di suoi esempi; prima raccogli altri gruppi per val. - Non rilevato (
car4 su 4,cup10 su 14): il modello non vede affatto l'oggetto. Controlla la copertura di quello scenario in train e cerca etichette mancanti consuspect_labels.py. - Classificato come un'altra classe (
cup4 su 14): le definizioni delle classi si sovrappongono. Apri quelle immagini, rendi più precise le definizioni e indica nella guida l'esempio simile.
cup è il risultato su cui intervenire: 14 esempi etichettati e nessuno rilevato.
Leggi la cartella dell'esecuzione come riscontro sui dati#

Ogni esecuzione di addestramento genera questi file e la Ultralytics Platform visualizza le stesse curve in tempo reale durante l'addestramento sul cloud:
| File | Cosa rivela sui dati |
|---|---|
confusion_matrix_normalized.png | Quali classi vengono confuse tra loro o scambiate per sfondo |
BoxPR_curve.png | Precisione e richiamo per classe; una curva bassa indica una classe debole |
val_batch0_pred.jpg | Previsioni su immagini val reali; cerca errori di rilevamento sistematici |
labels.jpg | Conteggi delle classi e dimensioni dei riquadri usati per l'addestramento del modello |
results.png | Curve di perdita e metriche; una perdita di val in aumento mentre quella di train diminuisce segnala overfitting |
Validazione e diagnosi spiega ogni grafico; qui, la domanda è sempre quali dati mancano.
Il ciclo incentrato sui dati#
Un'iterazione tipica: scegli la classe più debole con un numero sufficiente di esempi in val, verifica circa 50 immagini che la contengono, correggi i dati, riaddestra con le stesse impostazioni e la stessa suddivisione, quindi confronta l'AP per classe. Passa poi alla classe successiva più debole.
Se aggiungi 300 immagini e aumenti imgsz nello stesso nuovo addestramento, non puoi sapere quale modifica ha spostato il punteggio. Mantieni identici le impostazioni e la suddivisione mentre iteri sui dati, così ogni confronto isola una singola modifica ai dati.
Quando intervenire sugli iperparametri#
Dopo due o tre iterazioni sui dati, quando le classi deboli rimaste non sono più riconducibili a copertura, etichette o definizioni, l'ottimizzazione può farti guadagnare gli ultimi punti. La guida al fine-tuning illustra il congelamento dei layer, i tassi di apprendimento e la scelta dell'ottimizzatore. Se però ottimizzi prima che i dati siano corretti, passerai settimane a ottimizzare un modello basato su un dataset sbagliato.
Quando un modello supera acceptance_test.py sul set di test bloccato, YOLO di Ultralytics in produzione illustra l'esportazione e la messa in servizio, mentre Monitorare lo stato e la precisione e Automatizzare il ciclo di riaddestramento in Sviluppare con Ultralytics Platform trattano il ciclo di riaddestramento.
Mostra la soluzione
Dalla prova, cup è la classe su cui intervenire: 14 etichettate in val, 0 rilevate, 10 mancate, 4 assegnate a un'altra classe. Un piano quantificato:
| Rilievo | Azione sul dataset | Dimensione |
|---|---|---|
| 10 di 14 tazze mancate | Verifica la copertura del train: conta le immagini di train con tazze per giorno e telecamera; raccogli immagini di tazze nei gruppi che non ne hanno | 40 nuove immagini con tazze, distribuite su 4 giorni e telecamere |
| 4 di 14 assegnate a un'altra classe | Aprile in val_batch0_pred.jpg e nella matrice di confusione; se sono assegnate a wine glass o bowl, aggiungi entrambe le classi simili alla definizione di cup | Rietichetta circa 30 immagini di train secondo la nuova regola |
| Classi con 1 istanza | Non intervenire ancora; aggiungi gruppi di val che le contengano | Prossimo ciclo di raccolta |
Poi ripeti il training con epochs, imgsz e lo split invariati, riesegui rank_classes.py e confronta l'AP di cup prima e dopo. Se aumenta, il collo di bottiglia erano i dati; se non aumenta, verifica le 50 immagini successive prima di modificare un iperparametro.