Addestra il tuo primo modello
Esegui il fine-tuning di YOLO26 sul tuo dataset con una sola chiamata, leggi il log di addestramento in tempo reale riga per riga e individua best.pt e i grafici più importanti nella cartella dell'esecuzione.
Addestrare un rilevatore da zero richiede giorni e dataset enormi. Eseguire il fine-tuning di un YOLO26 preaddestrato su circa cento immagini richiede circa un minuto su una CPU di laptop, perché l'apprendimento per trasferimento riutilizza tutto ciò che il modello già sa su bordi, forme e oggetti.
In questa lezione addestrerai il modello sul dataset di pillole, vedrai la mAP50-95 salire da un valore iniziale prossimo allo zero a 0.66 in dieci epoche e imparerai a capire fin dalle prime righe del log se un'esecuzione procede bene o ti sta facendo perdere tempo.
Pratico
Esempio pratico: addestrare il rilevatore di pillole#
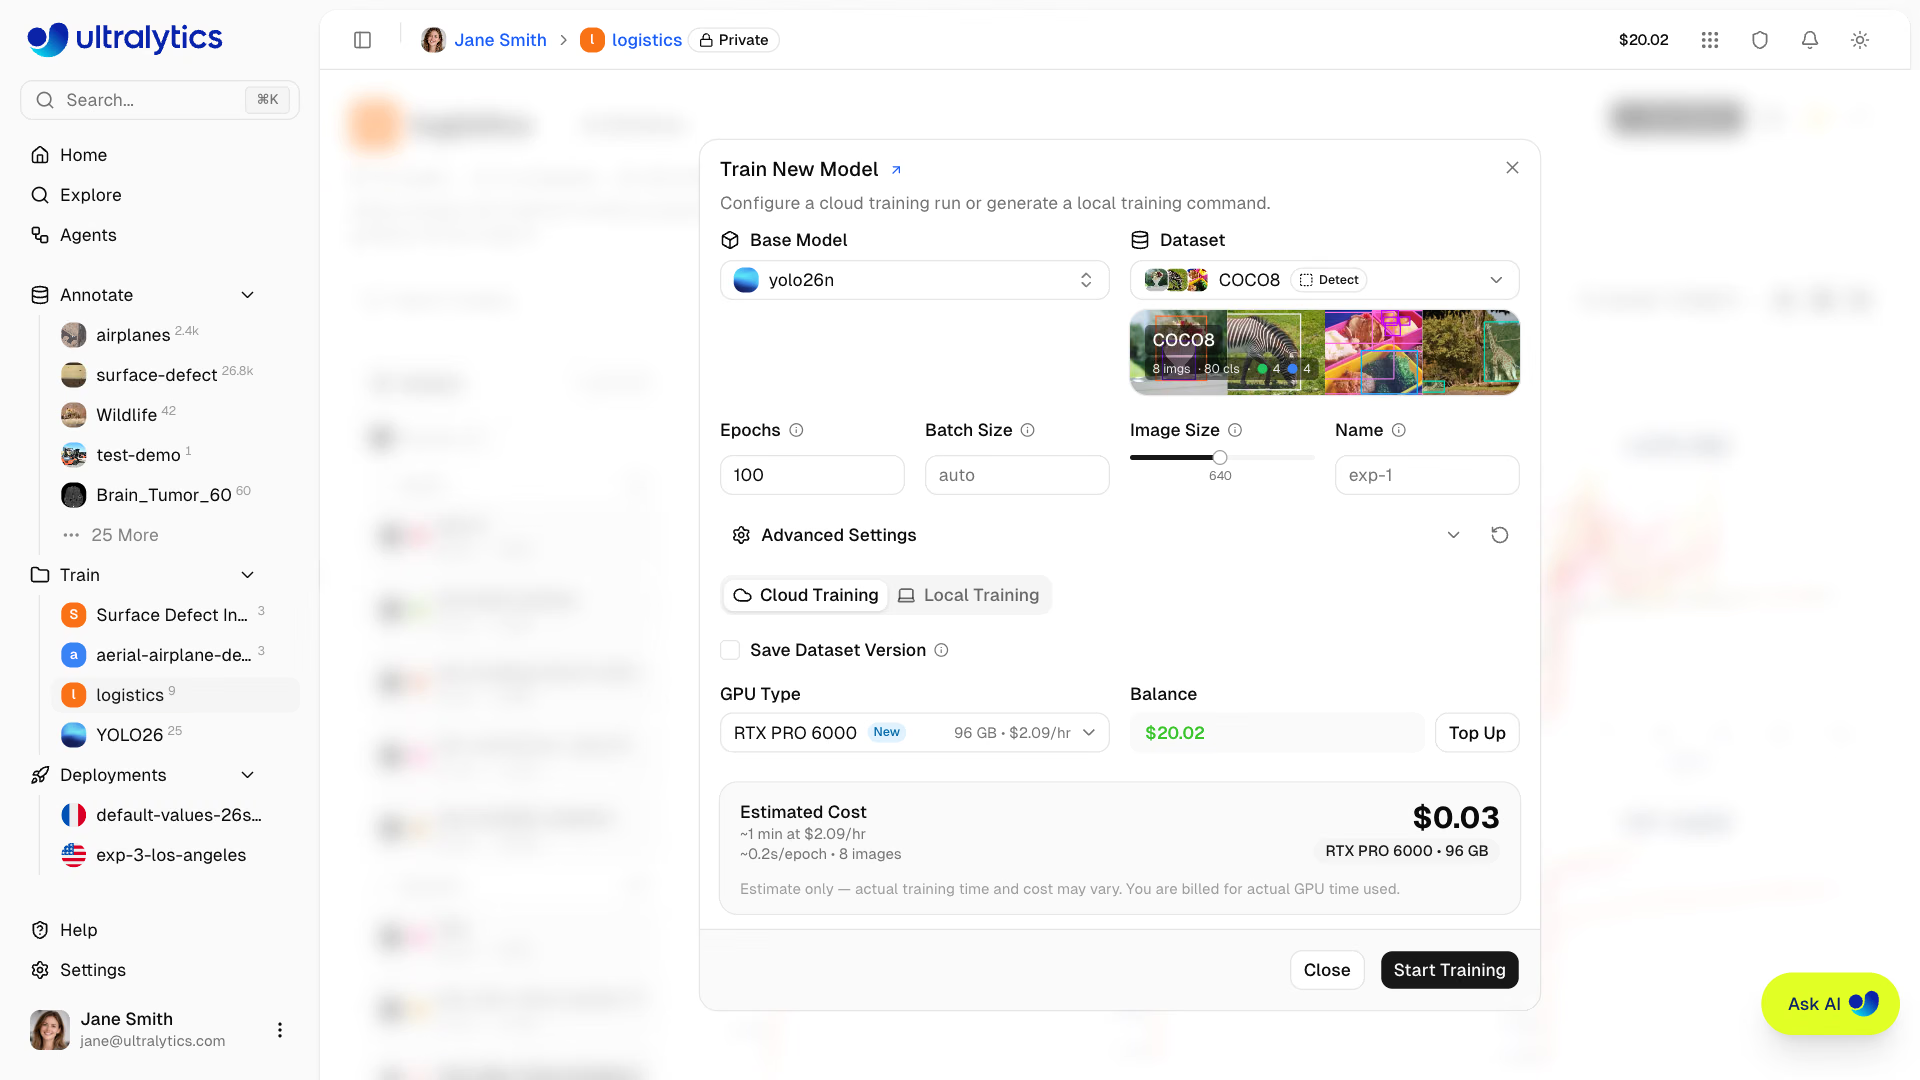
La finestra di dialogo Train New Model di Ultralytics Platform richiede le stesse scelte del codice qui sotto — modello di base, dataset, epoche, dimensione delle immagini — ed esegue l'addestramento su GPU cloud oppure genera il comando locale corrispondente. Con queste impostazioni, l'addestramento richiede circa un minuto su una CPU di laptop:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # preaddestrato su COCO
results = model.train(data="my_dataset/data.yaml", epochs=10, imgsz=320, name="pills_v1")
print(results.save_dir)
CLI e Python sono equivalenti. epochs=10 e imgsz=320 mantengono brevi le esecuzioni su CPU; con una GPU, rimuovili entrambi e accetta i valori predefiniti (epochs=100, imgsz=640), perché più epoche e pixel sono quasi sempre vantaggiosi. La modalità Train esegue questo ciclo al posto tuo:
Leggi il log riga per riga#
Output reale, ridotto alle prime e alle ultime due epoche:
optimizer: AdamW(lr=0.002, momentum=0.9) with parameter groups ...
Using 92 train, 23 val images for fraction=1.0 at imgsz=320
      Epoch    GPU_mem   box_loss   cls_loss    l1_loss  Instances       Size
       1/10         0G      1.818      3.899   0.008805        206        320: 100% 6/6 3.3s
                   all         23        399      0.957      0.805      0.927      0.548
       2/10         0G      1.434      3.291   0.006285        208        320: 100% 6/6 4.4s
                   all         23        399      0.953      0.911      0.964      0.592
       ...
       9/10         0G      1.121      1.103   0.005143        194        320: 100% 6/6 5.0s
                   all         23        399      0.949      0.957      0.975      0.656
      10/10         0G      1.174      1.125   0.005068        212        320: 100% 6/6 5.1s
                   all         23        399       0.97      0.957      0.977      0.659
10 epochs completed in 0.015 hours.
optimizer: AdamW(lr=0.002 ...): il valore predefinitooptimizer=autoha scelto l'ottimizzatore e il tasso di apprendimento per te.Using 92 train, 23 val images: verifica che questi valori corrispondano al tuo dataset. Un numero inferiore indica immagini ignorate.GPU_mem 0G: addestramento sulla CPU. Su una GPU qui vedresti la memoria in uso;0Gsu una macchina con GPU significa che non viene utilizzata.- Prima riga di ogni epoca: le tre perdite per il sottoinsieme di addestramento, il numero di oggetti etichettati nell'ultimo batch (
Instances) e la dimensione delle immagini. - Riga
alldi ogni epoca: precisione, richiamo, mAP50 e mAP50-95 sul sottoinsieme di validazione. È la riga da tenere d'occhio.
| Colonna | Significato | Andamento regolare |
|---|---|---|
box_loss | Distanza tra le bounding box predette e quelle etichettate | Diminuisce, poi si appiattisce |
cls_loss | Quanto sono errati i punteggi delle classi | Diminuisce, poi si appiattisce |
l1_loss | Errore diretto di YOLO26 sulle coordinate delle bounding box | Diminuisce |
P, R | Precisione e richiamo sul sottoinsieme di validazione | Aumentano e restano bilanciati |
mAP50, mAP50-95 | Qualità del rilevamento; la mAP50-95 premia anche le bounding box precise | Aumenta, poi raggiunge un plateau |
In questo caso, la mAP50-95 è passata dal valore iniziale di 0.0002 a 0.548 dopo un'epoca e a 0.659 dopo dieci. La precisione è scesa a 0.80 all'epoca 4, per poi recuperare: le singole epoche sono soggette a oscillazioni con 23 immagini di validazione, quindi valuta l'andamento, non una singola riga. Regole pratiche da seguire mentre l'esecuzione è in corso:
- Le perdite diminuiscono e la mAP aumenta: lascia proseguire l'esecuzione.
- Le perdite sono piatte fin dall'epoca 1: interrompi con Ctrl+C e controlla le etichette e il YAML.
- Precisione molto superiore al richiamo: il modello è prudente e non rileva alcuni oggetti. Richiamo molto superiore alla precisione: rileva oggetti che non ci sono.
- La mAP resta piatta per molte epoche: aggiungerne altre non aiuterà; modifica i dati o
imgsz.
Le tre perdite sono le componenti della funzione di perdita di YOLO26; la guida alle metriche di prestazione spiega ogni metrica in dettaglio.
Individua i file generati dall'esecuzione#
Tutto viene salvato in runs/detect/pills_v1/:
| File | A cosa serve |
|---|---|
weights/best.pt | Checkpoint con la migliore fitness di validazione tra le epoche; usalo per l'inferenza e l'esportazione |
weights/last.pt | Checkpoint più recente; usato per riprendere un'esecuzione interrotta |
args.yaml | Tutti gli argomenti utilizzati dall'esecuzione, per riprodurla |
results.csv, results.png | Perdite e metriche per epoca, disponibili come dati e grafici |
labels.jpg | Conteggi delle classi e istogrammi di dimensione e posizione delle bounding box |
train_batch*.jpg | Batch di addestramento aumentati con le etichette sovrapposte |
val_batch*_labels.jpg, val_batch*_pred.jpg | Verità di riferimento e predizioni sulle immagini di validazione |
confusion_matrix*.png, Box*_curve.png | Matrice di confusione e curve di precisione, richiamo, F1 e PR |
Apri train_batch0.jpg prima di fare qualsiasi altra cosa. Se le bounding box non sono posizionate sugli oggetti, le etichette sono sbagliate e nessun numero di epoche potrà correggerle.
Modifica prima questi argomenti#
| Argomento | Predefinita | Modificalo quando |
|---|---|---|
epochs | 100 | Esperimenti brevi su CPU o dataset minuscoli che iniziano a sovradattarsi (valore più basso); dataset grandi che continuano a migliorare (valore più alto, 200–300) |
imgsz | 640 | Oggetti piccoli (aumenta a 1024 o 1280) o esperimenti su CPU (diminuisci) |
batch | 16 | Dimensione del batch: riducila in caso di errori di memoria esaurita oppure usa -1 per adattarla automaticamente a circa il 60% della memoria GPU |
patience | 100 | Interrompi l'addestramento in anticipo se la fitness di validazione non migliora per N epoche, ad esempio patience=20 |
device | auto | Imponi cpu, mps, un indice GPU come 0 o più indici come [0, 1] |
name | train | Sempre: assegna alle esecuzioni un nome che descriva cosa è cambiato |
model.train(data="my_dataset/data.yaml", epochs=200, imgsz=1024, batch=-1, patience=20, name="pills_v1_1024")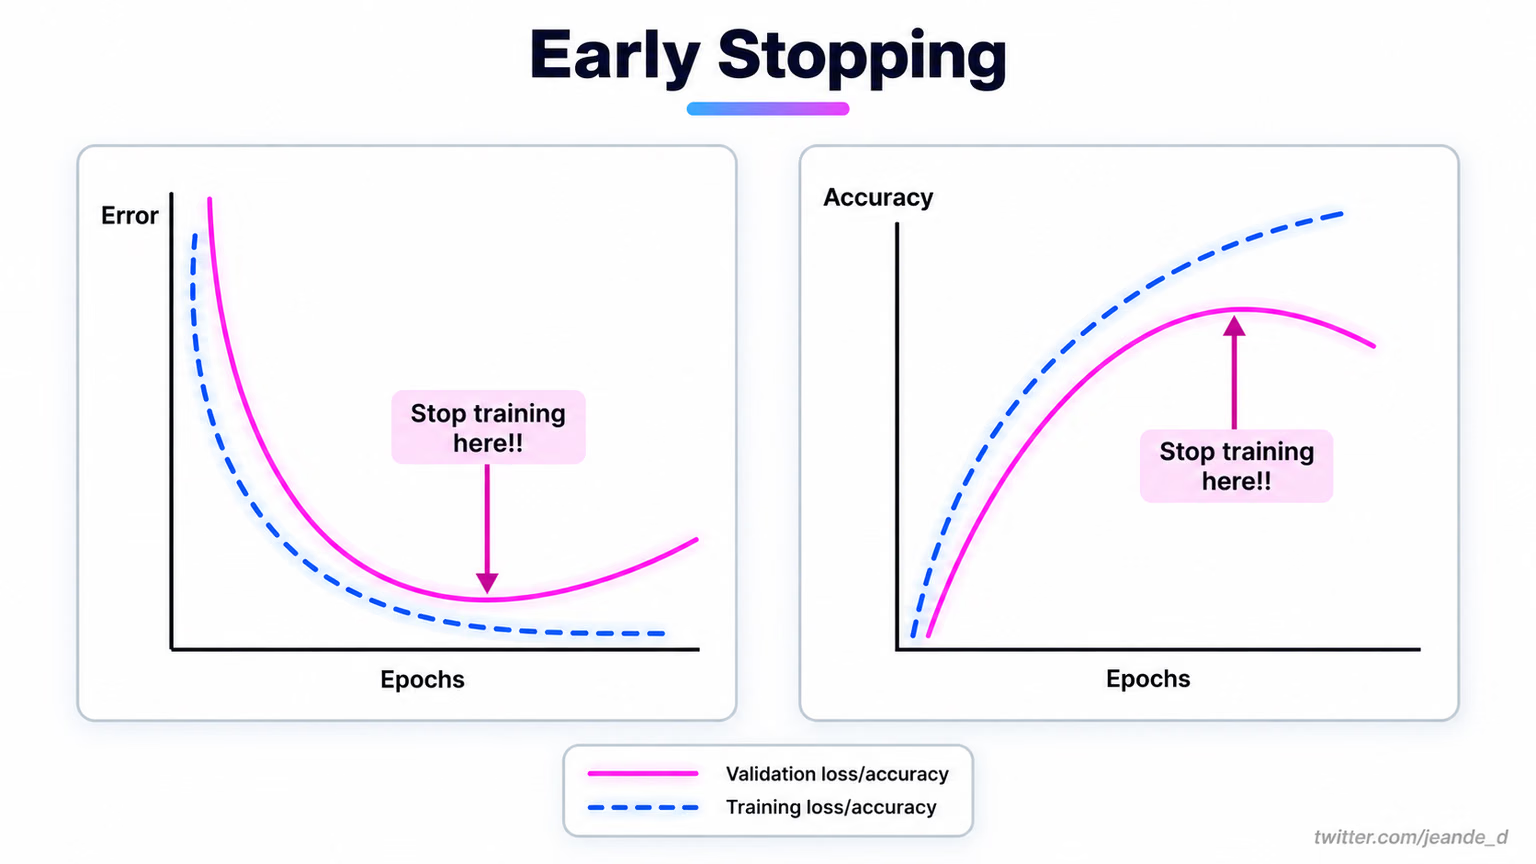
Il valore predefinito patience di 100 significa che un'esecuzione di 100 epoche non si interrompe mai in anticipo. Un valore più basso termina un'esecuzione bloccata quando le curve qui sopra indicano che è il momento; best.pt viene mantenuto in ogni caso.
Con più GPU, passa un elenco come device=[0, 1, 2, 3]: Ultralytics avvia per te l'addestramento distribuito con parallelismo dei dati (DDP), batch è il totale su tutte le GPU e l'addestramento usa la precisione mista per impostazione predefinita (amp=True). Quando l'esecuzione supera le capacità del tuo laptop, puoi usare lo stesso dataset e gli stessi argomenti su GPU cloud tramite Ultralytics Platform, come spiegato in Addestrare, leggere e ottimizzare le esecuzioni.
Evita questi errori#
Sintomo: mAP vicino a zero dopo molte epoche su un dataset piccolo. Causa: il modello proveniva da yolo26n.yaml (pesi casuali) anziché da yolo26n.pt. Soluzione: parti sempre da un .pt preaddestrato. L'addestramento da zero conviene solo per la ricerca sui backbone o con dataset molto grandi.
Sintomo: CUDA out of memory alla prima epoca. Soluzione: dimezza batch oppure imposta batch=-1, così AutoBatch sceglie una dimensione adatta alla memoria disponibile. Anche ridurre imgsz può aiutare, ma cambia ciò che il modello riesce a vedere.
last.pt corrisponde all'epoca finale, che potrebbe essere peggiore di una precedente. best.pt è l'epoca con il miglior valore di fitness in validazione ed è quella da convalidare, esportare e distribuire.
La guida ai suggerimenti per l'addestramento dei modelli illustra gli argomenti rimanenti; la guida all'ottimizzazione degli iperparametri tratta le prove sul tasso di apprendimento e l'ottimizzatore genetico. La guida al fine-tuning spiega come congelare i layer.
Mostra la soluzione
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
results = model.train(data="my_dataset/data.yaml", epochs=10, imgsz=320, name="pills_v1")
print(results.save_dir)  # runs/detect/pills_v1
Baseline (yolo26n.pt, no pill class): mAP50 0.001, mAP50-95 0.0002
pills_v1 (10 epochs, imgsz 320, CPU, ~1 min): mAP50 0.977, mAP50-95 0.659
Plateau: mAP50-95 gains shrink after epoch 8 (0.649 -> 0.656 -> 0.659)
train_batch0.jpg: yes, boxes sit on the pillsI valori esatti variano leggermente in base all'hardware e alla versione del pacchetto.