Convalida e diagnostica
Convalida best.pt rispetto a un valore di riferimento, leggi la matrice di confusione, i valori per classe e le immagini con le predizioni, quindi trasformali in un elenco di correzioni specifiche.
Un singolo valore di mAP ti dice quanto sbaglia il modello, ma non che cosa sbaglia. Gli oggetti piccoli non rilevati, le classi confuse tra loro e le bounding box imprecise riducono tutti la mAP, ma richiedono correzioni diverse. Se individui la causa sbagliata, passerai una settimana a raccogliere i dati sbagliati.
In questa lezione eseguirai la modalità Val su best.pt, la confronterai con il valore di riferimento e leggerai la matrice di confusione e le immagini con le predizioni finché non saprai scrivere un elenco di correzioni per la fase successiva. La guida alle metriche di prestazione è il complemento approfondito.
Pratico
Esempio pratico: convalidare best.pt#
from ultralytics import YOLO

model = YOLO("runs/detect/pills_v1/weights/best.pt")
metrics = model.val(data="my_dataset/data.yaml")

print(f"precision {metrics.box.mp:.3f}  recall {metrics.box.mr:.3f}")
print(f"mAP50 {metrics.box.map50:.3f}  mAP50-95 {metrics.box.map:.3f}")
Output reale da val.py:
precision 0.970  recall 0.957
mAP50 0.977  mAP50-95 0.659
I grafici vengono salvati in una nuova cartella runs/detect/val (poi val-2 e così via). Affianca i valori a quelli di riferimento:
| Modello | mAP50 | mAP50-95 |
|---|---|---|
yolo26n.pt preaddestrato (nessuna classe pillola) | 0.001 | 0.0002 |
pills_v1 (10 epoche, imgsz 320, CPU) | 0.977 | 0.659 |
Cosa dicono i numeri:
- Precisione 0.970, richiamo 0.957: valori bilanciati. Pochi falsi allarmi e pochi rilevamenti mancati.
- mAP50 0.977: con un requisito di sovrapposizione poco severo, il modello trova quasi tutte le pillole.
- mAP50-95 0.659: con una sovrapposizione rigorosa, molti riquadri non sono precisi. Una differenza così ampia indica un problema di localizzazione — più epoche, un
imgszpiù grande o annotazioni più precise — piuttosto che dati mancanti.
Per capire il compromesso tra precisione, richiamo e mAP, consulta Interpretare correttamente le metriche di rilevamento.
Scopri quale file risponde a ogni domanda#
| Domanda | File |
|---|---|
| Quali classi vengono confuse e quali non vengono rilevate? | confusion_matrix_normalized.png |
| Come si comporta ciascuna classe nel compromesso tra precisione e richiamo? | BoxPR_curve.png |
| Quale soglia di confidenza usare in produzione? | BoxF1_curve.png: il suo picco è un buon punto di partenza per conf |
| Che aspetto hanno gli errori? | val_batch0_labels.jpg rispetto a val_batch0_pred.jpg |
| Il modello sta andando in overfitting? | results.png nella cartella di training |
Leggi la matrice di confusione#
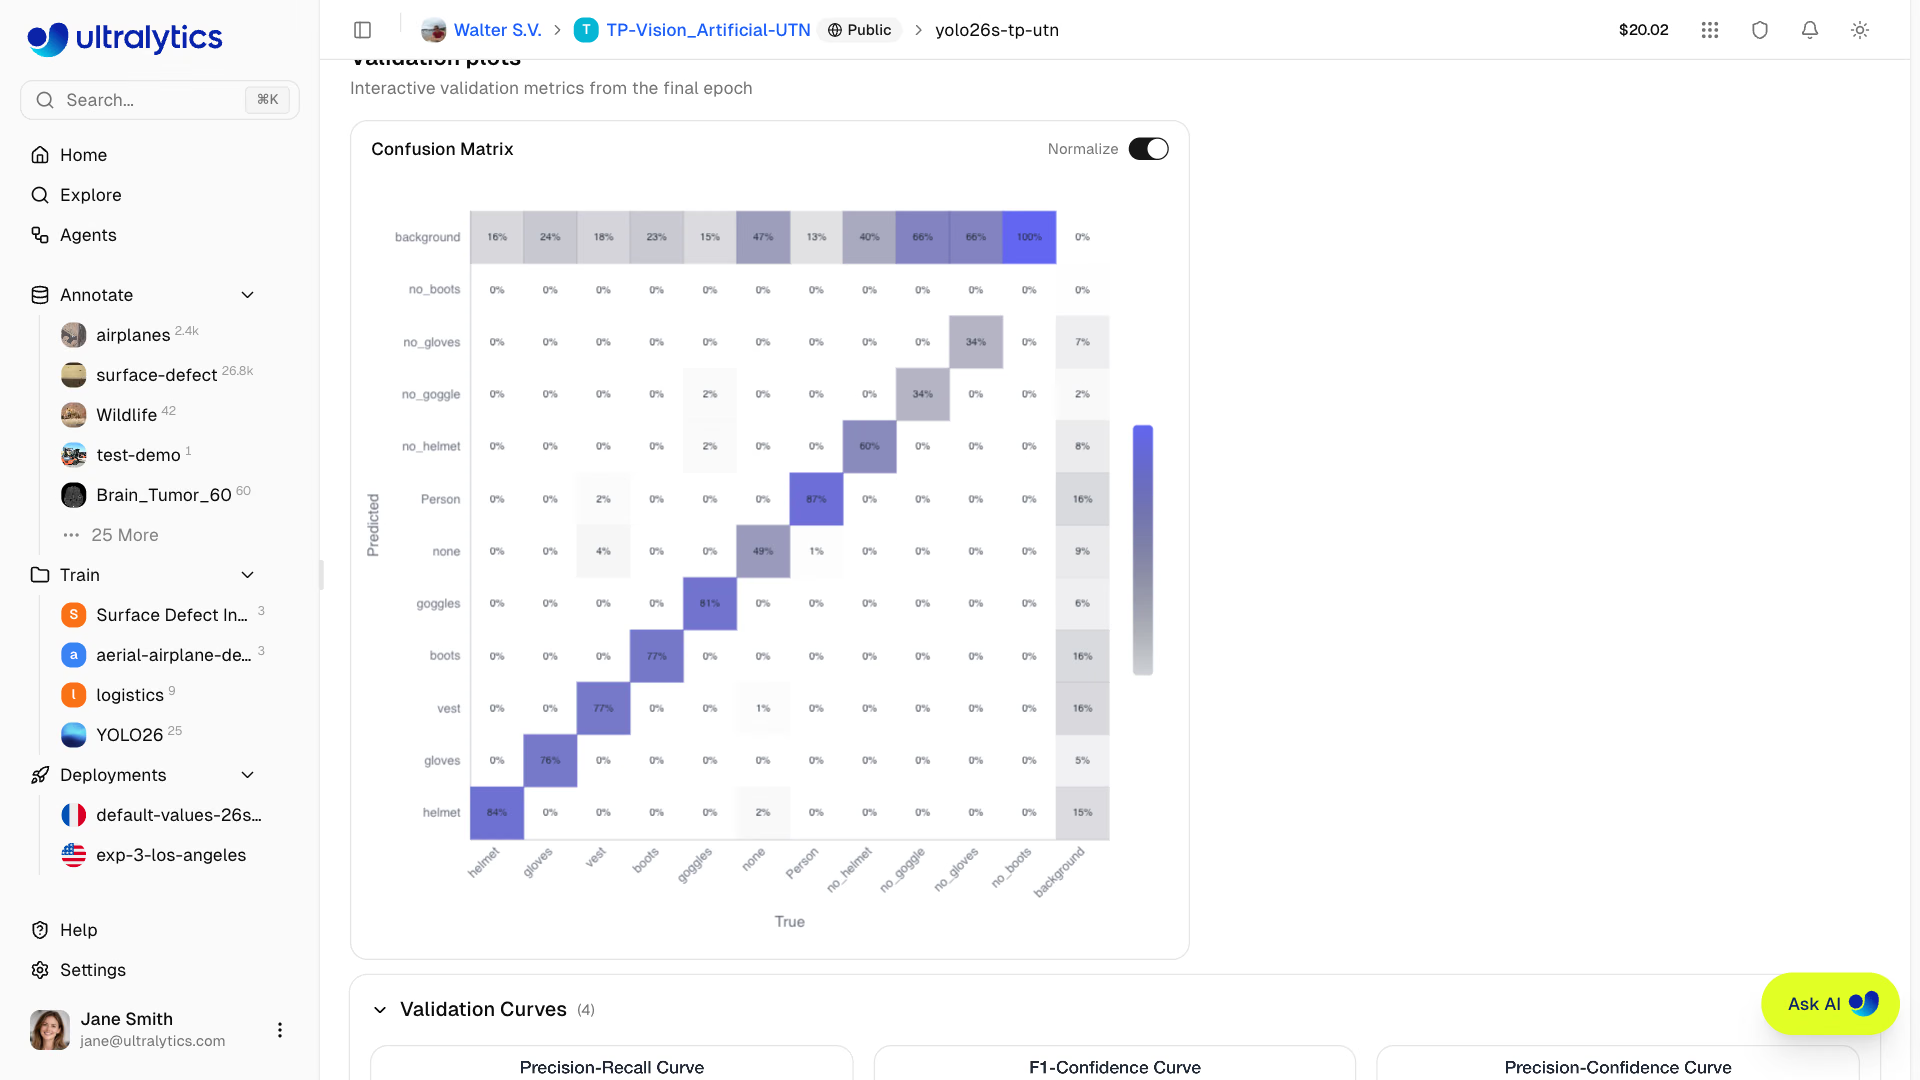
La matrice di confusione è lo strumento diagnostico più utile. Nei grafici Ultralytics, le colonne rappresentano la classe reale e le righe la classe predetta, con una riga e una colonna aggiuntive background. La versione normalizzata divide ogni colonna per il suo totale, così ogni colonna mostra dove sono finiti gli oggetti di quella classe. Il dataset Pills ha una sola classe, quindi esercitati con questo esempio illustrativo a tre classi ambientato in un magazzino:
| Predette ↓ / Reali → | carrello elevatore | persona | pallet | sfondo |
|---|---|---|---|---|
| carrello elevatore | 0.78 | 0.03 | 0.18 | 0.45 |
| persona | 0.04 | 0.91 | 0.00 | 0.20 |
| pallet | 0.10 | 0.00 | 0.65 | 0.35 |
| sfondo | 0.08 | 0.06 | 0.17 | — |
- Diagonale: quota di ciascuna classe rilevata correttamente. Il pallet, con 0.65, è la classe con i risultati peggiori.
- Fuori diagonale: confusioni. Il 18% dei pallet reali è stato predetto come carrello elevatore e il 10% dei carrelli elevatori come pallet.
- Riga dello sfondo: oggetti mancati. Il 17% dei pallet non è stato rilevato affatto.
- Colonna dello sfondo: falsi positivi, ovvero riquadri disegnati su aree vuote. Di questi, il 45% è stato classificato come carrello elevatore.
A ogni tipo di cella corrisponde una possibile correzione:
| Situazione | Soluzione |
|---|---|
| Due classi si confondono a vicenda | Aggiungi esempi che le distinguano: carrelli elevatori che trasportano pallet e pallet impilati accanto ai carrelli elevatori |
| Riga dello sfondo alta (rilevamenti mancati) | Più esempi di quella classe, nelle condizioni in cui non viene rilevata |
| Colonna dello sfondo alta (falsi allarmi) | Immagini di sfondo delle scene che li provocano, come corsie vuote |
Leggi i valori per classe#
Con diverse classi, il log di validazione stampa una riga per classe e metrics.box.maps contiene i valori di mAP50-95 per classe da usare nel codice. Continuiamo con l'esempio del magazzino:
                 Class     Images  Instances      Box(P          R      mAP50  mAP50-95)
                   all         50        102       0.78       0.71       0.74       0.51
              forklift         30         45       0.85       0.78       0.81       0.58
                person         40         50       0.92       0.88       0.91       0.64
                pallet          5          7       0.58       0.48       0.51       0.31
pallet è molto inferiore agli altri e ha solo 7 istanze nel set di validazione. Il modello potrebbe avere difficoltà con i pallet oppure i dati di validazione potrebbero essere insufficienti per stabilirlo. In entrambi i casi, il passo successivo è lo stesso: raccogliere altri pallet per il training e la validazione.
Esamina gli errori#
Apri val_batch0_labels.jpg e val_batch0_pred.jpg affiancati. Le differenze mostrano gli errori sotto forma di immagini; i loro schemi ricorrenti permettono di individuarne la causa: rilevamenti mancati ai bordi dell'immagine, oggetti piccoli, una specifica condizione di illuminazione o un oggetto dall'aspetto simile che crea confusione. Questi schemi nei dati superano quasi sempre l'ottimizzazione degli iperparametri.
Nelle immagini di validazione del modello per le pillole, quelle chiaramente visibili ottengono punteggi vicini a 1.0. I riquadri con bassa confidenza, intorno a 0.3–0.5, si concentrano sulle pillole parzialmente nascoste sotto un altro blister e su quelle tagliate dal bordo dell'immagine. Non è un problema da risolvere modificando conf: è una questione di criteri di annotazione. Una pillola coperta a metà deve essere conteggiata? Decidi, scrivi la regola e annota tutte le immagini in modo uniforme.
Poi apri results.png. Le perdite di training e validazione dovrebbero diminuire insieme. Se la perdita di training continua a diminuire mentre quella di validazione aumenta, il modello è in overfitting; se entrambe restano alte, è in underfitting. Il compromesso bias-varianza aiuta a interpretare entrambi i casi.
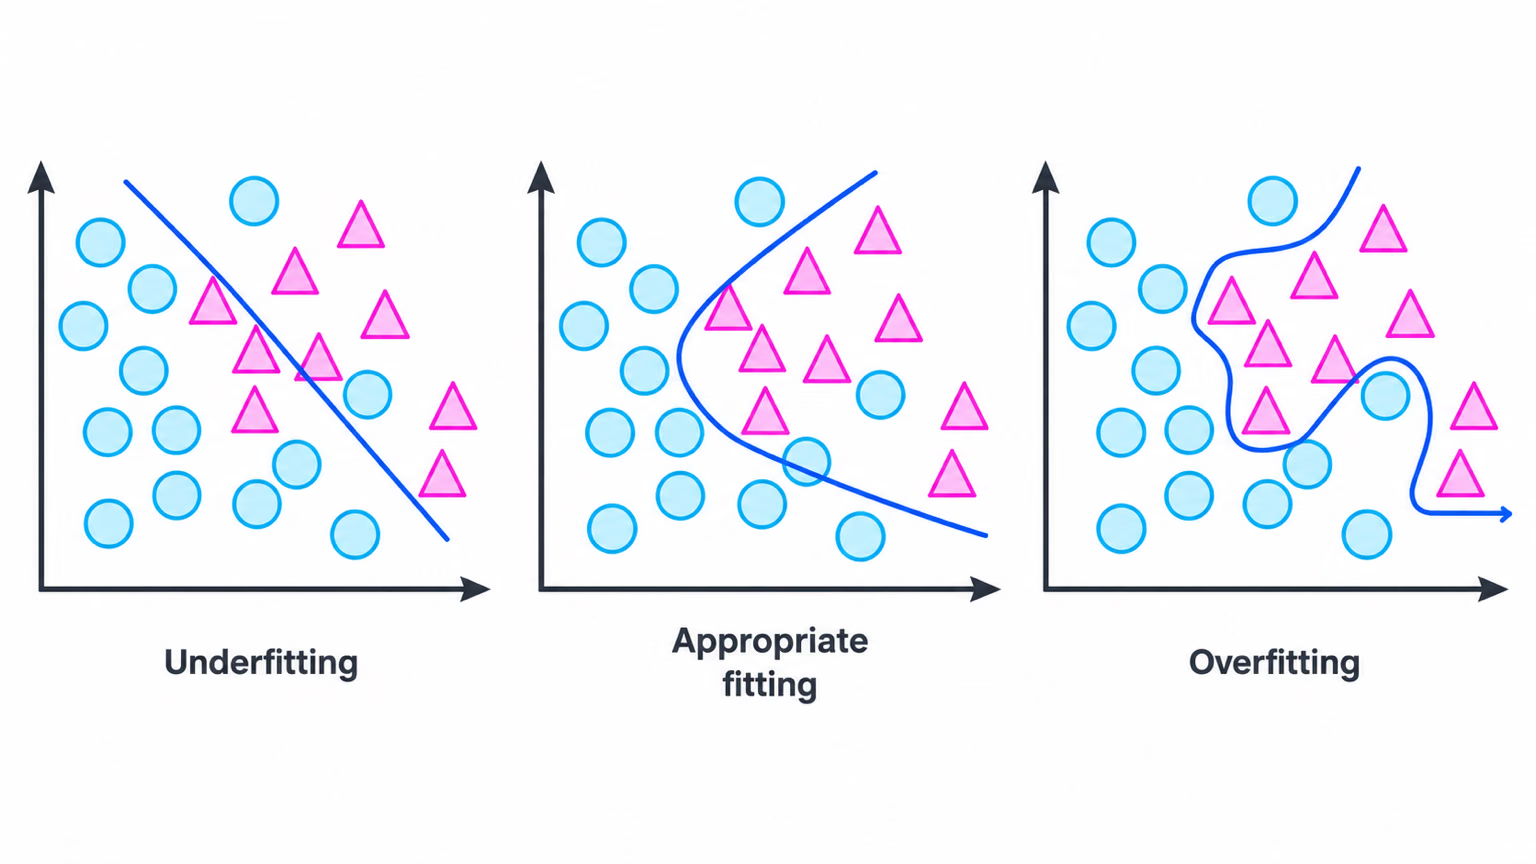
Per correggere l'overfitting, prova queste soluzioni nell'ordine in cui funzionano più spesso: dati più vari; meno epoche o un patience più contenuto; e aumento dei dati (hsv_h, degrees, translate, scale, fliplr, mosaic, ...). Le impostazioni predefinite per l'aumento dei dati sono già efficaci: modificale solo per un motivo preciso, ad esempio disattivando fliplr quando la distinzione tra sinistra e destra è importante.
Trasforma i risultati in un elenco di correzioni#
Correggi i dati prima di ottimizzare gli iperparametri e modifica una sola cosa per iterazione, così saprai cosa ha funzionato. La parte del ciclo dedicata al dataset è descritta in Primo fine-tuning e ciclo di iterazione.
Evita questi errori#
Sintomo: un modello che aveva ottenuto 0.659 mAP50-95 ottiene improvvisamente 0.403. Causa: pills_v1 è stato addestrato con imgsz=320 e convalidato con imgsz=640; gli oggetti appaiono grandi il doppio rispetto a quelli su cui è stato addestrato. Soluzione: convalida e distribuisci usando imgsz, la dimensione di addestramento, e confronta le esecuzioni solo a parità di dimensione.
La validazione viene eseguita con conf=0.001 per poter tracciare l'intera curva precision-recall: ecco perché val_batch0_pred.jpg mostra riquadri che la tua app non segnalerebbe mai. Scegli la soglia di produzione da BoxF1_curve.png, poi verificala con predict.
Con 23 immagini, la precisione di un'epoca è passata da 0.93 a 0.80 e poi è risalita. Valuta le tendenze su più epoche ed esecuzioni e amplia il set di validazione prima di fidarti di differenze di uno o due punti.
Mostra la soluzione
Baseline mAP50-95 0.0002 -> pills_v1 0.659 (mAP50 0.977), both at imgsz=320

Failures:
- Low-confidence boxes (about 0.3-0.5) on pills half-hidden under another pack.
- Low-confidence or missing boxes on pills cut off at the image edge.

Overfitting: none. val/box_loss flattened near 1.05; val/cls_loss spiked at epochs 4-6
and then fell to its lowest value (1.08) at epoch 10.

Fix list:
1. Write a labeling rule for partly hidden and edge pills, then relabel the val set to match.
2. Train longer and larger: epochs=50, imgsz=640 (mAP50-95 lags mAP50, so box tightness is the gap).
3. Add 20 frames with overlapping packs, labeled under the new rule.