Interpretare correttamente le metriche di rilevamento
Esegui la validazione, leggi insieme precisione, recall, mAP50-95, AP per classe e matrice di confusione, quindi scegli una soglia di deployment a partire da un obiettivo.
Un singolo numero è rassicurante: mAP 0.83, fatto. Ma lo stesso mAP può nascondere una classe che fallisce metà delle volte, riquadri sistematicamente imprecisi o una soglia che invia un avviso ogni minuto. Eseguirai una validazione reale e la leggerai riga per riga, finché non ti dirà cosa correggere e dove impostare la soglia.
Pratico
Come viene valutata ogni previsione#
Durante la validazione, ogni riquadro previsto viene confrontato con la ground truth. Una previsione è un vero positivo (TP) quando ha la classe corretta e la sua IoU con un riquadro della ground truth non ancora abbinato supera una soglia; altrimenti è un falso positivo (FP). Ogni oggetto della ground truth che rimane senza abbinamento è un falso negativo (FN).
| Metrica | Formula | Domanda a cui risponde |
|---|---|---|
| Precisione | TP / (TP + FP) | Quando il modello disegna un riquadro, con quale frequenza è corretto? |
| Recall | TP / (TP + FN) | Quanti degli oggetti reali ha trovato? |
| F1 | 2 × P × R / (P + R) | Un numero che bilancia entrambi |
Abbassando la soglia di confidenza si aggiungono riquadri: il recall aumenta e la precisione diminuisce. La curva precisione-recall traccia questo compromesso per tutte le soglie, e l'area sottostante è la average precision (AP) per una classe. mAP50 calcola la media dell'AP tra le classi con IoU pari a 0.5, dove viene conteggiato anche un riquadro notevolmente impreciso. mAP50-95 calcola la media su dieci soglie IoU, da 0.5 a 0.95, premiando così i riquadri precisi; è il numero principale nelle tabelle dei modelli Ultralytics.
Esegui una validazione#
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
metrics = model.val(data="coco8.yaml")

print(f"precision={metrics.box.mp:.3f} recall={metrics.box.mr:.3f}")
print(f"mAP50={metrics.box.map50:.3f} mAP50-95={metrics.box.map:.3f}")
Class Images Instances Box(P R mAP50 mAP50-95)
all 4 17 0.551 0.962 0.943 0.669
person 3 10 0.551 0.8 0.848 0.387
dog 1 1 0.36 1 0.995 0.597
horse 1 2 0.36 1 0.995 0.696
elephant 1 2 0.656 0.969 0.828 0.545
umbrella 1 1 0.543 1 0.995 0.895
potted plant 1 1 0.833 1 0.995 0.895Leggila dall'inizio alla fine:
- Instances 17, Images 4. COCO8 è un test rapido. Quattro immagini non bastano per decidere se distribuire il modello: considera ogni numero puramente illustrativo.
- mAP50 0.943 contro mAP50-95 0.669. Viene individuata la maggior parte degli oggetti, ma molti riquadri sono imprecisi. Una differenza ampia indica che il punto debole è la localizzazione, non il rilevamento.
personAP50-95 0.387. La classe più frequente è la più debole. È il tuo collo di bottiglia.- P 0.551, R 0.962. Queste colonne sono calcolate alla singola soglia di confidenza che massimizza F1 tra le classi — qui una soglia bassa — non alla soglia 0.25 con cui fai le previsioni. Non citarle come «la precisione del modello».
AP per classe e soglia di deployment#
La stessa esecuzione contiene l'AP per classe e precisione e recall a ogni soglia di confidenza, quindi puoi scegliere una soglia in base a un obiettivo, anziché tirare a indovinare:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
metrics = model.val(data="coco8.yaml", plots=False, verbose=False)
box = metrics.box

# Per-class AP from the same run: the average hides the weakest class
for i, c in enumerate(box.ap_class_index):
    print(f"{model.names[int(c)]:13} AP50={box.ap50[i]:.3f}  AP50-95={box.ap[i]:.3f}")

# Precision and recall at every confidence threshold for one class
row = list(box.ap_class_index).index(0)  # class 0 = person
for conf in (0.1, 0.25, 0.5, 0.75):
    j = int(conf * (len(box.px) - 1))
    print(f"person @ conf {conf:.2f}: precision {box.p_curve[row, j]:.2f}, recall {box.r_curve[row, j]:.2f}")
all 4 17 0.551 0.962 0.943 0.669
person AP50=0.848 AP50-95=0.387
dog AP50=0.995 AP50-95=0.597
horse AP50=0.995 AP50-95=0.696
elephant AP50=0.828 AP50-95=0.545
umbrella AP50=0.995 AP50-95=0.895
potted plant AP50=0.995 AP50-95=0.895
person @ conf 0.10: precision 0.63, recall 0.80
person @ conf 0.25: precision 1.00, recall 0.54
person @ conf 0.50: precision 1.00, recall 0.40
person @ conf 0.75: precision 1.00, recall 0.14Ora la soglia è una regola decisionale, non una sensazione:
| Obiettivo in base alla tua decisione | Scegli | In questa esecuzione |
|---|---|---|
| Al massimo il 5% degli avvisi può essere falso (precisione ≥ 0.95) | La soglia più bassa che soddisfa il requisito, per mantenere il recall più alto possibile | 0.25: precisione 1.00, recall 0.54 |
| Non perdere più di 1 persona su 5 (recall ≥ 0.80) | La soglia più alta che soddisfa il requisito, per mantenere la precisione più alta possibile | 0.10: precisione 0.63, recall 0.80 |
Qui nessuna delle due è abbastanza buona: un'elevata precisione fa perdere metà delle persone, mentre un recall elevato comporta un terzo degli avvisi falsi. È un motivo per «iterare», non un problema di soglia. La validazione salva anche BoxPR_curve.png, BoxP_curve.png, BoxR_curve.png, BoxF1_curve.png e confusion_matrix.png nella cartella dell'esecuzione, così puoi osservare lo stesso compromesso nei grafici; la guida alle metriche di prestazione li illustra uno per uno.
Cosa correggere dopo#
La matrice di confusione ti dice con cosa viene confusa una classe debole. Se l'AP di forklift è basso e i carrelli elevatori vengono classificati come pallet_jack, si tratta di confusione tra classi, non di localizzazione: aggiungi esempi che mostrino la differenza visiva oppure unisci le classi se nessun codice a valle deve distinguerle. La guida agli approfondimenti sulla valutazione dei modelli illustra il flusso di lavoro.
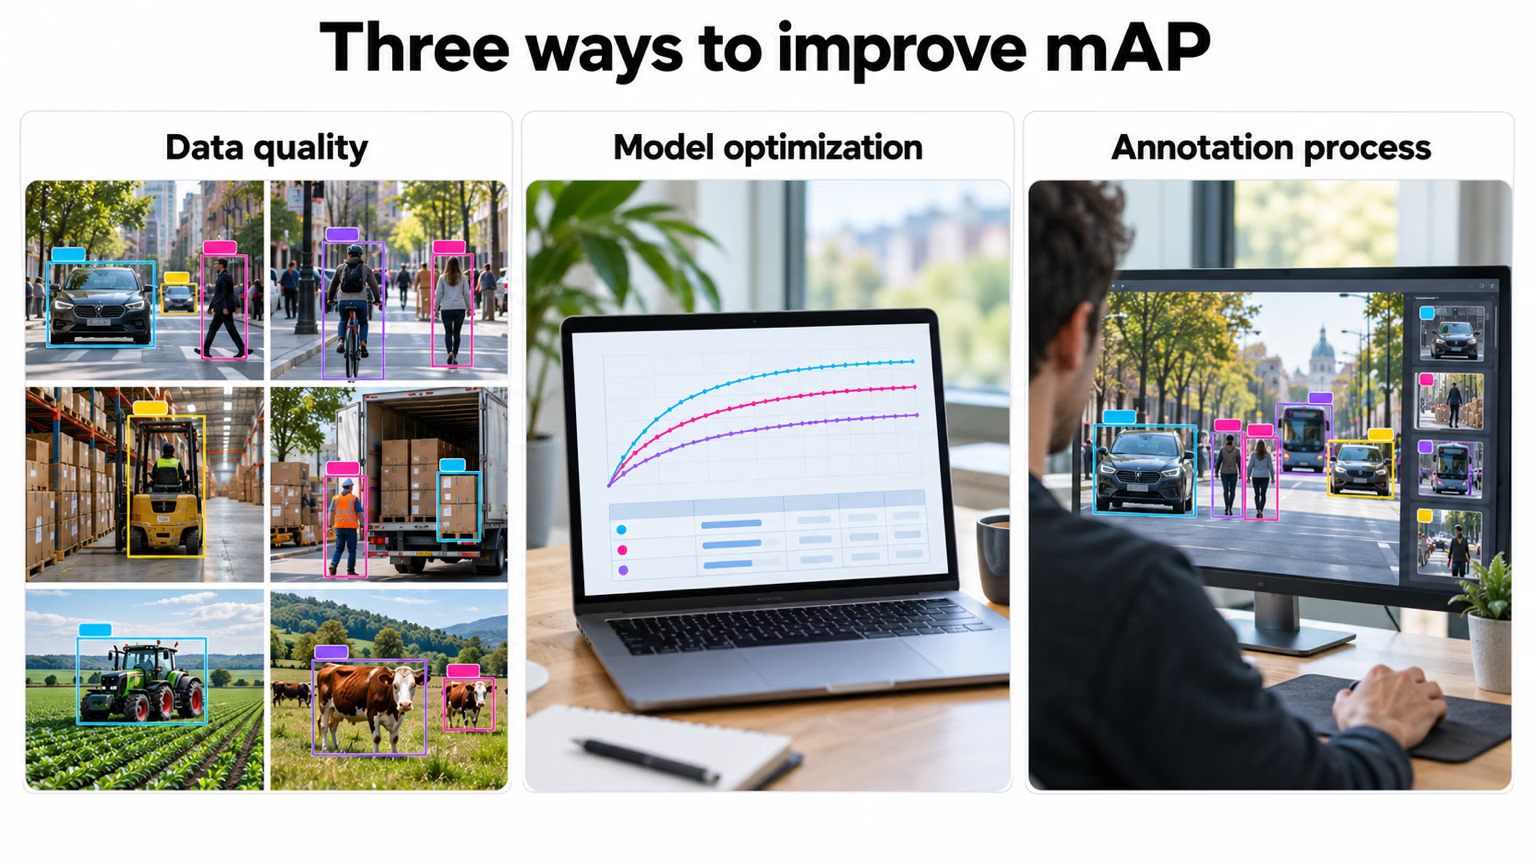
La maggior parte delle correzioni riguarda il primo e il terzo riquadro: dati e annotazioni migliori per la classe critica. Modifica il modello o le impostazioni di training solo dopo aver superato i controlli sui dati delle tre lezioni precedenti.
| Evidenze su un set di test congelato | Decisione |
|---|---|
| Ogni classe critica per l'attività soddisfa i propri obiettivi di precisione e recall | Distribuisci e monitora |
| Una classe o condizione non raggiunge il proprio obiettivo | Itera: raccogli dati e annotazioni mirati per colmare il divario |
| Tutte le classi sono molto lontane dall'obiettivo oppure si sovrappongono visivamente | Ripensa le specifiche dell'attività, le classi o la configurazione delle telecamere |
Insidie#
Un mAP di 0,83 può nascondere una classe a 0,40. Se quella classe è quella che genera valore per l'azienda, non hai un modello da 0,83: hai un modello che non funziona, mascherato da una media lusinghiera.
Sintomo: un modello che "ottiene 0,94" produce riquadri troppo imprecisi per misurazioni o ritagli. Soluzione: riporta mAP50-95 e interpreta la differenza rispetto a mAP50 come indicatore della precisione di localizzazione.
Sintomo: numeri apparentemente perfetti ottenuti su poche decine di immagini o su quasi duplicati del set di addestramento. Soluzione: porta la validazione ad alcune centinaia di istanze per ogni classe importante ed esegui il controllo dei quasi duplicati della lezione precedente prima di esaminare qualsiasi metrica.
Mostra la soluzione
Resoconto: contatore di persone su yolo26n.pt, validazione COCO8
Il collo di bottiglia è person, con AP50-95 pari a 0.387 rispetto al valore complessivo di 0.669. È anche la classe con più istanze (10 su 17), quindi è sia la più debole sia quella più importante per un contatore di persone. Il suo AP50 è 0.848: il modello rileva la maggior parte delle persone, ma disegna box approssimative — un problema meno rilevante per il conteggio che per qualsiasi attività che misuri posizione o dimensioni.
Per una precisione ≥ 0.95, la soglia più bassa che soddisfa il requisito è conf 0.25: la precisione è 1.00, ma il richiamo è solo 0.54, quindi il contatore non rileverebbe quasi la metà delle persone. Per un richiamo ≥ 0.80 servirebbe conf 0.10, con cui un terzo dei conteggi sarebbe costituito da falsi positivi.
Decisione: iterare. Raccogli e annota immagini di persone riprese dalla telecamera di produzione, soprattutto persone piccole, occluse e ai bordi dell'inquadratura; poi ripeti la validazione su un set di test congelato con qualche centinaio di persone. Quattro immagini di validazione non bastano per decidere se rilasciare il modello.