Box e maschere: quando ti serve davvero la segmentazione
Misura il valore aggiunto di una maschera rispetto a una box su un'immagine reale e decidi, in base all'applicazione a valle, se il tuo progetto ha davvero bisogno della forma.
Quando pensano alla visione artificiale, la maggior parte delle persone immagina le maschere, che sono anche ciò per cui i team spendono più risorse di etichettatura. Una maschera indica la forma esatta di un oggetto; una box indica solo dove si trova. Questa differenza determina il successo di alcuni prodotti, ma non cambia nulla per la maggior parte di essi.
Pratico
Cosa aggiunge una maschera#
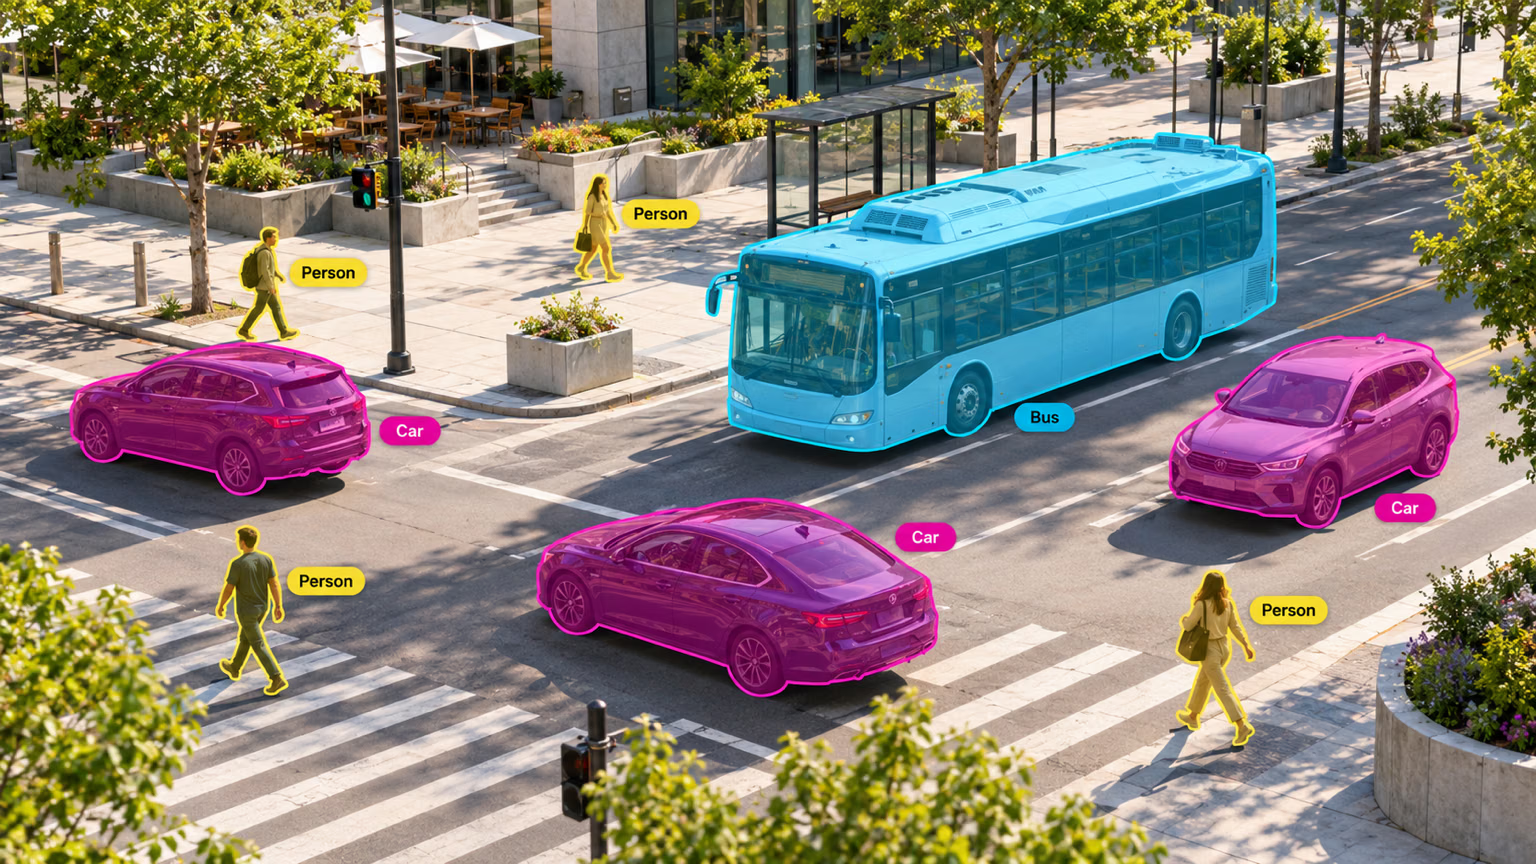
Per ogni oggetto, il task di segmentazione restituisce tutto ciò che restituisce un rilevatore — classe, box, confidenza — più i pixel che appartengono all'oggetto; così ogni auto qui sopra ha il proprio contorno, separato dall'autobus e dalle persone. Leggi la maschera come un poligono (masks.xy) o come un'immagine binaria (masks.data).
Quanto cambia i risultati la forma? Confronta l'area della box di ogni oggetto con l'area della sua maschera:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
result = model("https://ultralytics.com/images/bus.jpg", retina_masks=True, verbose=False)[0]

for box, mask in zip(result.boxes, result.masks.data):
    x1, y1, x2, y2 = box.xyxy[0].tolist()
    box_area = (x2 - x1) * (y2 - y1)
    mask_area = float(mask.sum())  # pixels inside the object's mask
    name, ratio = result.names[int(box.cls)], mask_area / box_area
    print(f"{name:7} box={box_area:7.0f} px  mask={mask_area:7.0f} px  ({ratio:.0%})")
person box= 97116 px mask= 49331 px (51%)
person box= 68102 px mask= 21316 px (31%)
bus box= 410093 px mask= 255265 px (62%)
person box= 55998 px mask= 33524 px (60%)
person box= 23690 px mask= 11109 px (47%)L'autobus occupa solo il 62% della propria box e una persona ne occupa il 31%. Qualsiasi valore calcolato solo dalle box — area dipinta, dimensioni di una fuoriuscita, spazio vuoto su uno scaffale — sarebbe errato di quella percentuale. Se il tuo prodotto riporta un valore di questo tipo, ti servono le maschere. Se invece conta o individua oggetti, i pixel aggiuntivi non cambiano nulla.
Sintomo: aree delle maschere che sembrano 3–4× troppo piccole rispetto alle aree dei riquadri. Causa: per impostazione predefinita, masks.data viene restituito alle dimensioni usate per l'inferenza (qui 640×480), mentre i riquadri sono espressi in pixel dell'immagine originale (1080×810). Soluzione: passa retina_masks=True, come sopra, oppure scala tu i conteggi.
Decidi in base all'applicazione, non alla demo#
| Esigenza a valle | Bastano le box? | Perché |
|---|---|---|
| Contare gli oggetti o verificarne la presenza | Sì | La posizione è l'unica informazione necessaria |
| Inviare un avviso quando un oggetto entra in una zona | Sì | Basta che una box attraversi una linea |
| Tracciare gli oggetti tra i fotogrammi | Sì | I tracker associano le box |
| Ritagliare l'immagine per un secondo classificatore | Sì | Per un ritaglio basta la box |
| Misurare l'area o la copertura (erbacce, ruggine, fuoriuscite) | No | Con forme irregolari, l'area della box non è significativa |
| Ritagliare l'oggetto (rimozione dello sfondo, AR) | No | Serve il bordo esatto |
| Verificare lo spazio libero o il contatto (presa robotica, collisione) | No | La box sovrastima le dimensioni dell'oggetto |
| Separare oggetti irregolari che si toccano | Spesso no | Le box sovrapposte rendono indistinguibile a chi appartengono i pixel |
Se ogni riga relativa alle esigenze del tuo prodotto indica "sì", usa un rilevatore. Scegli la segmentazione YOLO26 solo quando la forma giustifica il costo.
Segmentazione di istanze e segmentazione semantica#
La segmentazione di istanze assegna a ogni oggetto una maschera distinta, così tre auto sovrapposte restano tre auto. La segmentazione semantica assegna una classe a ogni pixel e nient'altro: tutti i pixel delle auto diventano un'unica regione "auto" e il conteggio va perso. Usa la segmentazione di istanze per contare o misurare oggetti individuali — cellule, frutti, difetti. Usa la segmentazione semantica per misurare la copertura di regioni — strada rispetto a marciapiede, coltivazioni rispetto a terreno.
Quanto costa etichettare la forma#
Per una box bastano due clic. Un buon poligono può richiederne decine, e ogni bordo è un possibile motivo di disaccordo tra annotatori: la borsa fa parte della persona? L'ombra fa parte dell'auto? Misura il costo del tuo caso invece di fidarti di una regola empirica: cronometra un annotatore mentre etichetta 20 oggetti come box e gli stessi 20 come poligoni, poi moltiplica la differenza per le dimensioni del tuo dataset.
Gli strumenti basati sull'AI riducono gran parte della differenza. Annotazione intelligente ed etichettatura in batch propone una maschera a partire da un clic o da una box, così gli annotatori correggono i bordi invece di tracciarli da zero; tuttavia, qualcuno deve comunque verificare ogni contorno.
Prima di iniziare l'etichettatura, decidi come gestire occlusioni, oggetti trasparenti, ombre, oggetti tagliati dal bordo del fotogramma e oggetti associati (borse, maniglie, carichi), poi consegna la stessa pagina ad annotatori e revisori. Buone pratiche di annotazione spiega come applicarle; il dataset COCO-Seg mostra maschere coerenti su larga scala.
Quando controlli a campione le maschere, cerca sbavature (la maschera supera il bordo), buchi (regioni interne all'oggetto non rilevate), bordi fantasma (la maschera segue un artefatto JPEG) e parti ambigue (il manico della valigia fa parte della maschera della valigia?).
Mostra la soluzione
Supponiamo che due prodotti condividano la videocamera sull'autobus: un contapersone e un rapporto sull'occupazione stradale che indica quanta parte della scena è occupata dai veicoli. Misura entrambi i risultati usando la stessa esecuzione:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
result = model("https://ultralytics.com/images/bus.jpg", retina_masks=True, verbose=False)[0]
height, width = result.orig_shape

for name in sorted({result.names[int(c)] for c in result.boxes.cls}):
    rows = [i for i, c in enumerate(result.boxes.cls) if result.names[int(c)] == name]
    union = result.masks.data[rows].amax(dim=0)  # merge masks so overlaps count once
    box_union = sum(float((b[2] - b[0]) * (b[3] - b[1])) for b in result.boxes.xyxy[rows])
    print(f"{name:6} {len(rows)} objects | masks cover {float(union.sum()) / (height * width):.0%} of the image, boxes {box_union / (height * width):.0%}")
bus 1 objects | masks cover 29% of the image, boxes 47%
person 4 objects | masks cover 13% of the image, boxes 28%- Contapersone → box. Il conteggio è 4 in entrambi i casi; le maschere aumentano i costi di etichettatura senza cambiare il risultato.
- Rapporto sull'occupazione → maschere. Le box stimano che l'autobus occupi il 47% della scena; in realtà ne occupa il 29%. Un rapporto basato sulle box sbaglierebbe di oltre la metà.