Definisci il problema
Trasforma un’idea di prodotto vaga in una specifica del task di tre righe e mantieni la regola di business nel codice, dove puoi modificarla senza riaddestrare.
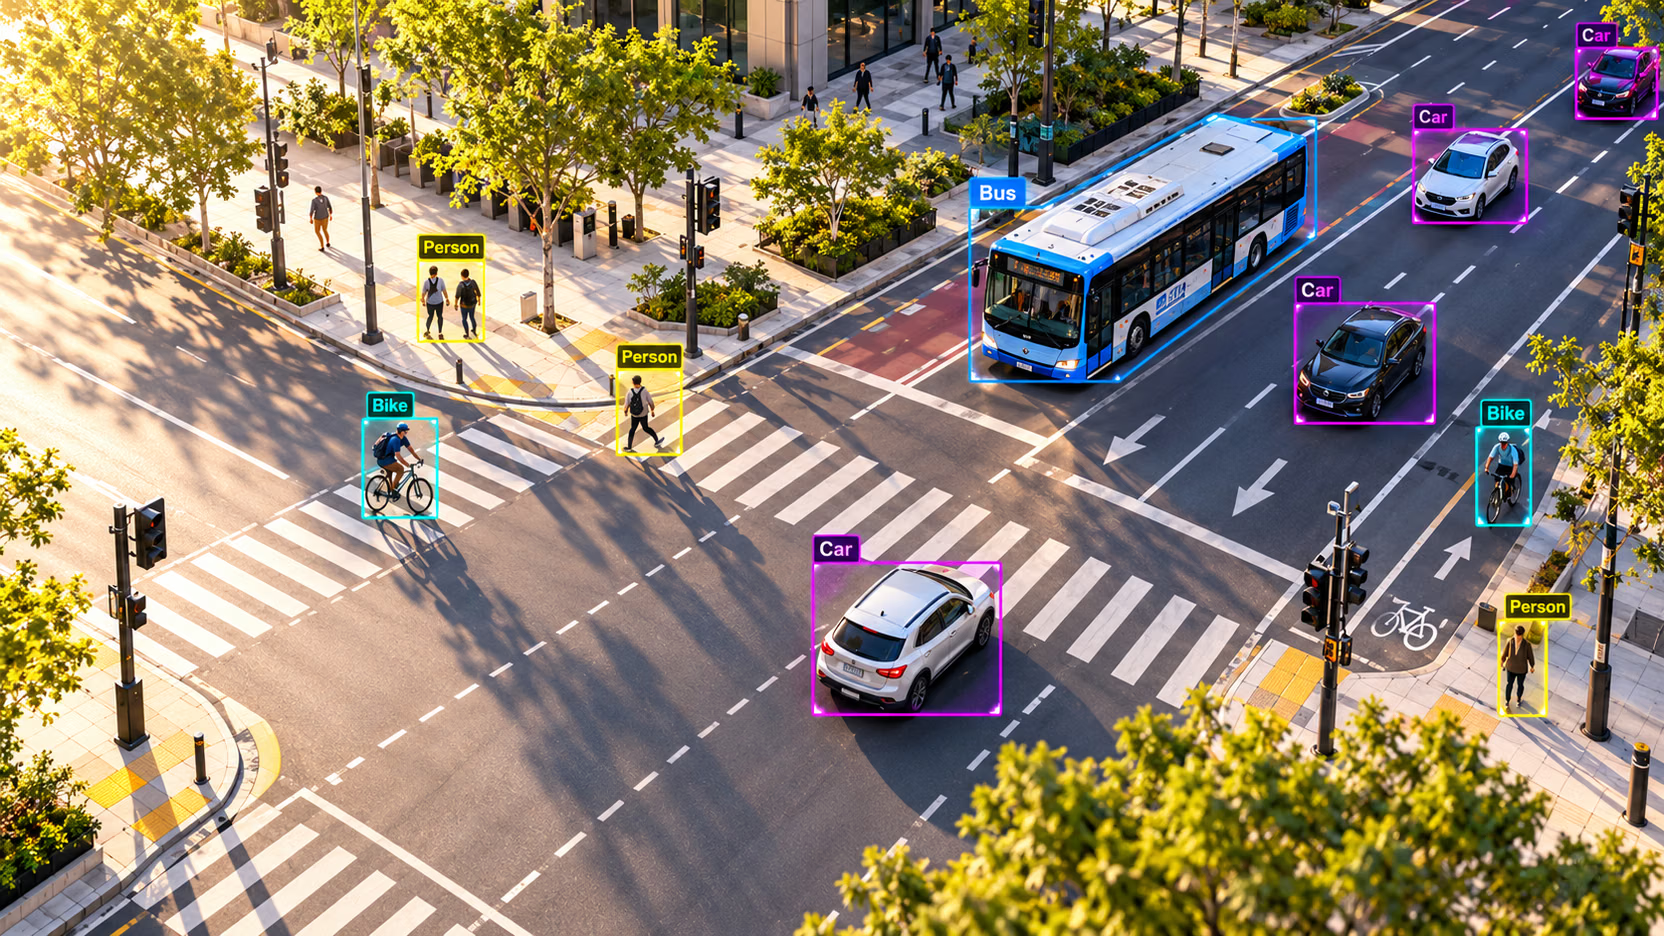
La maggior parte dei progetti di visione artificiale che si arenano non è mai partita da una domanda chiara. "Rilevare comportamenti pericolosi" sembra un requisito, ma chi annota non può assegnargli un’etichetta, un modello non può apprenderlo e nessuno può stabilire quando funziona. Una specifica di tre righe risolve il problema in un pomeriggio e determina quale task addestrare, cosa annotare e quale metrica riportare.
Pratico
Perché la specifica viene prima#
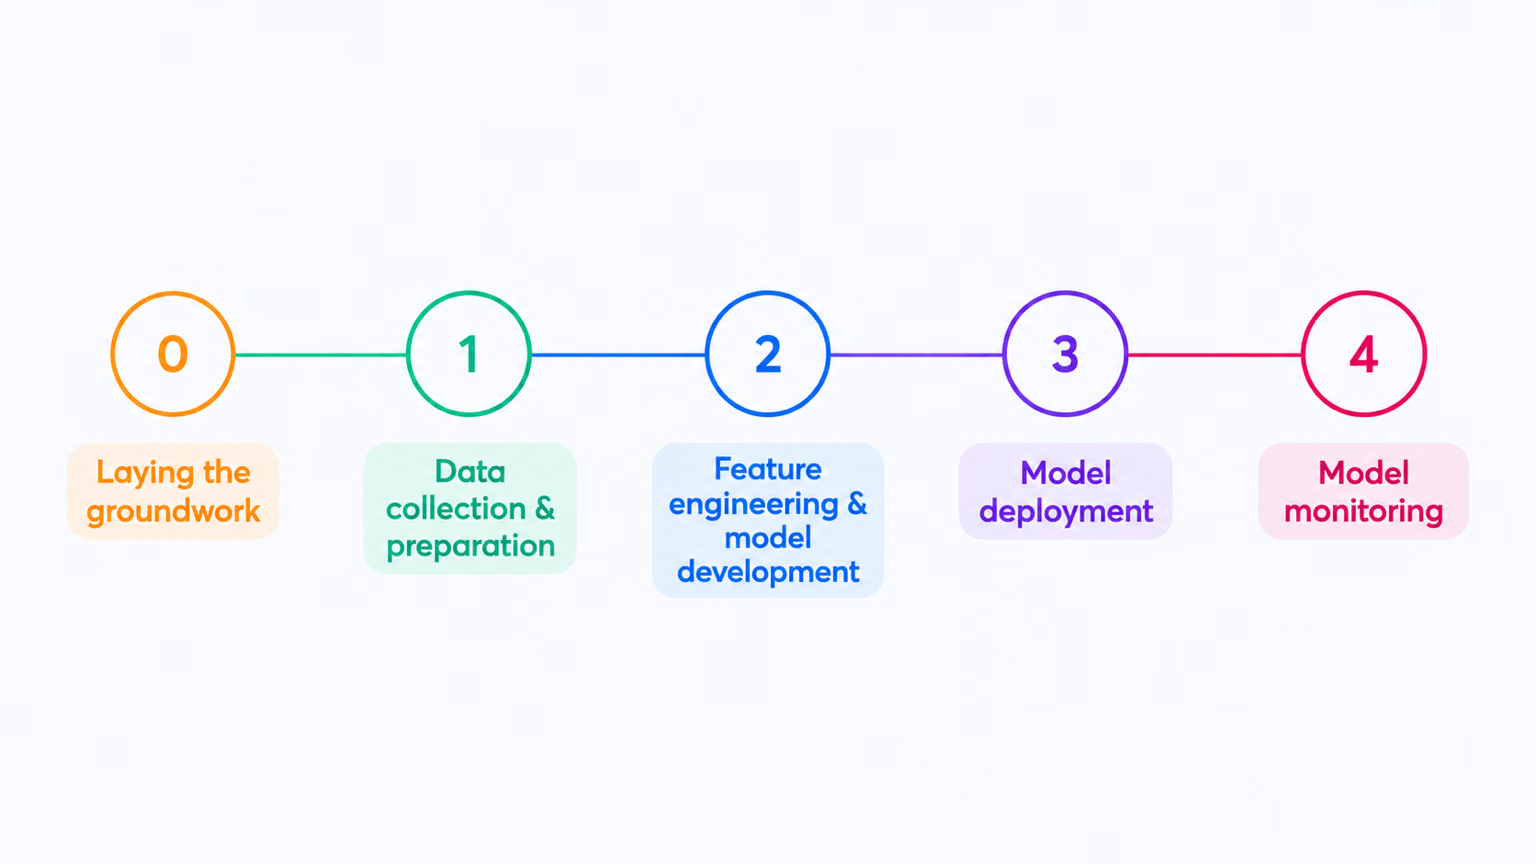
Ogni fase di un progetto di visione artificiale eredita il proprio obiettivo dalla fase 0. Una domanda vaga produce un dataset vago, annotatori in disaccordo e una metrica che misura la cosa sbagliata; nessuna quantità di addestramento nella fase 2 può correggere il problema.
Le tre righe#
Una specifica del task consiste in tre frasi, una per riga. Ognuna risponde a una domanda che si porrà una persona diversa del progetto:
| Riga | Domanda a cui risponde | Debole | Efficace |
|---|---|---|---|
| Input | Cosa vede il modello? | "Filmati della telecamera" | "Fotogrammi 1920×1080 a 5 fps da 12 telecamere a soffitto" |
| Output | Quali dati vengono restituiti? | "Rilevare problemi di sicurezza" | "Riquadri per forklift e person, ciascuno con un punteggio di confidenza" |
| Decisione | Chi interviene e quando? | "Migliorare la sicurezza" | "Avvisare il supervisore del turno quando un carrello elevatore e una persona si trovano entro 2 m l’uno dall’altra per 2 s" |
La riga dell’output richiede più attenzione, perché il tipo di dato determina il task:

Un’etichetta per l’intera immagine indica classificazione; i riquadri indicano rilevamento; i contorni indicano segmentazione; le articolazioni indicano posa; i riquadri ruotati indicano OBB; una classe o una distanza per pixel indica segmentazione semantica o profondità. La prossima lezione illustra tutti e sette i task.
Esempio pratico: separa il modello dalla regola#
"Vogliamo sapere quando i carrelli elevatori fanno qualcosa di pericoloso nel magazzino."
Questa frase descrive un progetto, non un task. Unisce due attività: individuare carrelli elevatori e persone, che riguarda i pixel, e decidere cosa sia pericoloso, che riguarda le regole. Separale:
Solo il rilevatore è il modello. Il rombo è semplice codice. Puoi provare subito questa separazione: bus.jpg non ha carrelli elevatori, ma un autobus e quattro persone permettono di eseguire lo stesso test. Una prima regola dice: "genera un avviso quando più del 30% del riquadro di una persona si sovrappone al riquadro di un veicolo":
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
result = model("https://ultralytics.com/images/bus.jpg", verbose=False)[0]

# The model's job ends here: a class, a box, and a confidence per object.
people = [b.xyxy[0].tolist() for b in result.boxes if result.names[int(b.cls)] == "person"]
vehicles = [b.xyxy[0].tolist() for b in result.boxes if result.names[int(b.cls)] == "bus"]

def share_inside(a, b):
    """Fraction of box a's area that lies inside box b."""
    w = max(0, min(a[2], b[2]) - max(a[0], b[0]))
    h = max(0, min(a[3], b[3]) - max(a[1], b[1]))
    return w * h / ((a[2] - a[0]) * (a[3] - a[1]))

# The decision rule is plain code: change the policy without retraining.
ALERT_SHARE = 0.30
for person in people:
    share = max(share_inside(person, v) for v in vehicles)
    print(f"person at x={person[0]:3.0f}: {share:4.0%} inside the bus box -> {'ALERT' if share > ALERT_SHARE else 'ok'}")
person at x= 49: 70% inside the bus box -> ALERT
person at x=223: 76% inside the bus box -> ALERT
person at x=670: 70% inside the bus box -> ALERT
person at x= 0: 62% inside the bus box -> ALERTQuattro avvisi, tutti falsi: le persone sono sul marciapiede davanti a un autobus parcheggiato. Il rilevatore individua correttamente tutti i riquadri; è la regola a essere sbagliata, perché la sovrapposizione in un’immagine 2D non significa che due oggetti siano vicini nel mondo reale. Poiché la regola è codice, la correzione si fa nel codice. Confronta il punto in cui i piedi di ogni persona toccano il suolo con la linea delle ruote dell’autobus:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
result = model("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
people = [b.xyxy[0].tolist() for b in result.boxes if result.names[int(b.cls)] == "person"]
vehicles = [b.xyxy[0].tolist() for b in result.boxes if result.names[int(b.cls)] == "bus"]

def same_ground_line(person, vehicle, tolerance=40):
    """True when the person's feet are level with the vehicle's wheels and inside its width."""
    feet_x, feet_y = (person[0] + person[2]) / 2, person[3]
    return vehicle[0] < feet_x < vehicle[2] and abs(feet_y - vehicle[3]) < tolerance

for person in people:
    alert = any(same_ground_line(person, v) for v in vehicles)
    print(f"person at x={person[0]:3.0f}: feet y={person[3]:.0f}, bus wheels y={vehicles[0][3]:.0f} -> {'ALERT' if alert else 'ok'}")
person at x= 49: feet y=902, bus wheels y=751 -> ok
person at x=223: feet y=861, bus wheels y=751 -> ok
person at x=670: feet y=880, bus wheels y=751 -> ok
person at x= 0: feet y=871, bus wheels y=751 -> okI piedi di ogni persona si trovano 110–150 pixel sotto la linea delle ruote, quindi le persone sono più vicine alla telecamera rispetto all’autobus. Non serve riaddestrare né riassegnare le etichette: il team responsabile della sicurezza può modificare la regola mentre il rilevatore rimane invariato. Una versione per la produzione trasformerebbe la posizione dei piedi in coordinate del pavimento usando una telecamera calibrata e aggiungerebbe la persistenza di 2 secondi tramite tracciamento degli oggetti: sempre codice applicato agli stessi riquadri.
Le parole soggettive — "non sicuro", "difettoso", "sospetto", "VIP" — appartengono al codice che legge l'output del modello. Un modello risponde a domande sui pixel. Se due esperti discuterebbero su un'etichetta, la discussione va tradotta in una regola che puoi versionare, testare e modificare.
Insidie#
Sintomo: la specifica dice "rilevare problemi di sicurezza" o "comprendere la scena" e chi annota chiede cosa disegnare. Soluzione: riscrivi l'output come tipo di dato con classi denominate: "riquadri per forklift e person."
Sintomo: una classe come suspicious_behavior o dangerous che due annotatori etichettano diversamente nello stesso fotogramma. Soluzione: sostituiscila con elementi visibili — una persona in un'area riservata, una porta tenuta aperta — e sposta il giudizio nella riga decisionale.
Sintomo: "descrivere cosa sta succedendo" (generazione di didascalie) o "prevedere se il carrello elevatore investirà qualcuno" (previsione). Soluzione: prima individua gli oggetti, poi aggiungi il tracciamento e le regole di movimento. Crea il rilevatore prima della previsione.
Dalla specifica ai criteri di successo#
La specifica dice cosa fa il modello, non quanto deve essere efficace né quanto costa un errore rispetto a un falso allarme. Parti dall’obiettivo di business, in Creare dataset YOLO ad alte prestazioni, trasforma la specifica in obiettivi misurabili. Ogni lezione successiva di questo corso rimanda alle tue tre righe.
Mostra la soluzione
Una specifica per la telecamera dello scaffale:
- Input: un’immagine fissa 1920×1080 ogni 60 secondi, acquisita da una telecamera fissa rivolta verso una corsia.
- Output: riquadri di delimitazione per
producteempty_facing(uno spazio vuoto sullo scaffale), ciascuno con un punteggio di confidenza. - Decisione: crea un’attività di rifornimento quando tre o più riquadri
empty_facingsullo stesso scaffale persistono per cinque immagini fisse consecutive durante l’orario di apertura del negozio.
Le parole che il modello non può vedere sono attività di rifornimento, stesso scaffale, persistono per cinque immagini fisse e orario di apertura del negozio. Come regola:
if count(empty_facing on shelf S) >= 3 in each of the last 5 stills and store_is_open(now):
    create_restock_task(shelf=S)
Il negozio può modificare "3", "5" o gli orari di apertura senza riassegnare le etichette a una sola immagine.