Dataset che rispecchiano la realtà
Verifica le lacune di copertura in un dataset reale prima di aggiungere altre etichette e trasforma le lacune in un piano di raccolta con hard negative.
La maggior parte dei modelli di visione deludenti non è costituita da modelli scadenti: sono modelli validi addestrati su un dataset che non assomiglia al luogo in cui vengono usati. Il rilevatore COCO della lezione precedente non ha rilevato nessuna barca ripresa da un drone perché le barche in COCO sono fotografate di lato. Una verifica di cinque minuti mostra queste lacune prima che tu spenda denaro per le etichette.
Pratico
I modelli imparano il dataset, non il mondo#
Un modello interpola tra gli esempi che ha visto. Se lo addestri su strade diurne e soleggiate e lo usi di notte in un garage nebbioso, fallirà: non perché le auto abbiano un aspetto diverso, ma perché non ne ha mai viste in quelle condizioni. Questa discrepanza si chiama cambiamento di dominio e la validazione non può segnalartela se le immagini di validazione provengono dalla stessa raccolta distorta:
La soluzione è strutturale, non algoritmica: campiona intenzionalmente il mondo in cui userai il modello, prima di etichettare. La guida alla raccolta e annotazione dei dati spiega i passaggi pratici.
Verifica un dataset reale#
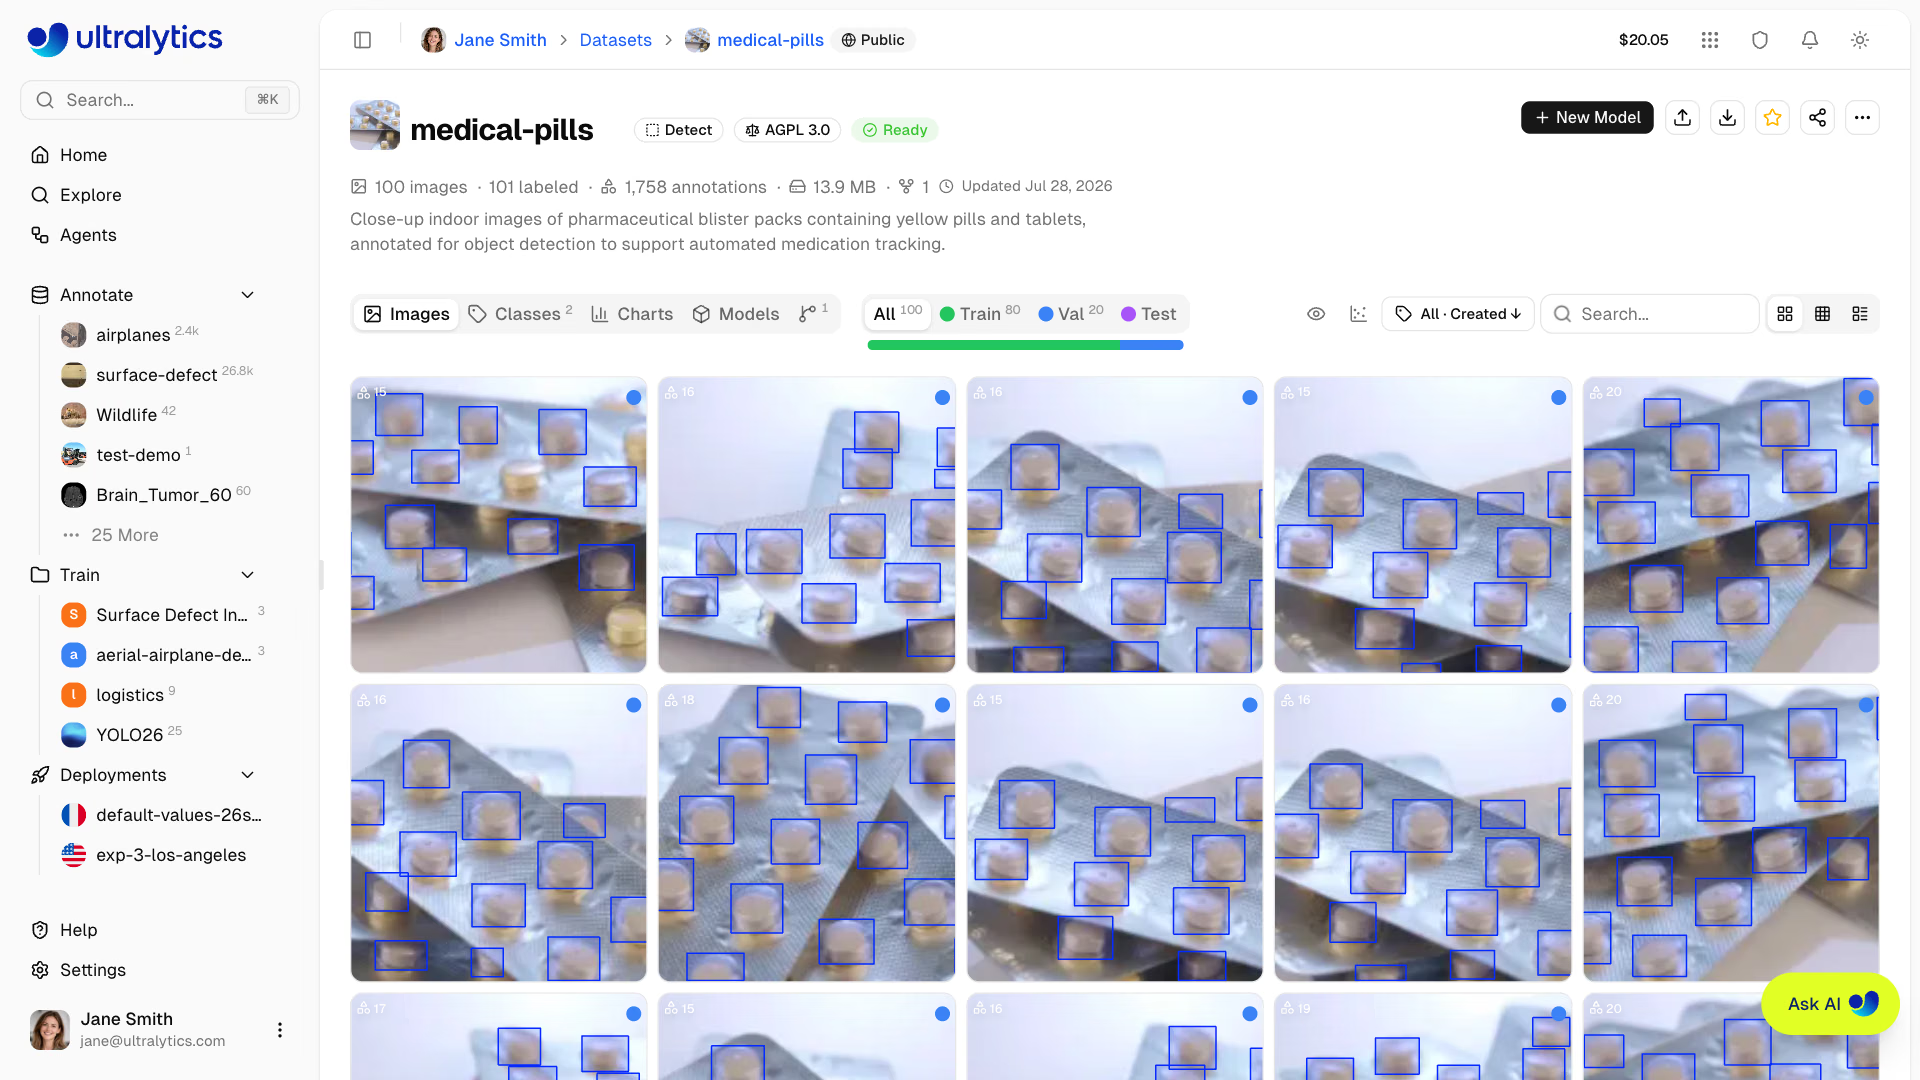
Il dataset medical-pills qui sopra — primi piani di blister con un riquadro attorno a ogni pillola — è un buon candidato per una verifica. Ultralytics Platform mostra i conteggi principali nella pagina del dataset; lo script seguente calcola i valori che rivelano la copertura, usando la copia fornita con ultralytics:
from collections import Counter
from pathlib import Path

from PIL import Image, ImageStat
from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("medical-pills.yaml")  # downloads the dataset on first use

for split in ("train", "val"):
    images = sorted(Path(data[split]).glob("*.jpg"))
    labels = [Path(str(p).replace("/images/", "/labels/")).with_suffix(".txt") for p in images]
    rows = [line.split() for f in labels if f.exists() for line in f.read_text().splitlines()]
    classes = Counter(data["names"][int(r[0])] for r in rows)
    backgrounds = sum(not f.exists() or not f.read_text().strip() for f in labels)
    areas = sorted(float(r[3]) * float(r[4]) for r in rows)  # box area as a share of the image
    sizes = Counter(Image.open(p).size for p in images)
    brightness = [ImageStat.Stat(Image.open(p).convert("L")).mean[0] for p in images]
    print(f"{split}: {len(images)} images, {backgrounds} backgrounds, {dict(classes)}, sizes {dict(sizes)}")
    print(f"  boxes: median {areas[len(areas) // 2]:.1%} of the image, {sum(a < 0.01 for a in areas)} of {len(areas)} under 1%")
    print(f"  brightness: {min(brightness):.0f} to {max(brightness):.0f} (0 = black, 255 = white)")
train: 92 images, 0 backgrounds, {'pill': 1623}, sizes {(1920, 1080): 92}
boxes: median 1.4% of the image, 320 of 1623 under 1%
brightness: 171 to 198 (0 = black, 255 = white)
val: 23 images, 0 backgrounds, {'pill': 399}, sizes {(1920, 1080): 23}
boxes: median 1.4% of the image, 79 of 399 under 1%
brightness: 171 to 198 (0 = black, 255 = white)Leggi i risultati come un rapporto sulla copertura, con un rilievo per riga:
| Rilievo | Significato | Decisione |
|---|---|---|
| Una sola risoluzione, 1920×1080 | Una sola telecamera e una sola configurazione | Raccogli immagini da ogni modello di telecamera su cui userai il sistema |
| Luminosità compresa solo tra 171 e 198 | Illuminazione intensa e uniforme da studio, senza scene poco illuminate | Raccogli immagini poco illuminate, in controluce e con illuminazione mista prima di usare il modello al banco di una farmacia |
| 0 immagini di sfondo | Il modello non vede mai una scena senza pillole | Aggiungi blister vuoti, altre compresse e banconi vuoti come hard negative |
| Il riquadro mediano occupa l’1,4% dell’immagine; 1 riquadro su 5 è inferiore all’1% | Oggetti piccoli | Mantieni imgsz abbastanza alto e includi intenzionalmente immagini riprese da lontano |
Una classe, pill | Nessuna distinzione tra tipi di pillole | Va bene per il conteggio; aggiungi classi solo se servono per prendere una decisione |
Nessuno di questi problemi emerge dal punteggio di validazione, perché il set di validazione condivide tutte queste caratteristiche.
I quattro assi della copertura#
| Asse | Cosa raccogliere | Errore tipico in caso di lacune |
|---|---|---|
| Illuminazione | Alba, mezzogiorno, tramonto, notte, abbagliamento, controluce, luci fluorescenti intermittenti | Il richiamo crolla al cambio turno o sotto la luce diretta del sole |
| Meteo e condizioni atmosferiche | Pioggia, nebbia, neve, polvere, condensa sull’obiettivo | Falsi positivi sulle gocce e mancate rilevazioni nella foschia |
| Occlusione e disordine | Bersagli parzialmente nascosti, scene affollate, oggetti tagliati dal bordo dell’inquadratura | Mancate rilevazioni ogni volta che il bersaglio non è completamente visibile |
| Telecamera e punto di vista | Obiettivo, altezza e angolo di montaggio, risoluzione, compressione, sfocatura da movimento | Funziona con la telecamera del progetto pilota, ma non nella sede successiva |
Il punto di vista è l’asse trascurato nell’esempio del porto turistico: la stessa classe ripresa da una nuova angolazione e il richiamo è sceso a zero.
Hard negative e immagini di sfondo#
Un rilevatore deve imparare anche cosa non è il bersaglio. Le hard negative sono superficialmente simili: per un rilevatore di carrelli elevatori, un transpallet, una piattaforma a forbice, il riflesso di un carrello elevatore su un pavimento lucido o un poster di sicurezza con l’immagine di un carrello elevatore.
Nel formato YOLO, un’immagine di sfondo è semplicemente un’immagine senza file di etichette: non c’è nulla da disegnare. I consigli per l’addestramento di Ultralytics raccomandano circa lo 0–10% di immagini di sfondo per ridurre i falsi positivi; COCO stesso ne contiene circa l’1%. Usa questa quota per inserire hard negative dal tuo ambiente, anziché fotogrammi vuoti scelti a caso. L’aumento dei dati può variare luminosità e angolazione, ma non può inventare un transpallet che il modello non ha mai visto.
Insidie#
Sintomo: 10.000 immagini etichettate, tutte diurne e tutte provenienti dalla videocamera pilota. Soluzione: acquisisci immagini dalle videocamere di produzione per un paio di settimane, coprendo l'intera gamma di condizioni; verifica la copertura e poi paga per le etichette. I dati sintetici possono colmare una lacuna nota, ma non sostituiscono le acquisizioni reali.
Sintomo: mAP di validazione elevata, risultati scarsi nel primo nuovo sito. Soluzione: ricorda che la validazione condivide i punti ciechi del dataset. Prendi dieci immagini casuali di addestramento e dieci fotogrammi di produzione e chiedi a un collega di distinguerli; se ci riesce, hai un divario di dominio.
Per un piano di campionamento con conteggi obiettivo per condizione, continua con Raccogliere dati rappresentativi e di alta qualità in Creare dataset YOLO ad alte prestazioni.
Mostra la soluzione
Per medical-pills, distribuito su un bancone di farmacia con illuminazione mista, compila la griglia usando l'audit (luminosità 171–198, una sorgente 1920×1080, zero sfondi) e una rapida scorsa alle immagini, che mostra le stesse confezioni sulla stessa superficie luminosa, senza mani:
| Classe | Luce intensa da studio | Luce fioca o calda del negozio | Controluce / riflessi | Parzialmente coperto da una mano | Fotocamera del telefono |
|---|---|---|---|---|---|
pill | 2,022 | 0 | 0 | 0 | 0 |
| sfondo | 0 | 0 | 0 | — | 0 |
Piano di raccolta in ordine di priorità:
- Luce fioca o calda del negozio — la condizione normale del bancone, attualmente con zero immagini.
- Parzialmente coperto da una mano — succede in quasi tutte le interazioni reali.
- Fotocamera del telefono — un secondo sensore e una seconda risoluzione.
- Controluce / riflessi — le confezioni in foglio metallico riflettono le finestre e le luci a soffitto.
Hard negative: blister vuoti (stesso foglio metallico, senza pillole) e altri oggetti rotondi sul bancone — monete, bottoni, caramelle. Aggiungili come immagini di sfondo, circa il 5–10% del dataset.