Qualità delle annotazioni
Scopri cosa contiene un'etichetta YOLO, controlla i file delle etichette per individuare righe errate e mantieni la coerenza tra gli annotatori con una linea guida e una sessione di calibrazione misurata.
Un modello addestrato su etichette incoerenti apprende l'incoerenza. Cinquantamila riquadri disegnati seguendo una regola chiara valgono più di mezzo milione disegnati secondo venti interpretazioni personali, e rietichettare è quasi sempre più economico che usare un modello più grande. Questa lezione ti fornisce un verificatore delle etichette, una linea guida di una pagina e un valore che misura l'accordo tra annotatori.
Pratico
Cos'è davvero un'etichetta#
Nel formato YOLO, ogni immagine ha un file .txt corrispondente, con una riga per ogni oggetto. Le coordinate sono normalizzate tra 0 e 1 rispetto alla larghezza e all'altezza dell'immagine, così le etichette restano valide quando l'immagine viene ridimensionata. La struttura della riga dipende dall'attività:
| Task | Un'etichetta | Note |
|---|---|---|
| Rilevamento | class x_center y_center width height | Centro e dimensioni del riquadro |
| Segmentazione di istanze | class x1 y1 x2 y2 ... xn yn | Contorno del poligono |
| Stima della posa | class x y w h px1 py1 v1 ... pxn pyn vn | Riquadro, poi keypoint con visibilità facoltativa |
| OBB | class x1 y1 x2 y2 x3 y3 x4 y4 | Quattro angoli del riquadro ruotato |
| Classificazione | Nessun file delle etichette | Immagini suddivise in una cartella per classe |
| Segmentazione semantica | Una maschera PNG per immagine | Ogni valore dei pixel è un indice di classe |
| Stima della profondità | Un PNG o NPY di profondità per immagine | Ogni valore dei pixel è una distanza |
Gli indici delle classi partono da 0 e corrispondono ai nomi nel YAML del dataset. Un'immagine senza oggetti non richiede un file delle etichette: è così che funzionano le immagini di sfondo. Le pagine dei dataset di rilevamento, semantico e di profondità contengono esempi pratici.
Controlla i file delle etichette#
Le righe errate passano inosservate: una coordinata superiore a 1, un ID di classe non definito nel YAML o lo stesso oggetto racchiuso due volte diventano rumore che il modello cerca di apprendere. Un breve script di controllo li individua prima dell'addestramento:
from itertools import combinations
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

def iou(a, b):
    """IoU of two normalized (x_center, y_center, width, height) boxes."""
    ax1, ay1, ax2, ay2 = a[0] - a[2] / 2, a[1] - a[3] / 2, a[0] + a[2] / 2, a[1] + a[3] / 2
    bx1, by1, bx2, by2 = b[0] - b[2] / 2, b[1] - b[3] / 2, b[0] + b[2] / 2, b[1] + b[3] / 2
    inter = max(0, min(ax2, bx2) - max(ax1, bx1)) * max(0, min(ay2, by2) - max(ay1, by1))
    return inter / (a[2] * a[3] + b[2] * b[3] - inter)

def check_labels(text, names):
    """Return a list of problems in one YOLO detection label file."""
    problems, boxes = [], []
    for i, row in enumerate(text.split("\n"), 1):
        values = row.split()
        if not values:
            continue
        if len(values) != 5:
            problems.append(f"row {i}: {len(values)} values, expected 5")
        elif int(values[0]) not in names:
            problems.append(f"row {i}: unknown class {values[0]}")
        elif not all(0 <= float(v) <= 1 for v in values[1:]):
            problems.append(f"row {i}: coordinates outside 0-1")
        else:
            boxes.append((i, int(values[0]), [float(v) for v in values[1:]]))
    for (i, ca, a), (j, cb, b) in combinations(boxes, 2):
        if ca == cb and iou(a, b) > 0.8:
            problems.append(f"row {j}: duplicate of row {i} (IoU {iou(a, b):.2f})")
    return problems

broken = "0 0.50 0.50 0.20 0.30\n0 0.51 0.50 0.20 0.30\n3 0.40 0.40 0.10 0.10\n0 1.20 0.50 0.10 0.10\n0 0.50 0.50 0.10"
print("\n".join(check_labels(broken, {0: "pill"})))

data = check_det_dataset("medical-pills.yaml")
files = sorted(Path(data["path"], "labels").rglob("*.txt"))
found = sum(len(check_labels(f.read_text(), data["names"])) for f in files)
print(f"medical-pills: {found} problems in {len(files)} label files")
row 3: unknown class 3
row 4: coordinates outside 0-1
row 5: 4 values, expected 5
row 2: duplicate of row 1 (IoU 0.90)
medical-pills: 0 problems in 115 label filesL'esempio creato a mano mostra ogni errore rilevato dallo script; il dataset reale supera il controllo senza problemi. Eseguilo dopo ogni gruppo di annotazioni e prima di ogni sessione di addestramento: bastano pochi secondi.
Perché le etichette divergono#
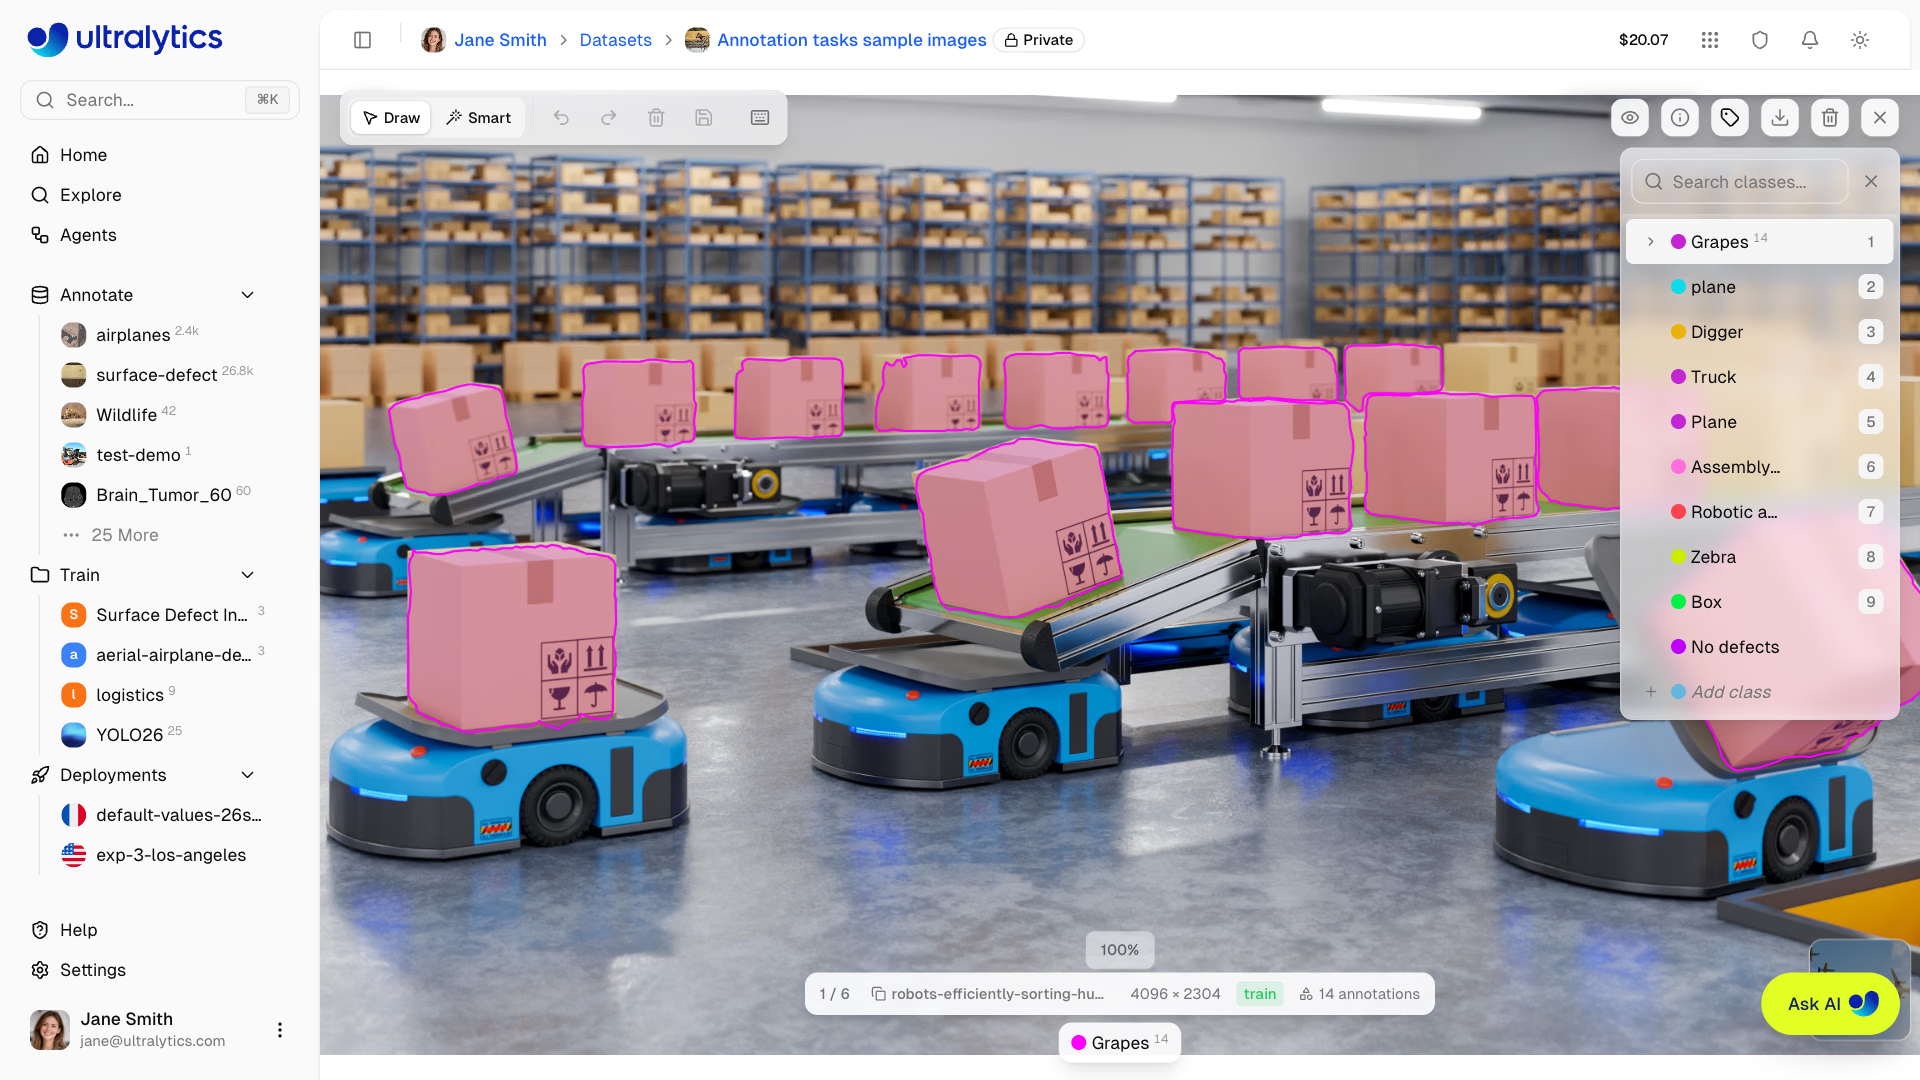
Osserva il pannello delle classi in questo editor: i 14 poligoni degli scatoloni sono salvati sotto Grapes, mentre una classe Box compare più in basso nell'elenco; inoltre, plane e Plane esistono come due classi separate. Un verificatore non può individuare nessuno dei due problemi, perché ogni riga è valida, ma un revisore che confronta le etichette con la linea guida li noterebbe entrambi in pochi secondi. La maggior parte degli errori di etichettatura è di questo tipo: file validi, decisioni sbagliate.
Raramente gli annotatori etichettano male per disattenzione. Le loro annotazioni sono incoerenti perché le regole sono ambigue e ciascuno fa una supposizione ragionevole ma diversa:
- Dove finisce il riquadro? Include l'ombra, una borsa trasportata, il carico sulle forche di un muletto?
- Troncamento. Una persona per metà fuori dall'inquadratura è ancora
person? Quale frazione deve essere visibile? - Occlusione. Se è visibile solo una ruota di un'auto, va etichettata o ignorata?
- Confini tra classi. Un pick-up è
carotruck? Uno scooter èbicycleoother? - Casi da non etichettare. Riflessi, poster e schermi che mostrano l'oggetto.
Ogni scelta va bene, purché tutti facciano la stessa.
Una linea guida di una pagina#
Deve stare su una pagina, includere un'immagine di esempio per ogni regola e presentare per primi i casi limite:
## Class: forklift

Include:
- Forklifts with at least 30% of the body visible, moving or parked, any size or color.

Do not label:
- Pallet jacks (no overhead mast) → class `pallet_jack`.
- Reflections in glass or polished floors, and forklifts on posters or screens.

Box rules:
- Include the mast and the full visible body.
- Exclude the load (pallets, boxes) — those have their own classes.
- For partly occluded forklifts, box the visible part only.
Misura l'accordo durante una sessione di calibrazione#
Prima di passare da un annotatore a venti, tutti etichettano le stesse 50 immagini e confronti i risultati:
L'accordo è la quota di oggetti che entrambi gli annotatori hanno disegnato con la stessa classe e un IoU di almeno 0,5: la versione pratica dell'affidabilità inter-valutatore:
def iou(a, b):
    """IoU of two (x1, y1, x2, y2) pixel boxes."""
    w = max(0, min(a[2], b[2]) - max(a[0], b[0]))
    h = max(0, min(a[3], b[3]) - max(a[1], b[1]))
    inter = w * h
    return inter / ((a[2] - a[0]) * (a[3] - a[1]) + (b[2] - b[0]) * (b[3] - b[1]) - inter)

def agreement(boxes_a, boxes_b, threshold=0.5):
    """Share of objects both annotators drew with the same class and IoU >= threshold."""
    unmatched, matched = list(boxes_b), 0
    for cls_a, box_a in boxes_a:
        best = max(unmatched, key=lambda b: iou(box_a, b[1]) if b[0] == cls_a else -1, default=None)
        if best and best[0] == cls_a and iou(box_a, best[1]) >= threshold:
            unmatched.remove(best)
            matched += 1
    return matched / max(len(boxes_a), len(boxes_b))

# Two annotators label the same calibration image
alice = [("forklift", (100, 200, 400, 600)), ("person", (450, 220, 520, 480)), ("person", (600, 230, 660, 470))]
bob = [("forklift", (100, 120, 400, 600)), ("person", (452, 218, 522, 478)), ("pallet_jack", (600, 230, 660, 470))]
print(f"agreement: {agreement(alice, bob):.0%}")
agreement: 67%Quel 67% nasconde due tipi di disaccordo. Il riquadro del muletto di Bob parte 80 pixel più in alto — ha incluso la punta del montante — ma ha comunque un IoU di 0,83, quindi conta come accordo; se il tuo prodotto misura l'altezza, definisci meglio la regola per il riquadro. Il terzo oggetto è un vero conflitto: Alice dice person, Bob dice pallet_jack. Serve una regola più chiara e un'immagine di esempio, poi un'altra sessione. Conserva le 50 immagini di calibrazione: diventeranno il test di onboarding per ogni nuovo annotatore.
Un revisore che corregge silenziosamente le etichette elimina il ciclo di feedback e chi annota non impara mai cosa ha sbagliato. Rifiuta l'etichetta indicando il motivo e lascia che sia l'annotatore a correggerla. È più lento per le prime cento immagini, ma molto più rapido in seguito.
Cosa monitorare#
| Metrica | Cosa indica |
|---|---|
| Produttività (oggetti all'ora) | Capacità e costi |
| Tasso di rifiuto | Se la qualità sta peggiorando |
| Accordo su un insieme di sovrapposizione condiviso | Se gli annotatori continuano ad applicare le stesse regole |
Quando l'accordo diminuisce, qualcosa è cambiato: un nuovo annotatore, una nuova fotocamera, un gruppo di immagini ambiguo, la stanchezza. Quando in seguito il modello fallisce in una condizione specifica, rimanda quelle stesse immagini all'etichettatura: è il ciclo che l'apprendimento attivo automatizza e da cui derivano la maggior parte dei miglioramenti di accuratezza nel mondo reale. Esplora e filtra gli errori nei tuoi dataset su Ultralytics Platform e consulta Controllo qualità dei dataset e Buone pratiche di annotazione per applicare questo processo su larga scala.
Mostra la soluzione
Una linea guida per la classe pill di medical-pills, scritta dopo una sessione di calibrazione su 10 immagini:
## Class: pill

Include:
- Every tablet inside a blister cavity, including half-visible ones at the image edge.
- Tablets seen through clear plastic, even when glare covers part of them.

Do not label:
- Empty cavities, torn foil, or tablets outside the pack.
- Reflections of tablets in the foil.

Box rules:
- Box the tablet itself, not the plastic bubble around it.
- If two tablets touch, draw two boxes.
Come interpretare il punteggio di accordo: supponiamo che la prima sessione ottenga 82%. Ordina gli oggetti non corrispondenti in base alla causa. Sui blister, i due problemi più comuni sono i riquadri disegnati intorno alla bolla di plastica invece che alla compressa (risolto con la prima regola sui riquadri e un'immagine di esempio) e le compresse coperte dai riflessi ignorate da un annotatore (risolto con la seconda regola di inclusione). Ripeti la prova su 10 immagini nuove; aumenta la scala solo quando il punteggio supera la soglia del 90%.