Best practice per l'annotazione
Scrivi una guida all'etichettatura, scegli uno strumento, evita i dieci errori che compromettono silenziosamente la precisione e misura con uno script l'accordo tra annotatori prima di aumentare la scala.
La qualità delle etichette pone un limite alla qualità del modello. Dieci annotatori che interpretano ciascuno "pallet" in modo leggermente diverso producono un dataset che insegna contemporaneamente tutte e dieci le interpretazioni, e nessuna quantità di addestramento può risolvere la contraddizione. Una guida scritta, un ciclo di calibrazione misurato e un breve elenco di errori noti mantengono coerenti le etichette, sia che una persona ne assegni 500 immagini, sia che un team ne annoti 50.000.
Pratico
Scegli lo strumento di annotazione#
Lo strumento giusto dipende dall'attività, dal team e dal luogo in cui avviene l'addestramento:
| Strumento | Ideale per | Note |
|---|---|---|
| Ultralytics Platform | Tutti e sette i task YOLO: un editor per riquadri, poligoni, maschere semantiche, punti chiave, riquadri ruotati e classi di immagini, oltre a mappe di profondità caricate; annotazione intelligente con SAM | Etichette, grafici del dataset e addestramento in un unico posto; nessuna fase di esportazione |
| CVAT | Team numerosi, video, flussi di revisione complessi | In hosting autonomo o nel cloud |
| Label Studio | Progetti multimodali (immagine + testo + audio) | Configurazione flessibile, curva di apprendimento più ripida |
| Labelme | Etichettatura tramite poligoni per piccoli team | Semplice app desktop |
| LabelImg | Prototipi rapidi con soli riquadri | Leggero; il repository è archiviato |
Su Ultralytics Platform, l'annotazione intelligente con SAM 2.1, SAM 3 e SAM 3.1 funziona con dataset di rilevamento, segmentazione, segmentazione semantica e OBB. Qualunque strumento tu scelga, verifica che esporti nel formato YOLO richiesto dal tuo task; Preparare un dataset personalizzato spiega il formato delle etichette e la conversione.
I sette tipi di etichetta#

| Tipo di etichetta | Cosa disegnare | Task |
|---|---|---|
| Etichetta di classe | Un'etichetta per immagine | Classificazione |
| Riquadro di delimitazione | Rettangolo non ruotato per ogni oggetto | Rilevamento |
| Poligono | Contorno di ogni istanza dell'oggetto | Segmentazione di istanze |
| Maschera densa | Una classe per ogni pixel | Segmentazione semantica |
| Punti chiave | Punti denominati, come le articolazioni | Posa |
| Riquadro orientato | Rettangolo ruotato per ogni oggetto | OBB |
| Mappa di profondità | Niente: una mappa delle distanze per pixel acquisita da un sensore di profondità e abbinata a ogni immagine | Stima della profondità |
Scrivi prima la guida all'etichettatura#
Prima che qualcuno disegni un riquadro, scrivi una guida articolata in cinque sezioni:
- Definizioni delle classi: un paragrafo per ogni classe, con esempi positivi, elementi simili che non appartengono alla classe e casi limite.
- Regole di disegno: riquadri aderenti all'oggetto visibile; poligoni che seguono il contorno visibile.
- Regole per occlusione e dimensioni: una soglia per gli oggetti parziali ("etichetta se riesci a identificare la classe") e una per quelli molto piccoli ("etichetta le persone alte più di 10 pixel"), applicate ovunque.
- Registro dei casi ambigui: ogni domanda del tipo "e questo caso?", con la risposta concordata e uno screenshot.
- Cosa tralasciare: tutto ciò che non vale la pena etichettare per questo task.
Una o due pagine con screenshot sono più che sufficienti. La guida serve poi da riferimento per un breve ciclo da completare prima di aumentare la scala dell'etichettatura:
Etichetta ogni oggetto rilevante in ogni immagine. Un carrello elevatore senza etichetta insegna al modello che a volte i carrelli elevatori sono sfondo, quindi il modello impara a non rilevarli. Un dataset etichettato solo in parte sembra identico a un dataset più piccolo etichettato per intero, finché non avvii l'addestramento. Completa ogni immagine prima di passare alla successiva.
Dieci errori che compromettono la precisione#
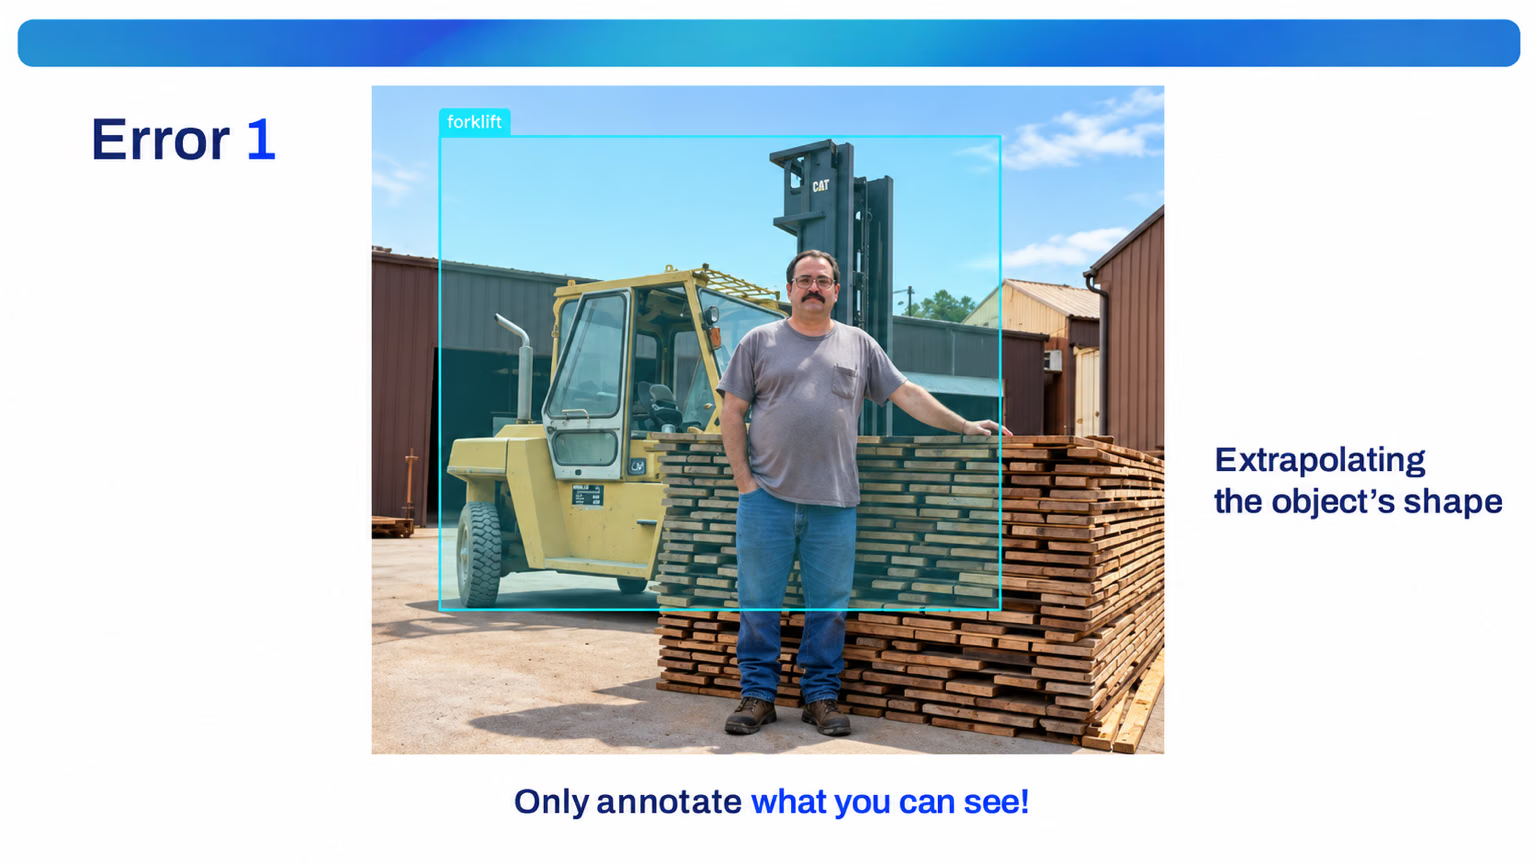
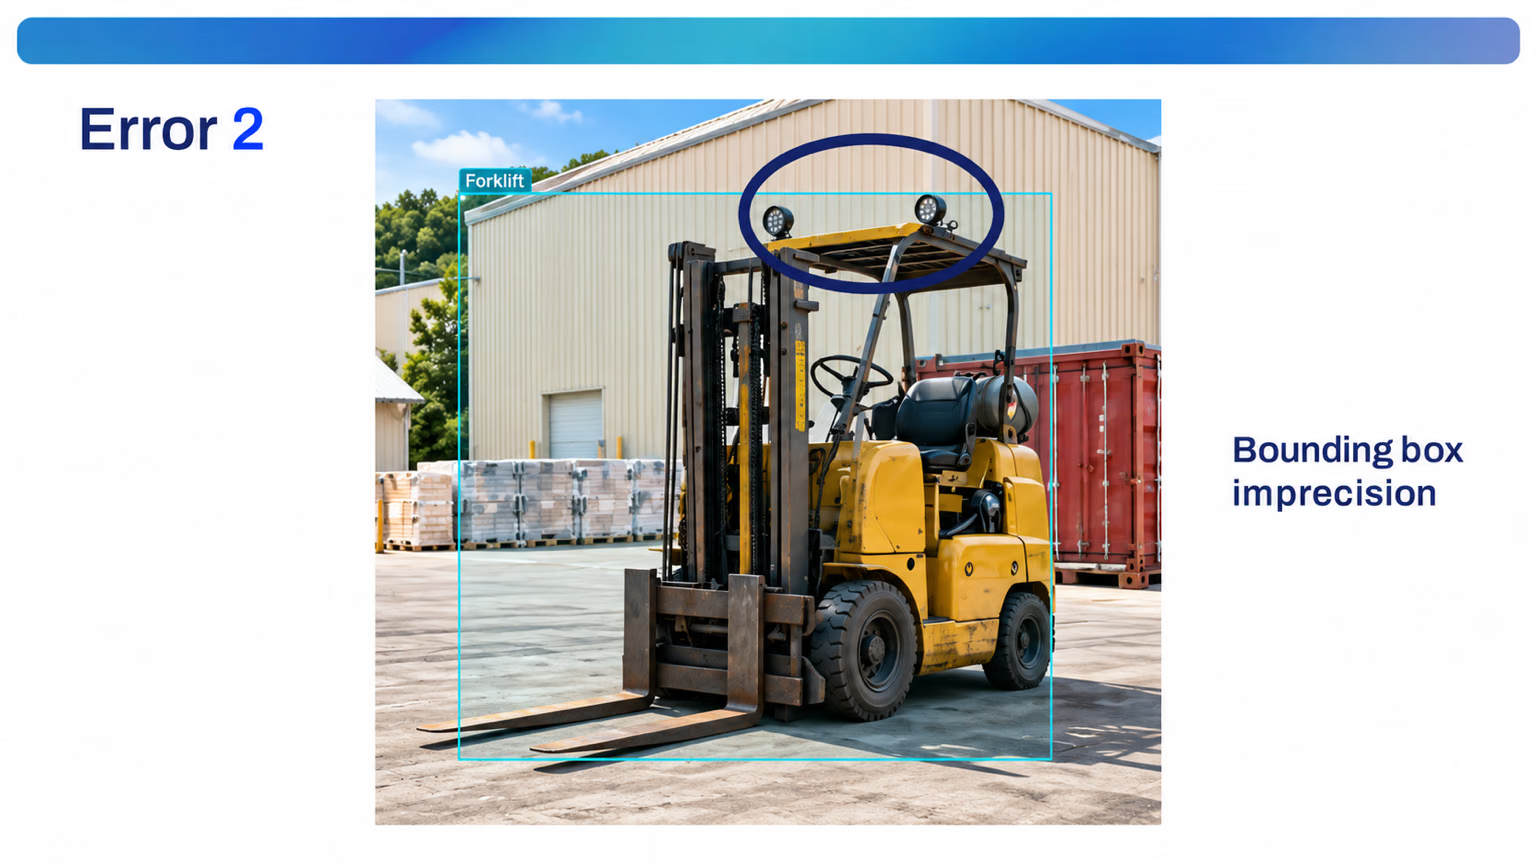
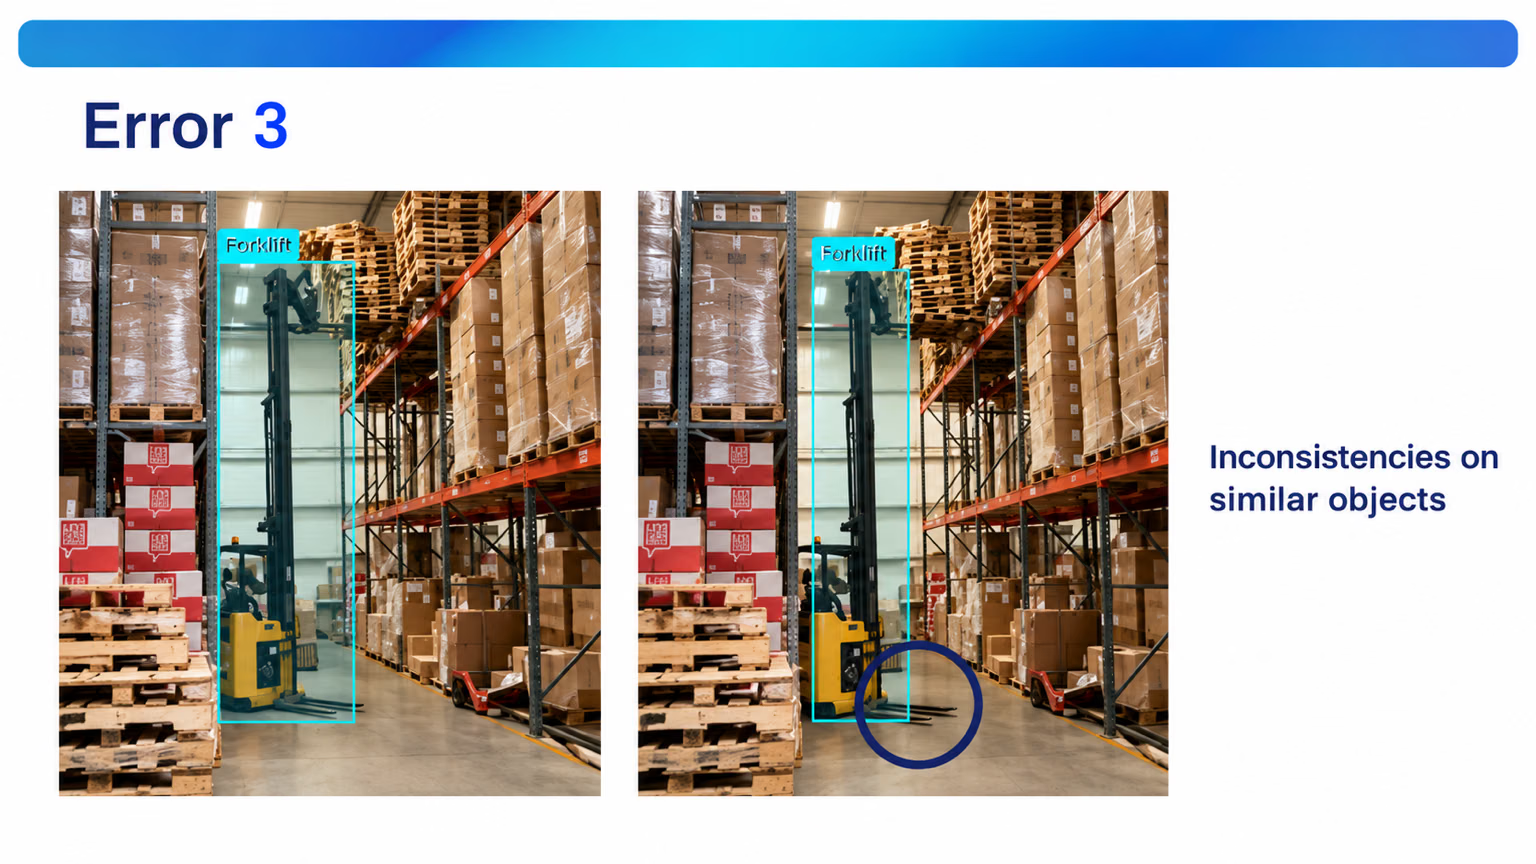
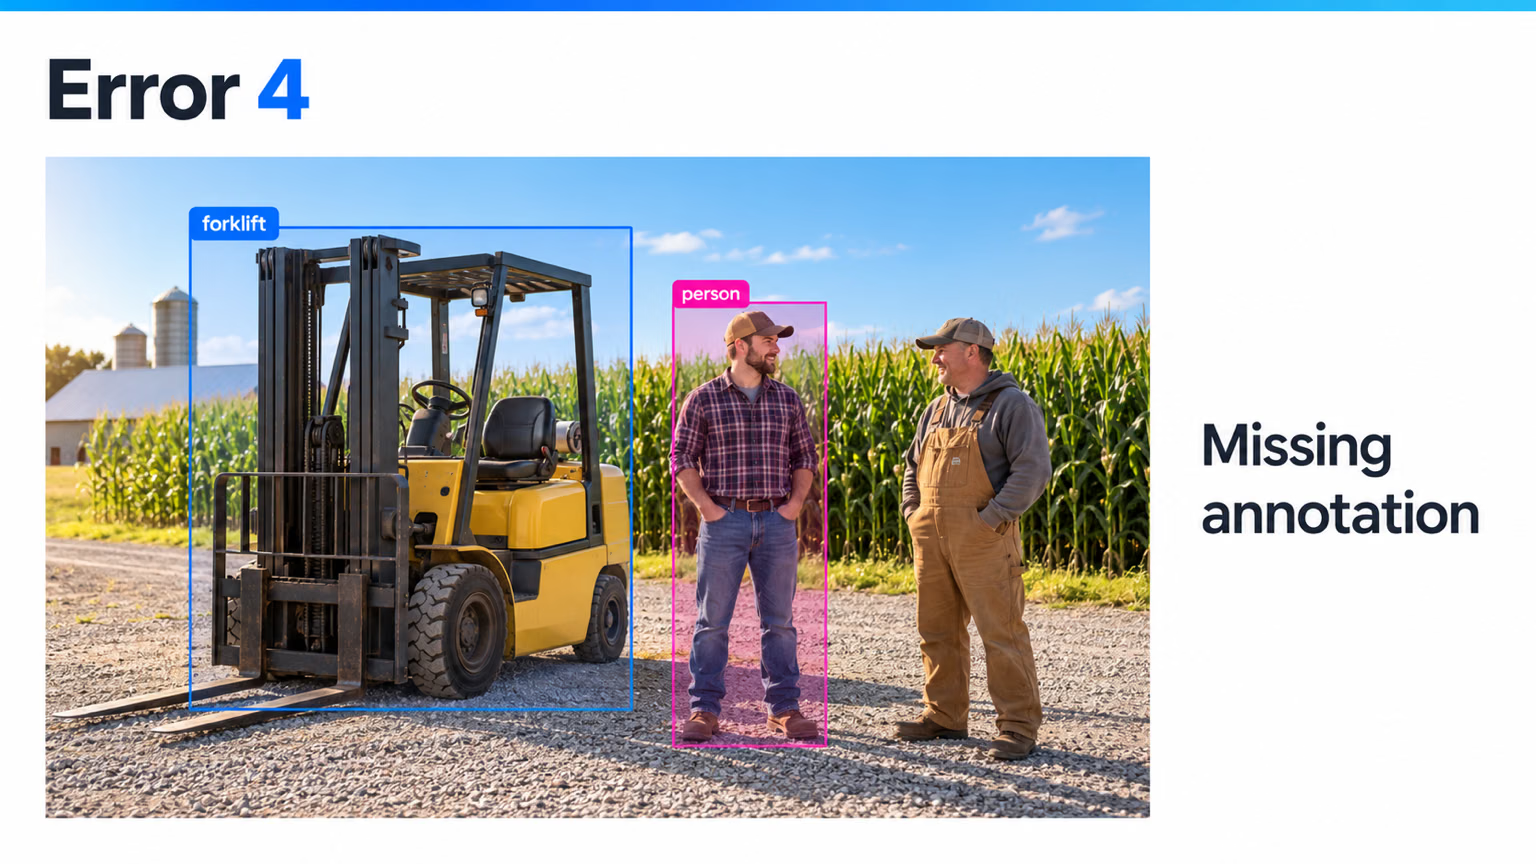
Gli errori che il team di annotazione di Ultralytics riscontra più spesso, illustrati con immagini di carrelli elevatori, persone e pallet (adattato da una presentazione di Alexis Schutzger). Usali come prime voci della tua guida.
1. Deducendo la forma dell'oggetto. Annota solo ciò che puoi vedere. Qui il carrello elevatore è dietro una persona e una pila di legname, ma il suo riquadro si estende oltre entrambi fino al punto in cui l'annotatore ha immaginato il resto del carrello. Delimita solo la parte visibile.
2. Riquadri imprecisi. I riquadri devono aderire all'oggetto. Questo attraversa le luci della protezione superiore; un riquadro che taglia parte dell'oggetto o include un margine di pavimento insegna un'estensione errata.
3. Convenzioni incoerenti per oggetti simili. Il riquadro a sinistra include le forche; quello a destra le esclude. Il modello riceve due risposte alla stessa domanda, quindi stabilisci per iscritto la convenzione: forche incluse o escluse.
4. Annotazioni mancanti. Due persone sono accanto al carrello elevatore, ma solo una è racchiusa in un riquadro. Quella senza etichetta diventa una lezione secondo cui "le persone sono sfondo".
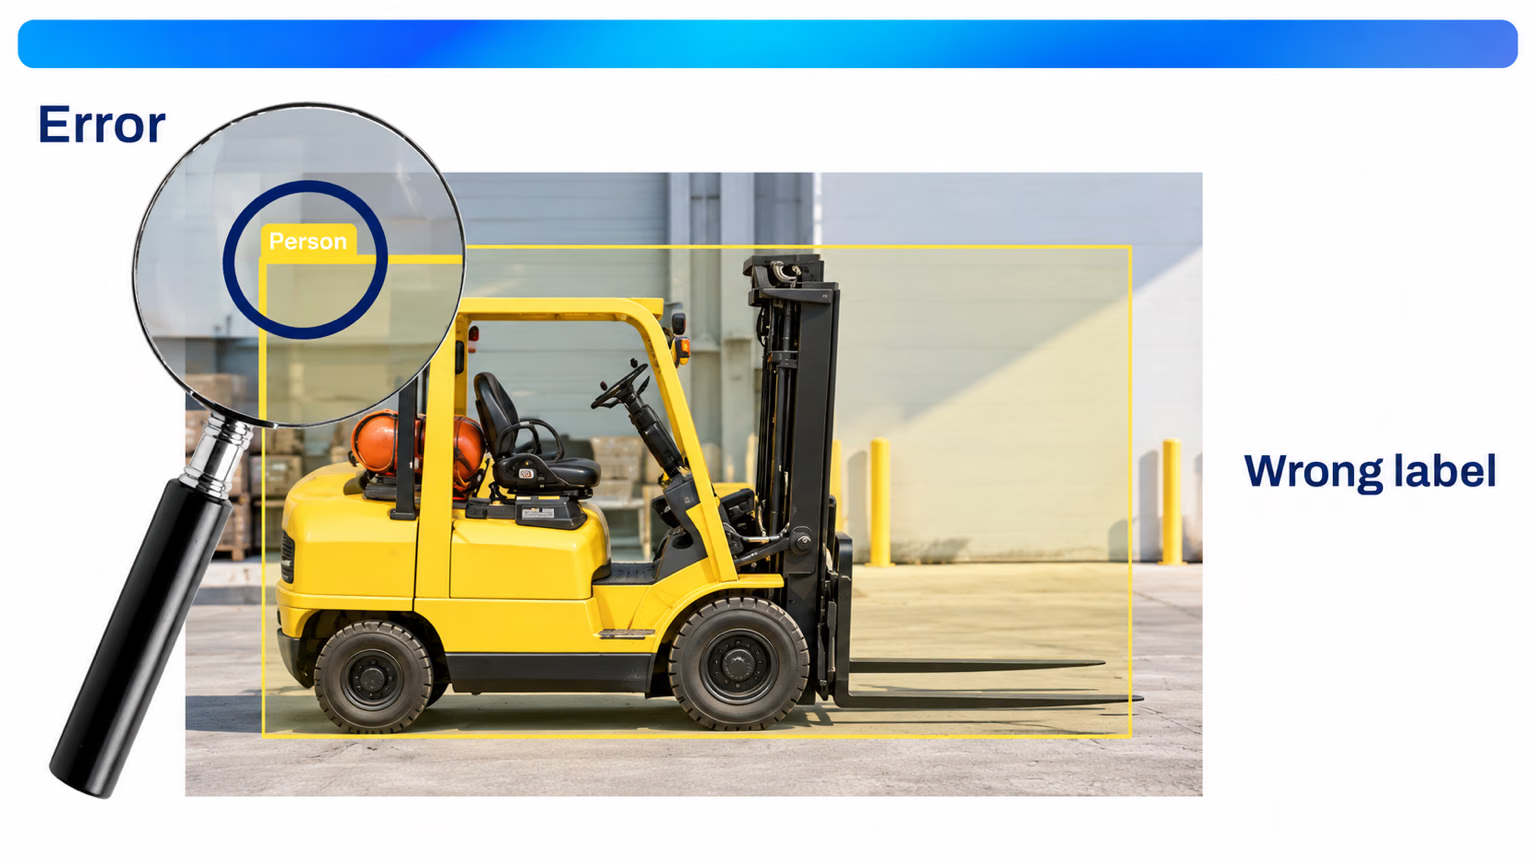
5. Classe errata. Controlla la classe, non solo il riquadro. Un riquadro corretto attorno a un carrello elevatore etichettato person corrompe entrambe le classi, di solito a causa di un errore con una scorciatoia da tastiera.
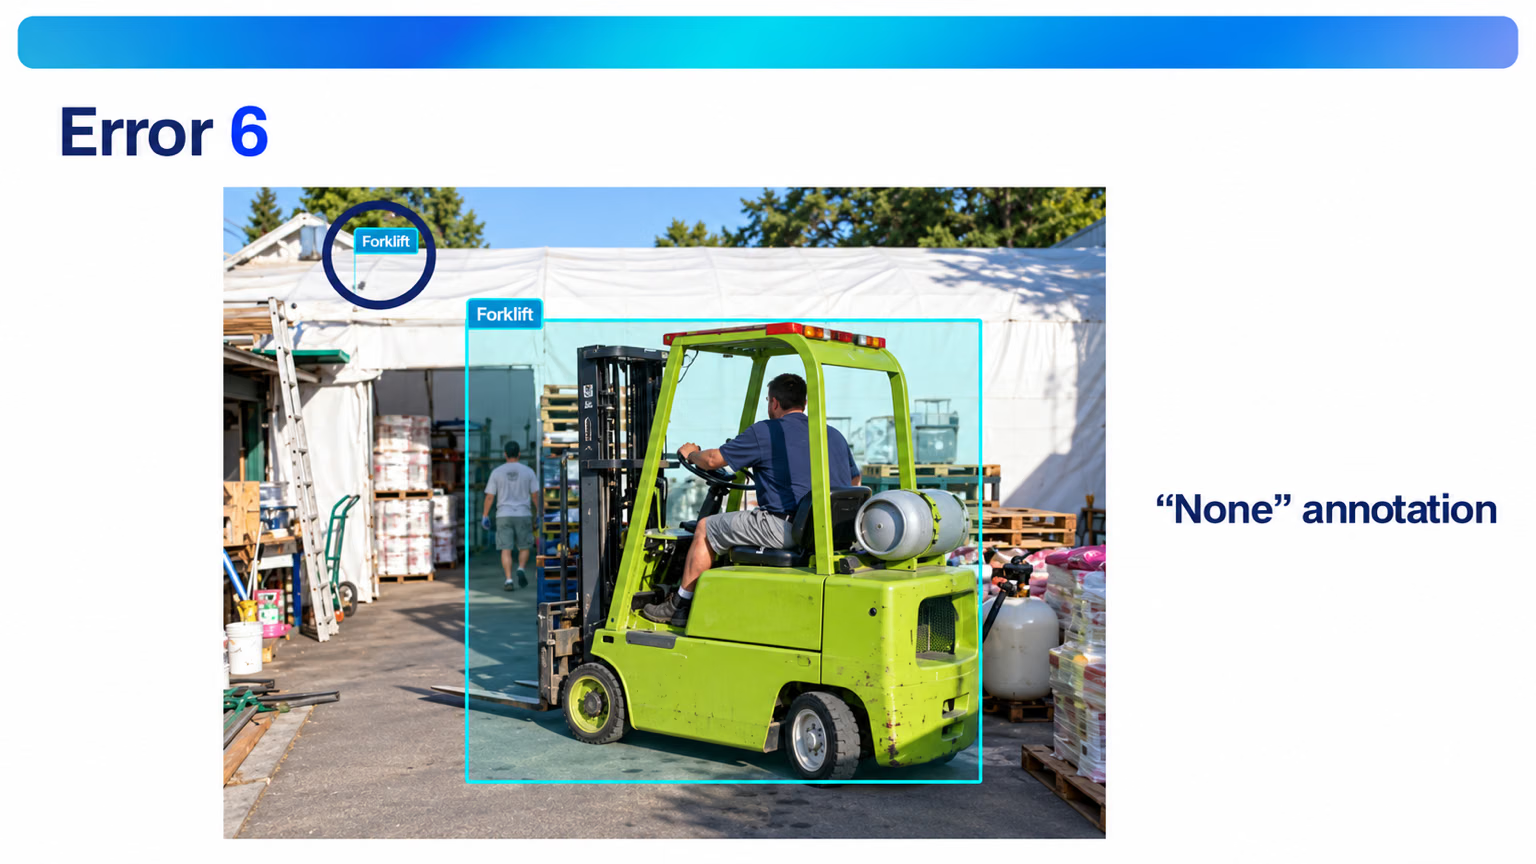
6. Annotazioni vuote o fuori posto. Ogni annotazione deve corrispondere a un oggetto reale e a una classe reale. Un clic fuori posto lascia un riquadro quasi vuoto, come quello nell'angolo qui, mentre un riquadro salvato senza una classe può essere esportato come None o classe 0. Correggili o eliminali.
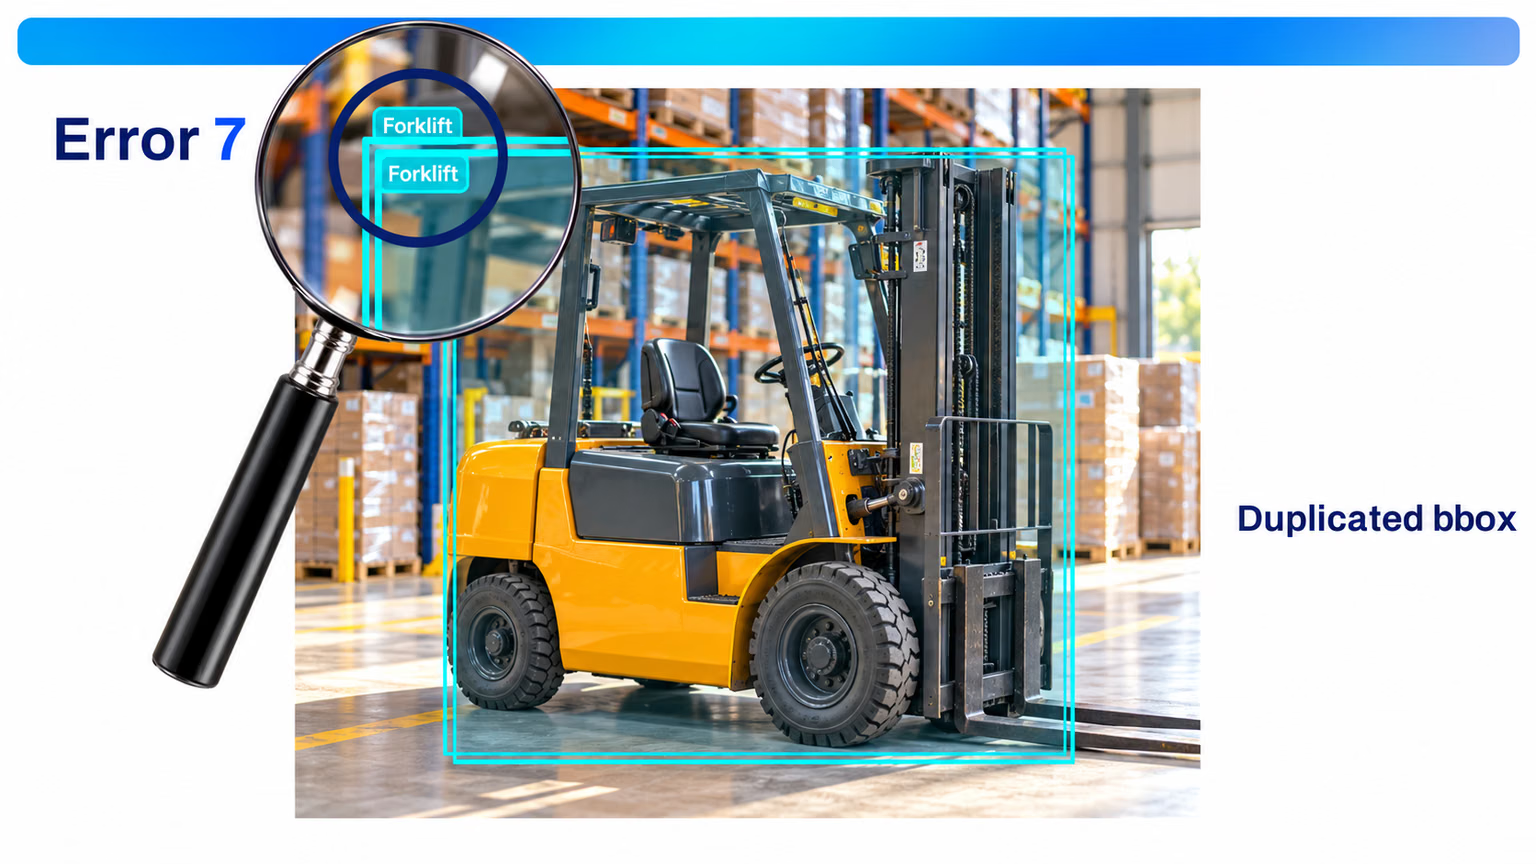
7. Riquadri duplicati. Un oggetto, un riquadro. Due riquadri sovrapposti sullo stesso carrello elevatore aumentano il conteggio delle istanze e insegnano al modello a prevedere duplicati.
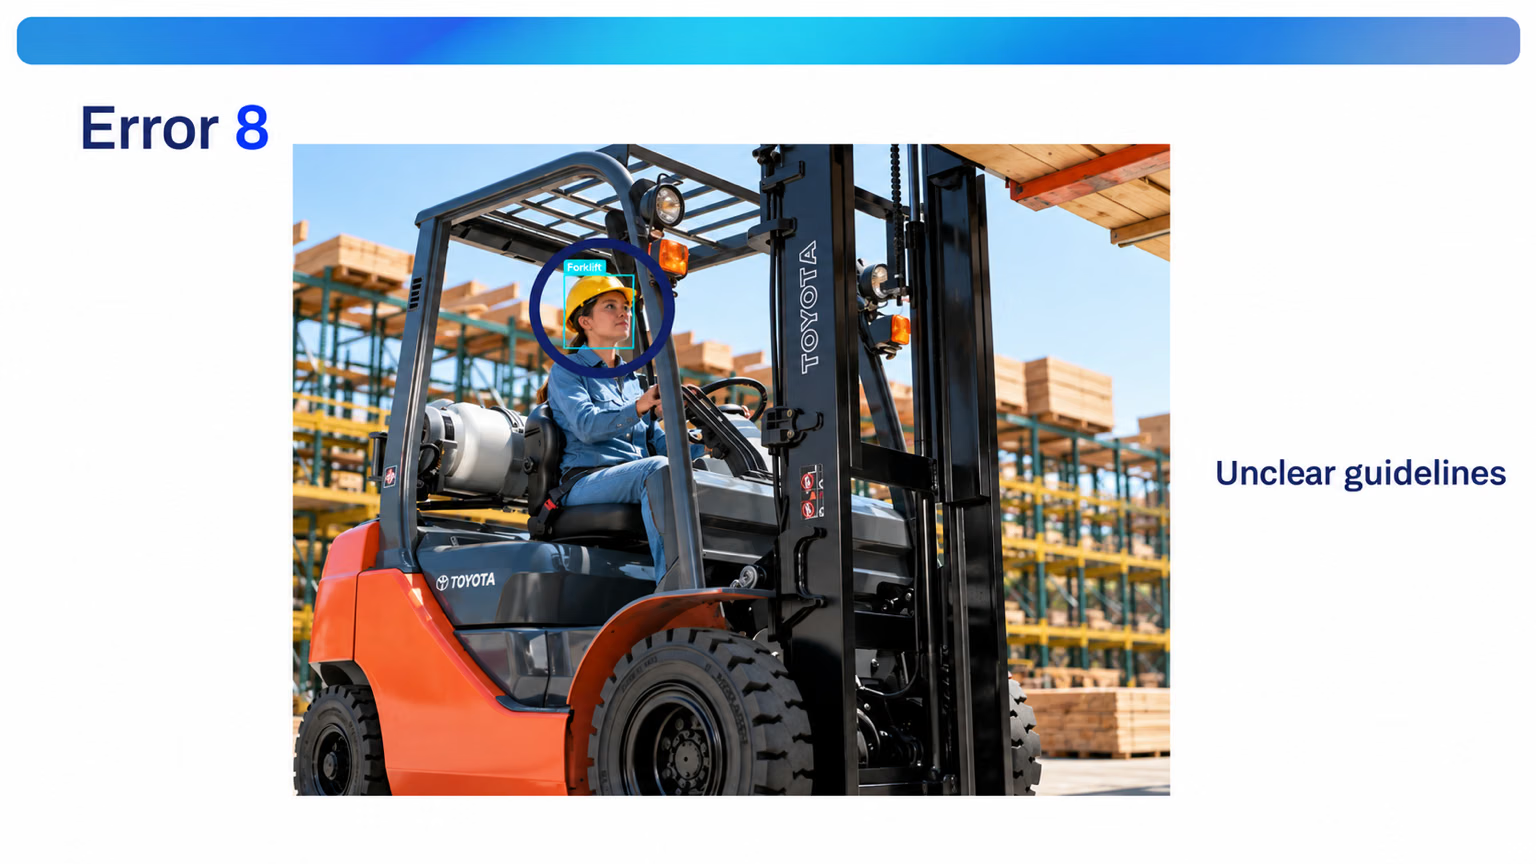
8. Linee guida poco chiare. Senza una regola scritta, chi annota improvvisa: qui qualcuno ha racchiuso solo la testa del conducente e le ha assegnato la classe forklift. Il conducente fa parte del carrello elevatore o è un person separato? Rispondi una volta sola, nella guida.
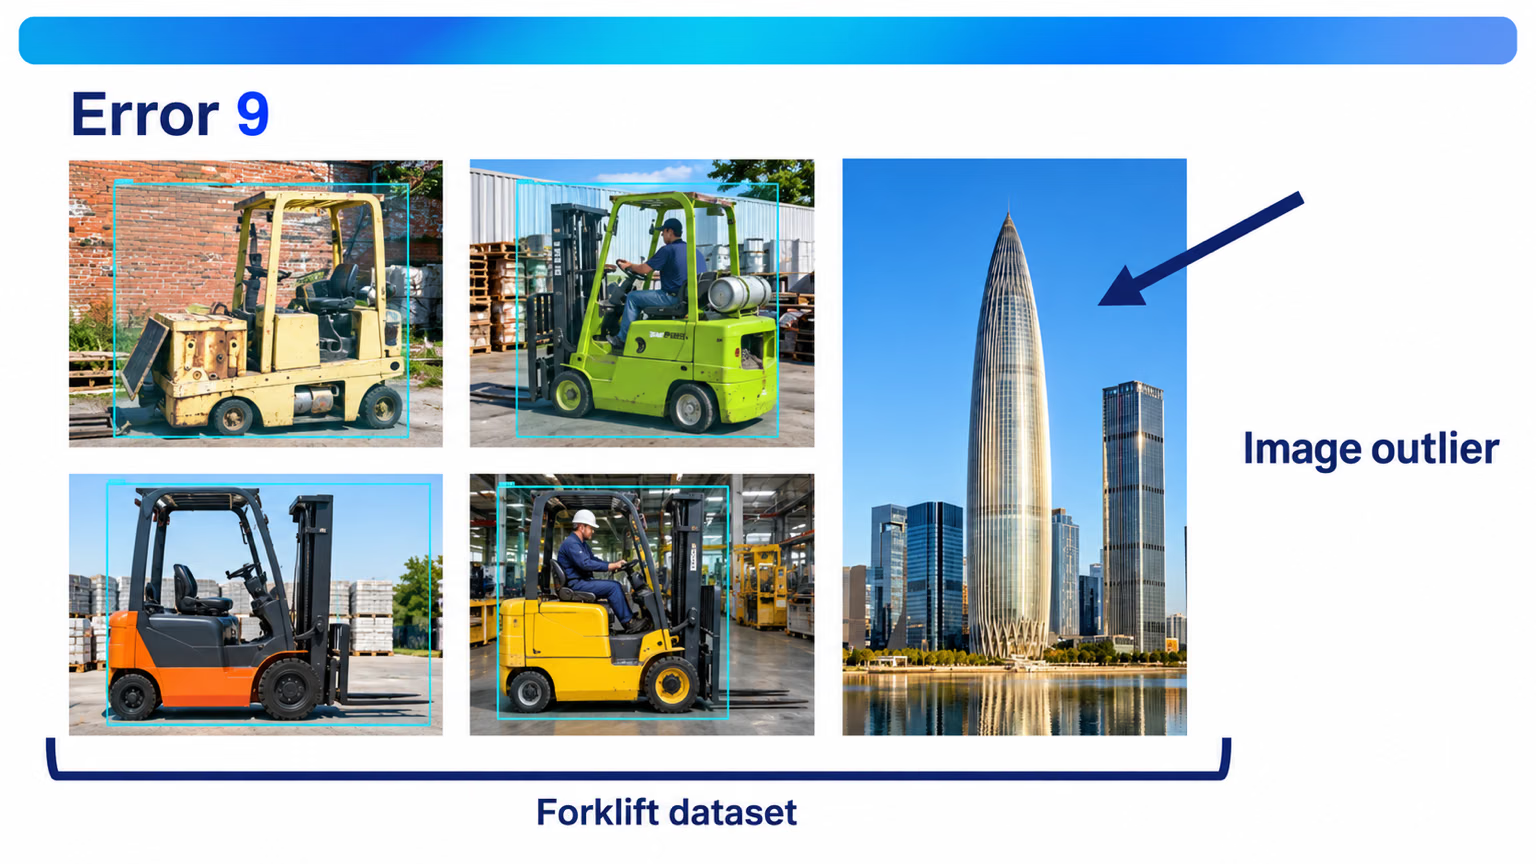
9. Immagini anomale. Escludi le immagini che non corrispondono all'ambiente di deployment. Una foto dello skyline di una città in un dataset di carrelli elevatori non insegna nulla di utile e diluisce tutto il resto.
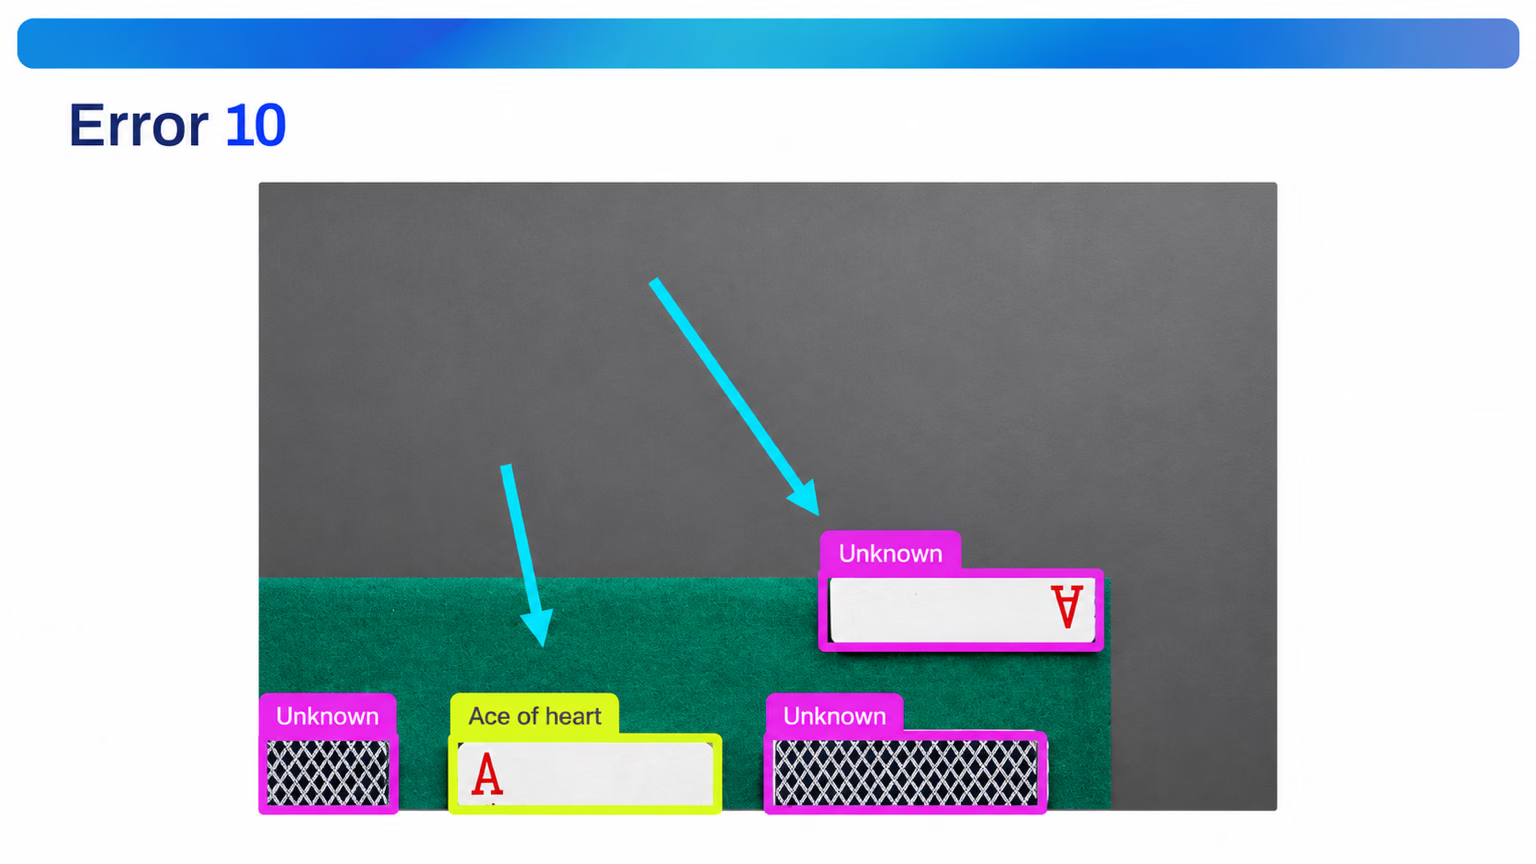
10. Ambiguità indotta dall'aumento dei dati. Se un ritaglio può rimuovere la caratteristica che definisce una classe, due classi diventano identiche. Ritaglia il simbolo nell'angolo di un asso di cuori e sembrerà uguale alle carte etichettate unknown. Usa con attenzione l'aumento dei dati spiega come risolvere il problema.
Misura l'accordo, non tirare a indovinare#
Un ciclo di calibrazione assegna le stesse immagini a due persone che annotano, poi confronta le rispettive etichette oggetto per oggetto. Due etichette concordano se hanno la stessa classe e si sovrappongono con una IoU di almeno 0.5. Questo script calcola il punteggio sulle immagini di val di COCO8. Per poterlo eseguire senza una seconda persona, un modello preaddestrato svolge il ruolo dell'annotatore B; con un team reale, leggi invece i riquadri di B dai suoi file delle etichette:
from pathlib import Path

import torch

from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset, img2label_paths
from ultralytics.utils.metrics import box_iou
from ultralytics.utils.ops import xywh2xyxy

data = check_det_dataset("coco8.yaml")
model = YOLO("yolo26n.pt")  # stands in for a second annotator; compare two label folders the same way
names = data["names"]

matched = total = 0
for image in sorted(Path(data["val"]).glob("*.jpg")):
    rows = [r.split() for r in Path(img2label_paths([str(image)])[0]).read_text().splitlines() if r.strip()]
    a_cls = torch.tensor([int(r[0]) for r in rows])  # annotator A: the dataset labels
    a_box = xywh2xyxy(torch.tensor([[float(v) for v in r[1:]] for r in rows]))
    b = model(image, conf=0.5, verbose=False)[0].boxes  # annotator B: confident model proposals
    iou = box_iou(a_box, b.xyxyn)
    used = set()
    for i in range(len(rows)):  # pair each A object with the best unused same-class B box at IoU >= 0.5
        ok = [j for j in range(len(b)) if j not in used and b.cls[j] == a_cls[i] and iou[i, j] >= 0.5]
        if ok:
            used.add(max(ok, key=lambda j: iou[i, j]))
        else:
            print(f"{image.name}: {names[int(a_cls[i])]} labeled by A only")
    for j in set(range(len(b))) - used:
        print(f"{image.name}: {names[int(b.cls[j])]} labeled by B only")
    matched += len(used)
    total += len(rows) + len(b) - len(used)

print(f"agreement: {matched}/{total} objects = {matched / total:.0%}")
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: potted plant labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000061.jpg: person labeled by A only
000000000061.jpg: elephant labeled by A only
000000000061.jpg: person labeled by A only
agreement: 8/17 objects = 47%Come interpretarlo:
- Il punteggio è il numero di oggetti corrispondenti diviso per il totale degli oggetti disegnati da entrambi gli annotatori: 8 su 17.
- I disaccordi si concentrano. Tutti e nove sono in due immagini e la maggior parte riguarda persone che occupano molto meno dell'1% del fotogramma. Non si tratta di nove errori casuali, ma di un'unica regola mancante: etichettiamo le persone distanti?
- La soluzione è aggiungere una voce alla guida, ad esempio «etichetta ogni persona alta almeno 10 pixel in un'immagine da 640 pixel». Entrambi gli annotatori rietichettano quelle due immagini e si misura di nuovo il punteggio.
La regola decisionale: aumenta la scala dell'annotazione solo quando l'accordo raggiunge il 90%. Al di sotto di questa soglia, ogni nuovo annotatore moltiplica le incongruenze.
Usa l'annotazione intelligente per accelerare il lavoro#
L'annotazione intelligente consente a un modello YOLO o SAM di proporre etichette che una persona accetta o corregge, aumentando la produttività anche di diverse volte. Procedi per cicli: addestra il modello su un lotto revisionato, usalo per proporre etichette per il lotto successivo, revisiona e riaddestra. Questo è il ciclo di apprendimento attivo e Annotazione intelligente ed etichettatura in batch lo illustra sulla Ultralytics Platform.
Un modello che non rileva le persone piccole non propone alcun riquadro per loro, e un revisore che fa clic su "accetta tutto" non le aggiunge. Il modello successivo, addestrato su quelle etichette, non le rileverà con ancora maggiore sicurezza. Esamina ogni immagine e aggiungi ciò che il modello non ha rilevato, oltre a correggere ciò che ha disegnato.
Verifica a occhio#
Ogni esecuzione di training Ultralytics scrive labels.jpg e train_batch*.jpg nella cartella dell'esecuzione. Il primo mostra i conteggi delle classi e le posizioni e dimensioni dei riquadri; gli altri mostrano immagini reali di training con le etichette sovrapposte. Aprili prima che termini la prima epoca. L'occhio coglie ciò che le metriche non potranno mai rilevare: riquadri disegnati attorno alle ombre, ID di classe scambiati e poligoni non chiusi.
Mostra la soluzione
I disaccordi di COCO8 si trasformano in voci della guida come queste:
| Disaccordo | Regola aggiunta alla guida |
|---|---|
Persone distanti in 000000000049.jpg etichettate solo da A | Etichetta ogni persona alta almeno 10 pixel in un'immagine da 640 pixel; ignora quelle più piccole in tutte le immagini. |
| Pianta in vaso sul bordo del fotogramma etichettata solo da A | Etichetta un oggetto tagliato dal bordo del fotogramma se ne è visibile almeno la metà. |
Elefante parzialmente nascosto da un altro elefante in 000000000061.jpg | Etichetta gli animali occlusi se sono visibili la testa o metà del corpo; racchiudi solo la parte visibile. |
Per confrontare due persone invece di una persona e un modello, leggi le righe dell'annotatore B dalla seconda cartella delle etichette, esattamente come lo script legge quelle di A (Path("labels_b", image.stem + ".txt")), crea b_cls e b_box a partire da esse con le stesse due righe e usale nei punti in cui lo script legge b.cls e b.xyxyn. Esegui di nuovo lo script dopo la rietichettatura; il ciclo è concluso quando il punteggio supera il 90%.